DDiT: 动态 Patch 调度的高效扩散 Transformer
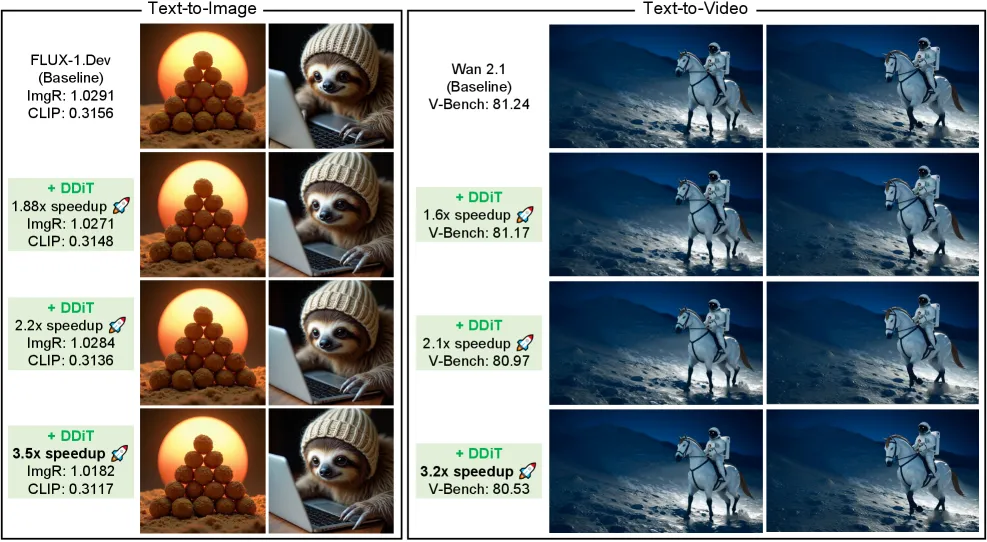
DDiT 提出测试时(training-free)动态分块策略——根据内容复杂度与去噪时间步自适应调整 patch size:高噪声步用粗 patch 建模全局结构、低噪声步用细 patch 精修局部细节;通过三阶有限差分度量潜表示演化速率驱动调度器,在 FLUX-1.Dev / Wan 2.1 上实现最高 3.52×/3.2× 加速且不损画质。
DDiT: Dynamic Patch Scheduling for Efficient Diffusion Transformers
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DDiT: Dynamic Patch Scheduling for Efficient Diffusion Transformers |
| 作者 | Dahye Kim, Deepti Ghadiyaram, Raghudeep Gadde |
| 论文 | https://arxiv.org/abs/2602.16968 (v1) |
| 发布 | 2026-02-19 |
| 分类 | cs.CV (Computer Vision and Pattern Recognition) |
| 基座模型 | FLUX-1.Dev(T2I)、Wan-2.1 1.3B(T2V) |
摘要
Diffusion Transformers (DiTs) 在图像/视频生成上达到 SOTA,但代价是沉重的计算量。低效的主因是固定的 tokenization 过程——整个去噪阶段使用恒定大小的 patch,无视内容复杂度。本文提出 动态 tokenization (dynamic tokenization),一种高效的测试时策略,根据内容复杂度与去噪时间步改变 patch size。
核心洞察:早期时间步只需较粗的 patch 建模全局结构,后期迭代则需要更细(更小)的 patch 精修局部细节。推理时,方法在去噪步骤间动态重新分配 patch size,大幅降低成本同时保持感知生成质量。实验表明在 FLUX-1.Dev 和 Wan 2.1 上分别取得最高 3.52× 和 3.2× 加速,且不损生成质量与提示遵循度。
二、核心思想
问题定义
DiT 因迭代去噪与注意力操作产生巨大计算开销(如 Wan-2.1 在 RTX 4090 上生成 5 秒 720p 视频需 30 分钟)。现有加速方法(特征缓存、剪枝、量化、蒸馏)存在两大局限:
- 静态硬性削减:如移除固定比例的权重/操作/token,可能永久丢弃对特定输出关键的计算,导致质量显著下降
- 一刀切、与输入无关:不同 prompt 需要不同的计算细节量——“a blue sky” 不该与 “a scene crowded with many zebras” 消耗相同资源
解决方案概述
DDiT 基于关键观察:扩散模型生成的视觉内容以不同细节层次演化——某些去噪步建立粗略场景结构,另一些精修细粒度细节。因此不同去噪步不必以相同粒度处理 latent。
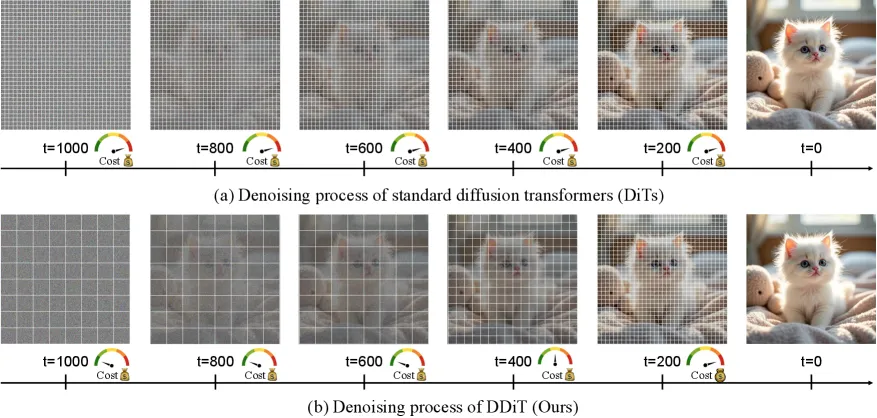
与”丢弃权重/操作”的先前工作不同,DDiT 动态分配计算:每个时间步调整 latent 的 patch size——需要细节少时用更大 patch(粗粒度),需要高保真时用更小 patch(细粒度)。
如何确定最优 patch size? 度量 latent 流形随时间的变化速率:
- 若短时窗内 latent 演化缓慢 → 生成粗粒度细节 → 用粗 patch 省算力
- 若 latent 演化快速 → 生成细粒度细节 → 回退到细 patch 保细节
三、技术架构
3.1 预备知识:Diffusion Transformer
DiT 基于 ViT,在预训练 VAE 的潜空间操作。输入图像编码为 latent 。latent 先被切分为 非重叠 patch,经 patch embedding 层(权重 ,偏置 )投影到 维嵌入,再由 个 transformer block 处理。
复杂度关键:patch 数 ,注意力复杂度 。更小的 → 更多 token → 注意力更昂贵;且去噪是迭代操作,小 patch 的开销被进一步放大。这促使跨时间步动态改变 。
3.2 动态分块与 Tokenization(架构改造)
目标:以最小架构改动让预训练 DiT 无缝支持不同 patch size。定义新 patch size 为 的正整数倍,即 。
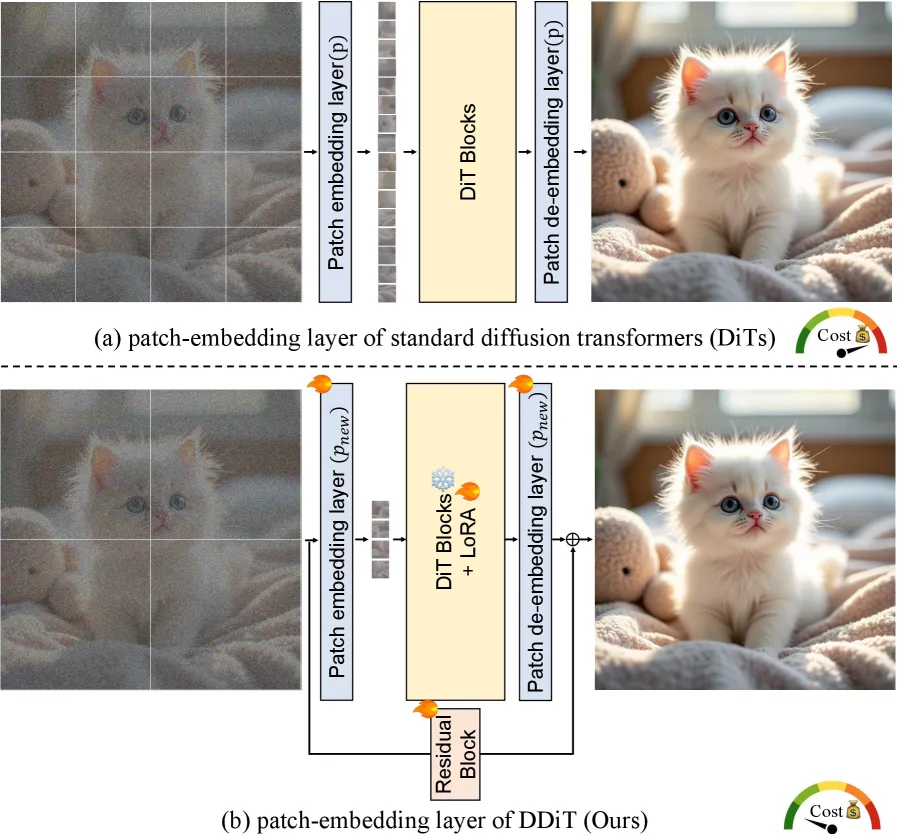
① patch-specific embedding 层:为每个想支持的 patch size 引入独立嵌入层。 对应 和 。patch 数 ,比 小 倍。
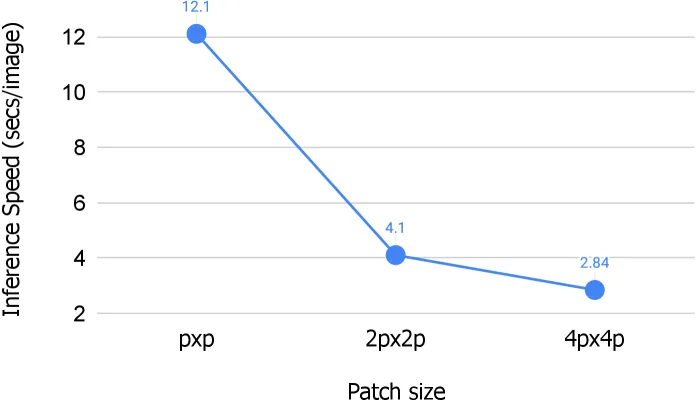
从 增大到 带来约 3× 计算收益。
② LoRA 适配分支:保留在 patch size 上训练的基座模型(冻结),在每个 transformer block 引入 LoRA 分支(rank=32)作为自适应通路,使模型能处理不同尺寸 patch,最小化训练成本。
③ 残差连接:从 patch embedding 前连到 patch de-embedding 后,平衡基座 latent 流形与 LoRA 学习的新流形。
④ 位置嵌入复用与 patch 标识:将原 patch size 的位置嵌入双线性插值到 ;引入可学习的 patch embedding( 维向量,类似位置嵌入)作为 patch-size 标识符,帮助模型区分当前用哪种 patch size。
⑤ 蒸馏训练:微调 LoRA 分支时用蒸馏损失,将冻结基座模型知识蒸馏到 LoRA 增强模型。设 、 分别为 LoRA 微调模型与冻结基座的预测噪声:
仅需 patch embedding 权重用双线性插值投影的伪逆初始化(following FlexiViT),保持基座功能行为。
3.3 动态 Patch 调度(Training-free 调度器)
核心问题:何时切换到更大 patch(粗 token),何时切回更小 patch(细 token)? DDiT 设计训练无关(training-free) 的动态调度器,根据时间步窗口内 latent 表示的演化速率自适应选择 patch size。
假设:
- 大 patch 可合理捕捉粗略场景结构,视觉质量损失小且带来加速
- 小 patch 适合捕捉细粒度细节,保留视觉复杂度
① Latent 演化估计(有限差分):用递增阶数的有限差分量化 latent 演化。设 为时间步 的 latent:
- 一阶差分:捕捉相邻时间步的位移
- 二阶差分:位移的变化率,即去噪轨迹的局部速度
- 三阶差分:速度的变化,可解释为短时窗内 latent 演化的加速度
假设:加速度慢 → 局部时窗内潜流形差异小;加速度高 → 底层流形结构差异大。以此作为代理,识别生成过程从粗到细(或反之)的转变点。
经验发现三阶差分最有效且更稳定,一/二阶因只捕捉短期时间变化而失效。此观察与已有工作一致——相邻噪声预测之差显式关联三阶有限差分。
② 空间方差估计:实践中 总被切分为 patch。将 切分为 patch(),计算每个 patch 内加速度的标准差 。
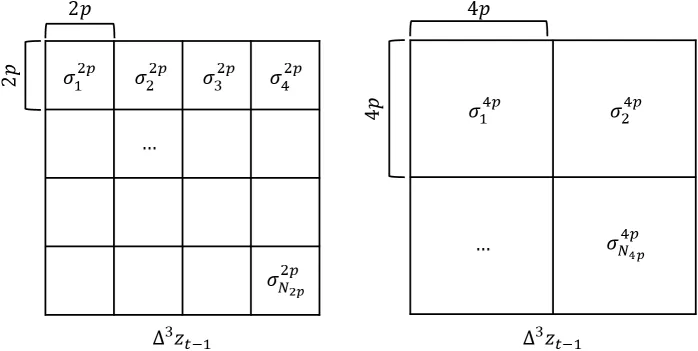
patch 内每(潜)像素标准差高 → 生成细粒度细节;标准差低 → 潜表示平滑。
③ 百分位聚合:直接取均值会抹平空间异质性(如同时含纯白背景与高纹理区域时,均值会平滑掉高方差,导致选大 patch 而忽略纹理细节)。因此取每-patch 方差的 -百分位 ,既捕捉跨 patch 的有意义信息,又避免被少数高方差离群点偏置。
④ 阈值调度规则:将 与预定义方差阈值 比较。每个时间步选择方差低于阈值 的最大 patch size;若无满足条件的 patch,默认最小 patch size(=1):
控制 即显式控制速度:偏好更快生成用更高 ;偏好更高质量用更小 。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 动态 tokenization | 按内容复杂度 + 时间步动态改变 latent 粒度,架构改动极小 | 图 2,最高 3.52× 加速 |
| 测试时 Patch 调度器 | 自动确定每步最优 patch size,基于生成复杂度与 prompt | 训练无关 |
| 三阶有限差分度量 | 用潜流形演化”加速度”识别粗↔细转变点 | 消融:n=3 最优 |
| 百分位聚合 | -百分位替代均值,捕捉空间异质性 | 避免抹平纹理细节 |
| LoRA 即插即用适配 | 冻结基座 + LoRA 分支使 patch-embedding 支持多尺寸 | rank=32,通用于任意 DiT |
| 可控计算预算 | 显式权衡速度-质量 | 表 4 |
与先前工作的区别:现有多 patch size 方法要么 (1) 需从头训练+复杂架构设计;(2) 无法泛化到现成预训练 DiT;(3) 推理时用刚性手工定义的 schedule。DDiT 是通用框架,测试时动态调整、可插入任意现成 DiT。
与 PPFlow (2506.23543) 的对比:PPFlow 用固定手工 stage schedule 按时间步切 patch(需为每 patch size 训练线性投影);DDiT 是训练无关的、内容自适应调度(用有限差分度量在线决定 patch size),且用 LoRA 适配现成模型而非重训。
五、实验结果
5.1 实验设置
- 基座:FLUX-1.dev(T2I)、Wan-2.1 1.3B(T2V)
- 支持 patch size:(原则上可扩展任意)
- 训练:T2I 在 T2I-2M 合成数据集上微调(Prodigy 优化器,lr=1.0);T2V 在 Vchitect-T2V-Dataverse 生成的合成视频上训练(AdamW,lr=)
- 超参:,(全实验统一)
- 评测:T2I 生成 1024×1024(50 步,guidance 3.5),COCO 算 CLIP/FID,DrawBench/PartiPrompts 算 CLIP/ImageReward/SSIM/LPIPS;T2V 生成 480×832、81 帧,用 VBench
5.2 文生图 (T2I)
对比 SOTA 缓存加速方法 TeaCache 和 TaylorSeer:
| 方法 | 相对基座 | 说明 |
|---|---|---|
| Base (FLUX-1.dev) | 1× | 基线 |
| DDiT | 2.18× 加速 | FID 仅差 0.35,CLIP 相当 |
| DDiT + TeaCache | 3.52× 加速 | 超越所有 SOTA,效率与质量兼得 |
- 相同推理速度下(表 1 行 4/6/8),DDiT 持续优于先前方法
- DDiT 与缓存策略互补,结合 TeaCache 达 3.52× 加速
- 图 7/8 定性对比显示 DDiT 保留细粒度细节、姿态、空间结构,能处理需深层语义理解的复杂 prompt
5.3 文生视频 (T2V)
- 表 2(VBench):显著降低推理时间同时保持有竞争力的视频质量
- 图 9:保留运动一致性与细粒度帧细节,最高 3.2× 加速
- 可扩展到长视频生成——同等算力下生成更长视频
5.4 分析与消融
① 用户研究(视觉偏好):图像对(DDiT vs 基线)随机顺序并排展示,让评分者选质量更高者:
- DDiT 与 DiT 同样好 占 61%
- DiT 更受偏好 22%
- DDiT 更受偏好 17%(尽管非主要目标)
- → DDiT 在提供大幅加速的同时视觉质量与基线持平
② n 阶差分的影响(表 3):随 增大,FID 与 CLIP 持续改善(高阶差分捕捉更丰富的时间动态)。三阶 (n=3) 最优——最低 FID、最高 CLIP 与 ImageReward。
③ 跨 prompt 的 patch schedule(图 10):
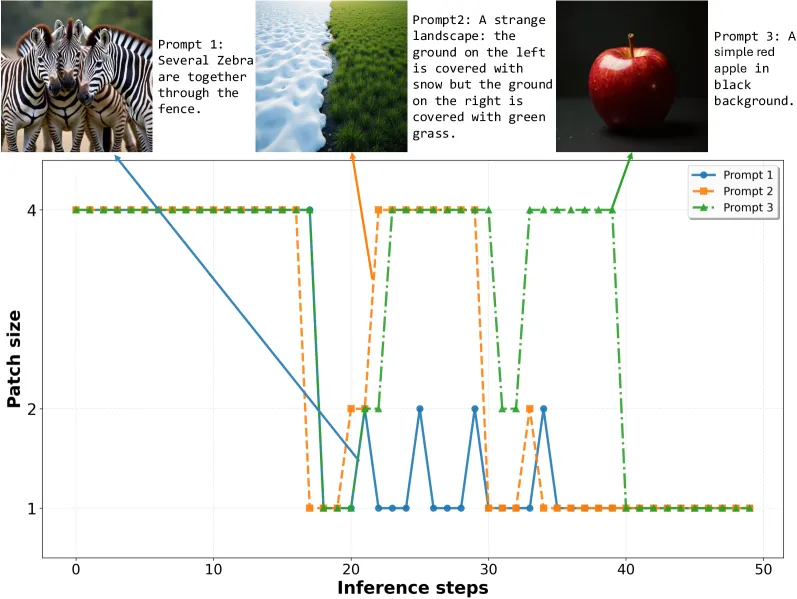
调度器按 prompt 语义与结构丰富度自动调整——复杂纹理场景分配更多细 patch 步;简单/均匀背景 prompt 切换到粗 patch 减少冗余计算,实现内容感知的计算分配。
④ 阈值 的影响(表 4):增大 → 推理更快、质量轻微下降(调度器对局部时间变化敏感度降低,过早选粗 patch)。退化很小,验证鲁棒性;折中选 。
六、总结
核心贡献
- 动态 tokenization:简单、直观、低成本地在扩散模型去噪中动态改变 latent 粒度,架构改动极小
- 测试时 Dynamic Patch Scheduler:自动确定每步最优 patch size,按生成复杂度与 prompt 自适应
- 广泛验证:跨图像/视频 DiT 泛化,FLUX-1.Dev 达 3.52×、Wan 2.1 达 3.2× 加速且保持高感知质量
- 新视角:对潜流形演化速率与生成复杂度关系的详细分析,揭示扩散模型内部动态
技术影响
- 提供正交于缓存/剪枝/量化/蒸馏的新效率维度——动态调整 tokenization 粒度
- 即插即用 LoRA 适配器让任意现成 DiT 受益于快速推理,无需从头重训
- 可用于长视频生成,同等算力生成更长视频
局限性与未来方向
- 当前设计同一时间步用固定 patch size,仅跨时间步变化
- 未来方向:探索同一时间步内的可变 patch size,进一步提升效率
七、参考资源
- arXiv: https://arxiv.org/abs/2602.16968
- 基座模型: FLUX-1.dev、Wan-2.1 1.3B
- 对比方法: TeaCache、TaylorSeer
- 数据集: T2I-2M、Vchitect-T2V-Dataverse、COCO、DrawBench、PartiPrompts、VBench
- 相关技术: LoRA、FlexiViT(伪逆初始化)、Prodigy 优化器
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 1 | DDiT 效果展示(动态选 patch,算力增益无损画质) | figure-1-teaser.png |
| Figure 2 | 核心思想:去噪中的动态 tokenization | figure-2-dynamic-tokenization.png |
| Figure 3 | 改造后的 patch-embedding 层(支持多尺寸 patch) | figure-3-patch-embedding.png |
| Figure 4 | 推理速度 vs patch size(p→2p 约 3× 增益) | figure-4-speed-vs-patch.png |
| Figure 5 | 空间方差估计(patch 内加速度标准差) | figure-5-spatial-variance.png |
| Figure 10 | 不同 prompt 的 patch 调度示例 | figure-10-patch-schedules.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer