TempoVLA: Learning Speed-Controllable Vision-Language-Action Policies
A single VLA with bidirectional speed control via Variable-Speed Trajectory Augmentation (VSTA) and explicit speed conditioning, enabling on-demand acceleration/deceleration without retraining
TempoVLA: Learning Speed-Controllable Vision-Language-Action Policies
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | TempoVLA: Learning Speed-Controllable Vision-Language-Action Policies |
| 作者 | Dong Jing*^1,2, Jingchen Nie*^2, Tianqi Zhang*^2, Jiaqi Liu^2, Huaxiu Yao^2, Zhiwu Lu^1†, Mingyu Ding^2† |
| 机构 | ^1 RUC (Renmin University of China), ^2 UNC (University of North Carolina at Chapel Hill) |
| 论文 | arXiv:2606.06491 |
| 发布 | 4 Jun 2026 (v1), revised 19 Jul 2026 (v2), 5,020 KB |
| 许可 | CC BY 4.0 |
| Subjects | Robotics (cs.RO); Artificial Intelligence (cs.AI) |
二、核心思想
问题定义
机器人操作在低风险通过阶段需要快速执行,在高接触风险阶段需要慢速精确运动。然而现有的 Vision-Language-Action 模型(VLAs)仅从训练演示中继承单一固定速度。已有工作通过模型压缩、KV-cache 复用或强化学习来加速 VLAs,只是将策略从一个固定速度移到另一个固定速度,且减速几乎未被探索。
解决方案概述
TempoVLA 是一个单一 VLA 框架,其执行速度通过显式条件控制。核心洞察是:每个预测动作的幅度已经决定了机器人的移动速度——这为可控执行速度打开了直接通道。
TempoVLA 结合两个耦合组件:
-
数据端 — 变速轨迹增强 (Variable-Speed Trajectory Augmentation, VSTA):在线将任何演示重新定时到任意目标速度,通过合并连续动作来加速,或拆分动作来减速,同时保持运动语义不变。
-
模型端 — 速度条件机制:将标量速度 作为显式条件输入策略,通过三种注入方案之一缩放预测动作幅度,底层控制器保持不变。
配合大型多模态模型 (VLM),TempoVLA 可实现动态速度调度——在低风险阶段加速通过,在高接触阶段减速以确保精度。
三、技术架构
整体框架图
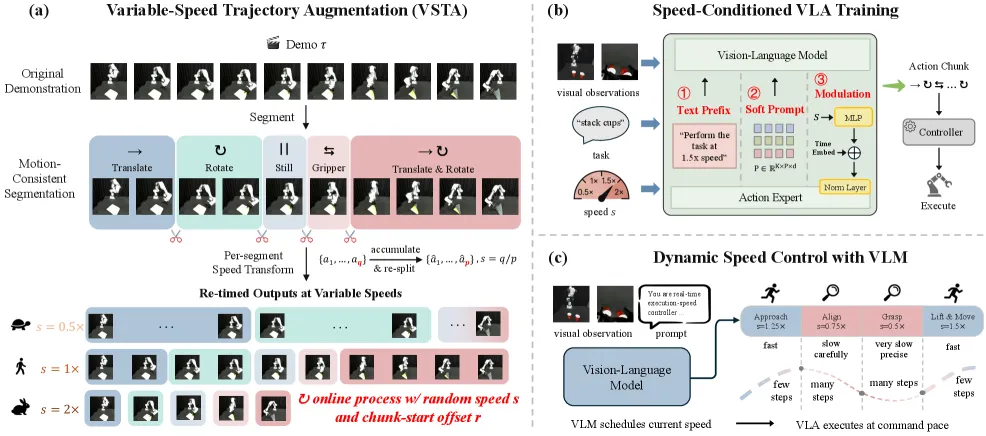
┌─────────────────────────────────────────────────────────────────┐
│                      TempoVLA Architecture                       │
│                                                                  │
│  ┌─────────────────── VSTA (Data Side) ─────────────────────┐   │
│  │                                                          │   │
│  │  Original Demo:  [a_1] [a_2] [a_3] [a_4] [a_5] [a_6]    │   │
│  │                    │      │      │      │      │      │   │
│  │  s=0.5× (slow):  [a_1] [a_1'] [a_2] [a_2'] [a_3] [a_3'] │   │
│  │                  (split: q<p → more output frames)        │   │
│  │                                                          │   │
│  │  s=2.0× (fast):  [b_1] [b_2] [b_3]                      │   │
│  │                  (merge: q>p → fewer output frames)       │   │
│  │                                                          │   │
│  │  Key: s = q/p, accumulate Δ = Σ a_i, re-split into p     │   │
│  │  steps. Gripper copied discretely (never averaged).       │   │
│  └──────────────────────────────────────────────────────────┘   │
│                                                                  │
│  ┌─────────────────── Speed Conditioning (Model Side) ─────────┐ │
│  │                                                              │ │
│  │  Three injection schemes:                                    │ │
│  │                                                              │ │
│  │  ① Textual Prefix:                                          │ │
│  │     "Perform the task at ⟨s⟩x speed." + original instruction │ │
│  │                                                              │ │
│  │  ② Speed-Modulated RMSNorm:                                 │ │
│  │     adaRMSNorm(x; σ_ts + ϕ_mod(s)) = γ(σ_ts+ϕ_mod(s)) ⊙ x  │ │
│  │                                                              │ │
│  │  ③ Soft Prompt with Speed Anchors:                          │ │
│  │     P ∈ ℝ^{K×P×d_emb}, pick anchor k* = argmin_k|s-s_k|    │ │
│  │                                                              │ │
│  └──────────────────────────────────────────────────────────────┘ │
│                                                                  │
│  ┌─────────────────── VLM Scheduler (Optional) ────────────────┐ │
│  │  GPT-4o observes scene → dispatches per-chunk speeds        │ │
│  │  s_t → TempoVLA executes chunks at speed s_t                │ │
│  └──────────────────────────────────────────────────────────────┘ │
└─────────────────────────────────────────────────────────────────┘
核心公式
问题形式化
VLA 策略 (Eq. 1):
其中 包含视觉输入、语言指令和可选本体感知状态, 是 horizon 的动作块。
TempoVLA 目标: 产生速度可控的策略 ,其中 加速, 减速, 恢复默认速度。
变速轨迹增强 (VSTA)
速度分解: 将目标速度写为既约分数 ,其中 为互质整数。 个源帧映射到 个输出帧 ( 加速, 减速)。
累积-拆分操作 (Section 3.2):
对每个 chunk 积累总运动:
然后将 拆分为 个等幅步长(线性插值累积运动)。由构造可知,新的 个动作之和恰好等于 ,因此 chunk 的积分运动被保留,仅改变 chunk 内的形状。
在线 Chunk-start 采样: 对每个 segment 采样偏移 ,chunks 从 开始。每次演示采样时抽取新鲜偏移。
速度调制 RMSNorm
AdaRMSNorm (Eq. 2):
其中 是小型两层 MLP,将标量速度嵌入并加到 flow-matching timestep embedding 上。
软提示速度锚点
最近锚点选择:
其中 存储 个训练速度锚点各 个软提示 token。
运动模式分割 (Section 3.2)
每帧标记为四种运动模式之一:静止 (still)、平移 (translate)、旋转 (rotate)、平移+旋转 (translate-and-rotate)。当平移/旋转幅度超过小阈值时设置边界。进一步在运动方向反转时拆分(连续平移或旋转方向的余弦相似度低于 )。
动作表示要求
累积-拆分操作仅在动作相加等于组合时才有效。这在 中的笛卡尔平移、关节速度和 中的轴角向量旋转增量下成立。单位四元数、旋转矩阵或欧拉角等不满足加法封闭性的表示必须先映射到 或在流形上插值(如 SLERP)。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Base Model | (flow-matching VLA based on PaliGemma) | 3B parameters |
| VSTA Segmentation | 按运动模式分割演示为 motion-consistent segments | 4 modes, threshold |
| Chunk Transform | 累积-拆分,保持总运动守恒 | coprime integers |
| Online Offset Sampling | 避免丢弃帧 | 每次训练重新采样 |
| Textual Prefix | ”Perform the task at x speed.” | 默认方案,无需架构修改 |
| Speed Modulation | 2-layer MLP → adaRMSNorm | 注入 action expert |
| Soft Prompt | anchors × tokens tensor | , in ablation |
| VLM Scheduler | GPT-4o 每 2 个 action chunks 查询一次速度 | 部署时可选 |
训练流程
TempoVLA 不需要额外数据收集:
- VSTA 在线增强: 在训练过程中,对每个采样的演示在线重定时到随机目标速度
- 速度条件训练: 使用 VSTA 生成的多速度数据集 训练速度条件策略
- 超参数: 30k 迭代,batch size 512,32× NVIDIA H20 GPUs
- 底层控制器不变: 训练和部署均不修改低层控制器
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 发现动作幅度即速度控制 | 观察到已预测动作的幅度已决定机器人移动速度,为可控执行速度打开直接通道 | Section 3: 无需修改底层控制器即可实现双向速度控制 |
| VSTA: 在线变速轨迹增强 | 通过 累积-拆分操作,将演示重定时到任意目标速度,保持运动语义不变;在线 chunk-start 采样避免丢弃帧 | Table 1: Motion Err. ,可忽略不计 |
| 三种轻量级速度注入方案 | 文本前缀(零架构修改)、RMSNorm 调制(注入 action expert)、软提示锚点(encoder 输入),三者性能基本持平 | Table 2: SR 差异 |
| VLM 动态速度调度 | 与 GPT-4o 配合实现运行时自动速度调度,低风险加速、高接触减速 | Section 5.2: 96% 成功率,比最佳固定速度高 8 分 |
五、代码实现分析
实现细节
- Base Model: — 基于 PaliGemma 的 flow-matching VLA
- 动作空间: LIBERO 上是 7-dim EEF 命令(平移 + 轴角旋转增量 + 夹爪信号);Franka 上是 8-dim(7-dim 关节速度 + 1-dim 夹爪)
- 运动表示兼容性: 平移和旋转部分位于可线性组合的空间,VSTA 可直接应用;夹爪命令离散复制
- 硬件: 32× NVIDIA H20 GPUs 训练,单 H100 评估
六、实验结果
仿真实验设置
- Benchmark: LIBERO — 4 套任务(Spatial, Object, Goal, Long),每套 10 任务 × 500 演示
- 动作: 7-dim EEF (平移 + 轴角旋转 + 夹爪)
- 基线: 单速度 在
VSTA 可行性验证 (Table 1)
重定时演示回放成功率:
| Target | Data Ratio | Succ. (#) | SR (%) | Motion Err. |
|---|---|---|---|---|
| 0.5 | 0.5 | 664 | 83.0 | |
| 0.75 | 743 | 92.9 | ||
| 1.0 | 1.0 | 781 | 97.6 | — |
| 1.25 | 739 | 92.4 | ||
| 1.5 | 653 | 81.6 | ||
| 2.0 | 540 | 67.5 |
关键观察:Motion Error 始终 ,远小于控制器容差。SR 接近 1× 时很高(0.75×: 92.9%, 1.25×: 92.4%),远离 1× 时单调下降。
速度注入方案消融 (Table 2)
三种方案在 LIBERO 上的对比:
| Speed | Text SR (%) | Modulation SR (%) | Soft Prompt-8 SR (%) |
|---|---|---|---|
| 0.75× | 96.5 | 95.8 | 96.4 |
| 1.0× | 96.9 | 97.0 | 95.8 |
| 1.25× | 97.0 | 97.3 | 96.8 |
| 1.5× | 96.8 | 97.2 | 96.9 |
| Avg. | 96.8 | 96.8 | 96.5 |
三种方案整体 SR 差异 ,表明速度控制可注入 VLA 而几乎不依赖具体机制。Text 前缀因无需架构修改且 SR 最高被选为默认方案。
训练速度范围影响 (Table 3)
不同速度范围的训练效果:
Narrow Range {0.75, 1, 1.25, 1.5}×:
- 1× SR: 96.9% ↑0.2 (vs baseline 96.7%)
- Peak SR: 97.0% at 1.25× (比 1× 高 0.3)
Wide Sparse Range {0.5, 1, 1.5, 2}×:
- 1× SR: 96.8% ↑0.1
- Peak SR: 97.2% at 1.5×
Refined 7-Range {0.5, 0.75, 1, 1.25, 1.5, 1.75, 2}×:
- 1× SR: 96.9% ↑0.2
- Peak SR: 97.4% at 1.25× (最佳)
- 在共享速度 {0.5, 1, 1.5, 2}× 上,细化粒度始终优于稀疏范围
关键发现:
- 峰值成功率高出 1×:所有速度条件策略的峰值出现在 1.25× 或 1.5×,归因于遥操作数据中的自然节奏冗余被 VSTA 压缩
- 更细粒度有益:在共享速度上,stride 从 0.5 细化到 0.25 始终提升 SR
- 极端速度扩展有益:包含 0.5× 和 2× 扩大了增强覆盖,提升中等速度表现
真实世界实验 (Section 5)
Franka 机械臂设置: 7-DoF arm + 1-DoF 并行夹爪,主相机 + 腕部相机,5 任务(4 个 pick-and-place + 1 个可变形物体任务)。
速度控制结果:
| Speed | Pick & Place Avg. SR | Deformable Object SR |
|---|---|---|
| Baseline (1×) | 80.0% | — |
| VSTA (1×) | 88.0% (+8) | — |
| VSTA (1.25×) | 84.0% | — |
| Realized ratio | — | 0.63× (cmd 0.75×), 1.29× (cmd 1.25×), 1.48× (cmd 1.5×) |
VSTA 将 1× 成功率从 80% 提升到 88%,与仿真中发现的隐式增强效应一致。
VLM 动态速度调度 (Section 5.2)
GPT-4o 调度器表现:
- 平均成功率: 96% — 比最佳固定速度配置 (88% at 1×) 高 8 分
- 平均实现加速比: 1.21× over 1× baseline
- 速度分布: 大多数决策落在 1× 或 1.25×,1.5× 很少调度
- GPT-4o 可靠地识别自由空间通过、精细对齐和接触阶段
失败模式分析 (Appendix D, Figure 4)
在高速度端,实现的加速逐渐饱和——策略的每步目标开始超出固定底层控制器的跟踪带宽。
七、相关工作
Vision-Language-Action Models
- RT-2, OpenVLA, , , GR-3, CogACT, BAKU, Diffusion Policy, ACT, PaLM-E, RoboCat, UniVLA, etc.
- 共同局限:执行速度从演示数据中静默继承
VLA Acceleration (Model-based)
- TinyVLA, SmolVLA, EfficientVLA (模型压缩)
- FAST tokenizer, OpenVLA-OFT (token/KV 压缩)
- Real-Time Chunking, Flow policies with smooth boundaries (异步执行)
- DemoSpeedup, SpeedAug, ESPADA, SAIL — 操纵演示 tempo 的近期工作,但均未暴露执行速度为显式的按需控制
VLA Acceleration (Model-free / Low-level)
- CHOMP, Riemannian motion policies, cuRoBo (运动规划器)
- Tune to learn: controller gains shaping policy execution
八、总结
核心贡献
- 提出 TempoVLA: 一个单一的 VLA 框架,通过 VSTA(数据端)和速度条件(模型端)实现双向速度控制,无需新数据收集
- 发现速度控制的简易性: 证明在正确重定时数据下,速度控制易于植入且几乎独立于注入机制,变量速度训练作为有效增强持续提升默认 1× 成功率
- 扩展到 VLM 驱动动态调度: 将执行速度转化为高层推理器的新控制通道
技术影响
TempoVLA 将执行速度从 VLAs 的隐式属性转变为显式控制通道。通过与 VLM 调度器配合,系统可以在低风险阶段自动加速、在高接触阶段自动减速,无需人工干预。
局限性
- 高速端饱和: 在速度范围高端,实现的加速逐渐饱和——策略每步目标超出固定底层控制器的跟踪带宽
- 动作表示要求: VSTA 的累积-拆分操作要求动作表示在线性可组合空间中( 平移、 旋转),单位四元数等需要额外变换
- 极端速度成功率下降: 2× 加速时回放成功率降至 67.5%,2× commanded 时模型仅实现 1.56×
- VLM 调度保守: GPT-4o 实际调度偏向安全端(主要 1×/1.25×),未充分利用加速潜力
九、参考资源
- 论文: https://arxiv.org/abs/2606.06491
- DOI: https://doi.org/10.48550/arXiv.2606.06491
- License: CC BY 4.0
- LIBERO Benchmark: https://github.com/Lifelong-Robot-Learning/LIBERO
- Model: https://arxiv.org/abs/2504.16054
- PaliGemma: https://arxiv.org/abs/2407.07726
- 相关基线: DemoSpeedup (arXiv:2506.05064), ESPADA (arXiv:2512.07371), SAIL (arXiv:2506.11948)