ScalingCache: Extreme Acceleration of DiTs through Difference Scaling and
通过差分缩放和动态间隔缓存实现 DiT 的极端加速
ScalingCache: Extreme Acceleration of DiTs through Difference Scaling and Dynamic Interval Caching
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | ScalingCache: Extreme Acceleration of DiTs through Difference Scaling and Dynamic Interval Caching |
| 作者 | Lihui Gu, Jingbin He, Lianghao Su, Kang He, Wenxiao Wang, Yuliang Liu |
| 机构 | 浙江大学软件技术学院, KlingAI Research |
| 论文 | |
| 代码 | GitHub |
| 主题 | cs.CV (计算机视觉与模式识别) |
二、核心思想
问题定义
扩散 Transformer (DiT) 已成为强大的生成模型,但其迭代去噪结构和深层 Transformer 块产生了大量计算开销,限制了高质量视频生成的可访问性和实际部署。
核心挑战: 特征缓存涉及两个核心问题:
- 如何使用缓存: 直接重用缓存特征面临关键限制——随着时间距离增加,特征相似性迅速衰减
- 何时使用缓存: 固定间隔策略缺乏适应模型动态行为的灵活性
解决方案概述
ScalingCache 是一个无训练加速框架,专门针对 DiT 设计。它通过以下两个互补策略解决上述问题:
- 差分缩放优化: 对每个时间步和 Transformer 块离线预计算差分缩放系数,实现准确的基于缓存的预测
- 运行时自适应动态间隔缓存: 利用每个块的输出和计算过程中的误差变化,自适应调整全步计算的间隔
核心性能
- 在 Wan2.1 和 HunyuanVideo 上实现约 2.5× 加速,VBench 分数仅下降 0.5%
- 在 FLUX 上实现 3.1× 近无损加速,人类偏好测试显示与原始输出质量相当
- 在相同加速比下,相比 SOTA 缓存策略:
- 文本到图像生成 LPIPS 降低 45%
- 文本到视频生成 LPIPS 降低 20-30%
三、技术架构
DiT 架构概述
扩散 Transformer 遵循分层架构:
每个块 由多个模块组成:
其中:
- = 自注意力模块
- = 交叉注意力模块
- = 前馈网络
每个模块包含残差连接:
差分缩放预测
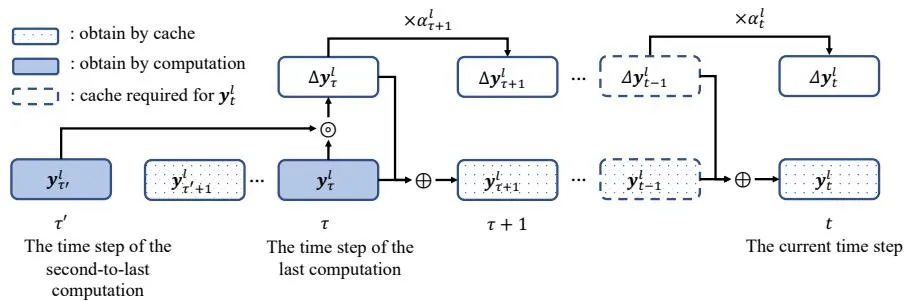
Figure 4: 通过差分缩放基于块级预测获取当前步特征的完整过程
零阶与一阶特征观察
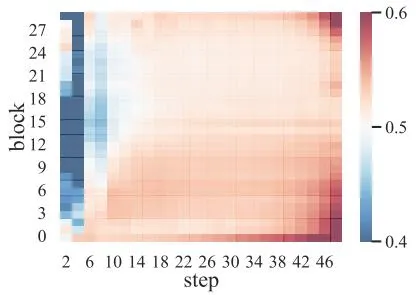
Figure 1: 不同去噪步骤和不同块中,零阶和一阶特征相对于全计算的 L1 误差呈现不同的区域模式
关键观察:对于某些 Transformer 块在特定时间步,直接重用缓存的预时间步特征 相对于全计算产生的误差比应用一阶特征 更小。这表明组合 和 比单独依赖任一更有效。
一阶线性预测
Taylorseer 提出的一阶特征预测公式:
其中:
- = 最近的全计算步
- = 次近的全计算步
- = 缓存间隔
修改的一阶线性预测(ScalingCache)
其中 是一阶差分缩放系数。
离线 α 估计
通过最小二乘公式求解 :
闭式解(当 ):
使用指数移动平均更新以提高稳定性和泛化性:
实践参数:
- 使用约 50 个提示离线预计算
- 离线计算不引入在线推理的额外开销
特征差估计
由于两个全计算步之间的缩放因子不同,使用以下公式估计 :
缓存存储需求: 每个模块需要存储两个张量:缓存特征 和特征差
运行时动态间隔缓存
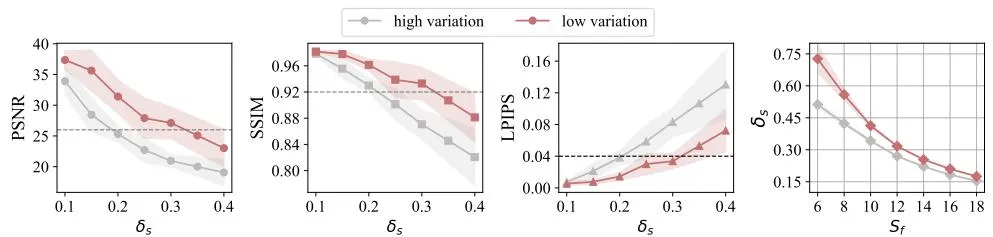
Figure 5: 使用不同提示集评估不同阈值配置下的生成质量
U 形误差模式
观察发现缓存预测存在 U 形误差模式:使用一阶差分优化时,中间时间步的预测误差相对较低,而扩散过程的开始和结束阶段显示较大偏差。
动态误差定义
每个时间步 的动态误差定义为:
累积误差:
缓存更新规则
其中:
- = 初始预热步数(必须进行全计算以捕获早期扩散阶段的快速变化特征)
- = 动态误差阈值(限制预测与全计算特征之间的偏差)
自适应阈值估计
- 高变化视频生成任务需要更小的阈值
- 低变化场景可以使用更大的 ,获得更高的加速比
- 可从第一批 时间步估计
算法流程
Algorithm 1: ScalingCache 推理策略
输入: DiT 模型 M, [α_t^l]
参数: S_f (初始预热步数)
输出: {y_t^L | t = 1, ..., N}

1. 初始化 ε_t = 0, E = ∅
2. for t = 1 to N do
3.   计算 δ_s = 1/|E| Σ_{ε∈E} ε
4.   if t ∈ [0, S_f-1] or ε_t > δ_s then
5.     y_t^L = M(x_t)  # 全计算
6.     ε_t = ē_t
7.     E ← E ∪ ε_t
8.   else
9.     for l = 1 to L do
10.      y_t^l = y_{t-1}^l + α_t^l Δy_{t-1}^l  # 缓存预测
11.      Δy_t^l = α_t^l Δy_{t-1}^l
12.    end for
13.    ε_t = ε_t + ē_t  # 更新累积误差
14.  end if
15. end for
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 差分缩放系数 | 为每个时间步和块预计算 α 系数 | 离线最小二乘优化,EMA 更新 |
| 区域模式发现 | 零阶特征在某些情况下优于一阶 | L1 误差分析(Figure 1) |
| 动态间隔缓存 | 自适应调整全计算间隔 | U 形误差模式,累积误差阈值 |
| 自适应阈值 | 根据任务变化程度调整 δ_s | 高/低变化任务的不同需求 |
| 单参数调节 | 仅需调整 S_f 参数 | 简单易用,无需复杂调参 |
五、实验结果
基准测试
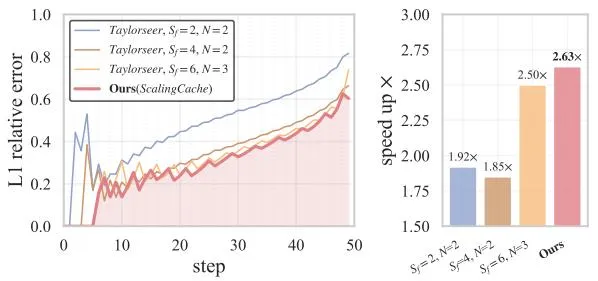
Figure 2: ScalingCache 在不同缓存策略下始终实现更高的加速比和更低的 L1 相对误差
文本到视频生成
| 模型 | 方法 | 加速比 | PSNR ↑ | SSIM ↑ | LPIPS ↓ | VBench (%) ↑ |
|---|---|---|---|---|---|---|
| Wan2.1 1.3B | 原始 | 1× | - | - | - | 83.31 |
| + 40% steps | 2.5× | 14.50 | 0.523 | 0.437 | 80.30 | |
| + Teacache | 2.0× | 22.57 | 0.806 | 0.128 | 81.04 | |
| + Taylorseer | 1.9× | 13.52 | 0.510 | 0.447 | 81.97 | |
| + EasyCache | 2.5× | 25.24 | 0.834 | 0.095 | 82.48 | |
| + ScalingCache | 2.5× | 26.61 | 0.890 | 0.071 | 82.92 | |
| Wan2.1 14B | 原始 | 1× | - | - | - | 84.05 |
| + ScalingCache | 2.5× | 25.63 | 0.861 | 0.083 | 83.87 | |
| HunyuanVideo | 原始 | 1× | - | - | - | 81.40 |
| + ScalingCache | 2.3× | 30.80 | 0.930 | 0.049 | 81.13 |
文本到图像生成
| 方法 | 加速比 | PSNR ↑ | SSIM ↑ | LPIPS ↓ | CLIP Score (%) ↑ |
|---|---|---|---|---|---|
| FLUX 1.dev 原始 | 1× | - | - | - | 80.17 |
| + 50% steps | 2.0× | 29.36 | 0.683 | 0.318 | 78.88 |
| + Teacache | 2.0× | 28.08 | 0.400 | 0.690 | 81.79 |
| + Taylorseer | 2.8× | 30.76 | 0.780 | 0.230 | 80.17 |
| + ScalingCache | 3.1× | 32.28 | 0.819 | 0.131 | 80.25 |
人类偏好评估
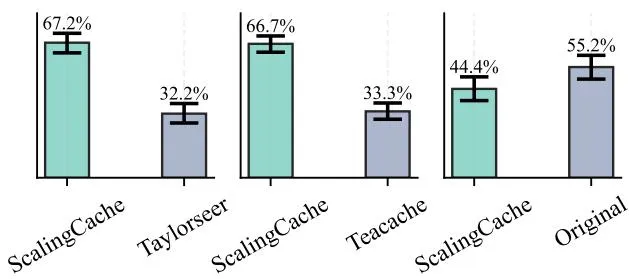
Figure 7: 人类偏好评估结果
ScalingCache 加速的图像被选择的比率与原始图像大致相同,证明加速生成保持了与原始相当的视觉质量。
消融实验
| 模型 | α | 动态缓存 | 加速比 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|---|---|---|
| Flux 1.dev | 2.9× | 29.15 | 0.652 | 0.324 | ||
| √ | 2.9× | 29.83 | 0.701 | 0.259 | ||
| √ | 2.6× | 31.04 | 0.772 | 0.192 | ||
| √ | √ | 3.0× | 32.28 | 0.819 | 0.131 | |
| Wan2.1 1.3B | 2.4× | 24.53 | 0.857 | 0.092 | ||
| √ | 2.4× | 25.95 | 0.876 | 0.079 | ||
| √ | 2.5× | 22.50 | 0.809 | 0.129 | ||
| √ | √ | 2.5× | 26.61 | 0.890 | 0.071 |
关键发现: 差分缩放系数 (α) 和动态缓存间隔对效率和生成质量都至关重要。
跨任务鲁棒性分析
| 子任务 | motion | composition | human | material | mechanics | dynamic | static | random |
|---|---|---|---|---|---|---|---|---|
| |α_i - ᾱ| | 0.008 | 0.007 | 0.009 | 0.022 | 0.015 | 0.011 | 0.017 | 0.006 |
关键发现: 大多数子任务的 α 值与全局均值偏差在 2.5% 以内,表明 α 具有良好的跨任务稳定性。
加速比与 S_f 参数
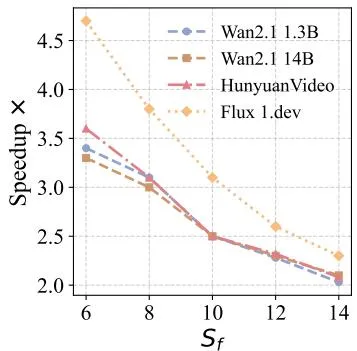
Figure 8: 不同模型使用不同 S_f 实现的加速比
对于 S_f ≤ 14,所有评估模型都实现了超过 2.0× 的端到端推理加速。
六、生成结果展示
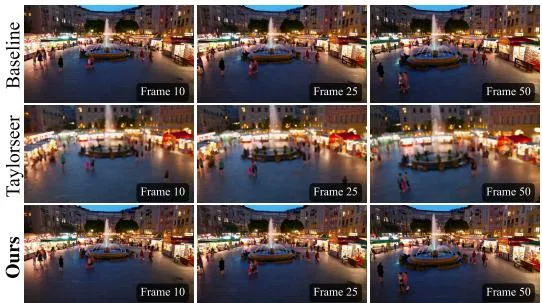
Figure 3: Wan2.1-14B 和 FLUX 1.dev 上的视频和图像生成结果
即使在高加速因子下,ScalingCache 也实现了与原始视频/图像几乎相同的视觉保真度。
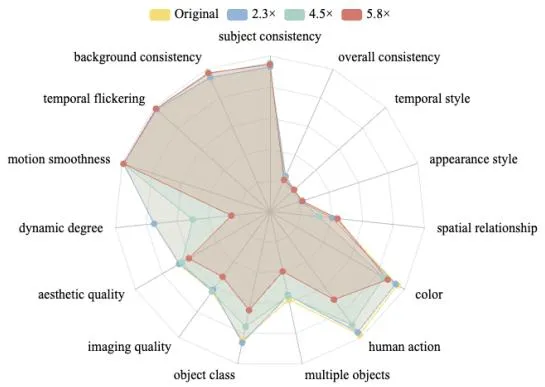
Figure 9: 不同 S_f 下的 VBench 和视觉保持评估
将 S_f 从 6 降低到 4 会明显降低生成质量。虽然整体 VBench 分数仅下降 2%,但更高加速会显著损害动态程度和人类动作性能。
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| Taylorseer | 使用高阶泰勒展开,但存储开销大且性能提升有限 |
| Teacache | 动态缓存策略,但仅基于第一块输入和最后块输出 |
| EasyCache | 动态缓存,但未充分考虑中间块的动态性 |
| MixCache | 混合缓存策略,在 HunyuanVideo 上对比 |
| 蒸馏方法 | 需要大规模数据和计算,非训练方法 |
八、总结
核心贡献
- 差分缩放优化: 为每个时间步和 Transformer 块预计算差分缩放系数,实现准确的缓存预测
- 运行时自适应动态间隔缓存: 利用块输出和误差变化自适应调整计算间隔
- 近无损加速: 在多个 SOTA 模型上实现 2.3-3.1× 加速,质量损失极小
- 单参数调节: 仅需调整 S_f 参数,简单易用
- 跨任务稳定性: α 系数在不同任务间具有良好的稳定性
技术影响
- 无训练加速: 避免了蒸馏等方法的高昂训练成本
- 即插即用: 可应用于任何 DiT 架构的生成模型
- 高质量保持: 在高加速比下仍保持专业级视觉质量
- 实际部署: 使高质量视频生成更加可访问
局限性
- 当前策略可能不适用于所有实例(如从静态开始但后来转变为动态的场景)
- 离线 α 计算需要约 50 个提示和 5 个随机种子
- 高加速比下动态程度和人类动作性能会下降