ScaleFusion: Scalable Inference of Spatial-Temporal Diffusion Transformers
面向高分辨率长视频生成的时空扩散Transformer可扩展推理
ScaleFusion: Scalable Inference of Spatial-Temporal Diffusion Transformers for High-Resolution Long Video Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | ScaleFusion: Scalable Inference of Spatial-Temporal Diffusion Transformers for High-Resolution Long Video Generation |
| 作者 | Jiacheng Yang, Jun Wu, Zhen Zhang, Xinwei Fu, Zhiying Xu, Zhen Jia, Yida Wang, Gennady Pekhimenko |
| 机构 | University of Toronto, Amazon Web Services |
| 会议 | MLSys 2025 |
| 论文 | |
| 领域 | 视频生成、分布式推理、序列并行、计算-通信重叠 |
二、核心思想
问题定义
近年来,时空扩散Transformer(ST-DiT)已成为高分辨率(1080p)长时长(20秒)视频生成的主流架构。然而,ST-DiT的推理面临严重的计算瓶颈:
- 二次方计算复杂度:注意力层的计算成本相对于分辨率和时长呈二次方增长
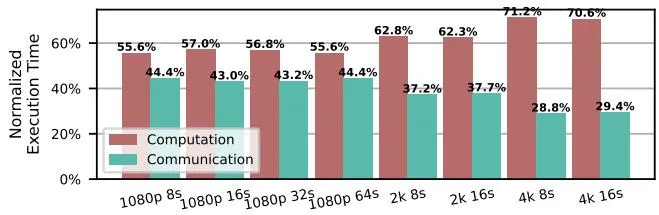
- 高通信开销:跨机器通信开销占端到端推理延迟的30-50%
- 可扩展性差:现有序列并行技术无法高效扩展到多GPU机器
关键发现:
- 生成1080p 4秒视频(OpenSora 1.1B参数)在单个A100 GPU上需要超过5分钟
- 现有SP技术在2机器和4机器实验中分别产生34%和44%的通信开销
- 相比理论强扩展加速比,实际加速仅为1.53×和1.83×
解决方案概述
ScaleFusion提出利用ST-DiT的时空独立性(spatial-temporal independence)来隐藏通信开销:
- 层内通信调度:将层执行分割为多个切片,实现切片间的计算-通信重叠
- 层间通信调度:将部分通信操作提升到前一层的计算中执行
- 无损优化:不牺牲视频生成质量
三、技术架构
整体框架
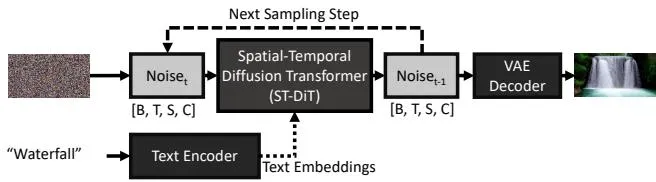
ST-DiT架构由交替的空间注意力层和时间注意力层组成:
| 层类型 | 注意力维度 | 输入张量形状 | 分布式布局 |
|---|---|---|---|
| 空间层 | 空间维度 S | [B, T, S/P, C] | 空间分布式 |
| 时间层 | 时间维度 T | [B, T/P, S, C] | 时间分布式 |
分布式执行流程
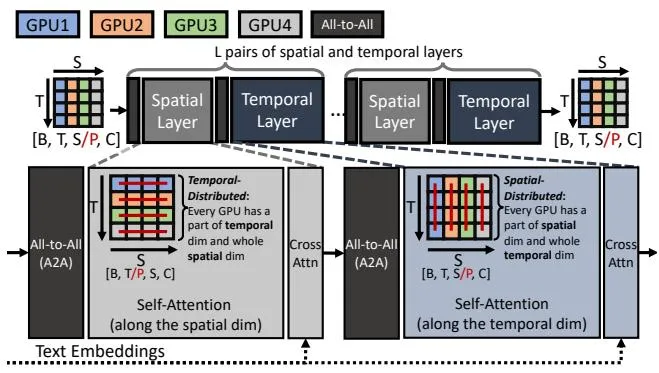
在P个GPU上执行ST-DiT的标准流程:
- 输入张量沿空间维度分割为P个分片
- 空间层执行前:All-to-All将空间分布式转换为时间分布式
- 时间层执行前:All-to-All将时间分布式转换回空间分布式
- 重复上述过程直到所有层执行完毕
核心公式
时空独立性原理:
对于空间层,输入张量沿时间维度分割为多个切片后可独立计算:
类似地,对于时间层:
通信开销分析:
使用层内调度后,通信开销降低为:
使用层间调度后,通信开销进一步降低为:
四、核心创新
挑战与机遇
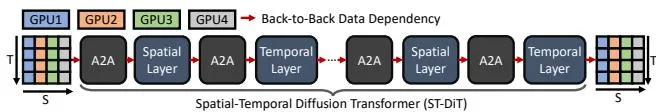
挑战1:计算与通信的背靠背依赖
- All-to-All操作的输入是前一层的输出
- 无法直接实现计算-通信重叠
机遇1:层内计算-通信重叠
- 空间层在时间维度上独立
- 时间层在空间维度上独立
- 可将层执行分割为多个独立切片
挑战2:切片数量增加导致加速递减
- 增加切片数可重叠更多通信
- 但也增加了计算开销(小CUDA kernel启动)
机遇2:层间计算-通信重叠
- 只分割通信操作,不分割计算操作
- 将部分通信提升到前一层执行
层内通信调度算法
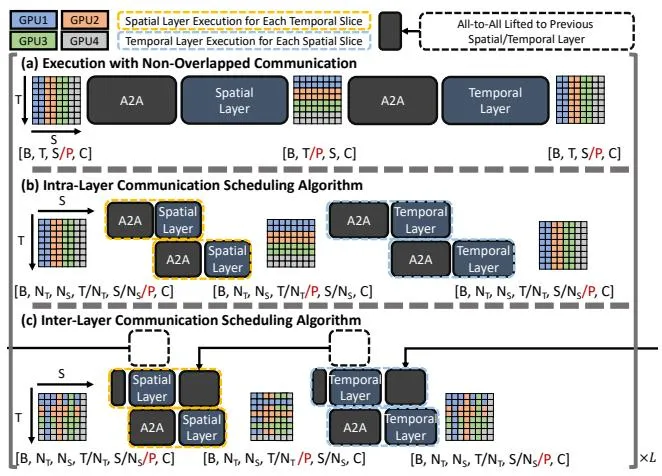
算法流程:
- 引入超参数 和 (时间/空间切片数)
- 重排输入张量为
- 对于空间层:
- 先执行第一个时间切片的All-to-All
- 然后流水线执行后续切片的通信和计算
- 对于时间层类似处理
效果:理想情况下,通信开销降低为
层间通信调度算法
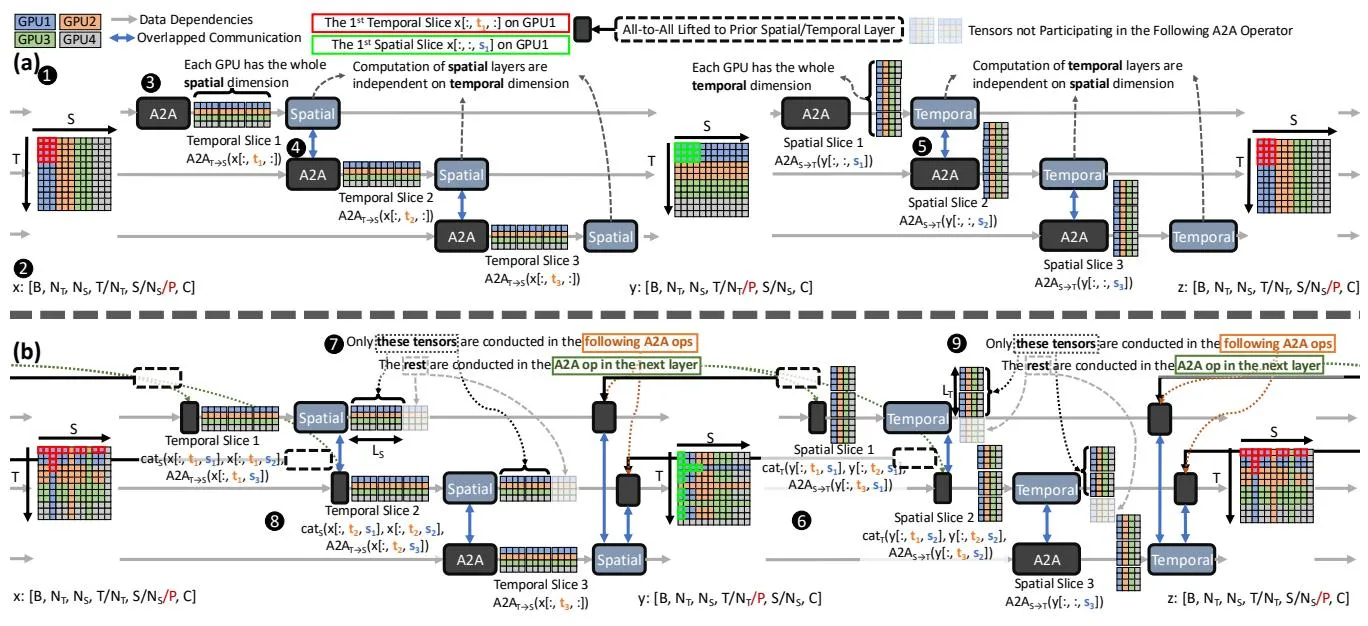
算法流程:
- 将All-to-All操作沿维度进一步分解
- 将前两个通信分区提升到前一层的最后一个切片执行
- 引入超参数 和 控制提升的通信分区数
效果:通信开销进一步降低为
额外收益:降低峰值内存使用(减少All-to-All临时缓冲区)
算法伪代码
输入: 输入张量 x [B,T,S/P,C], 模型 M, 切片数 N_T, N_S, 分区数 L_T, L_S
输出: 输出张量 [B,T,S/P,C]

1. 创建空张量 y [B,T/P,S,C]
2. 重排 x 为 [B,N_T,N_S,T/N_T,S/N_S/P,C]
3. 重排 y 为 [B,N_T,N_S,T/N_T/P,S/N_S,C]
4. 初始化第一层通信
5. for SpatialLayer, TemporalLayer in M:
6.   执行层内调度的All-to-All
7.   执行层间调度的提升通信
8.   执行空间/时间层计算
9.   启动下一层的通信
10. 重排 x 为 [B,T,S/P,C]
11. return x
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 硬件 | Amazon p4d.24xlarge (8× A100 40GB) |
| GPU连接 | NVSwitch (机内), AWS EFA 400Gbps (跨机) |
| 软件 | NVIDIA Driver 535.183.01, CUDA 12.2, NCCL v2.19.3, PyTorch v2.2.2 |
| 模型 | OpenSora v1.2 ST-DiT (1.1B参数) |
| 基线 | OpenSora (DeepSpeed-Ulysses), DSP |
| 超参数 | , , |
端到端性能
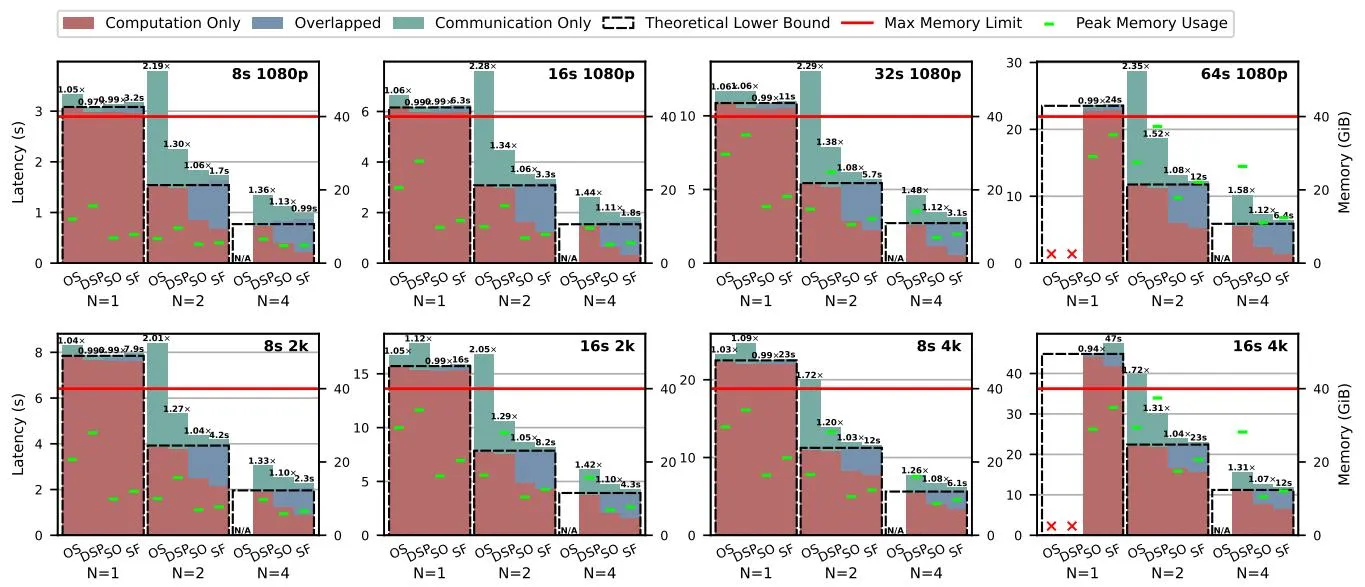
关键结果:
| 指标 | 2机器 | 4机器 |
|---|---|---|
| vs DSP平均加速 | 1.32× | 1.40× |
| vs DSP最大加速 | 1.52× | 1.58× |
| 强扩展加速 | 1.93× | 3.60× |
| 弱扩展效率 | 97% | 103% |
详细对比:
| 配置 | OpenSora | DSP | ScaleFusion (仅层内) | ScaleFusion (完整) |
|---|---|---|---|---|
| 1080p 8s (1机器) | 3.2s | 3.2s | 3.2s | 3.2s |
| 1080p 16s (2机器) | OOM | 5.4s | 4.5s | 3.3s |
| 1080p 32s (4机器) | N/A | 4.2s | 3.5s | 3.1s |
| 4k 8s (2机器) | OOM | 12.8s | 9.2s | 6.5s |
加速分解:
- 仅层内调度:平均1.26×加速(最高1.41×)
- 层间调度额外:平均1.08×加速(最高1.13×)
- 完整ScaleFusion:平均1.36×加速(最高1.58×)
峰值内存使用
| 对比 | 平均降低 | 最大降低 |
|---|---|---|
| vs OpenSora | 1.28× | 1.43× |
| vs DSP | 1.87× | 2.33× |
ScaleFusion可避免高分辨率/长视频生成时的OOM错误。
超参数敏感性分析
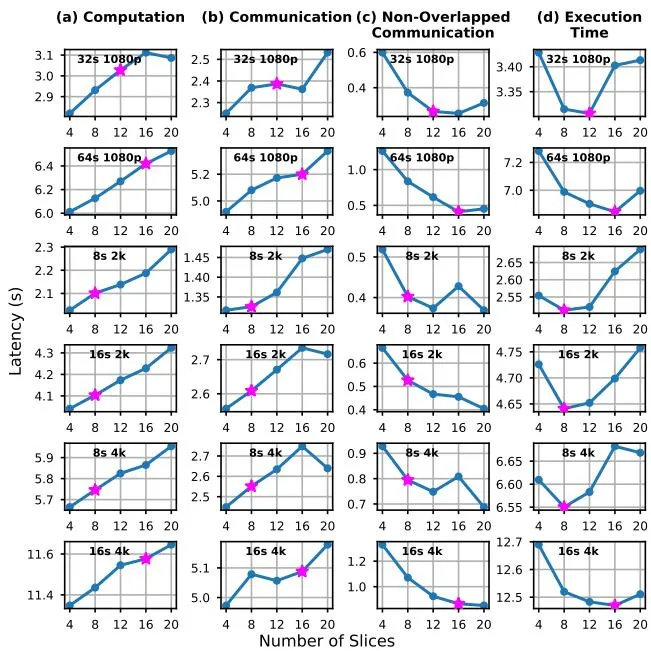
层内调度:
- 切片数增加可减少未重叠通信
- 但也增加计算开销
- 默认配置()接近最优(仅差2.7%)
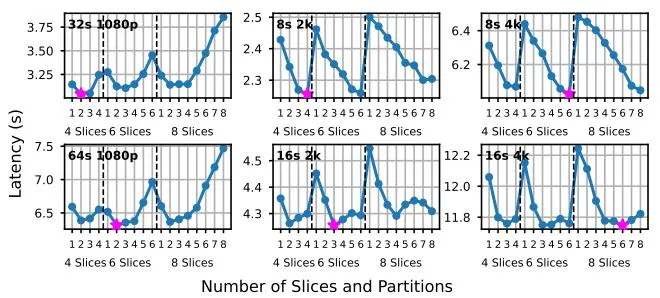
层间调度:
- 默认配置(, )接近最优(仅差0.7%)
- 时间层计算通常短于空间层,因此
六、相关工作
| 方法 | 特点 | 局限性 |
|---|---|---|
| DeepSpeed-Ulysses | All-to-All转置头和序列维度 | 无计算-通信重叠 |
| RingAttention | 环形通信的分布式注意力 | 跨机通信量大 |
| DSP | 动态序列并行 | 仍有高通信开销 |
| DistriFusion | 利用扩散模型的陈旧输入容忍性 | 有损优化,GPU越多质量越差 |
| PipeFusion | 流水线并行的扩散推理 | 需要修改模型结构 |
ScaleFusion优势:
- 无损算法,不牺牲生成质量
- 最小通信开销
- 与流水线并行正交,可组合使用
七、总结
核心贡献
- 识别时空独立性:发现ST-DiT中空间/时间层在另一维度上的独立性
- 层内通信调度:通过切片实现计算-通信重叠
- 层间通信调度:将通信提升到前一层执行,进一步减少开销
- 显著性能提升:平均1.36×加速(最高1.58×),强扩展3.60×(4机器)
技术影响
- 可扩展性:高效扩展到多GPU机器集群
- 内存效率:降低峰值内存使用,避免OOM
- 无损优化:不牺牲视频生成质量
- 通用性:适用于各种分辨率和时长的视频生成
局限性
- 模型依赖:主要针对ST-DiT架构优化
- 超参数调优:需要根据具体工作负载调整切片数
- 硬件依赖:需要高速跨机网络(如AWS EFA)
八、参考资源
- 论文:PDF
- 相关项目:OpenSora, DSP, DeepSpeed-Ulysses