FVAttn: Adaptive Sparse Attention with Runtime Load Balancing for Video Generation
面向视频 DiT 推理的训练无关稀疏注意力系统,通过运行时负载均衡(RLB)和松弛感知稀疏增强(SASA)解决 Top-p 路由在多 GPU 序列并行下的负载不均衡问题
FVAttn: Adaptive Sparse Attention with Runtime Load Balancing for Video Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FVAttn: Adaptive Sparse Attention with Runtime Load Balancing for Video Generation |
| 作者 | Hao Liu, Chenghuan Huang, Ye Huang, Zhiying Wen, Hao Liu, Mohan Zhang, Chen Li, Ziyang Ma, Jing Lyu, Jiangsu Du |
| 机构 | 中山大学 (Sun Yat-sen University), 腾讯微信 HPC, 腾讯微信 Vision, 北京大学 |
| 论文 | arXiv:2607.16190 |
| 代码 | 无公开仓库(GitHub 搜索未找到) |
| 发布 | 2026-07-17 |
| 许可 | arXiv.org perpetual non-exclusive license |
核心贡献:
- 首次发现并系统分析了训练无关稀疏注意力在多 GPU 序列并行下的运行时负载不均衡瓶颈:Top-p 自适应路由产生的 head 级工作负载差异在 Ulysses 并行下被放大为 rank 级 straggler 问题
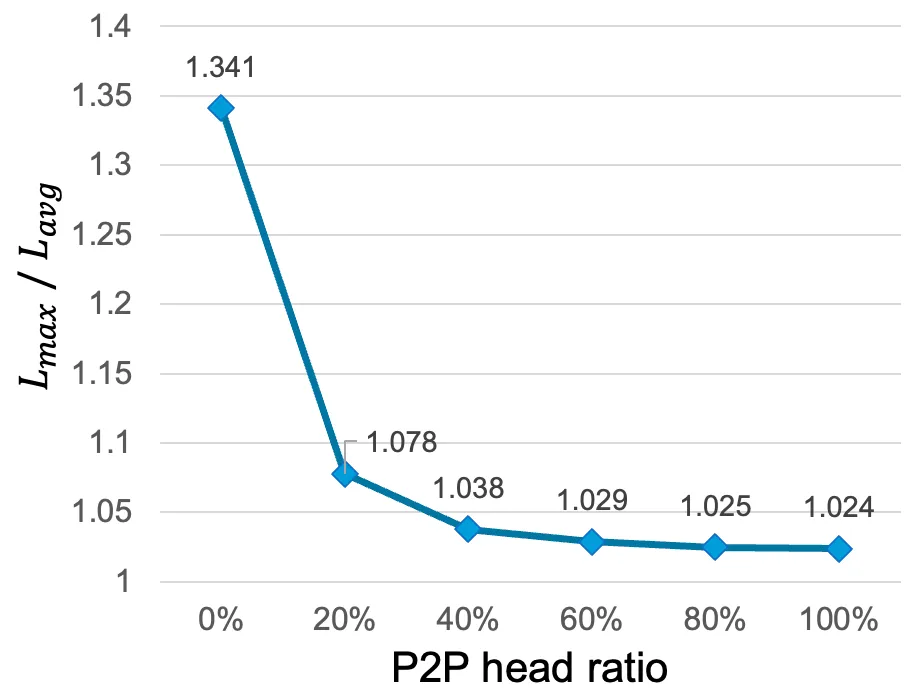
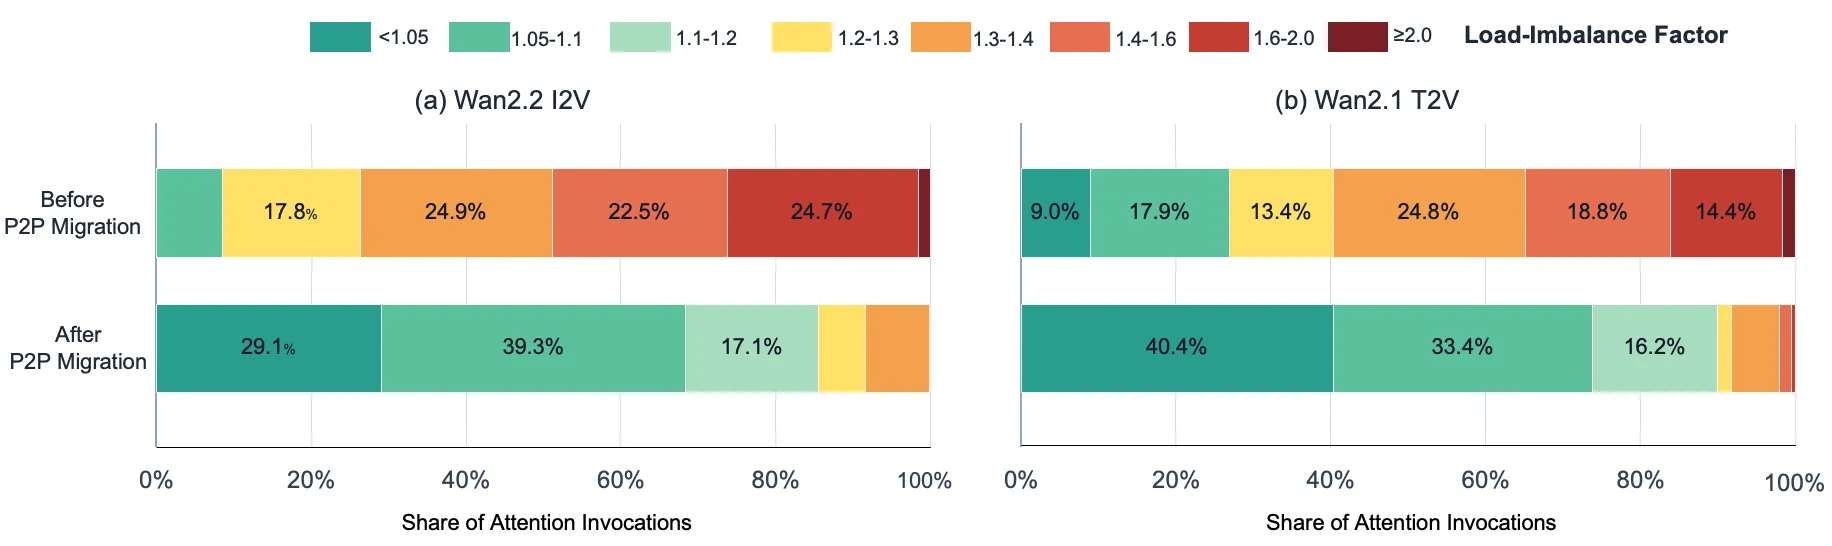
- 提出 Runtime Load Balancing (RLB)——一种基于已实现 per-head 工作负载的轻量级 P2P head 迁移机制,将平均负载不均衡因子从 1.34 降至 1.08
- 提出 Slack-Aware Sparse Augmentation (SASA)——将 RLB 后非关键 rank 的剩余松弛时间用于增加高价值 sparse block,在不延长全局延迟的前提下提升 mask 覆盖率
- 设计了 CPU-GPU 重叠和计算-通信重叠的高效执行框架,使运行时组件的可见开销仅占最终注意力的 1.87%
- 在 Wan2.2 I2V/Animate/T2V 上实现了 4.41× 注意力加速和 2.02–2.11× DiT 推理加速,同时保持有竞争力的视频质量
二、核心思想
问题定义
Video Diffusion Transformers (Video DiTs) 处理长时空 token 序列,自注意力成为高分辨率视频生成的主要瓶颈。以 Wan2.2-14B I2V 为例,在单张 NVIDIA H20 GPU 上生成 5 秒 720p 视频仍需约 2 小时,其中注意力占总推理时间的 74.1%。
训练无关稀疏注意力通过构建块级 mask 跳过低价值 query-key 交互来降低计算成本。其中 Top-p 路由因其自适应特性尤为吸引人——集中分布的 attention head 只需保留少量高质块,而平坦或多峰分布则可保留更多交互。然而,这种适应性在多 GPU 序列并行下引入了新的系统瓶颈:
Top-p 路由在不同 head 间产生不均匀的工作负载 → 在 Ulysses 风格的 sequence parallelism 下,All-to-All 操作将完整 attention heads 分配到各 GPU rank → 当多个高密度 head 被映射到同一 rank 时,该 rank 成为 straggler → 同步阶段其他 rank 必须空闲等待 → 稀疏性的理论效率增益被分布式执行开销部分抵消。
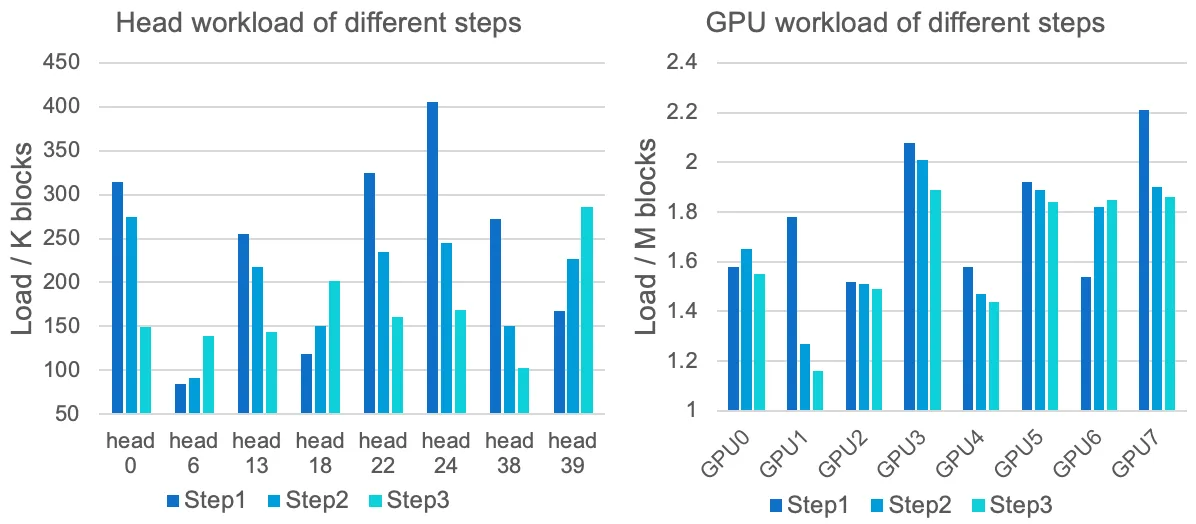
更关键的是,这种负载不均衡具有高度的运行时动态性。在 4-step 蒸馏设置中,相邻 step 间同一 head 密度的最大变化达 97%,同一 rank 负载的最大变化达 44%。这意味着基于历史稀疏性或离线 profiling 的预调度策略高度脆弱。
解决方案概述
FVAttn 的核心洞察是:Top-p 路由引入的负载不均衡高度局部化——大部分工作负载倾斜通常只集中在少数几个 heavy head 中。 因此,消除 attention straggler 不需要昂贵的全局 repartitioning,而是只需在 mask 材料化后识别并迁移少量过载 head 即可。
FVAttn 采用两阶段运行时调度策略:
- RLB (Runtime Load Balancing):在稀疏 mask 材料化后,根据已实现的 per-head 工作负载,通过受限的 P2P head 迁移修复关键路径
- SASA (Slack-Aware Sparse Augmentation):在 RLB 之后,将非关键 rank 的剩余松弛时间转化为额外的高价值 sparse block 计算
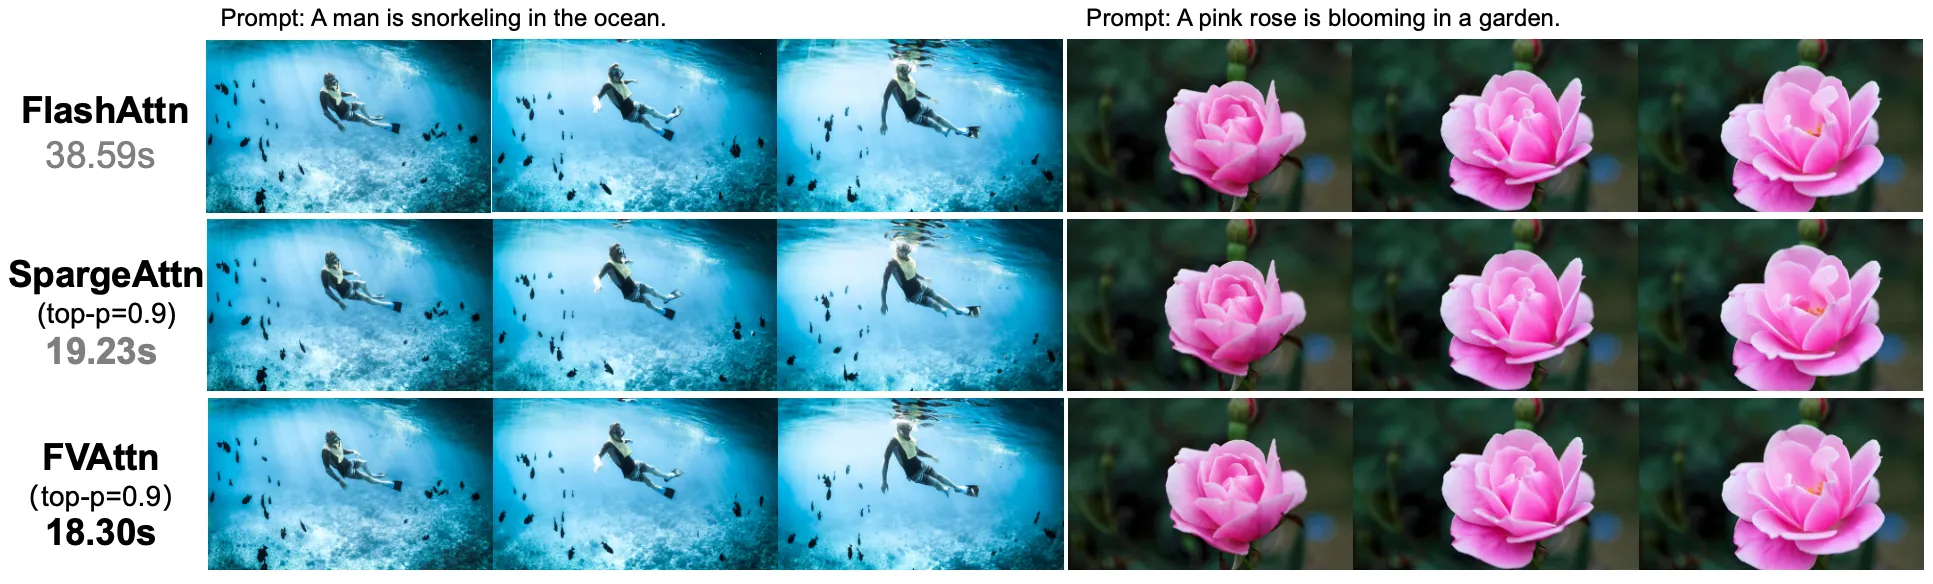
三、技术架构
整体框架
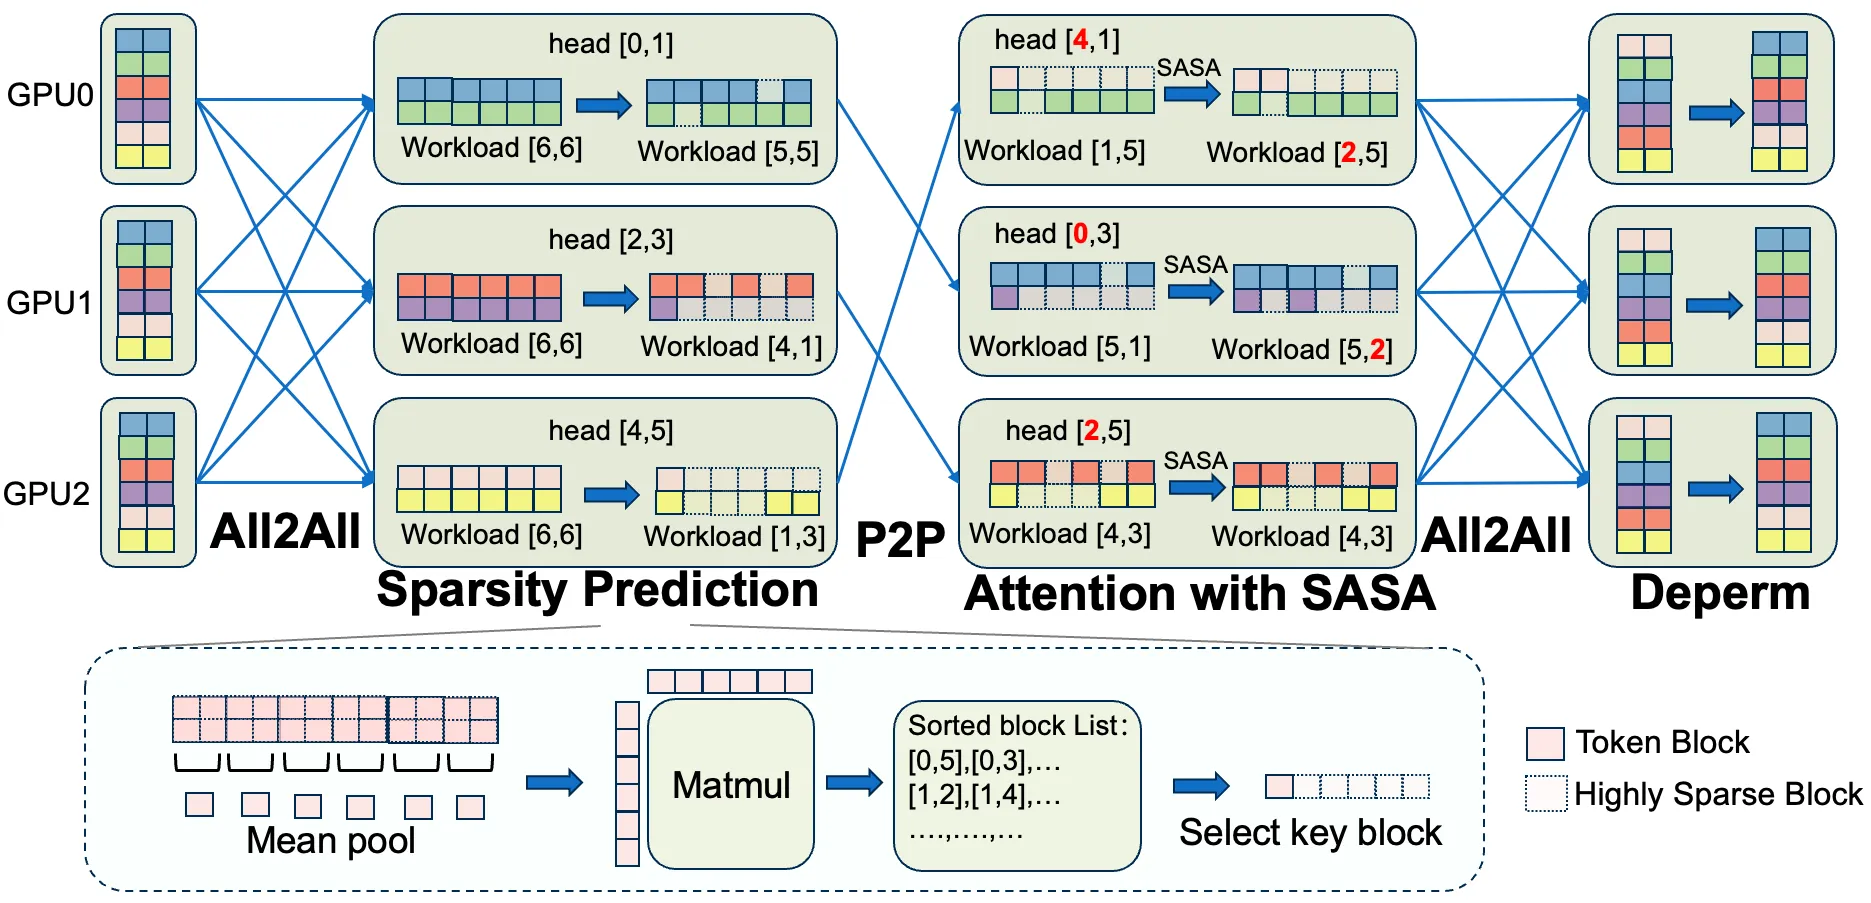
FVAttn 在 sequence-to-head All-to-All 之后执行两阶段运行时调度:
┌─────────────────────────────────────────────────────────────┐
│  Sequence-to-Head All-to-All                                 │
│  (将 sequence shards 转换为 head shards)                     │
└──────────────────────┬──────────────────────────────────────┘
                       ▼
┌─────────────────────────────────────────────────────────────┐
│  Stage 1: Sparse Mask Routing                                │
│  • Hilbert curve block reordering                            │
│  • Top-p CDF threshold → adaptive retained-block count       │
│  • Top-k safety floor against over-sparsification            │
│  • Output: per-head workloads + key-block importance order   │
└──────────────────────┬──────────────────────────────────────┘
                       ▼
┌─────────────────────────────────────────────────────────────┐
│  Stage 2: Runtime Load Balancing (RLB)                       │
│  • Profile realized per-head workload L_h                    │
│  • Compute rank workload L_r = Σ_{h∈H_r} L_h                │
│  • Solve constrained P2P head migration (σ*)                │
│  • Each rank migrates ≤1 local head (~20%)                   │
│  • Post-balance: L_r^new = L_r - L_hr + L_h_σ⁻¹(r)          │
└──────────────────────┬──────────────────────────────────────┘
                       ▼
┌─────────────────────────────────────────────────────────────┐
│  Stage 3: Slack-Aware Sparse Augmentation (SASA)             │
│  • Compute residual slack: ΔL_r = L_max^new - L_r^new       │
│  • Allocate budget: B_r = n₁ · ΔL_r (n₁=0.8)               │
│  • Add high-value blocks from sorted key-block order         │
│  • Trigger only when ΔL_r > n₂·L_max^new (n₂=0.07)         │
└──────────────────────┬──────────────────────────────────────┘
                       ▼
┌─────────────────────────────────────────────────────────────┐
│  Block-Sparse Attention Execution                             │
│  • V quantization + P2P migration overlap                    │
│  • Reverse All-to-All + head-order restoration               │
└─────────────────────────────────────────────────────────────┘
核心公式
负载度量(Eq. 1-2)
对于 attention head 和 rank (本地 head 集合 ):
负载不均衡因子:
其中 为 rank 数量。 表示均衡执行; 表示大量 GPU 在等待最慢 rank 时浪费计算时间。
RLB 收益模型(Eq. 3-6)
以 作为单个 sparse block 的单位计算时间,schedule 的关键路径收益:
净收益模型:
其中 为移动 head state 的通信开销, 为求解 migration plan 的调度开销。
P2P head migration 后的 rank workload:
最优迁移计划(lexicographic 目标):
其中 为满足 one-send-one-receive 约束且迁移不超过约 20% 本地 head 的候选 schedules。
SASA 松弛分配(Eq. 7-10)
非关键 rank 对当前关键路径的剩余松弛:
额外 sparse budget:
augmented workload:
可见关键路径开销:
FVAttn 通过两个条件使 :
- :每个 rank 的 augmentation budget 不超过其 residual slack
- 触发阈值 :仅在 时启动 augmentation
- 增强系数 :discount 为安全 sparse budget,为 kernel granularity 和估计误差留出余量
联合净收益(Eq. 11)
核心组件详解
3.1 Sparse Routing Frontend
FVAttn 的稀疏路由前端包含两个关键设计:
- Hilbert curve block reordering:沿 Hilbert 曲线重排 blocks,使空间相邻的 token 倾向于落入邻近的 blocks across scales,改进 routing-stage 的相似度估计
- Top-p + Top-k safety floor:Top-p 提供自适应计算预算,Top-k 作为安全网防止路由估计错误或过度稀疏化
3.2 Runtime Load Balancing (RLB)
为什么不做预测性预调度? 在 few-step video generation 中,相邻 step 间同一 head 密度的最大变化达 97%(Figure 2),预调度依赖过时信号。
为什么不做全 post-mask repartition? 需要另一次大规模 collective data movement, 过大导致 变小。
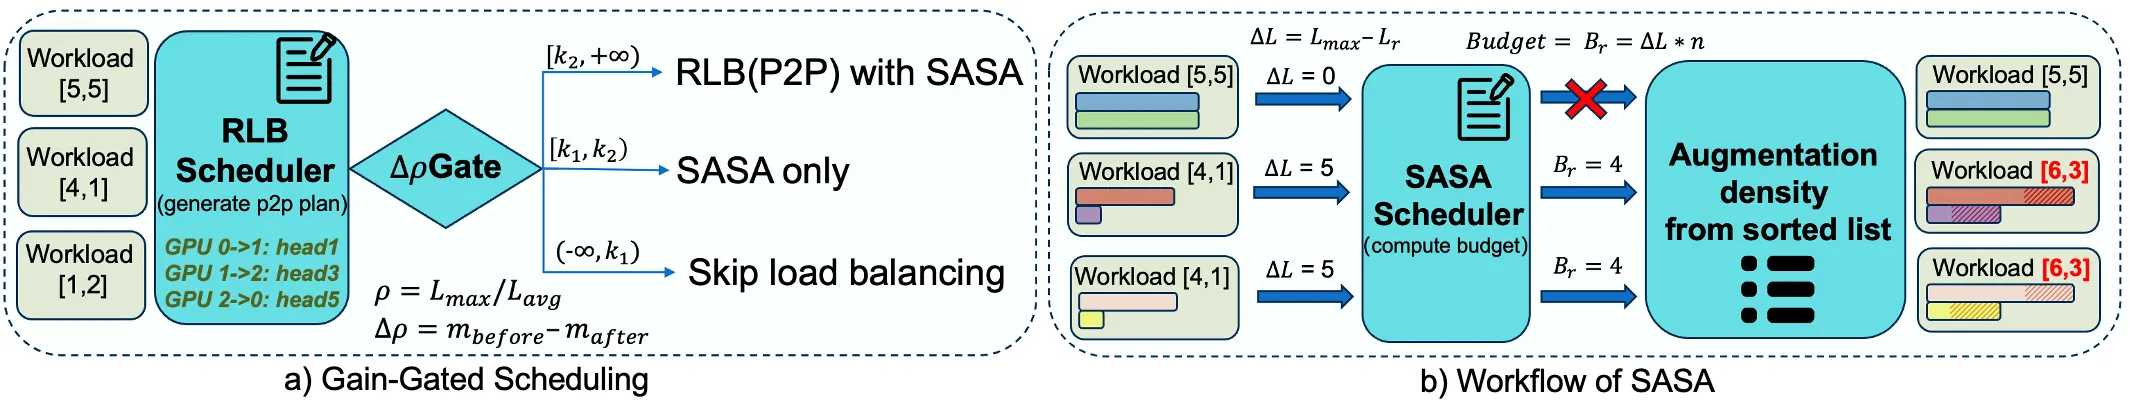
FVAttn 的第三条路:在受限的 P2P head-migration 空间中搜索高 gain schedule。观察到负载倾斜集中在少数 head 中,而非均匀分布在所有 head 上。在 Wan2.2 I2V 的 8-GPU 设置中,仅迁移 20% 的本地 head(每个 rank 最多一个 head),就将平均不均衡从 1.34 降至 1.08。
实现细节:
- 所有 rank 通过一个轻量级 all-gather 收集全局密度信息
- 由于信息在所有 rank 上相同且搜索是确定性的,每个 GPU 独立运行相同搜索
- 避免 rank-0 solve-and-broadcast 同步
- 在 8-GPU 设置中可构建 pair topologies,枚举 中的候选匹配
3.3 Slack-Aware Sparse Augmentation (SASA)
核心洞察:传统稀疏注意力将 mask routing 视为独立于推理环境的局部决策。RLB 后,非关键 rank 可能仍有剩余松弛时间。只要不超过全局 critical path,这些 idle time 可用于计算更多高价值 attention blocks。
与全局提高 Top-p 的区别:全局提高阈值会增加所有 rank 的工作负载并延长 critical path;SASA 仅在具有测量 slack 的非关键 rank 上追加未选中的 high-value blocks。
Piecewise 启用策略:
| 负载状态 | 行为 |
|---|---|
| () | 接近均衡,跳过额外机制 |
| () | 仅启用 SASA,使用当前 post-mask 工作负载的 slack |
| 先启用 RLB 修复 critical path,再在 RLB 后的 residual slack 上应用 SASA |
3.4 Efficient Implementation
两条异步重叠路径:
- CPU-GPU overlap:CPU 搜索 RLB plan 并计算部分 SASA budget 时,GPU 执行必需的 V quantization
- Computation-Communication overlap:P2P head migration 异步发出后,runtime 对非迁移 heads 执行 V quantization 和 SASA augmentation,仅在迁移 states 被消费时同步
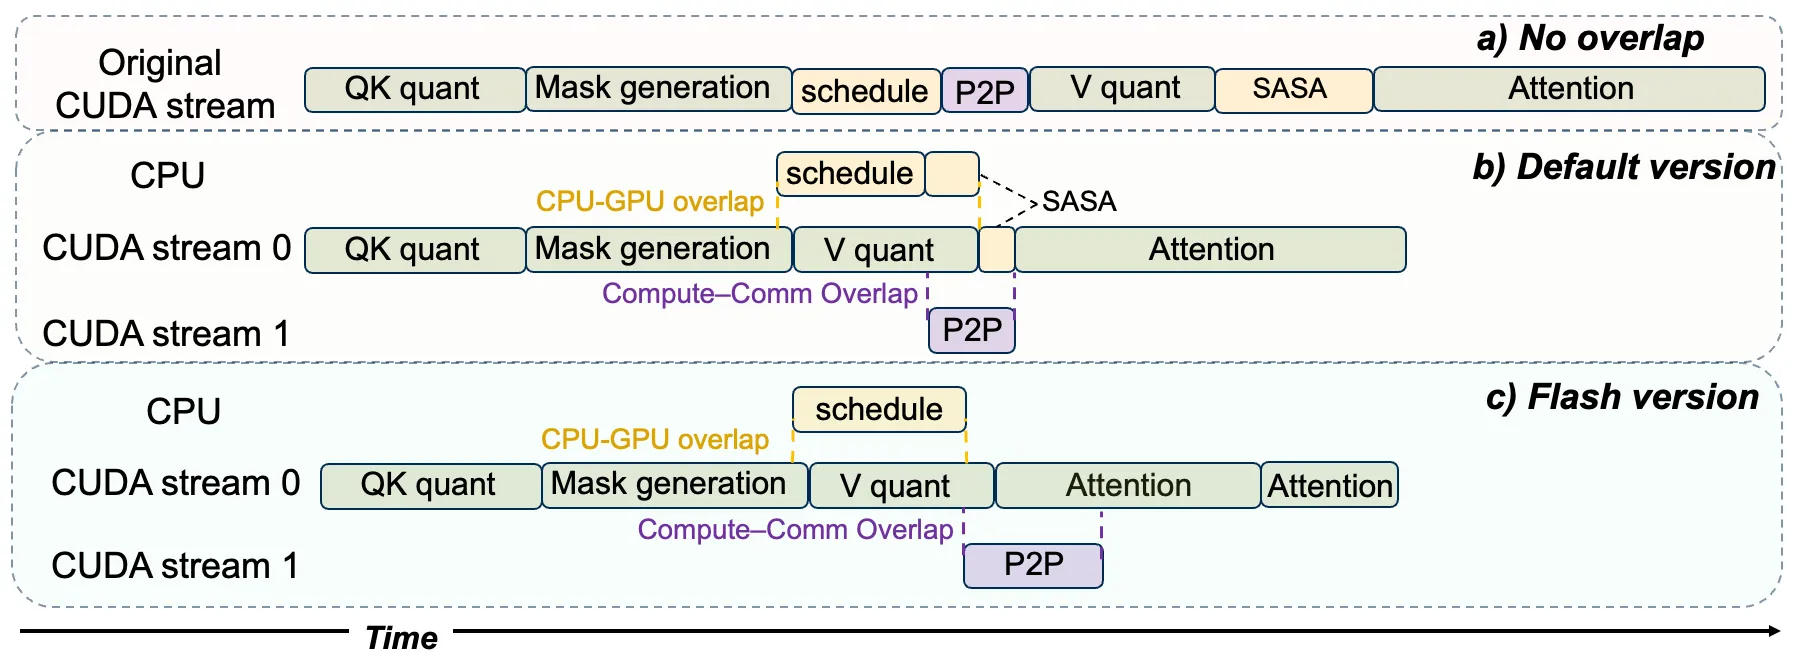
Overlap/Opt. 进一步移除不必要的 CPU-GPU 同步, streamlined runtime management 和 kernel launches。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 运行时负载不均衡的发现 | 首次系统分析 Top-p 路由在多 GPU 序列并行下的 straggler 效应 | Figure 2: 相邻 step head 密度变化达 97% |
| RLB: 受限 P2P head 迁移 | 不在全局 repartition 和预测预调度之间选择,而是在受限 P2P 空间中搜索高 gain schedule | Eq. (3)-(6): 收益模型 |
| SASA: 松弛时间转化 | 将非关键 rank 的 idle time 转化为有用的 sparse-mask coverage | Eq. (7)-(10): |
| Piecewise 启用策略 | 根据可观测的 值渐进启用机制,避免低不均衡时的不必要开销 | 阈值 |
| 双重叠执行 | CPU-GPU + 计算-通信双路径隐藏运行时开销 | Table 5: 可见开销仅 1.87% |
| Hilbert curve block reordering | 改进 routing-stage 的相似度估计质量 | Section 3.1 |
五、实验结果
实验设置
| 配置项 | 值 |
|---|---|
| GPU | 8× NVIDIA H20 (NVLink 连接) |
| CUDA | 13.1 |
| Models | Wan2.2 I2V 14B, Wan2.2 Animate 14B, Wan2.1 T2V 14B |
| Distillation | LightX2V 4-step distilled LoRA |
| Video | 720p, 81 frames (21 latent frames, 3,600 tokens/latent frame) |
| Parallelism | Ulysses sequence parallelism |
| Baselines | FlashAttention, SageAttention, SpargeAttention, SVG2, Jenga, db-SP |
I2V 和 T2V 端到端结果(Table 1)
Wan2.2-14B-I2V (4 steps):
| 方法 | VBench | PSNR | SSIM | LPIPS | CLIP-Sim | DiT Latency | Speedup |
|---|---|---|---|---|---|---|---|
| FlashAttention (Dense) | 88.7% | – | – | – | – | 38.59s | 1.00× |
| SageAttention (Dense) | 88.7% | 25.414 | 0.8420 | 0.0868 | 0.9922 | 21.20s | 1.82× |
| SpargeAttention Top-p=0.95 | 88.3% | 22.400 | 0.7728 | 0.1261 | 0.9880 | 19.92s | 1.94× |
| SpargeAttention Top-p=0.90 | 88.2% | 21.477 | 0.7425 | 0.1472 | 0.9857 | 19.23s | 2.01× |
| SpargeAttention+RLB+SASA Top-p=0.90 | 88.3% | 21.807 | 0.7513 | 0.1381 | 0.9865 | 18.84s | 2.05× |
| FVAttn Top-p=0.95 | 88.8% | 23.801 | 0.8092 | 0.1045 | 0.9906 | 19.10s | 2.02× |
| FVAttn Top-p=0.90 | 88.8% | 23.473 | 0.8024 | 0.1091 | 0.9903 | 18.30s | 2.11× |
Wan2.1-14B-T2V (4 steps):
| 方法 | DiT Latency | Speedup |
|---|---|---|
| FlashAttention | 34.70s | 1.00× |
| FVAttn Top-p=0.90 | 14.96s | 2.32× |
| SpargeAttention+RLB+SASA | 15.31s | 2.27× |
Animate 端到端结果(Table 2)
| 方法 | PSNR | SSIM | LPIPS | CLIP-Sim | DiT Latency | Speedup |
|---|---|---|---|---|---|---|
| FlashAttention | – | – | – | – | 36.95s | 1.00× |
| SageAttention | 22.259 | 0.8386 | 0.1131 | 0.9871 | 17.96s | 2.06× |
| FVAttn-Base (Top-p=0.95) | 22.182 | 0.8343 | 0.1239 | 0.9848 | 16.40s | 2.25× |
| FVAttn (Top-p=0.95) | 22.640 | 0.8488 | 0.1066 | 0.9873 | 15.21s | 2.43× |
| FVAttn (Top-p=0.90) | 21.512 | 0.8257 | 0.1291 | 0.9851 | 14.79s | 2.50× |
| Jenga | 21.534 | 0.8256 | 0.1314 | 0.9831 | 22.24s | 1.66× |
| SpargeAttention (Top-k=0.60) | 21.188 | 0.8169 | 0.1400 | 0.9824 | 15.71s | 2.35× |
| SVG2 (Top-p=0.95) | 21.002 | 0.8167 | 0.1389 | 0.9817 | 29.14s | 1.27× |
注意力运行时消融(Table 4)
| 方法 | Attention Latency | Final | Speedup vs. Flash |
|---|---|---|---|
| FlashAttention | 165.60 ms | 1.00 | 1.00× |
| FVAttn-Base (Top-p=0.95) | 45.91 ms | 1.34 | 3.61× |
| + RLB | 41.32 ms | 1.08 | 4.01× |
| + RLB + SASA | 41.33 ms | 1.01 | 4.00× |
| + RLB + SASA + Overlap/Opt. | 37.54 ms | 1.01 | 4.41× |
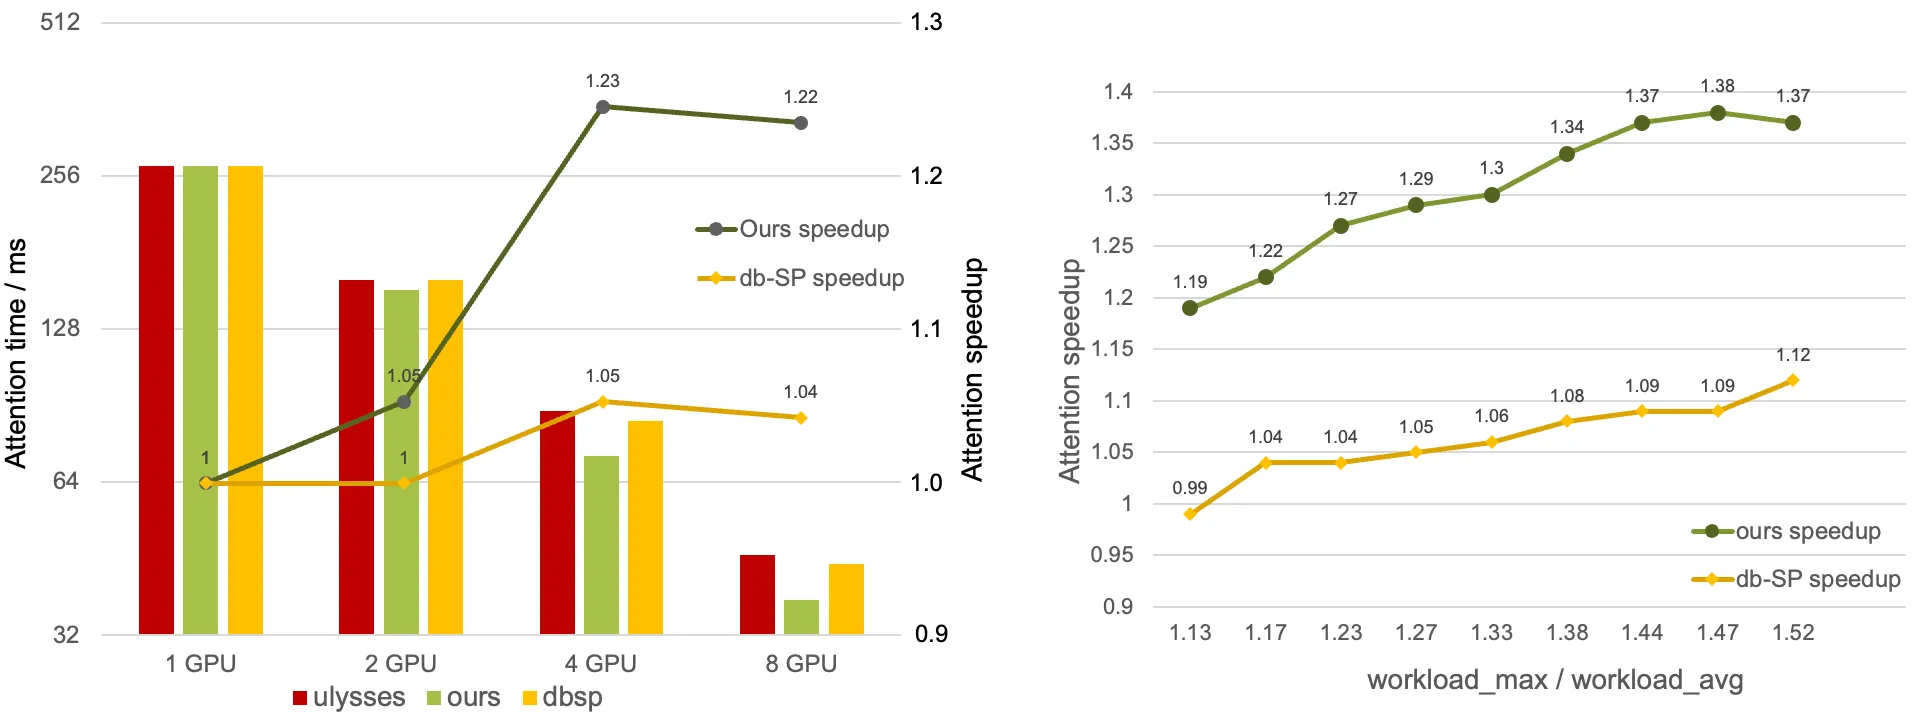
| FVAttn-Base + db-SP | 44.17 ms | 1.22 | 3.75× |
关键发现:
- RLB 将 从 1.34 降至 1.08,注意力延迟从 45.91ms 降至 41.32ms
- SASA 进一步将有效 降至 1.01(非关键 rank 通过 augmentation 追平)
- Overlap/Opt. 在保持 不变的情况下,从 41.33ms 降至 37.54ms
运行时开销分解(Table 5)
| Component | Standalone Added Cost | Ratio w.r.t. Attention | Visible after Overlap/Opt. | Visible Ratio |
|---|---|---|---|---|
| Density exchange | ~0.3 ms | 0.72% | ~0.1 ms | 0.27% |
| Balance plan search | ~0.5 ms | 1.21% | ~0.1 ms | 0.27% |
| P2P head migration | ~0.6 ms | 1.45% | ~0.1 ms | 0.27% |
| Slack-aware augmentation | ~0.5 ms | 1.21% | ~0.2 ms | 0.53% |
| Head-order restoration | ~0.1 ms | 0.24% | ~0.1 ms | 0.27% |
| Other overhead | ~0.6 ms | 1.45% | ~0.1 ms | 0.27% |
| Total | ~2.6 ms | 6.28% | ~0.7 ms | 1.87% |
参考注意力延迟:41.4 ms (standalone) / 37.5 ms (after Overlap/Opt.)
负载不均衡分布(Figure 7)
多 GPU 扩展性(Figure 8)
五、代码实现分析
本文未公开代码仓库。但文中提供了关键的实现参数和算法伪代码逻辑:
关键超参数
| 参数 | 值 | 说明 |
|---|---|---|
| 1.05 | SASA-only 启用阈值 | |
| 1.10 | RLB+SASA 启用阈值 | |
| RLB 迁移比例 | 20% | 每个 rank 最多迁移 1 个 local head |
| (augmentation coeff.) | 0.8 | SASA 增强系数 |
| (trigger threshold) | 0.07 | SASA 触发阈值 |
| 首步密集注意力 | 25% | 前 25% 的 denoising steps 执行 dense attention |
| Top-p 操作点 | 0.95 (quality), 0.90 (speed) | 主要评估配置 |
RLB 算法流程
1. After sparse mask materialization, compute per-head workload L_h
2. Compute rank workload L_r = Σ_{h∈H_r} L_h
3. One lightweight all-gather to share global density info
4. Each rank independently solves: σ* = argmin(max_r L_r^new, Var_r(L_r^new))
   subject to: σ ∈ S_20%, one-send-one-receive constraint
5. Execute P2P head migration: rank r sends h_r to σ(r), receives from σ⁻¹(r)
6. Post-balance workload: L_r^new = L_r - L_hr + L_h_σ⁻¹(r)
SASA 算法流程
1. Compute residual slack: ΔL_r = L_max^new - L_r^new
2. If ΔL_r > n_2 * L_max^new (trigger condition):
   a. Allocate budget: B_r = n_1 * ΔL_r
   b. From already sorted key-block importance order:
      add unselected high-value blocks until budget B_r is consumed
   c. Update mask in place (no extra sorting or QK scoring needed)
3. Augmented workload: L_r^aug = L_r^new + B_r
4. Ensure B_r ≤ ΔL_r to prevent new straggler creation
重叠执行调度
Stream 1 (CPU):    [search RLB plan] → [compute SASA budget]
Stream 2 (GPU):    [V quantization] ← overlaps with CPU search
Stream 3 (GPU):    [non-migrated head attn] ← overlaps with P2P migration
Stream 4 (Net):    [P2P head migration] ← overlaps with computation
Stream 5 (GPU):    [SASA augmentation] ← overlaps with P2P migration
Sync:              [wait for migrated states] → [reverse All-to-All]
六、相关方法对比
| 方法 | 策略 | 适用场景 | 局限性 |
|---|---|---|---|
| db-SP | 全局 head/block 级 repartition,跨 step 复用规划 | 稳定稀疏模式 | Few-step video 中历史布局易过时 |
| S-HPLB | 基于 offline-profiled sparsity 的 head placement | 静态稀疏模式 | 无法适应运行时变化 |
| DSA | 利用结构化稀疏模式构建专用 parallel layout | 固定稀疏模式 | 不适用于 Top-p 自适应路由 |
| OSP-Next | 稀疏 sequence parallelism + hif8 quantization + RL | 视频生成 | 需要训练 |
| FVAttn (Ours) | 基于当前 workloads 的 P2P head migration + SASA | Few-step video DiT | 依赖 GPU 间通信带宽 |
七、总结
核心贡献
- 问题发现:首次系统揭示 Top-p 自适应稀疏路由在多 GPU 序列并行下引发的 rank-level straggler 问题,以及 few-step video generation 中相邻 step 间高达 97% 的 head 密度变化
- RLB 机制:通过受限 P2P head 迁移(每 rank 最多 1 个 head,约 20%)将负载不均衡因子从 1.34 降至 1.08,无需全局 repartition
- SASA 机制:将 RLB 后非关键 rank 的剩余松弛时间转化为额外的高价值 sparse block 计算, 进一步降至 1.01
- 高效执行:CPU-GPU 重叠 + 计算-通信重叠使运行时组件的可见开销仅占最终注意力的 1.87%
- 综合加速:在 Wan2.2 I2V 上实现 4.41× 注意力加速和 2.11× DiT 推理加速,同时提升视频质量指标
局限性
- 短序列效果有限:对于短序列或注意力稀疏性较弱的任务(如许多图像生成任务),稀疏注意力节省和负载均衡收益均相应减少
- 硬件依赖:收益依赖硬件的通信-计算比。在 H20 类服务器上,轻量级 P2P 迁移和重叠可有效隐藏运行时开销;但在 PCIe 连接设备上,head migration 的收益可能受限
- 仅验证 Ulysses 风格并行:主要在 Ulysses-style sequence parallelism 和 few-step video DiT 推理上验证,Ring Attention、USP 等其他并行策略下的适用性尚待探索
- 仅训练无关:专注于推理加速,未涉及 training-time sparse attention
- 参数需重新校准:阈值 、增强系数 和触发阈值 需根据硬件的 kernel-launch overhead 和 communication-to-computation ratio 重新校准
未来方向
- 探索在 Ring Attention、USP 等更多并行策略下的适用性
- 扩展到更多样化的硬件拓扑
- 探索 training-time sparse attention 的负载均衡
- 针对 PCIe 连接设备等不同硬件配置优化迁移预算和重叠策略
八、参考资源
- 论文: arXiv:2607.16190
- Wan2.2: Wan: Open and Advanced Large-Scale Video Generative Models
- LightX2V: Light Video Generation Inference Framework
- FlashAttention: Fast and Memory-Efficient Exact Attention
- SageAttention: Accurate 8-bit Plug-and-Plug Inference Acceleration
- SpargeAttention: Accurate Sparse Attention Accelerating Any Model Inference
- SVG2: Sparse Videogen2: Accelerate Video Generation with Sparse Attention
- db-SP: Dual-Balanced Sequence Parallelism for Visual Generative Models
- VBench: Comprehensive Benchmark Suite for Video Generative Models
- Ulysses: System Optimizations for Enabling Training of Extreme Long Sequence Transformer
附图索引
| 编号 | 文件名 | 说明 |
|---|---|---|
| Figure 1 | figure-1-visual-result.png | FVAttn 整体效果:结合高效稀疏注意力与运行时负载均衡 |
| Figure 2 | figure-2-load-crossstep.png | Step-to-step workload variation(head 密度变化 97%,rank 负载变化 44%) |
| Figure 3 | figure-3-overview.png | FVAttn 架构总览(mask routing → RLB → SASA → block-sparse attention) |
| Figure 4 | figure-4-imbalance-factor.png | 不同 RLB head-migration budget 下的 load-imbalance factor |
| Figure 5 | figure-5-adaptive-compute.png | (a) 根据可观测负载不均衡启用运行时机制; (b) SASA 工作流 |
| Figure 6 | figure-6-opt-overlap.png | Overlapped execution schedule |
| Figure 7 | figure-7-lb-distribute-show.png | RLB 前后的 load-imbalance factor 分布 |
| Figure 8 | figure-8-speedup-cross-multigpus.png | 不同 GPU 数量和初始不均衡程度下 RLB 的表现 |
附表格索引
| 编号 | 说明 |
|---|---|
| Table 1 | I2V 和 T2V 端到端结果(FlashAttention vs. SageAttention vs. SpargeAttention vs. FVAttn) |
| Table 2 | Wan2.2 Animate 端到端结果(FVAttn vs. Jenga vs. SpargeAttention vs. SVG2) |
| Table 3 | Wan2.2 Animate 端到端消融(RLB 和 SASA 的独立效果) |
| Table 4 | Wan2.2 I2V 注意力运行时消融(各组件对 attention latency 和 final imbalance 的影响) |
| Table 5 | FVAttn 添加的运行时组件的增量开销分解(standalone vs. visible cost) |