FlashDecoder: Real-Time Latent-to-Pixel Streaming Decoder with Transformers
A fast, memory-efficient pure-Transformer video decoder that decodes latents to pixels frame by frame using a rolling KV cache, achieving 3.6x-4.7x faster throughput and up to 11x less GPU memory compared to convolutional decoders.
FlashDecoder: Real-Time Latent-to-Pixel Streaming Decoder with Transformers
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FlashDecoder: Real-Time Latent-to-Pixel Streaming Decoder with Transformers |
| 作者 | Minguk Kang, Suha Kwak |
| 机构 | Pika Labs / POSTECH |
| 论文 | https://arxiv.org/abs/2607.14898 |
| 代码 | 未提供 |
| 发布 | 16 Jul 2026 |
| 许可 | 未明确 |
二、核心思想
问题定义
实时视频生成不仅需要快速的去噪(denoising),还需要快速的解码(decoding)。当前基于潜在扩散模型(LDM)的视频生成管线中,VAE 解码器将潜在表示重建为像素。现有的视频解码器主要依赖 3D 因果卷积网络,虽然重建质量良好,但速度慢且内存密集,在高解析度或长视频场景下需要空间-时间分块(tiling),导致多次解码器评估和延迟增加。
Transformer 解码器在理论上可以满足四个理想属性:(1) 逐帧解码无需填充或混合;(2) 重建质量与卷积解码器竞争;(3) 快速推理且具有稳定的每帧延迟和有界内存;(4) 高分辨率和长持续时间解码无需空间-时间分块。然而,现有 Transformer 解码器面临质量-流式传输的权衡:因果注意力需要显式因果掩码,难以高效训练高分辨率;双向注意力质量更好但不能流式传输。
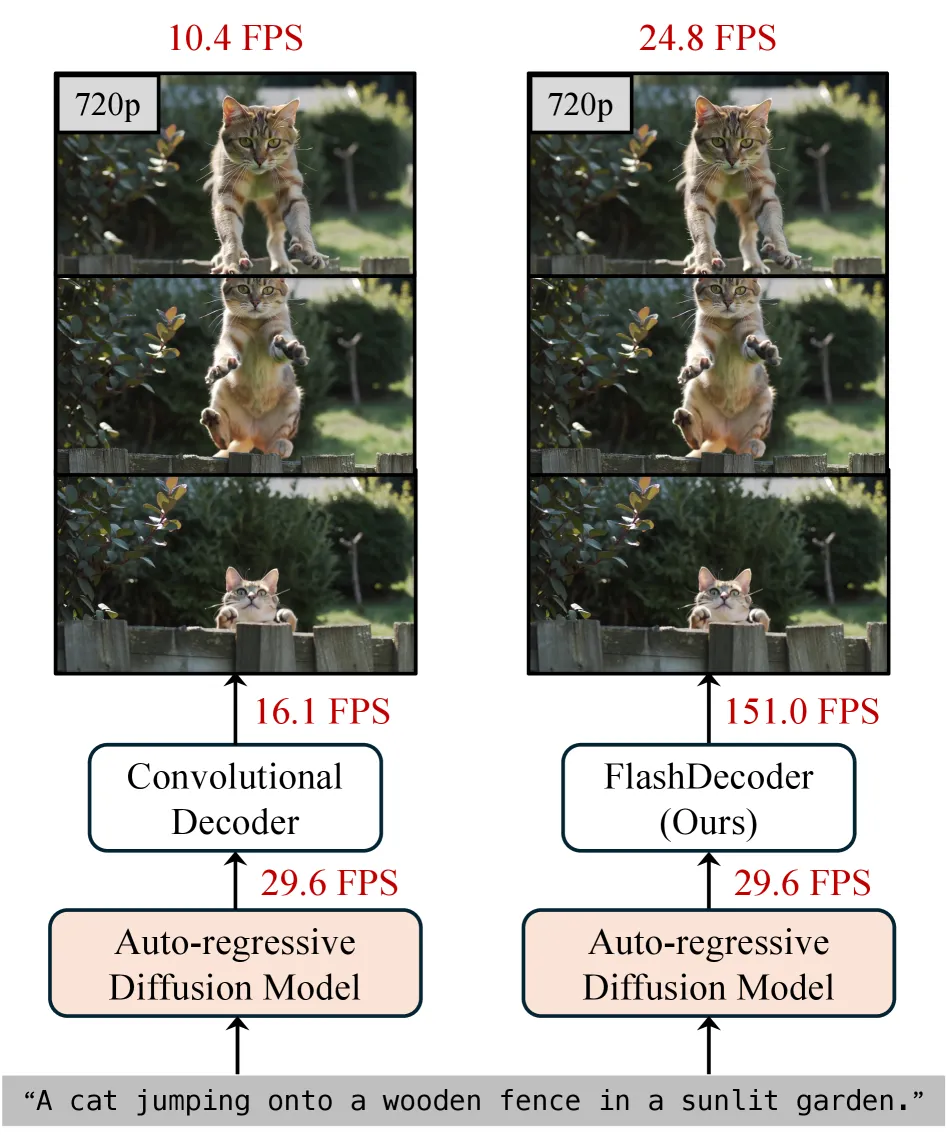
Wan2.2 解码器在 720p 下,VAE 解码占总推理时间的 64.6% 以上(Figure 1)。
解决方案概述
本文提出 FlashDecoder,一个快速、内存高效的纯 Transformer 视频解码器,逐帧将潜在编码为像素。其核心设计包括:
- 滚动 KV 缓存:每个潜在帧仅通过固定大小的滚动 KV 缓存关注前 Wfrm=2 个帧,使解码速度恒定且内存有界,不受视频长度影响
- 因果性通过处理顺序强制:而非显式注意力掩码,使得因果性天然满足且无需 FlashAttention 兼容的掩码
- 先时序后空间的升采样策略:由于 Transformer 中空间升采样导致注意力成本为 O(rs^4),而时序升采样仅为 O(rt^2),因此先通过通道扩展和 Transformer 层进行时序升采样,再通过 MLP + PixelShuffle 进行空间升采样
- 流式训练-推理一致性:训练和推理遵循相同的流式协议,模型始终只看到 Wfrm 帧
三、技术架构
整体框架
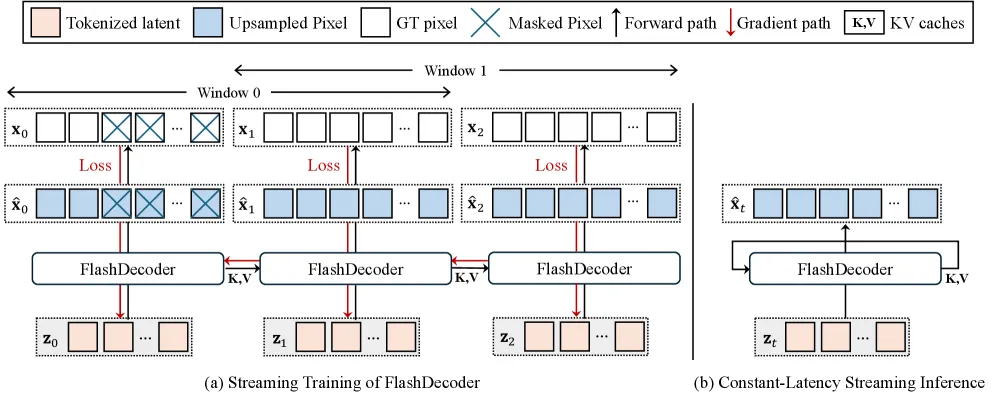
FlashDecoder 是一个纯 Transformer 解码器,将视频潜在编码逐帧转换为像素。每个潜在帧 zt 首先被线性投影,然后通过具有固定大小滚动 KV 缓存的 Transformer 主干网络处理(存储最近 Wfrm 帧),接着通过通道扩展进行时序升采样(因子 rt),最后通过 MLP 和 PixelShuffle 进行空间升采样(因子 rs)。
核心公式
潜在扩散模型框架(公式 1-2):
潜在投影(公式 3):
其中 为每个帧的空间 token 数。
KV 缓存更新(公式 4):
其中 为 KV 组数(使用 Grouped-Query Attention)。
时序升采样(公式 5):
总损失函数(公式 6):
其中 为像素级 L1 损失, 为感知损失, 为基于 3D patch 判别器的对抗损失。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Backbone Transformer | 带 GQA 的自注意力+FFN,RMSNorm 前置,SiLU FFN | D=1536, 20 blocks (XL) |
| Rolling KV Cache | 固定窗口大小 Wfrm=2,每帧仅关注自身和前1帧 | Wfrm=2, G=3 groups |
| Latent Projection | 线性层将潜在通道映射到模型维度 | C’→D |
| Temporal Refinement | 2个Transformer块,使用扩展窗口 Wfrm_full = rt·Wfrm | rt=4 |
| Spatial Upsampling | 2层MLP + PixelShuffle | rs=16 (16×16 latent) |
| Loss Function | L1 + LPIPS + Adversarial (3D PatchGAN) | λ_L1=1.0, λ_LPIPS=0.25 |
流式推理算法(Algorithm 1)
输入: 潜在 z ∈ R^(B×C'×T'×H'×W') for any T'
输入: 窗口大小 Wfrm
输入: 每帧token数 Lfrm = H'W'
输入: 升采样因子 rt(时序), rs(空间)
输入: 主干 Transformer B, 时序细化 Transformer R

初始化 (KB, VB) ← ∅, (KR, VR) ← ∅
初始化输出 x̂ ← []

for t = 0, …, T'-1 do
    Pt ← Project(z[:, :, t:t+1, :, :])
    // Backbone处理,RoPE偏移 t·Lfrm
    Yt, (KB_t, VB_t) ← B(Pt, KB, VB, t)
    KB ← concat(tail_(Wfrm-1)Lfrm(KB), KB_t)
    VB ← concat(tail_(Wfrm-1)Lfrm(VB), VB_t)

    // 时序升采样:通道 → 时序轴
    Pt_temp ← Linear_D→rtD(Yt)
    Pt_full ← Reshape(Pt_temp)
    // 时序细化,扩展窗口 Wfrm_full = rt·Wfrm
    Yt_full, (KR_t, VR_t) ← R(Pt_full, KR, VR, t)
    KR ← concat(tail_rt(Wfrm-1)Lfrm(KR), KR_t)
    VR ← concat(tail_rt(Wfrm-1)Lfrm(VR), VR_t)

    // 空间升采样
    Ft ← MLP_D→Cr_s²(Yt_full)
    x̂_t ← PixelShuffle(Ft, rs)
    x̂ ← concat(x̂, x̂_t)
end
复杂度分析
注意力成本:,与时间窗口 Wfrm 和头数 N 成线性关系,与空间 token 数 Lfrm 成二次方关系。
KV 缓存内存: per layer,与视频长度 T’ 无关——这是常数内存的关键。
训练-推理一致性
FlashDecoder 的独特性质是训练和推理遵循完全相同的流式协议:模型在两个阶段都从未同时看到超过 Wfrm 帧。传统方法在一个前向传播中加载所有 T’ 帧,需要完整的注意力掩码和随视频长度线性增长的内存。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 纯Transformer流式解码器 | 首个同时支持流式传输和高重建质量的纯Transformer视频解码器 | Table 2 对比 |
| 滚动KV缓存 | 固定大小窗口使内存和延迟与视频长度无关 | Eq. 4, Complexity Analysis |
| 因果性通过处理顺序 | 无需显式掩码即可强制时序因果性 | Sec. 3.3 |
| 先时序后空间升采样 | 解决Transformer中空间升采样的 O(rs^4) 注意力成本问题 | Sec. 3.4 |
| 流式训练-推理一致性 | 训练和推理使用相同协议,消除域间隙 | Sec. 3.5, Algorithm 1 |
五、代码实现分析
论文未提供开源代码。但从描述中可推断实现要点:
- 骨干网络:Grouped-Query Attention Transformer blocks with RMSNorm before each sublayer and SiLU activation in FFN
- 流式推理:每个帧级前向传播具有固定的、数据独立计算图,适合 CUDA graph capture
- 推理优化:torch.compile kernel fusion、CUDA graph capture、预计算 RoPE 表、FlashAttention-3 自定义算子、静态校准 FP8 量化
六、实验结果
基准测试
Table 1 — 组件消融实验(FlashDecoder-S,480p,17帧):
| 组件 | PSNR ↑ | LPIPS ↓ | rFVD ↓ | FPS ↑ |
|---|---|---|---|---|
| Baseline (blockwise causal) | 30.30 | 0.16 | 117.77 | 331.4→16.6 |
| (a) + SW-CA | 30.20 | 0.15 | 136.08 | 333.8 |
| (b) + GQA | 30.13 | 0.14 | 121.87 | 340.7 |
| (c) + Temporal Refinement | 31.05 | 0.13 | 86.94 | 260.3 |
| (d) + Spatial Upsampling | 31.49 | 0.12 | 96.19 | 262.1 |
| (e) + Scale-up (56.8M→769.3M) | 32.56 | 0.09 | 44.74 | 166.0 |
| (f) + Streaming training | 37.52 | 0.05 | 12.29 | 166.0 |
| (g) + Adversarial | 37.08 | 0.05 | 10.77 | 166.0 |
关键发现:
- 基线模型的 KV 缓存随视频长度线性增长,吞吐量从 331.4 崩溃到 16.6 FPS
- 流式训练引入带来最大质量提升(PSNR 从 32.56→37.52,rFVD 从 44.74→12.29)
- Temporal Refinement 带来最大的单项增益(rFVD: 121.87→86.94)
Table 2 — 视频重建基准(UltraVideo,25帧clip,单H100):
4×16×16 压缩组:
| 方法 | 720p PSNR | 720p rFVD | 720p FPS | 720p Mem(GB) | 1080p PSNR | 1080p Mem(GB) |
|---|---|---|---|---|---|---|
| Wan2.2† | 38.29 | 10.39 | 16.1 | 19.3 | 41.49 | 41.0 |
| FlashDecoder-XL† | 37.46 | 12.13 | 76.1 | 2.4 | 40.74 | 3.6 |
| FlashDecoder-XL-Opt† | 37.17 | 14.02 | 152.0 | 1.5 | 40.44 | 2.3 |
FlashDecoder-XL 在 720p 上以 3.6x-4.7x 更高吞吐量和最多 11x 更低峰值内存(2.4GB vs 41.0GB at 1080p)接近 Wan2.2 的 PSNR 和 LPIPS。
4×8×8 压缩组:
| 方法 | 720p PSNR | 720p rFVD | 720p FPS | 720p Mem(GB) |
|---|---|---|---|---|
| Wan2.1† | 37.43 | 12.43 | 15.9 | 16.4 |
| FlashDecoder-XL† | 37.46 | 12.13 | 76.1 | 2.4 |
FlashDecoder-XL 在 Wan2.1 潜在空间上达到与 Wan2.1 相当的质量(37.46 vs 37.43 PSNR),吞吐量高 4.8x,内存低 6.8x。
Transformer-based Decoders 对比:
| 方法 | 480p PSNR | 480p rFVD | 能否流式 |
|---|---|---|---|
| OmniTokenizer‡ | 17.25 | 60.40 | 是(但质量低) |
| MAGI-1 | 35.08 | 42.24 | 否 |
| AToken | 35.08 | ~42 | 否 |
| FlashDecoder-XL | 35.92 | 11.62 | 是 |
FlashDecoder-XL 以 2.5x-13x 更高的吞吐量实现比 MAGI-1 和 AToken 更好的重建质量,且支持流式传输。
消融实验
Table 4 — 窗口大小消融(720p,25帧,FlashDecoder-XL):
| Wfrm | PSNR | LPIPS | rFVD | FPS | Mem(GB) |
|---|---|---|---|---|---|
| 2 | 38.38 | 0.05 | 12.75 | 76.3 | 2.4 |
| 3 | 38.13 | 0.05 | 12.71 | 67.8 | 2.5 |
| 4 | 38.49 | 0.05 | 12.87 | 60.6 | 2.6 |
Wfrm=2 提供了最佳权衡:与 Wfrm=4 相似的质量,更低的内存(2.4 vs 2.6 GB)和更高的吞吐量(76.3 vs 60.6 FPS)。表明对于潜在解码,仅关注一个前一帧就提供足够的时序上下文。
Table 5 — 模型缩放分析(224×224,150K迭代,480p评估):
| 模型 | Depth | Width(D) | Heads(N) | KV Groups(G) | Params(M) | PSNR | rFVD | FPS | Mem(GB) |
|---|---|---|---|---|---|---|---|---|---|
| S | 12 | 512 | 8 | 2 | 56.8 | 30.90 | 89.23 | 254.5 | 0.3 |
| B | 16 | 768 | 12 | 3 | 161.7 | 31.15 | 72.36 | 205.2 | 0.6 |
| L | 20 | 1024 | 16 | 4 | 348.0 | 32.13 | 63.81 | 164.3 | 1.0 |
| XL | 20 | 1536 | 24 | 3 | 769.3 | 33.81 | 31.00 | 166.0 | 1.9 |
重建质量随模型规模稳步提升:PSNR 从 30.90 升至 33.81,rFVD 从 89.23 降至 31.00。即使 FlashDecoder-XL 也舒适地保持所有分辨率下的实时流式性能。
长视频解码
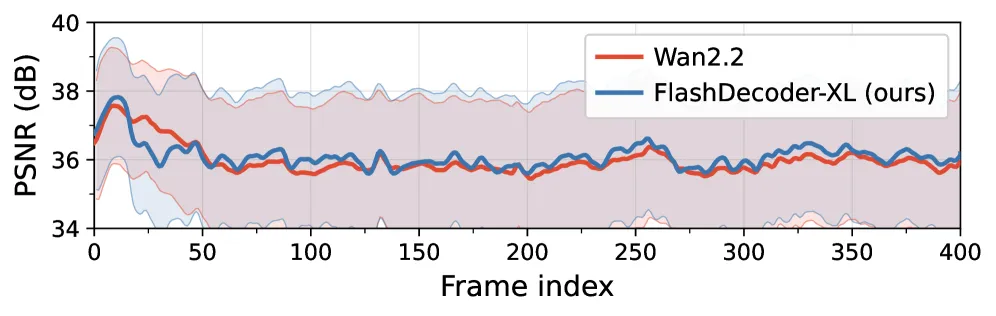
由于 KV 缓存窗口固定,FlashDecoder 保持与视频长度无关的恒定内存。Figure 4 显示在 720p 下超过 400 帧的视频上,FlashDecoder-XL 保持稳定的重建质量。RoPE 位置相对于当前窗口分配,而非绝对帧索引,使位置编码始终保持在训练期间看到的范围内。
推理优化
FlashDecoder 的流式架构特别适合推理优化,因为每个帧级前向传递具有固定的、数据独立的计算图。应用四种渐进优化:
- torch.compile:融合 elementwise 操作(RMSNorm、SiLU、残差连接)为单个 GPU kernel
- CUDA graph capture:消除每步 Python 分发和 kernel 启动开销
- 预计算 RoPE 表 + FlashAttention-3 自定义算子:移除动态分配和 graph break
- 静态校准 FP8 量化:利用 H100 FP8 Tensor Cores 提高 matmul 吞吐量
FP8 量化带来质量权衡:PSNR 下降 0.06-0.71 dB,rFVD 增加最多 0.94(Table 2 FlashDecoder-XL-Opt)。
跨潜在空间泛化
Table 3 — 不同编码器潜在空间上的泛化(720p,25帧):
| Encoder | Decoder | PSNR | LPIPS | rFVD | FPS | Mem(GB) |
|---|---|---|---|---|---|---|
| Wan2.1 | Wan2.1 | 37.43 | 0.04 | 12.43 | 15.9 | 16.4 |
| Wan2.1 | FlashDecoder-XL | 37.46 | 0.05 | 12.13 | 76.1 | 2.4 |
| Wan2.2 | Wan2.2 | 38.29 | 0.04 | 10.39 | 16.1 | 19.3 |
| Wan2.2 | FlashDecoder-XL | 38.38 | 0.05 | 12.75 | 76.3 | 2.4 |
FlashDecoder 不绑定于特定编码器。在 Wan2.1 潜在空间(8×8 空间压缩)上,通过 PixelUnshuffle 因子 2 折叠额外空间维度,FlashDecoder-XL 达到与 Wan2.1 相当的质量,吞吐量高约 5x,内存低 8x。
定性比较
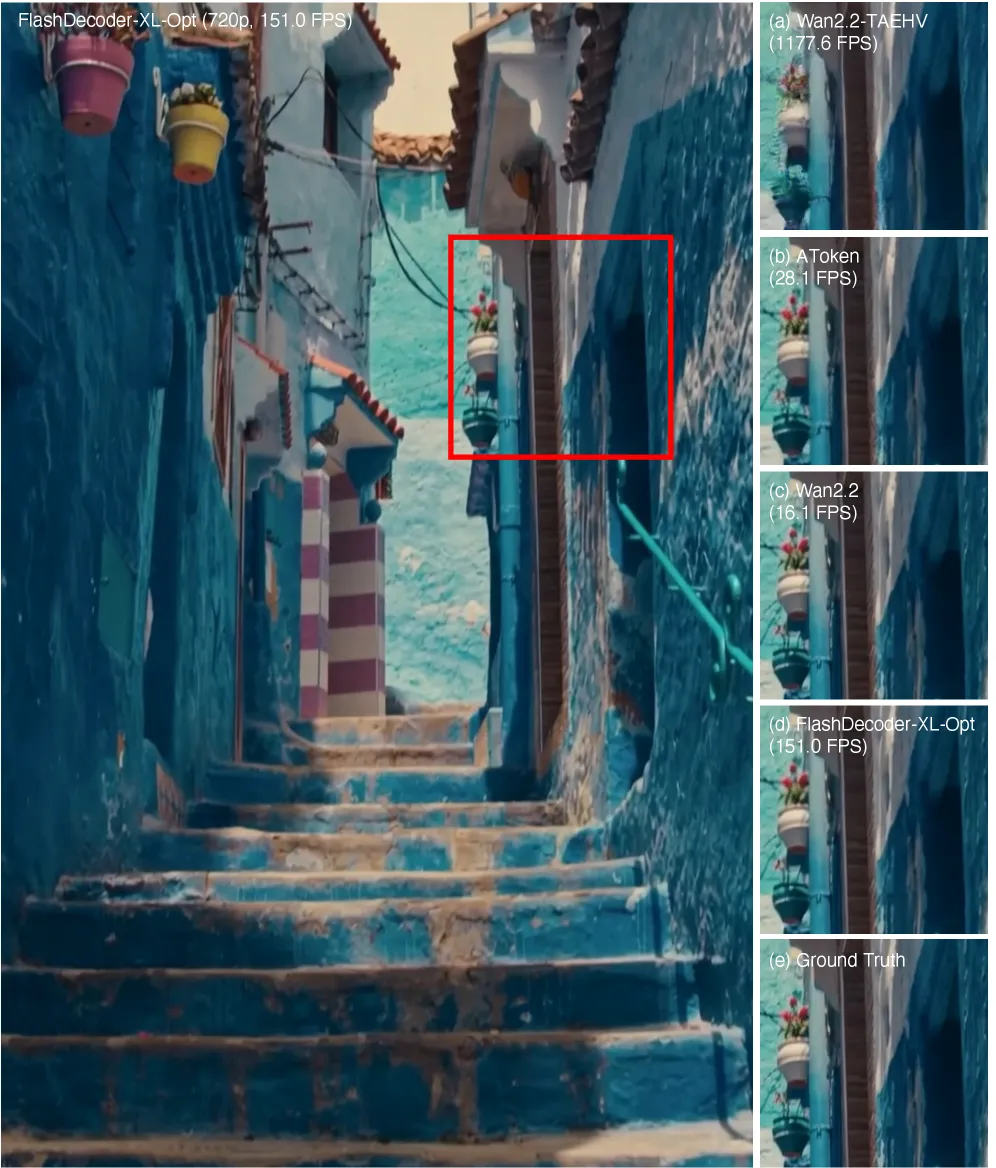
Wan2.2-TAEHV 和 AToken 产生模糊但更平滑的输出,而 Wan2.2 和 FlashDecoder-XL-Opt 产生视觉上可比的高质量输出,且 FlashDecoder 吞吐量高出 9x 以上。
七、相关工作
| 工作 | 方法 | 局限 |
|---|---|---|
| 3D 因果卷积解码器 (Wan2.2, HunyuanVideo) | 时空卷积 | 慢,内存密集,需分块 |
| OmniTokenizer | Transformer + 因果掩码 | 质量低 |
| MAGI-1, AToken | Transformer + 双向注意力 | 不能流式传输,吞吐量随视频长度退化 |
| TAEHV, TurboVAED | 轻量卷积 | 质量-速度权衡 |
| FlashDecoder (本文) | 纯Transformer + 滚动KV缓存 | 流式传输 + 高质量 + 高分辨率 |
八、总结
核心贡献
- 纯Transformer流式解码器:FlashDecoder 是首个同时满足流式传输、高质量重建、恒定内存和高分辨率训练的纯Transformer视频解码器
- 滚动KV缓存机制:固定时间窗口使内存和延迟与视频长度无关,理论上支持无限长度解码
- 先时序后空间升采样:解决Transformer中空间升采样的 O(rs^4) 注意力成本问题
- 生产级性能:在 Wan2.1 和 Wan2.2 潜在空间上匹配卷积解码器质量,吞吐量高 3.6x-12x,内存低至 11x
技术影响
为实时视频生成中的解码器瓶颈提供了一种新的架构范式,证明通过处理顺序而非显式掩码强制因果性是可行的,且能够消除高分辨率训练中的内存障碍。
局限性
- 仅替换解码器:保持预训练卷积编码器固定,潜在空间继承编码器的空间局部性偏好;Transformer 编码器-解码器对会学到什么仍是未探索的问题
- rFVD 差距:FlashDecoder-XL 在 rFVD 上落后于 Wan2.2 和 HunyuanVideo,尽管 PSNR 和 LPIPS 可比——这很可能是由于训练计算量差异
- 单节点训练:仅在 8 GPU 节点上训练,而生产解码器可能使用了显著更多的计算和数据