Cosmos 3: Omnimodal World Models for Physical AI
NVIDIA全模态世界模型,统一语言、图像、视频、音频和动作的理解与生成,为Physical AI提供通用骨干网络
Cosmos 3: Omnimodal World Models for Physical AI
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Cosmos 3: Omnimodal World Models for Physical AI |
| 作者 | NVIDIA |
| 机构 | NVIDIA |
| 论文 | NVIDIA Research |
| 代码 | github.com/nvidia/cosmos |
| 发布 | 2026年 |
| 许可 | Linux Foundation OpenMDW-1.1 License |
| 模型 | Cosmos3-Super, Cosmos3-Nano |
二、核心思想
Cosmos 3是NVIDIA推出的全模态世界模型家族,旨在统一处理和生成语言、图像、视频、音频和动作序列。核心创新在于:
- 统一框架:将VLM、视频生成器、世界模拟器、世界-动作模型整合到单一网络架构中
- Mixture-of-Transformers (MoT):双塔架构,AR子序列用于推理,扩散子序列用于生成
- 统一动作表示:将异构具身控制映射到共享几何结构的紧凑动作向量
- Physical AI定位:为机器人、自动驾驶、智能基础设施提供通用骨干网络
问题定义
当前Physical AI面临的核心挑战:
- 训练瓶颈:在真实世界中训练智能体缓慢、昂贵且危险
- 架构碎片化:VLM(感知)、视频生成器(模拟)、VLA/WAM(动作)各自独立
- 数据稀缺:高质量多模态训练数据难以获取
解决方案概述
Cosmos 3通过全模态统一架构解决上述问题:
- 根据输入-输出配置无缝切换操作模式:VLM、文本到图像生成、视频生成、世界-动作模型
- 通过共享表示和联合多任务监督实现可扩展学习
- 支持合成数据生成、任务特定专业化、训练环境构建三种应用场景
三、技术架构
整体框架图
Cosmos 3作为Physical AI的通用骨干网络,统一建模语言、图像、视频、音频和动作的理解与生成,整合了多种模型类别:视觉语言模型、图像生成模型、音视频生成模型、策略/世界-动作模型、前向动力学模型、逆动力学模型。
编码器设计
视觉编码器(双编码器):
- 理解编码器:ViT编码器,16×16 patch大小,两层MLP合并2×2 token,使用DeepStack聚合视觉特征
- 生成编码器:Wan2.2-TI2V-5B的视频VAE编码器,时间压缩4×,空间压缩32×32(16×16空间压缩+2×2 patch合并)
音频编码器:
- 采用Lee et al. (2025b)的音频VAE架构
- 48kHz立体声,hop size 1920,25 tokens/秒
动作编码器:
- 统一动作表示:ego poses(智能体主观测帧)、effector poses(执行器)、grasp states(抓取状态)
- 使用6D旋转表示(Zhou et al., 2019)
- 域感知输入/输出投影层,共享MoT骨干
核心公式
动作token化:
其中 是潜在动作token, 是域标识符。
动作解码:
Token排列:
- AR子序列:语言token + ViT编码的视觉token,用于推理和理解
- 扩散子序列:VAE编码的视觉token + 音频token + 动作token,用于生成
文本到图像序列:
其中 , 是噪声图像token。
文本到视频序列:
图像到视频/视频到视频序列:
视频转换序列:
Mixture-of-Transformers (MoT) 架构
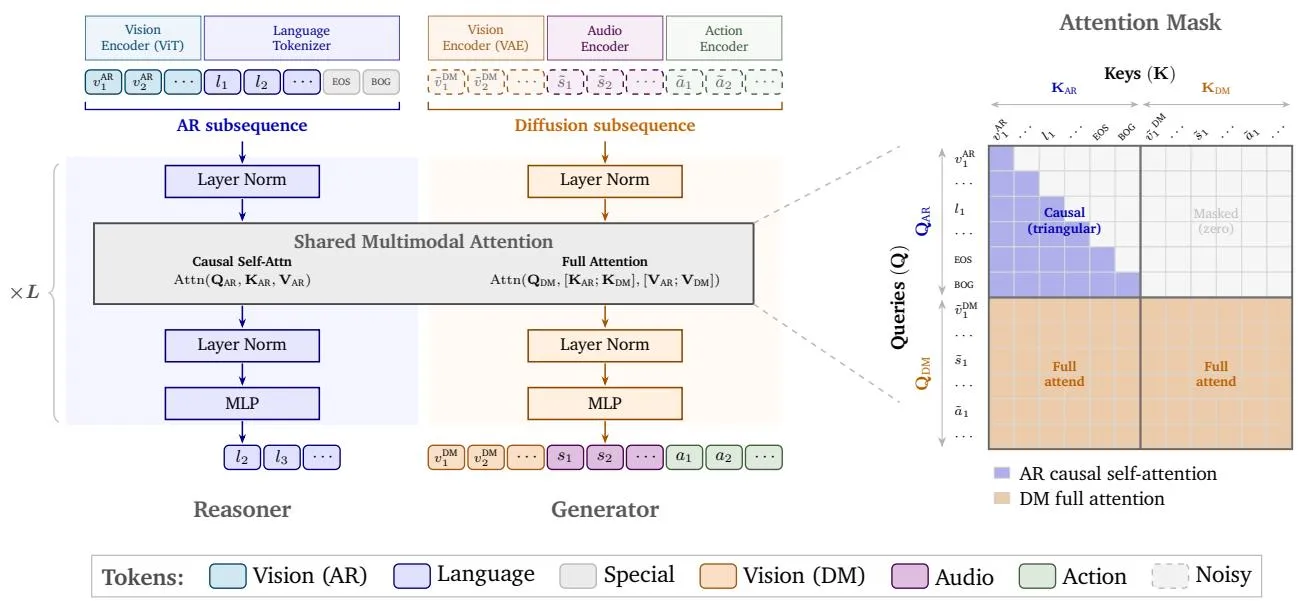
双塔层结构:
- 每个Transformer解码器层包含两套参数:推理塔(AR子序列)和生成塔(扩散子序列)
- 两个塔都从预训练VLM初始化,继承语言和视觉推理能力
双流联合注意力:
-
AR子序列注意力:因果自注意力,保持自回归属性
-
扩散子序列注意力:全双向注意力,AR和DM token的联合作为key/value
关键特性:AR token永远不会基于DM token更新,保持条件路径的因果完整性。
多模态位置嵌入
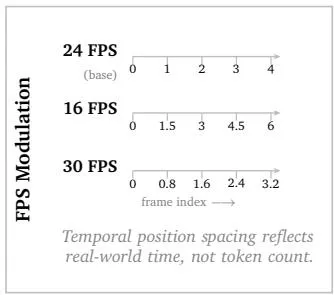
3D MRoPE设计:
- 时间、高度、宽度三个分量
- 语言token:t = h = w,退化为标准1D RoPE
- 视觉token:t随时间帧索引,h和w平铺空间网格
- 音频/动作token:仅时间坐标(h = w = 0)
FPS调制:
其中 (24 FPS / 4时间压缩比),对齐不同帧率的物理时间轴。
AR-DM时间间隔:在AR和扩散子序列之间插入15000的时间间隔,避免过饱和和棋盘伪影。
模型变体
| 变体 | 总参数 | 密集参数 | LLM层数 | 隐藏维度 | 注意力头 | KV头 | FFN维度 |
|---|---|---|---|---|---|---|---|
| Cosmos3-Edge | 4B | 2B | 28 | 2,048 | 16 | 8 | 9,216 |
| Cosmos3-Nano | 16B | 8B | 36 | 4,096 | 32 | 8 | 12,288 |
| Cosmos3-Super | 64B | 32B | 64 | 5,120 | 64 | 8 | 25,600 |
- Edge:从头训练的2B密集Transformer
- Nano:基于Qwen3-VL 8B初始化
- Super:基于Qwen3-VL 32B初始化
训练流程
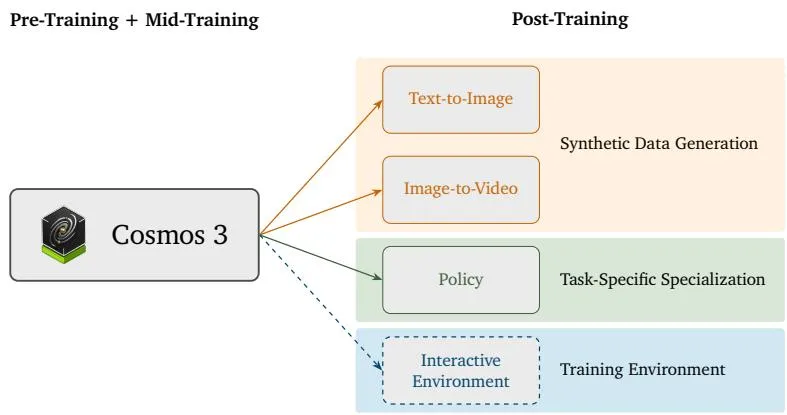
Reasoner训练:
- 预训练:22M样本,以图像-文本和文本为主(OCR 42.9%,2D Grounding 16.5%,Visual QA 11.3%)
- 监督微调:2.2M样本,转向Physical AI专业化(Video Reasoning 22.7%,Video QA 21.4%)
Generator训练:
- 预训练:大规模图像、视频、音频数据
- 中期训练:引入动作、控制条件转换、合成数据
- 后训练:文本到图像、图像到视频、机器人策略
数据基础设施
语义去重:
- 使用Qwen3-VL-Embedding-8B和Perception Encoder计算联合嵌入
- K-means聚类 + 余弦相似度(阈值0.95)去除近重复
AI Judge质量过滤:
- 使用Gemma-4-31B-it作为视觉语言评判器
- 三个质量维度:Faithfulness、Completeness、Correctness
- 预训练阈值2(保留78%数据),SFT阈值5(保留46%数据)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 全模态统一架构 | 语言、图像、视频、音频、动作的统一处理 | 单一框架整合VLM、视频生成器、世界模拟器、VLA |
| MoT双塔架构 | AR用于推理,扩散用于生成,联合注意力交互 | 从预训练VLM初始化,继承语言和视觉推理能力 |
| 统一动作表示 | 异构具身控制映射到共享几何结构 | 支持自动驾驶、相机运动、机器人、自我中心运动 |
| 3D MRoPE + FPS调制 | 对齐不同模态和帧率的物理时间轴 | 消除帧率差异,统一位置编码 |
| 合成数据生成 | SDG数据集(PhyxSim、RobotSim、DriveSim等) | 增强Physical AI训练数据多样性 |
五、实验结果
基准测试
Table 1: 结果概览
| 能力 | 指标 | Cosmos3-Super | Cosmos3-Nano | 最佳基线 |
|---|---|---|---|---|
| 推理 | ||||
| 通用 | 综合 | 73.7 | 69.6 | Gemini 3.1 Pro: 77.5 |
| 机器人 | 综合 | 57.8 | 55.1 | Gemini 3.1 Pro: 58.2 |
| 智能基础设施 | 综合 | 62.6 | 61.0 | Gemini 3.1 Pro: 58.6 |
| 自动驾驶 | 综合 | 79.3 | 76.0 | Gemini 3.1 Pro: 47.2 |
| 生成 | ||||
| 文本到图像 | 综合 | 91.36* | 84.61 | Gemini 3 Pro Image: 90.85 |
| 文本到视频 | 综合 | 80.0 | 79.4 | Veo-3.1: 79.1 |
| 图像到视频 | 综合 | 82.8 | 82.7 | Veo-3.1: 82.6 |
| 音频 | 综合 | 7.31 | 7.34 | Veo-3.1: 7.45 |
| 前向动力学(机器人) | 综合 | 26.0* | 25.5* | Ctrl-World: 23.0 |
| 策略(机器人) | 综合 | - | 39.7* | π₀.₅: 28.1 |
关键发现:
- Cosmos 3在大多数能力上建立新SOTA,超越专业化开源基线
- 文本到图像:Cosmos3-Super-Text2Image 91.36,超越Gemini 3 Pro Image (90.85)
- 自动驾驶推理:Cosmos3-Super 79.3,大幅超越Gemini 3.1 Pro (47.2)
- 机器人策略:Cosmos3-Nano-Policy 39.7,超越π₀.₅ (28.1)
- 图像到视频:Cosmos3-Super 82.8,与Veo-3.1 (82.6)竞争
生成能力展示
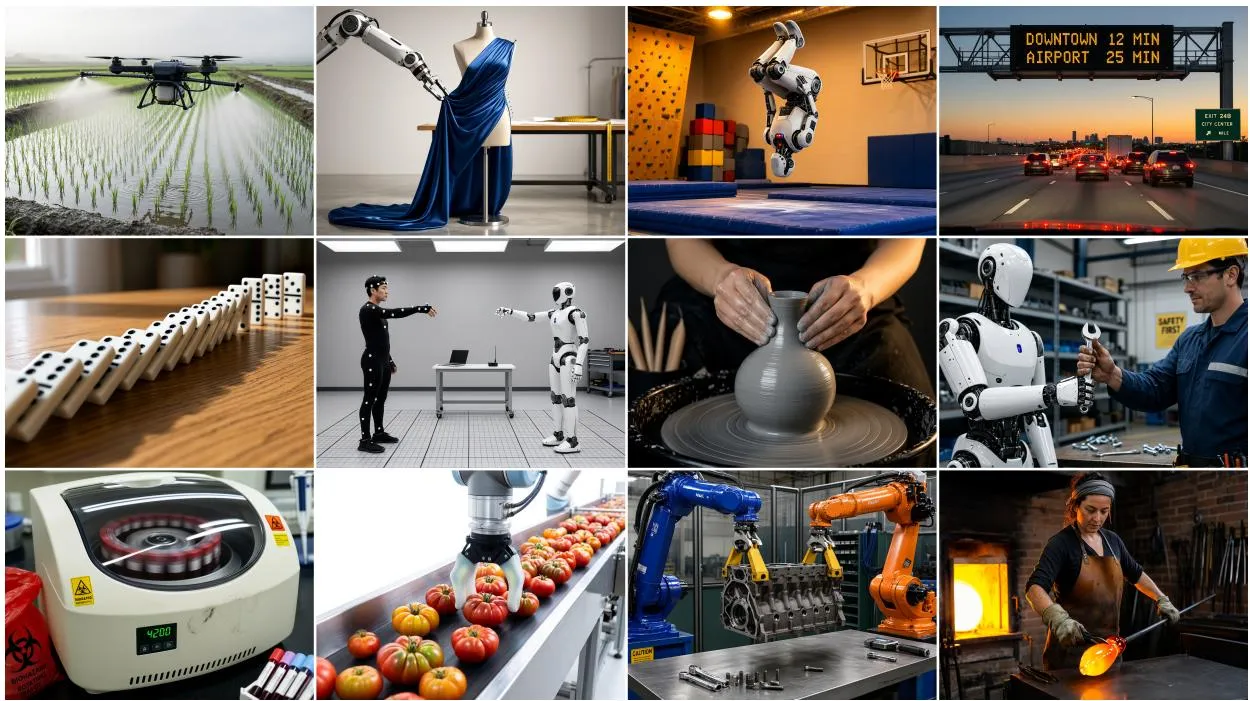
Cosmos3-Super-Text2Image生成的图像具有物理合理性和照片级真实感,展现了精细的细节和多样化的场景。
六、相关工作
| 方向 | 代表工作 | Cosmos 3优势 |
|---|---|---|
| VLM | Qwen3-VL, InternVL3 | 统一生成能力,无需额外模型 |
| 视频生成 | Veo-3.1, Wan2.2 | 同时支持理解和生成 |
| 世界模型 | Ctrl-World | 更强的前向动力学预测 |
| VLA/WAM | π₀.₅ | 更高的策略成功率 |
| 全模态模型 | Gemini 3.1 Pro | 开源,支持动作模态 |
七、总结
核心贡献
- 提出全模态世界模型Cosmos 3,统一语言、图像、视频、音频和动作的理解与生成
- 设计MoT双塔架构,AR用于推理,扩散用于生成,通过联合注意力交互
- 引入统一动作表示,将异构具身控制映射到共享几何结构
- 在大多数能力上建立新SOTA,包括文本到图像(91.36)、自动驾驶推理(79.3)、机器人策略(39.7)
- 开源代码、模型检查点、合成数据集和评估基准
技术影响
- 为Physical AI提供统一的训练设施,消除碎片化模型管道
- 合成数据生成能力解决训练数据稀缺问题
- 任务特定专业化能力支持多样化具身和任务
- 长期可生成高质量复杂训练环境
局限性
- 音频生成能力略弱于Veo-3.1(7.31 vs 7.45)
- 通用推理能力略弱于Gemini 3.1 Pro(73.7 vs 77.5)
- Cosmos3-Edge模型尚未发布
- 大规模模型(64B参数)需要大量计算资源