PhiZero: A World Model Built Around Physical Language
A physical world model that learns a compact discrete 'physical language' from in-the-wild videos, then uses a reason-then-render paradigm to generate and understand physically coherent video
PhiZero: A World Model Built Around Physical Language
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | PhiZero: A World Model Built Around Physical Language |
| 作者 | Shuyao Shang, Yuqi Wang, Ruopeng Gao, Xu Chen, Tieniu Tan, Lue Fan, Zhaoxiang Zhang |
| 机构 | NLPR, Institute of Automation, Chinese Academy of Sciences (CASIA) |
| 论文 | https://arxiv.org/abs/2607.28624 |
| 项目页 | https://Phi-Zero.github.io/ |
| 发布 | 2026-07-30 |
| 许可 | arXiv.org perpetual non-exclusive license |
二、核心思想
问题定义
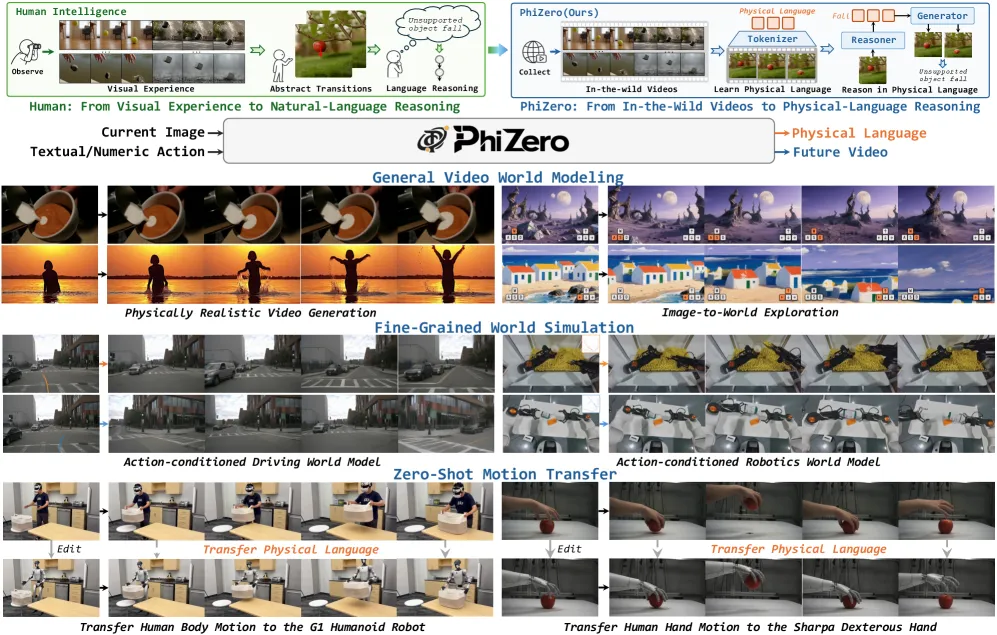
现有视频世界模型(Video World Models)通常在像素空间直接预测未来视频,将底层物理动力学隐式地编码在高维视觉表征中,导致物理上不一致的结果(如碰撞后物体不受影响、重力效果缺失等)。对于 Physical AI 而言,核心目标必须超越视觉保真度,转向学习物理世界如何演化的本质。
解决方案概述
PhiZero 受人类智能启发——人类从视觉经验中抽象出可泛化的知识,并用自然语言组织这些知识进行显式推理。但自然语言对于复杂视觉体验中的状态转换过于粗糙。PhiZero 提出学习一种物理语言(physical language):一种从在野视频(in-the-wild videos)中通过自监督学习获得的、紧凑离散的世界状态转换表示。
PhiZero 采用**先推理后渲染(reason-then-render)**范式:
- 首先将当前视觉状态和动作意图在物理语言空间中推理出未来状态转换序列
- 然后通过扩散解码器将推理出的转换渲染为未来视频
这个范式将状态转换推理与像素级合成分离,使世界演化成为显式的推理目标而非直接的像素空间预测。
三、技术架构
整体框架
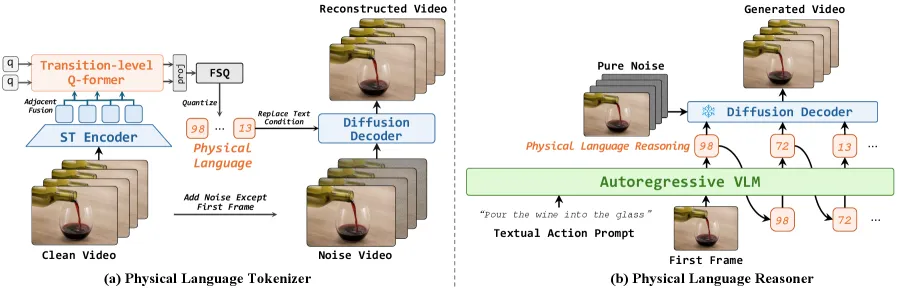
PhiZero 由两个互补组件构成:
- 物理语言分词器(Physical Language Tokenizer):使用转换级 Q-Former 将视频状态转换压缩为紧凑离散物理语言序列,配合预训练扩散解码器从物理语言+首帧重建视频
- 物理语言推理器(Physical Language Reasoner):基于预训练 VLM,从首帧和文本动作意图自回归预测物理语言序列
其中 为未来视频, 为首帧, 为文本动作意图, 为描述状态转换的离散物理语言序列。
核心公式
分词器 — 转换级 Q-Former:
给定视频 ,通过时空编码器获得隐特征 。对每对相邻隐状态 ,使用共享 Q-Former 提取转换表示:
其中 为 个共享可学习转换查询。将所有相邻区间的特征按时间顺序拼接得到 ,其中 。然后通过有限标量量化(FSQ)离散化:
解码器 — 扩散先验:
使用预训练视频扩散模型作为解码器,保留原始架构仅将文本条件替换为物理语言上下文 。首帧 作为静态外观来源,使用标准流匹配目标:
推理器 — 自回归预测:
监督信号通过冻结的分词器离线生成:。推理器使用自回归交叉熵目标:
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 时空编码器 | 基于 Wan2.2 VAE Encoder 架构 | 从预训练权重初始化 |
| 转换级 Q-Former | 对相邻隐状态对提取转换表示 | 个共享查询 |
| FSQ 量化器 | 将连续特征离散化为物理语言符号 | 量化层级 ,词表大小 25K |
| 扩散解码器 | 基于 Wan2.2-5B 的流匹配解码器 | LoRA rank=32 微调 |
| 推理器 | 基于 Qwen3-VL-4B 的自回归 VLM | 扩展词表(每 FSQ 索引一个原子符号) |
| 纯噪声预热 | 防止解码器绕过物理语言条件的捷径 | 预热阶段所有帧隐变量初始化为纯噪声 |
训练流程
物理语言分词器(两阶段):
-
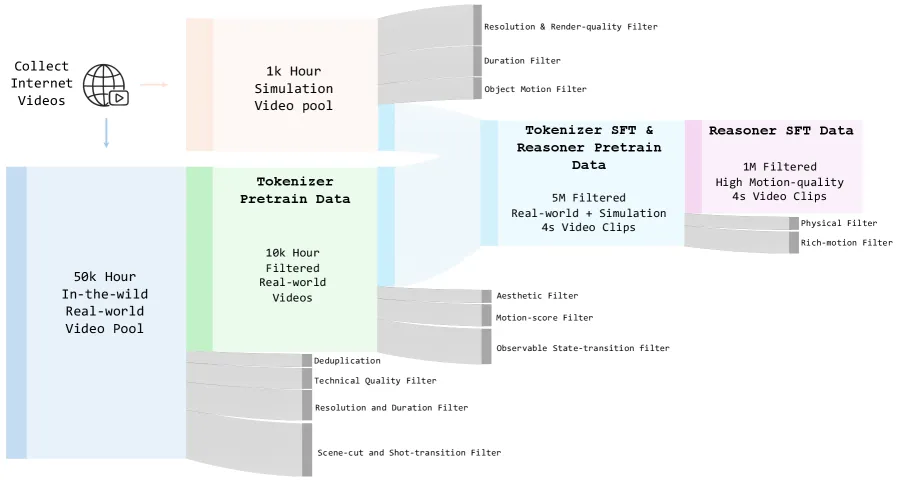
预训练:在约 10K 小时的无标签在野视频上,使用时空调度和空间调度渐进训练
- 先以 256×448 分辨率处理 1秒视频(9帧),逐步增加到 2秒(17帧),再增加到 4秒(33帧)
- 第四阶段交叉分辨率训练:输入 256×448,输出 512×896
- 前三个阶段各有初始纯噪声预热步数(50K、20K、20K)
- 使用 FSQ 熵正则化(权重 0.005)和 REPA 损失(权重 0.1)
-
SFT:在约 5M 个四秒片段上微调,然后冻结编码器/Q-Former/量化器,仅微调扩散解码器
物理语言推理器(两阶段):
- 继续预训练:在 5M 片段上,首帧+VLM生成的高层级动作描述 → 冻结分词器生成的物理语言序列
- 动作聚焦 SFT:在约 1M 个运动丰富且物理信息丰富的片段上微调,提升物理合理性和精确性
所有训练使用 128 块 NVIDIA A100 GPU。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 物理语言(Physical Language) | 从在野视频自监督学习的紧凑离散状态转换表示,将物理动力学从视觉外观中解耦 | 消融实验证明仅 256 个离散 token 即可实现高质量重建(PSNR 28.9),远优于连续 token 方案 |
| 转换级 Q-Former | 显式建模相邻隐状态对之间的转换,而非全局视频表征,引入局部时间归纳偏置 | 消融实验:移除转换级 Q-Former 导致 PSNR 下降 0.7,SSIM 下降 0.007 |
| 纯噪声预热 | 防止预训练扩散解码器利用部分噪声的目标信息和现有去噪先验产生捷径 | 消融实验:移除纯噪声预热导致 PSNR 下降 1.0,LPIPS 上升 0.004 |
| 先推理后渲染范式 | 将状态转换推理与像素级合成分离,使世界演化成为显式推理目标 | 在 Physics-IQ Verified 上 IQ-Score 达 41.2,远超 Wan2.2-5B 的 21.2 |
| 基于 VLM 的推理器 | 利用预训练 VLM 的视觉语义知识和常识先验,自回归预测物理语言序列 | 推理器消融显示两阶段训练和仿真数据对提升物理合理性至关重要 |
五、代码实现分析
关键实现细节
- 分词器架构:Wan2.2 VAE Encoder(时空编码器)+ 转换级 Q-Former + FSQ 量化器 + 扩散解码器
- 推理器基础:Qwen3-VL-4B,扩展词表添加 25K 个 FSQ 原子符号
- 量化方案:FSQ 将特征投影到低维量化空间,量化层级 ,产生 离散符号
- 物理语言序列长度:33帧视频 → 9个时间隐状态 → 每个状态 32 个查询 → 序列长度
训练超参数
分词器:
- 全局批大小:256
- 学习率:
- AdamW:
- 最大梯度范数:1.0
- LoRA rank:32
- 训练步数:预训练 4 阶段共 400K 步 + SFT 100K 步 + 解码器精炼 50K 步
推理器:
- 全局批大小:512
- 继续预训练学习率:,1K 步预热,50K 步训练
- SFT 学习率:,1K 步预热,10K 步训练
六、实验结果
物理视频生成基准
Physics-IQ Verified(物理结果保真度):
| 模型 | S-IoU ↑ | ST-IoU ↑ | WS-IoU ↑ | IQ-Score ↑ |
|---|---|---|---|---|
| Wan2.2-5B | 24.7 | 22.6 | 13.3 | 21.2 |
| Sora 2 | 37.3 | 27.0 | 26.9 | 26.5 |
| Cosmos3-Nano | 40.4 | 22.0 | 24.6 | 29.1 |
| Wan2.2-14B | 51.1 | 20.5 | 28.5 | 32.2 |
| Grok-Video | 52.7 | 21.4 | 35.7 | 34.8 |
| Cosmos3-Super | – | – | – | 39.5 |
| PhiZero | 58.2 | 36.8 | 27.6 | 41.2 |
PhyGround(物理定律遵循度):
| 模型 | General Quality ↑ | Physics Score ↑ | Overall ↑ |
|---|---|---|---|
| Veo3.1 | 3.01 | 2.85 | 2.93 |
| Wan2.2-14B | 3.00 | 2.90 | 2.95 |
| PhiZero | 2.93 | 3.01 | 2.97 |
WorldModelBench(通用世界建模):
| 模型 | Physics Adherence ↑ | Common Sense ↑ | Total ↑ |
|---|---|---|---|
| Wan2.2-5B | 4.51 | 1.41 | 7.98 |
| Runway | 4.27 | 1.65 | 8.08 |
| PhiZero | 4.88 | 1.71 | 8.19 |
视频理解基准
IntPhys2(直觉物理理解):
- PhiZero 总体准确率 56.34%,在 Medium 难度上达到 60.50%,优于 Gemini-2.5 Flash(55.63%)和 GPT-4o(53.75%)
LikePhys(物理合理性判别):
- PhiZero 平均误差 41.7,在刚性物理(29.14)和流体物理(53.15)上均显著优于基线
YoCausal(因果理解):
- PhiZero RSI 55.54%,CCI 6.20%,综合排名 2.0,优于所有基线
分词器重建性能
| 模型 | Tokens | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|---|
| Wan2.2-5B VAE | 44,800 | 37.7 | 0.957 | 0.042 |
| Video-LaVIT | 270 | 23.6 | 0.835 | 0.175 |
| VideoFlexTok (k=32) | 288 | 25.2 | 0.858 | 0.177 |
| PhiZero | 256 | 28.9 | 0.903 | 0.087 |
仅用 256 个离散 token 即达到高度压缩分词器中最佳重建质量。
消融实验
分词器设计消融:
| 变体 | PSNR | SSIM | LPIPS |
|---|---|---|---|
| 无扩散解码器 | 26.6 | 0.875 | 0.119 |
| 无转换级 Q-Former | 28.2 | 0.896 | 0.089 |
| 无纯噪声预热 | 27.9 | 0.894 | 0.091 |
| 完整模型 | 28.9 | 0.903 | 0.087 |
推理器设计消融(Physics-IQ Verified IQ-Score):
| 方法 | IQ-Score |
|---|---|
| Wan2.2-5B 基线 | 21.2 |
| + 提示增强 | 26.6 |
| 无仿真数据 | 37.7 |
| 无两阶段训练 | 39.2 |
| 完整模型 | 41.2 |
七、物理语言分析
跨外观可转移性
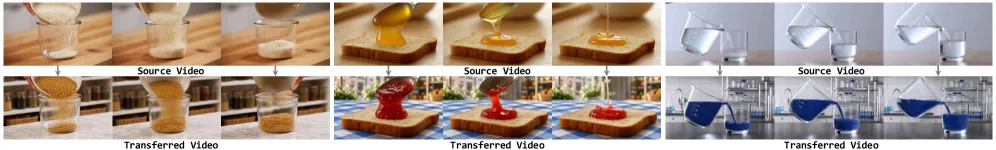
物理语言将状态转换从视觉外观中解耦。给定源视频,编码其状态转换为物理语言序列,然后用不同外观的首帧解码相同序列,转换模式(倒水、粘性扩散、液体流动)保持不变。
语义结构
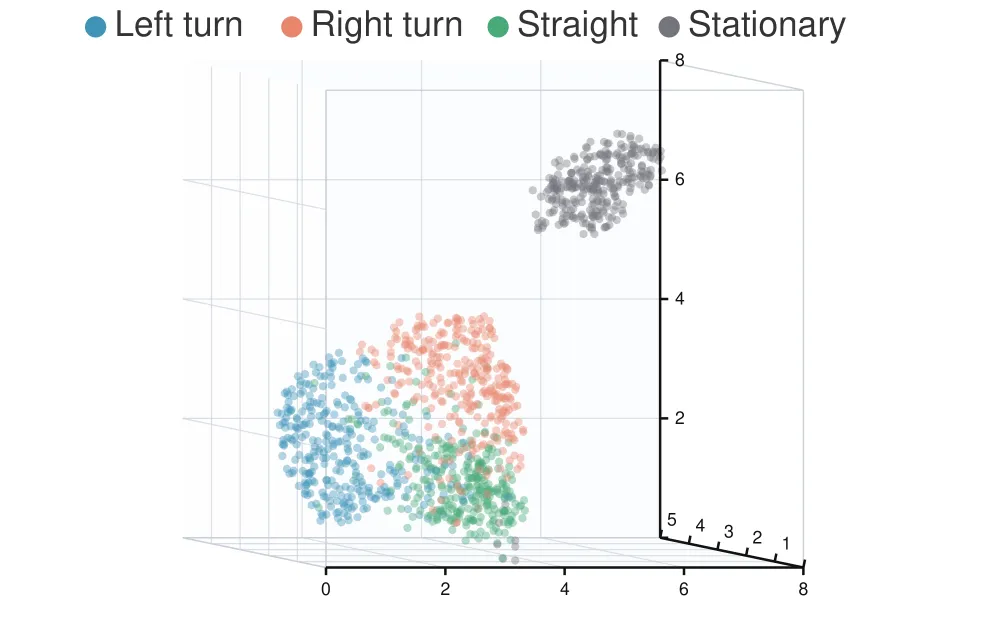
在自动驾驶和机器人操作两个领域,物理语言的嵌入通过 UMAP 降维后形成结构化流形——不同运动模式自然聚类,表明物理语言按世界如何变化组织视频,而非按视觉内容。
八、更广泛应用
物理现实视频世界模型
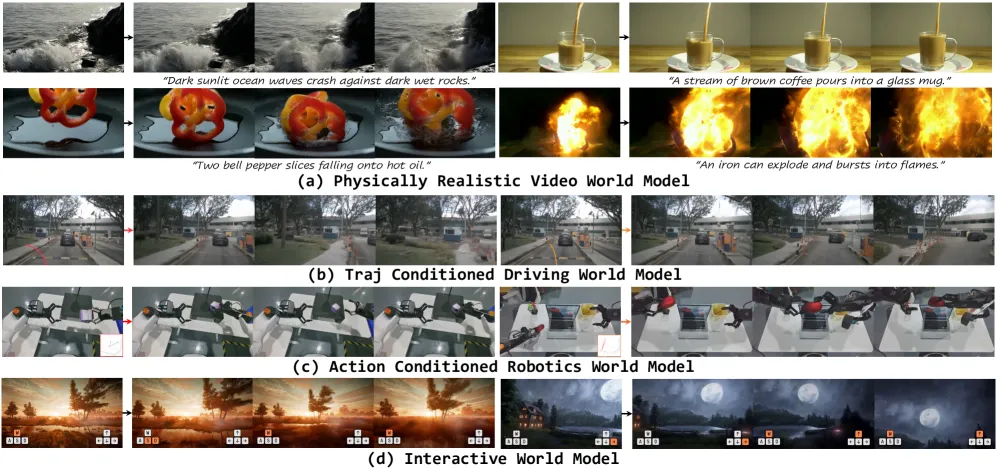
PhiZero 可生成物理连贯的世界演化,包括海浪撞击岩石、液体倾倒、物体落入热油产生飞溅、金属罐爆炸等复杂事件。
可控和交互式世界模型
- 驾驶世界模型:在 nuScenes 上,PhiZero 能捕捉细微的转向幅度差异,精确跟随动作信号
- 机器人世界模型:在 AGI-Bot RealRobot 上,精确生成机械臂和夹爪运动
- 交互式世界模型:支持通过自然语言指令序列修改相机视角和位置,生成连贯的长视频
零样本跨形态和仿真到真实迁移
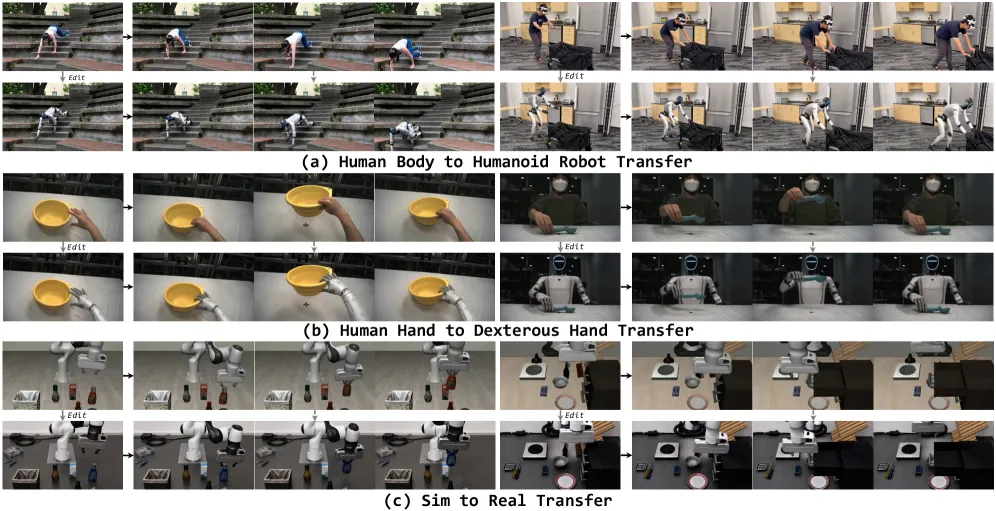
- 人体运动迁移:将人类全身运动模式迁移到 Unitree G1 人形机器人
- 手部运动迁移:将人类手部精细运动迁移到 Sharpa 灵巧手
- 仿真到真实迁移:将 LIBERO 仿真交互视频转换为真实视觉外观,同时保持状态转换
九、相关工作
PhiZero 与以下研究方向相关:
- 物理世界模型:Pandora、OpenSora-Plan、CogVideoX、Mochi 等主要通过像素空间直接预测未来视频
- 从无标签视频学习世界动力学:Genie、V-JEPA、VideoWorld 等学习隐式动态表示
- 潜动作世界模型:OLAF-world、DILA、MOTUS 等通过逆动力学瓶颈学习离散潜动作
- 视频分词器:Video-LaVIT、VideoFlexTok、Hi-VAE 等通过时空压缩学习视频表示
- 物理现实视频生成:MotionCraft、PhyGen、Videorepa 等通过物理约束或外部先验提升物理一致性
PhiZero 的独特之处在于:
- 学习的是状态转换模式而非隐动作或像素预测
- 从无标签在野视频自监督学习,无需物理仿真器约束
- 物理语言作为显式推理目标,支持生成和理解双重任务
- 外观解耦使迁移和交互成为可能
十、总结
核心贡献
- 提出物理语言概念——从在野视频自监督学习的紧凑离散状态转换表示
- 设计 PhiZero——采用先推理后渲染范式的物理世界模型,分词器和推理器协同工作
- 在物理生成基准(Physics-IQ、PhyGround、WorldModelBench)和理解基准(IntPhys2、LikePhys、YoCausal)上均取得最优或竞争力结果
- 展示物理语言在交互控制、动作条件模拟、零样本运动迁移等方面的广泛应用潜力
技术影响
PhiZero 为 Physical AI 提供了一个可缩放、可控、可迁移的世界建模框架。物理语言作为外观解耦的接口,使状态转换可以独立于视觉外观进行表示、控制和迁移。
局限性
- 物理语言是数据驱动的经验表示,而非符号物理定律的显式形式,离散符号尚未与可解释的物理变量关联
- 覆盖范围受训练数据中的视觉可观察性限制,触觉交互和微观粒子动力学等难以建模
- 当前模型规模和训练语料相对于物理世界的多样性仍有限
未来方向
- 物理语言可用于改进 VLM 的时空理解和具身策略规划
- 跨外观和形态的迁移能力可缓解真实机器人交互数据稀缺问题
- 通过层次化或递归预测扩展固定时长片段,实现长时域世界建模
- 使用更强骨干网络、更大计算资源和更多样化训练语料进一步扩展
十一、参考资源
- 论文:https://arxiv.org/abs/2607.28624
- 项目页:https://Phi-Zero.github.io/
- 代码:待发布