Sol-Attn: Accelerating Video Generation Inference via On-the-Fly Attention Sparsification
训练无关动态稀疏注意力:通过查询依赖高斯校准阈值、在线 Softmax 内联稀疏化和零阶泰勒代理分数复用,在不修改权重的情况下为视频生成 DiT 提供 2.0×–5.1× 端到端加速
Sol-Attn: Accelerating Video Generation Inference via On-the-Fly Attention Sparsification
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Sol-Attn: Accelerating Video Generation Inference via On-the-Fly Attention Sparsification |
| 作者 | Haopeng Li, Yitong Li, Junsong Chen, Tian Ye, Haozhe Liu, Jincheng Yu, Duomin Wang, Ruihua Zhang, Zeke Xie, Enze Xie, Song Han |
| 机构 | NVIDIA |
| 论文 | arXiv:2607.24027 |
| 代码 | 集成于 Sol-Engine(NVIDIA 视频推理引擎) |
| 发布 | 2026-07-27(cs.CV) |
| 许可 | arXiv.org perpetual non-exclusive license |
研究背景
Diffusion Transformers (DiTs) 已成为高保真视频生成的基础架构(如 Wan、HunyuanVideo、LTX-Video 等)。然而,追求更高分辨率和更长生成时长导致 token 序列急剧增长,自注意力的二次复杂度 成为推理瓶颈。训练无关的动态稀疏注意力(training-free dynamic sparse attention)因其无需修改模型权重即可加速推理而备受关注。
现有方法的根本缺陷
当前块稀疏方法存在两大核心问题:
-
L1(路由刚性、难控制、开销高):top-k 对每个查询块强制统一预算;top-p 产生动态预算但对概率分布敏感、难以平衡。两者都需要在 HBM 中物化完整的代理分数图和路由索引,在长序列(16K–128K)下引入显著的内存流量开销(可达 HBM 带宽的瓶颈级别)。
-
L2(丢弃式稀疏化有损):未选中的 key-value 块被完全丢弃,即使它们携带不可忽视的注意力质量。在高稀疏度(85%–90%)下,精度显著下降。
核心科学问题:能否在保证精度损失最小化的同时,实现更廉价且可控的动态预算路由?
解决方案概述
Sol-Attn(Sparsifying Online attention)提出了一种训练无关的稀疏注意力方案,将动态阈值路由、在线稀疏计算和近似修正统一在单个 online-softmax pass 中。核心创新有三:
- 查询依赖阈值化(Query-Dependent Thresholding):观察到预训练视频模型中的注意力预-softmax 分数近似高斯分布,利用每行的均值 和标准差 计算阈值 ,实现动态但可控的预算,无需物化完整代理图
- 在线稀疏化(On-the-Fly Sparsification):在 online softmax 过程中,对 pooled-key 序列按 chunk 流式扫描,分数生成即比较、即路由,无需存储完整代理分数图或路由索引
- 代理分数复用(Proxy-Score Reuse):未选中块的代理分数保留在寄存器中,用于零阶泰勒近似,恢复被丢弃块的注意力贡献,缩小稀疏与稠密输出的误差
二、技术架构
整体流程图
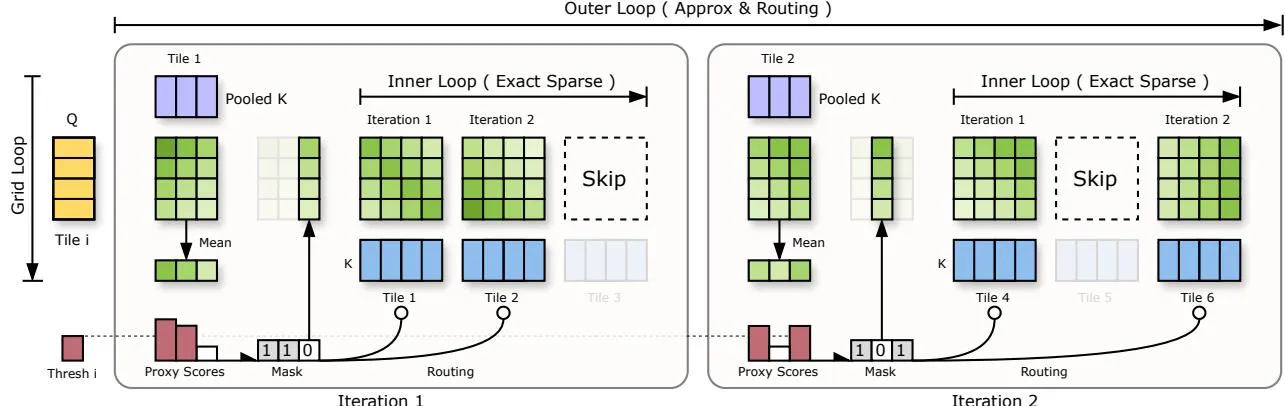
Sol-Attn 的执行流水线(Algorithm 1)采用双层嵌套循环结构:
外层循环:稠密扫描 pooled-key 序列(chunk by chunk)
  - Q_i × KC_chunk → token-to-block 分数矩阵 S̃_i^(t) ∈ R^(B×C)
  - 列均值 → chunk-wise 代理分数 ŝᵢ⁽ᵗ⁾ ∈ R^(1×C)
  - 与阈值 τᵢ 比较 → 生成 mask(哪些块被选中)
  - 未选中列:s_ap = where(mask, -inf, s_ij),执行 approximate online-softmax
  - 累加近似项:acc += PV_GEMM(p_ap, VC_chunk)

内层循环:对每个被选中的块(mask=True 的列)
  - Q_i × K_exact_block → 精确分数
  - 执行 exact online-softmax(与近似项共享 acc/l_i/m_i 状态)
  - 累加精确项:acc += PV_GEMM(p_ex, V_exact_block)

输出:O_i = acc / l_i[:, None]关键设计:路由、稀疏计算和近似修正共享同一个 online-softmax 状态(acc, l_i, m_i),三个功能在单个 kernel pass 中完成,无需额外的 HBM 读写。路由开销被完全内联到 online softmax 管线中,几乎”免费”。
核心公式推导
2.1 标准注意力与块稀疏注意力
Eq.(1) 标准注意力(FlashAttention 基础):
其中 , 为序列长度, 为特征维度。
Eq.(2) 块稀疏注意力(形式化):
其中 为注意力掩码, 条目被 softmax 忽略。块稀疏将掩码组织为块粒度,允许完全跳过掩蔽的 key-value 块。
2.2 块级代理分数
将序列划分为 个块,块大小为 (通常 )。第 个查询块 ,第 个 key-value 块 。块级代理分数定义为:
Eq.(3) 代理分数计算:
其中 , 为 token 维度均值(pooled key/query)。 为查询块 与所有 key 块的代理分数行。
2.3 查询依赖阈值路由
核心观察:Across models,聚合预-softmax 块代理分数的分布始终接近高斯(Figure 3 验证)。这提供了天然的路由坐标:对于高斯变量,距离均值 个标准差处的截断对应唯一的上尾密度。
Eq.(4) 阈值路由(核心):
其中 为全局共享的标准分数偏移参数,控制整体稀疏密度。 为查询块 的代理分数行的均值和标准差。
高效计算(Eq.5,附录 B 推导):
所有行的 可在 时间、 辅助存储下计算,无需物化 代理分数图。
对角近似(Eq.15,更低开销版本):
将 协方差矩阵替换为逐元素二阶矩,每个查询块的投影开销从 降至 。
2.4 Chunk-wise 在线阈值
将 pooled-key 序列 视为长度为 的新 key 序列,按 chunk 大小 划分为 个 chunk。对 chunk :
Eq.(6) Chunk-wise 代理分数:
Eq.(7) Chunk-wise 路由:
由于 ,chunk-wise 流式阈值路由在数学上等价于全行阈值路由。
2.5 代理分数复用与零阶泰勒近似
关键洞察(Eq.11):
token-to-block 分数矩阵 的列均值恰好等于 chunk-wise 代理分数。因此路由和近似修正可从同一张分数矩阵派生,无需额外计算或 HBM 存储。
Eq.(8) 零阶泰勒近似:
保留零阶项即可用 pooled key 近似整个块的指数分数矩阵,恢复被丢弃块的注意力贡献。
误差上界(Eq.16):
其中 ,,。分母误差为中心化分数散布的二阶小量,在注意力分数的平滑尾部(low-scoring blocks)近似误差极小。
2.6 精确+近似合并 softmax
对每个块 ,令 为 value 沿 token 维度的求和, 为未选中块集合。合并精确+近似:
Eq.(9)-(10) 合并 softmax 分母与分子:
输出:
三、Algorithm 1 完整实现
def sol_attn(Q, K, V, O, KC, VC, tau, N, B, C):
    for i in range(N):
        Q_i = Q[i*B:(i+1)*B]              # query block: B×d
        acc, l_i, m_i = 0, 0, -inf        # online softmax state (registers)

        # ── 外层循环:路由 + 近似修正 ──
        for j in range(0, N, C):           # chunk步长C
            s_ij = QK_GEMM(Q_i, KC[j:j+C])  # B×C token-to-block分数矩阵
            mask = s_ij.mean(axis=0) > tau[i]  # 列均值 vs 阈值 → 路由mask (1×C)

            # 未选中列:masked为-inf,执行 approximate online-softmax
            s_ap = where(mask, -inf, s_ij)
            p_ap = Softmax(s_ap, acc, l_i, m_i)
            acc += PV_GEMM(p_ap, VC[j:j+C]) # 累加近似贡献

        # ── 内层循环:精确稀疏注意力 ──
        for t in nonzero(mask):            # 对被选中的块
            s_ex = QK_GEMM(Q_i, K[(j+t)*B:(j+t+1)*B])  # 精确分数 B×B
            p_ex = Softmax(s_ex, acc, l_i, m_i)          # 共享online-softmax状态
            acc += PV_GEMM(p_ex, V[(j+t)*B:(j+t+1)*B])  # 累加精确贡献

        O[i*B:(i+1)*B] = acc / l_i[:, None]  # 归一化输出
return O硬件对齐实现要点:
- 和 暂存在 shared memory
- 单个 online-softmax 状态(acc, l_i, m_i)存放在寄存器
- 外层循环流式加载 KC/VC(pooled key/summed value),内层循环仅加载选中块的原始 K/V
- 精确和近似路径共享同一 online-softmax 统计量,避免两次独立 softmax 计算的重复归一化开销
四、与现有方法对比
| 方法 | 路由策略 | 未选中块处理 | 代理图物化 | 修正机制 | 路由开销 |
|---|---|---|---|---|---|
| top-k | 固定预算,每查询块选 k 个块 | 丢弃 | 是(完整 N×N) | 无 | 高(排序+索引物化) |
| top-p | 累积概率达 p,动态预算 | 丢弃 | 是(完整 N×N) | 无 | 高(排序+累积) |
| XAttn | 反对角线求和评分 | 丢弃 | 是 | 无 | 高 |
| SVG2 | 语义感知置换 | 丢弃 | 是(+permutation buffer) | 无 | 高 |
| PISA | Piecewise sparse,分片路由 | 泰勒修正 | 是 | 是(分片) | 中高 |
| SpargeAttn | top-k + 置信度阈值 | 丢弃+online-threshold | 是 | 无 | 高 |
| Twilight | top-k 候选 + top-p 剪枝 | 丢弃 | 是 | 无 | 高 |
| Sol-Attn | 在线阈值,查询依赖 | 零阶泰勒近似 | 否(流式消耗) | 是(inline) | 极低(免费) |
核心差异:Sol-Attn 的路由开销被内联到 online softmax 管线中(几乎”免费”),而近似修正使稀疏精度显著优于纯丢弃策略。与 BSA 相比,端到端反而快 6.2%–6.6%。
五、实验设置
5.1 评估模型
| 任务类型 | 模型 | 参数量 | 序列长度 |
|---|---|---|---|
| 文本到视频 | Wan2.1-14B | 14B | 81 tokens (720p) |
| 文本到视频 | HunyuanVideo-13B | 13B | 129 tokens (720p) |
| 文本到视频 | LTX 2.3-22B | 22B | 361→721 tokens (1080p) |
| 视频精修 | SANA-WM Refiner | — | ~1 分钟(最长序列) |
| 视频编辑 | Bernini-14B | 14B | 中等 |
| 文本到图像 | Ideogram 4 | — | 2K 分辨率(中短序列) |
5.2 评估指标
- 视频质量:VBench(文本到视频)、Pose Accuracy(SANA-WM)、Bernini-Bench(编辑)、Qwen-Image-Bench(图像)
- 保真度:PSNR、SSIM、LPIPS(vs 稠密注意力输出)
- 效率:端到端 wall-clock speedup(相对于稠密 FA3/FA4 基线)
5.3 基线方法
- FlashAttention-3 (FA3) / FlashAttention-4 (FA4):稠密注意力基线
- XAttention (XAttn):反对角线评分块稀疏
- Sparse-VideoGen2 (SVG2):语义感知置换稀疏
- PISA:Piecewise sparse attention(当前 SOTA 稀疏注意力)
5.4 实现细节
- 精确注意力使用固定 物理块
- Wan2.1、HunyuanVideo、Bernini、Ideogram 4:前 20% 去噪步使用稠密注意力作为 warm-up
- LTX 2.3:stage-1 使用 8 步 LoRA + 全程稠密注意力;stage-2 全程使用 Sol-Attn
- SANA-WM refiner:全程使用 Sol-Attn
- 在 NVIDIA H100 上测试 kernel 效率,在 B200 上测试 Sol-Engine 集成
六、实验结果
6.1 Kernel 级效率(H100)
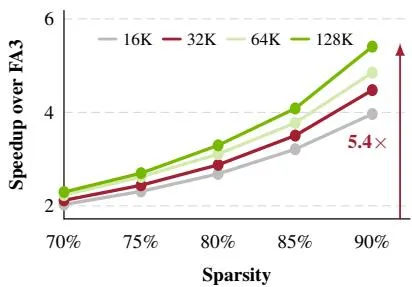
Figure 5a — 加速比 vs 稀疏度:在 128K tokens、90% 稀疏度下达到 5.41× 加速比(vs FA3)。加速比随序列长度和稀疏度单调增长,在 16K–128K 范围内保持一致的效率优势。
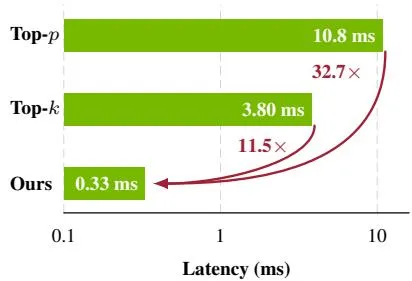
Figure 5b — 路由延迟(对数尺度):阈值路由比 top-k 快 11.5×,比 top-p 快 32.7×。原因:top-k/top-p 需要物化完整代理图 + 排序/累积选择,而 Sol-Attn 的分数在芯片上即时消耗。
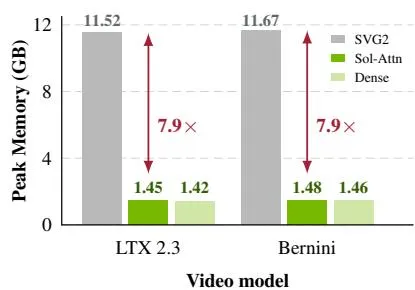
Figure 5c — 注意力处理器峰值内存:Sol-Attn 峰值内存接近 Dense;SVG2 的 routing structures + permutation buffers 需约 8× 更多内存。
6.2 文本到视频生成(Table 1)
Wan2.1-14B(720p,81 帧):
| 方法 | SC | BC | TF | MS | AQ | IQ | DD | OC | AVG | Sparsity | Speedup |
|---|---|---|---|---|---|---|---|---|---|---|---|
| FA3 | 95.59 | 96.75 | 98.75 | 97.86 | 63.17 | 68.88 | 61.11 | 25.08 | 75.90 | — | 1.00× |
| XAttn | 93.71 | 95.43 | 97.94 | 97.12 | 60.56 | 66.12 | 62.50 | 25.37 | 74.84 | 85.60% | 1.69× |
| SVG2 | 94.85 | 96.05 | 98.59 | 97.68 | 62.26 | 67.40 | 59.72 | 25.19 | 75.22 | 83.66% | 1.85× |
| PISA | 95.60 | 96.95 | 98.75 | 97.98 | 63.72 | 68.91 | 61.11 | 25.19 | 76.03 | 85.00% | 1.86× |
| Sol-Attn | 95.54 | 97.02 | 98.76 | 98.01 | 63.35 | 68.64 | 62.50 | 25.26 | 76.13 | 85.12% | 2.02× |
Sol-Attn 在 VBench 综合得分上全面超越所有稀疏基线,且加速比最高(2.02× vs PISA 的 1.86×)。在运动稳定性(MS)、动态细节(DD)等关键子项上取得最优。
HunyuanVideo-13B(720p,129 帧):
| 方法 | SC | BC | TF | MS | AQ | IQ | DD | OC | AVG | Sparsity | Speedup |
|---|---|---|---|---|---|---|---|---|---|---|---|
| FA3 | 93.87 | 96.60 | 98.97 | 99.11 | 61.54 | 67.87 | 72.22 | 26.28 | 77.06 | — | 1.00× |
| XAttn | 93.76 | 95.57 | 99.05 | 98.76 | 60.10 | 66.38 | 51.39 | 26.16 | 73.90 | 85.60% | 1.61× |
| SVG2 | 92.22 | 95.63 | 99.01 | 98.95 | 58.01 | 61.81 | 63.89 | 26.08 | 74.45 | 83.15% | 2.01× |
| PISA | 93.68 | 96.37 | 98.95 | 99.08 | 61.69 | 67.71 | 72.22 | 26.49 | 77.02 | 85.00% | 1.88× |
| Sol-Attn | 93.62 | 96.49 | 98.95 | 99.05 | 61.52 | 67.55 | 70.83 | 26.50 | 76.81 | 85.80% | 2.12× |
HunyuanVideo 上 Sol-Attn 质量略低于 PISA(76.81 vs 77.02),但加速比领先(2.12× vs 1.88×,+12.8%)。
LTX 2.3-22B(1080p,361→721 帧,两阶段):
| 方法 | AVG | Sparsity | End-to-End | Stage-2 |
|---|---|---|---|---|
| FA3 | 74.59 | — | 1.0× | — |
| XAttn | 74.59 | 90.17% | 1.6× | 1.9× |
| SVG2 | 71.98 | 89.35% | 1.7× | 2.1× |
| PISA | 74.67 | 90.00% | 1.8× | 2.3× |
| Sol-Attn | 74.69 | 89.83% | 1.9× | 2.4× |
LTX 2.3(最长序列)上质量和加速比均为最优。
6.3 视频到视频生成
SANA-WM Refiner(1 分钟视频精修,Table 2):
| 方法 | R.Err.↓ | T.Err.↓ | CMC↓ | PSNR↑ | SSIM↑ | LPIPS↓ | Sparsity | Speedup |
|---|---|---|---|---|---|---|---|---|
| FA3 | 7.133 | 1.167 | 1.216 | — | — | — | — | 1.00× |
| XAttn | 10.52 | 1.331 | 1.415 | 16.80 | 0.466 | 0.411 | 85.30% | 2.17× |
| SVG2 | 9.109 | 1.413 | 1.477 | 16.89 | 0.473 | 0.413 | 85.08% | 2.08× |
| PISA | 8.822 | 1.237 | 1.299 | 17.65 | 0.506 | 0.351 | 84.96% | 2.35× |
| Sol-Attn | 8.781 | 1.233 | 1.296 | 17.72 | 0.507 | 0.343 | 85.11% | 3.04× |
Sol-Attn 在最长序列场景下同时取得最佳 Pose 精度(R.Err.最低)、最佳 PSNR/SSIM 和最高加速比。
Bernini-14B 视频编辑(Table 3):
| 方法 | IF↑ | VC↑ | GQ↑ | OS↑ | PSNR↑ | SSIM↑ | LPIPS↓ | Sparsity | Speedup |
|---|---|---|---|---|---|---|---|---|---|
| FA3 | 3.32 | 3.80 | 3.70 | 3.41 | — | — | — | — | 1.00× |
| XAttn | 3.46 | 3.65 | 3.80 | 3.46 | 27.42 | 0.864 | 0.079 | 84.91% | 1.64× |
| SVG2 | 3.41 | 3.62 | 3.62 | 3.36 | 27.28 | 0.863 | 0.074 | 81.15% | 2.04× |
| PISA | 3.36 | 3.75 | 3.75 | 3.55 | 29.88 | 0.904 | 0.052 | 85.00% | 2.17× |
| Sol-Attn | 3.50 | 3.80 | 3.80 | 3.50 | 30.18 | 0.910 | 0.046 | 85.00% | 2.34× |
同样在编辑任务上同时最优。
6.4 文本到图像(Table 4)
Ideogram 4(2K 分辨率,90% 稀疏度):
| 方法 | Qual.↑ | Aesth.↑ | Align.↑ | Fidel.↑ | Creat.↑ | AVG | PSNR↑ | SSIM↑ | LPIPS↓ | Speedup |
|---|---|---|---|---|---|---|---|---|---|---|
| FA3 | 56.10 | 60.88 | 59.74 | 56.40 | 64.95 | 59.24 | — | — | — | 1.00× |
| BSA | 50.04 | 52.28 | 52.63 | 51.40 | 53.08 | 51.96 | 15.99 | 0.565 | 0.427 | 1.54× |
| PISA | 52.78 | 55.56 | 55.09 | 53.07 | 55.85 | 54.51 | 20.12 | 0.738 | 0.239 | 1.47× |
| Sol-Attn | 52.77 | 56.12 | 56.61 | 53.33 | 57.71 | 55.31 | 21.26 | 0.764 | 0.210 | 1.56× |
在中短序列文本到图像任务上同样最优,Qwen-Image-Bench 综合得分领先 PISA 0.8 分。
6.5 消费级 GPU(RTX 5090,Table 5)
Wan2.1-1.3B 480p 视频生成:
| 方法 | PSNR↑ | SSIM↑ | LPIPS↓ | Sparsity | Speedup |
|---|---|---|---|---|---|
| FA4 | — | — | — | — | 1.00× |
| XAttn | 15.16 | 0.41 | 0.554 | 86.09% | 1.36× |
| SVG2 | 24.08 | 0.77 | 0.195 | 86.00% | 1.41× |
| Sol-Attn | 24.70 | 0.794 | 0.162 | 84.90% | 1.71× |
在消费级 GPU 上同样实现最佳精度-效率权衡,PSNR 较 SVG2 提升 0.62dB,LPIPS 降低 0.033。
6.6 Sol-Engine 集成(Figure 7)
将 Sol-Attn 与 diffusion-step caching 和 kernel fusion 等技术集成到 Sol-Engine(NVIDIA B200):
| 模型 | 端到端加速比 |
|---|---|
| Wan2.1-14B | 3.48× |
| HunyuanVideo-13B | 5.08× |
Figure 7 展示了逐步添加加速技术后的延迟递减过程,验证了 Sol-Attn 作为即插即用组件的兼容性。
6.7 消融实验
路由密度分布(Figure 8):在相同平均密度 15% 下,top-k 每块密度完全固定;top-p 密度波动极大;Sol-Attn 密度分布紧密集中,兼具动态性与可控性。
近似修正效果(Figure 9):随稀疏度增加,标准稀疏注意力(exact-only)的相对 误差快速上升;Sol-Attn(exact-or-approx)的误差显著更低,cosine similarity 保持更高,且在 90% 稀疏度下优势最大。
延迟分解(Figure 10):与 cuDNN BSA(相同块索引)对比:
- Kernel 级额外开销:9.4%(10% 密度)、3.9%(15%)、1.6%(20%)
- 端到端层面:Sol-Attn 反而快 6.2%–6.6%(因 BSA 需额外路由阶段)
七、关键设计洞察
7.1 高斯校准的阈值路由
注意力预-softmax 分数的 near-Gaussian 分布是 Sol-Attn 的基础假设。Figure 3 展示了标准化代理分数的分布与标准高斯 CDF 的匹配程度。共享 参数在整个模型层面控制稀疏密度,而每行通过自身的 自适应映射到原始分数尺度,实现了”全局可控 + 局部自适应”的路由策略。
7.2 路由”免费”化
传统方法(top-k/top-p)需先完整扫描代理图再路由,额外 HBM 读写开销在长序列下显著。Sol-Attn 的 token-to-block 分数矩阵 的列均值恰好等于 chunk-wise 代理分数(Eq.11),使路由完全内联到 kernel 中,无额外 HBM 开销。
7.3 精确-近似统一 softmax
近似项和精确项共享同一 online-softmax 状态(acc, l_i, m_i),避免了两次独立 softmax 计算的重复归一化开销。这种设计将三个功能(路由、稀疏计算、近似修正)统一为单个 streaming operator。
7.4 零阶泰勒近似的有效性
虽然忽略了 的一阶项,但在注意力分数的平滑尾部(low-scoring blocks),该近似误差为二阶小量(Eq.16),实际影响很小。Figure 9 的消融实验验证了这一点:在 90% 稀疏度下,近似修正仍将相对 误差降低约 50%。
八、相关工作
块稀疏注意力
- 结构化布局:Longformer、BigBird 等通过固定稀疏模式降低复杂度
- 内容自适应:XAttention(反对角线评分)、SVG2(语义感知置换)、SpargeAttn(top-k+置信度阈值)
- 学习式稀疏:Native Sparse Attention、MoBA 等通过训练学习稀疏模式
路由策略
- 固定预算:top-k 强制统一预算
- 动态预算:top-p 累积概率达阈值,但对分布敏感
- 混合策略:SpargeAttn2(top-k ∪ top-p)、Twilight(top-k 候选 + top-p 剪枝)
- Sol-Attn 的新范式:查询依赖高斯校准阈值,无需排序/累积,完全内联
稀疏修正
- PISA:块级泰勒展开,分片精确+近似
- SVG-EAR:质心线性补偿 + 误差感知路由
- BA-Att:协方差补偿块近似
- SLA/SLA2:稀疏-线性注意力混合
- Sol-Attn 的新范式:零阶泰勒近似 + 代理分数复用,精确-近似共享同一 online-softmax
九、代码与实现
核心实现要点
# Sol-Attn 伪代码(Algorithm 1)
# Q, K, V: 完整 QKV 矩阵
# KC, VC: pooled-key 和 summed-value 缓存(预处理一次)
# tau: 每查询块的阈值(预处理一次,O(Ld + Nd²))
# B: 块大小(64),C: chunk 大小

def sol_attn(Q, K, V, O, KC, VC, tau, N, B, C):
    for i in range(N):
        Q_i = Q[i*B:(i+1)*B]           # B×d
        acc, l_i, m_i = 0, 0, -inf     # online softmax 状态(寄存器)

        for j in range(0, N, C):       # 外层:路由 + 近似
            s_ij = QK_GEMM(Q_i, KC[j:j+C])   # B×C
            mask = s_ij.mean(axis=0) > tau[i] # 列均值路由
            s_ap = where(mask, -inf, s_ij)    # 未选中列masked
            p_ap = Softmax(s_ap, acc, l_i, m_i)
            acc += PV_GEMM(p_ap, VC[j:j+C])

            for t in nonzero(mask):           # 内层:精确
                s_ex = QK_GEMM(Q_i, K[(j+t)*B:(j+t+1)*B])
                p_ex = Softmax(s_ex, acc, l_i, m_i)
                acc += PV_GEMM(p_ex, V[(j+t)*B:(j+t+1)*B])

        O[i*B:(i+1)*B] = acc / l_i[:, None]
    return O
预处理步骤
- Pooled Key/Value 缓存:,,预处理一次
- 阈值计算: 从 pooled-key 的一阶/二阶矩计算,
- Warm-up:前 20% 去噪步使用稠密注意力预热
十、局限性与未来工作
当前局限
- 仅支持前向推理:当前实现不支持反向传播,无法用于训练。这限制了将其应用于训练阶段优化或自适应稀疏度调整
- 未充分利用 Blackwell 特性:B200 kernel 尚未完全发挥 Blackwell 架构的性能潜力(如 FP8 张量核心优化、异步流水线)
- 仅评估双向扩散模型:未覆盖自回归视频生成(如 V3 类模型),这类模型的注意力模式与双向 DiT 不同
- 稠密 warm-up 开销:前 20% 去噪步使用稠密注意力,虽为稳定性所需,但占用了部分推理时间
未来方向
- Kernel 进一步优化:充分利用 Blackwell 架构的 FP8 张量核心和异步流水线
- 扩展至自回归模型:验证 Sol-Attn 在 V3 类自回归视频生成模型中的有效性
- 支持反向传播的可训练实现:使 Sol-Attn 可用于训练阶段,实现端到端稀疏优化
- 自适应稀疏度控制:根据内容复杂度动态调整 参数
十一、总结
Sol-Attn 提出了一种新颖的训练无关稀疏注意力范式:将路由从稀疏计算的前置阶段移入 online softmax 管线内部,并通过代理分数复用实现轻量级近似修正。这一设计使路由开销几乎”免费”(内联到 kernel 中),同时近似修正显著缩小了稀疏与稠密输出的误差。
核心贡献:
- 查询依赖高斯校准阈值路由:利用注意力分数的 near-Gaussian 分布,通过单参数 实现全局可控、局部自适应的动态稀疏密度
- 在线流式稀疏化:chunk-wise streaming 路由内联到 online softmax 管线,无需物化代理图或路由索引
- 代理分数复用:零阶泰勒近似恢复未选中块的注意力贡献,精确-近似共享同一 softmax 状态
- SOTA 精度-效率权衡:在 Wan2.1-14B(2.02×)、HunyuanVideo-13B(2.12×)、SANA-WM(3.04×)等多个模型上实现最佳加速比和质量,Sol-Engine 集成达 5.08×
十二、参考资源
- 论文:arXiv:2607.24027
- 关键引用:
- FlashAttention [Dao et al., NeurIPS 2022]:online softmax 基础
- FlashAttention-3 [Shah et al., NeurIPS 2024]:低精度异步 attention
- PISA [Li et al., arXiv 2026]:piecewise sparse attention
- SVG2 [Yang et al., NeurIPS 2025]:语义感知置换稀疏
- XAttention [Xu et al., ICML 2025]:反对角线评分块稀疏
- Sol-Engine [Li et al., arXiv 2026]:NVIDIA 全栈视频推理引擎
- SpargeAttn [Zhang et al., ICML 2025]:top-k + 置信度阈值
- SpargeAttn2 [Zhang et al., arXiv 2026]:top-k ∪ top-p 混合