WanToFight: Real-Time Generative Game Engine for Multi-Player Combat Interaction
基于 Wan-1.3B 的生成式格斗游戏引擎,首次实现多玩家控制、实时推理、复杂物理交互和对抗性玩法的统一
WanToFight: Real-Time Generative Game Engine for Multi-Player Combat Interaction
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | WanToFight: Real-Time Generative Game Engine for Multi-Player Combat Interaction |
| 作者 | Li Hu, Guangyuan Wang, Peng Zhang, Bang Zhang |
| 机构 | 阿里巴巴通义实验室 (Tongyi Lab, Alibaba) |
| 论文 | arXiv:2607.12592 |
| 代码 | — (未开源) |
| 项目页面 | https://humanaigc.github.io/wantofight/ |
| 发布 | 2026-07-14 |
核心贡献:
- 首个四合一生成式游戏引擎:同时支持多玩家控制(multi-player control)、实时推理(real-time inference, ≥30 FPS)、复杂物理交互(complex physical interaction)和对抗性玩法(adversarial gameplay)
- Player Association 模块:通过冻结 CLIP 编码器的参考图像嵌入,将每个玩家的键盘信号绑定到对应角色,解决 ID crosstalk 问题
- 块因果自回归生成器:结合 Diffusion Forcing / CausVid / SelfForcing 思想,三阶段训练(双向预训练 → 因果适配 → 效率优化),DMD 蒸馏至 4 步,单张 RTX 5090 实现 30 FPS @ 512×384
- 窗口注意力 + 门控融合键盘控制:局部因果控制(window size=3)+ 数据依赖门控,适应格斗游戏中突发性高频率输入
- 三阶段课程学习:单玩家动作 → 多玩家动作 → 完整对战,渐进提升训练难度
- 数据收集流水线:人工录制 → 键盘策略训练 → 自动化回放录制,构建了 KOF ‘97 游戏域配对数据
二、研究背景与动机
传统游戏开发的局限
传统游戏开发依赖三个独立制作的组件:手工创建的资源、硬编码的游戏逻辑和渲染引擎。这种流水线劳动密集,且玩家体验被限制在开发者预设的规则和资产内。
现有生成式游戏引擎的不足
| 方法 | 领域 | 多玩家 | 实时 | 复杂物理 | 对抗性 |
|---|---|---|---|---|---|
| GameNGen (2408.14837) | DOOM | × | ✓ | 部分 | — |
| Oasis (2412.03568) | Minecraft | × | ✓ | 部分 | — |
| Yan (2508.08601) | — | × | ✓ | 部分 | — |
| WorldMem (2504.12369) | Minecraft | × | × | 部分 | — |
| Multiverse | Gran Turismo | ✓ | × | ✓ | 竞争 |
| Solaris (2602.22208) | Minecraft | ✓ | × | 部分 | 合作 |
| MultiWorld (2604.18564) | It Takes Two | ✓ | × | 部分 | × |
| WanToFight | KOF ‘97 | ✓ | ✓ | ✓ | ✓ |
关键差距:现有工作要么聚焦单玩家第一人称视角,要么局限于非实时推理、合作场景或非战斗环境,没有方法同时满足多玩家控制、实时推理、复杂物理交互和对抗性玩法四大属性。
三大挑战
- 帧级精确物理交互:攻击动画必须在对手处于攻击范围的精确帧连接,接触触发正确的击退、命中僵直和 KO 机制,误差几帧即产生可见错误
- 高频组合输入:高手操作涉及双方玩家快速同时的方向-动作组合,模型需在每一步将快速输入流与当前游戏状态融合
- 多玩家身份绑定:16 键联合输入空间必须在角色侧换、相互遮挡、姿态变化时保持稳定的按键-to-角色路由
三、技术架构
整体框架
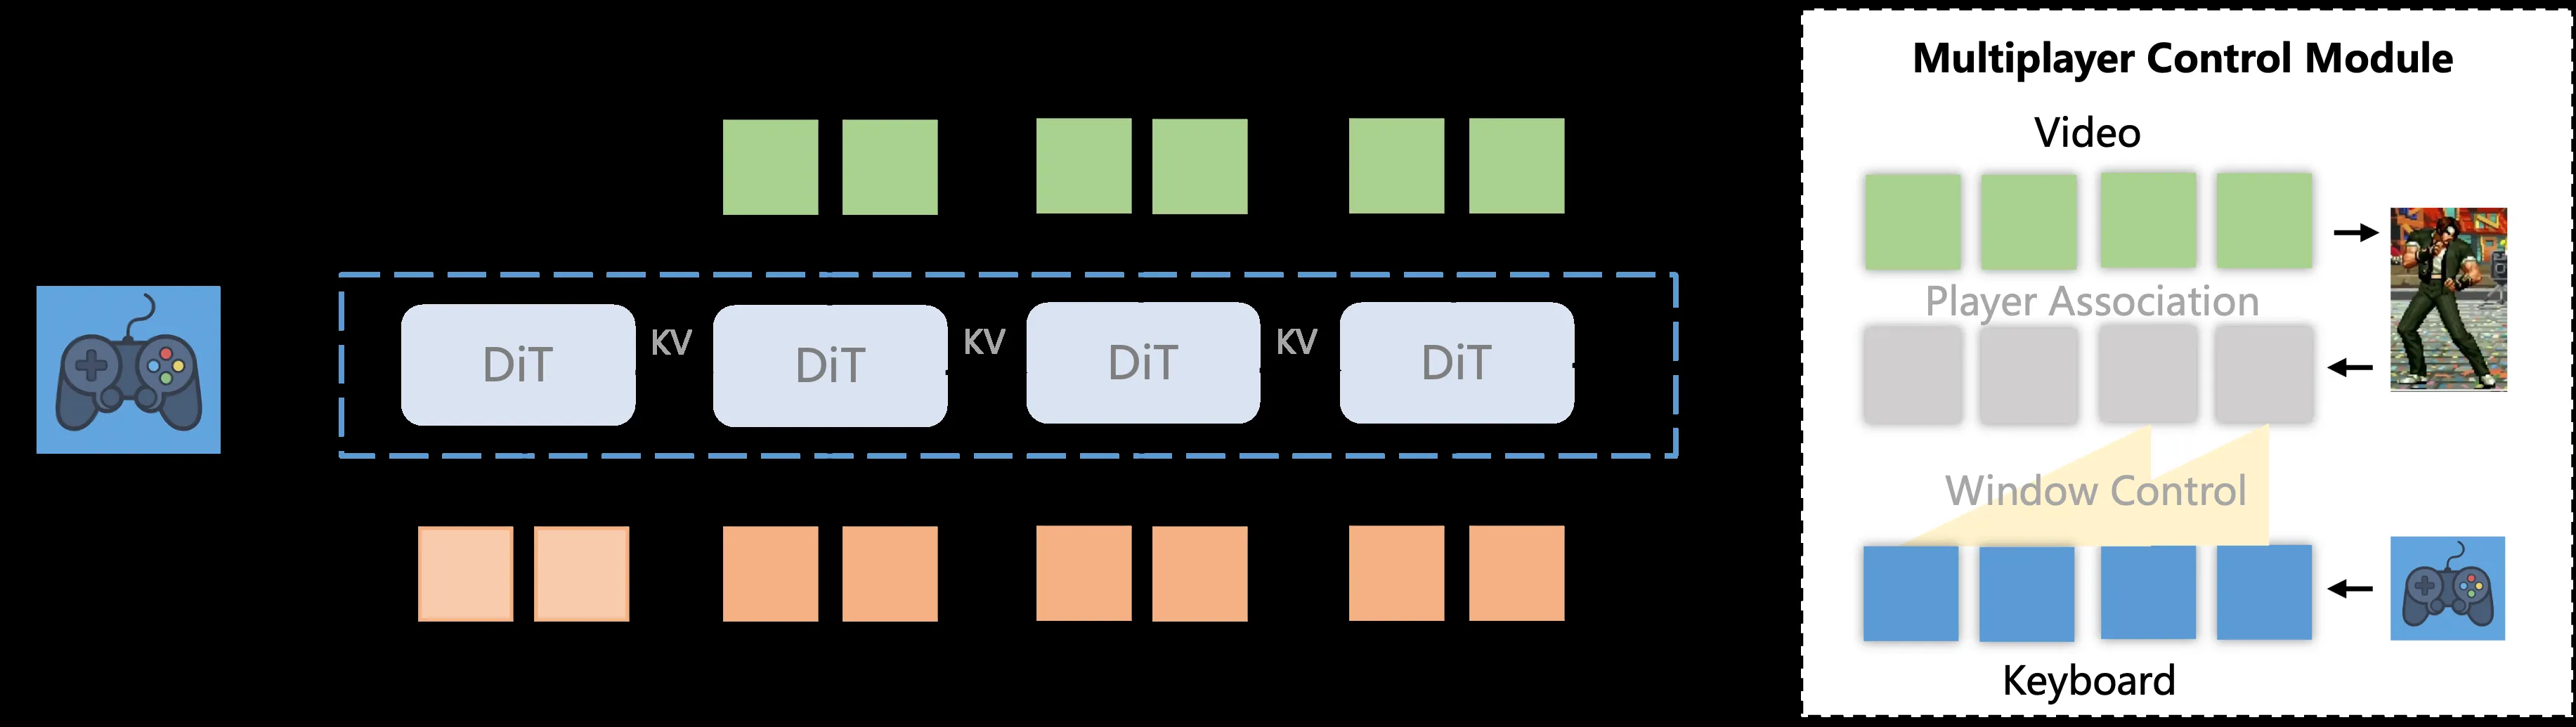
WanToFight 是一个自回归视频扩散引擎,逐 chunk 生成游戏画面。给定初始帧和键盘输入流,模型通过缓存的注意力状态对已生成的 chunk 进行条件化,生成下一个 chunk。
问题形式化
其中 是视频帧序列(), 是对应的键盘输入序列, 是 chunk 长度(约 0.27s @ 30 FPS)。
数据收集流水线(Sec. 3.1)
数据收集分为三个阶段:
- 人工录制:人类玩家在 KOF ‘97 中游戏,后台工具同步记录渲染帧和键盘状态,获得数小时配对数据
- 键盘策略训练:在人工数据基础上训练小型自回归模型,预测下一帧键盘状态,产生多样化且合理的输入序列用于数据增强
- 自动化回放录制:生成的键盘轨迹通过控制器模拟器反馈到实际游戏中,录制程序捕获渲染帧,保持帧级对齐
聚焦于基础动作(移动、跳跃、蹲伏、基本攻击),排除复杂连招和角色专属必杀技。
三大核心组件
1. 流式自回归生成器
Stage 1: 双向预训练
- 在 161 帧(约 20 个 chunk)的训练样本上微调 Wan-1.3B
- 长训练视野有意为之:跳跃弧线、击退轨迹、连招恢复动画等涉及多 chunk 动态
- 同时训练键盘控制模块
Stage 2: 因果适配
- 将密集注意力掩码替换为块因果掩码(block-causal mask)
- chunk 内 token 双向注意力,chunk 间仅关注当前和前面两个 chunk
- 不同 chunk 分配独立扩散时间步(diffusion timesteps),防止模型坍缩到单一噪声水平
- 推理时缓存最后两个 chunk(16 帧)的 keys/values 作为滚动 KV 缓存
Stage 3: 效率优化
- DMD Distillation:将去噪轨迹压缩至 4 步(全参数学生优化)
- Pruned VAE Decoder:结构化减少解码器参数量并在游戏域帧上微调
2. 键盘控制模块
输入编码:
- 每帧键盘状态编码为 16 维二进制向量(P1: WASD + UIJK, P2: 方向键 + 小键盘 7,8,4,5)
- 通过 1D 卷积进行时域压缩,使每个 keyboard latent 与 video latent 沿时间轴对齐
- 线性投影到 cross-attention key/value 维度
逐层注入调度:
- Wan-1.3B 包含 30 个 transformer block
- 每隔 3 个 block 插入一个 cross-attention 注入点,共 10 个注入站点
- 周期性调度让模型在多尺度表征中整合键盘条件
窗口注意力(Window Attention):
- 限制每个 video latent 的注意力仅覆盖大小为 3 的时间窗口(自身 + 前两个 keyboard latent)
- 防止未来按键泄漏到过去帧
- 避免模型对不相关历史输入进行平均
门控融合(Gated Fusion):
其中 是 sigmoid 函数, 和 是学习参数, 表示逐元素乘法。门控可抑制与当前屏幕上下文无关的输入(如不可破坏动画期间的按键),同时保留决定性输入的贡献。
3. Player Association for Multi-Player Control
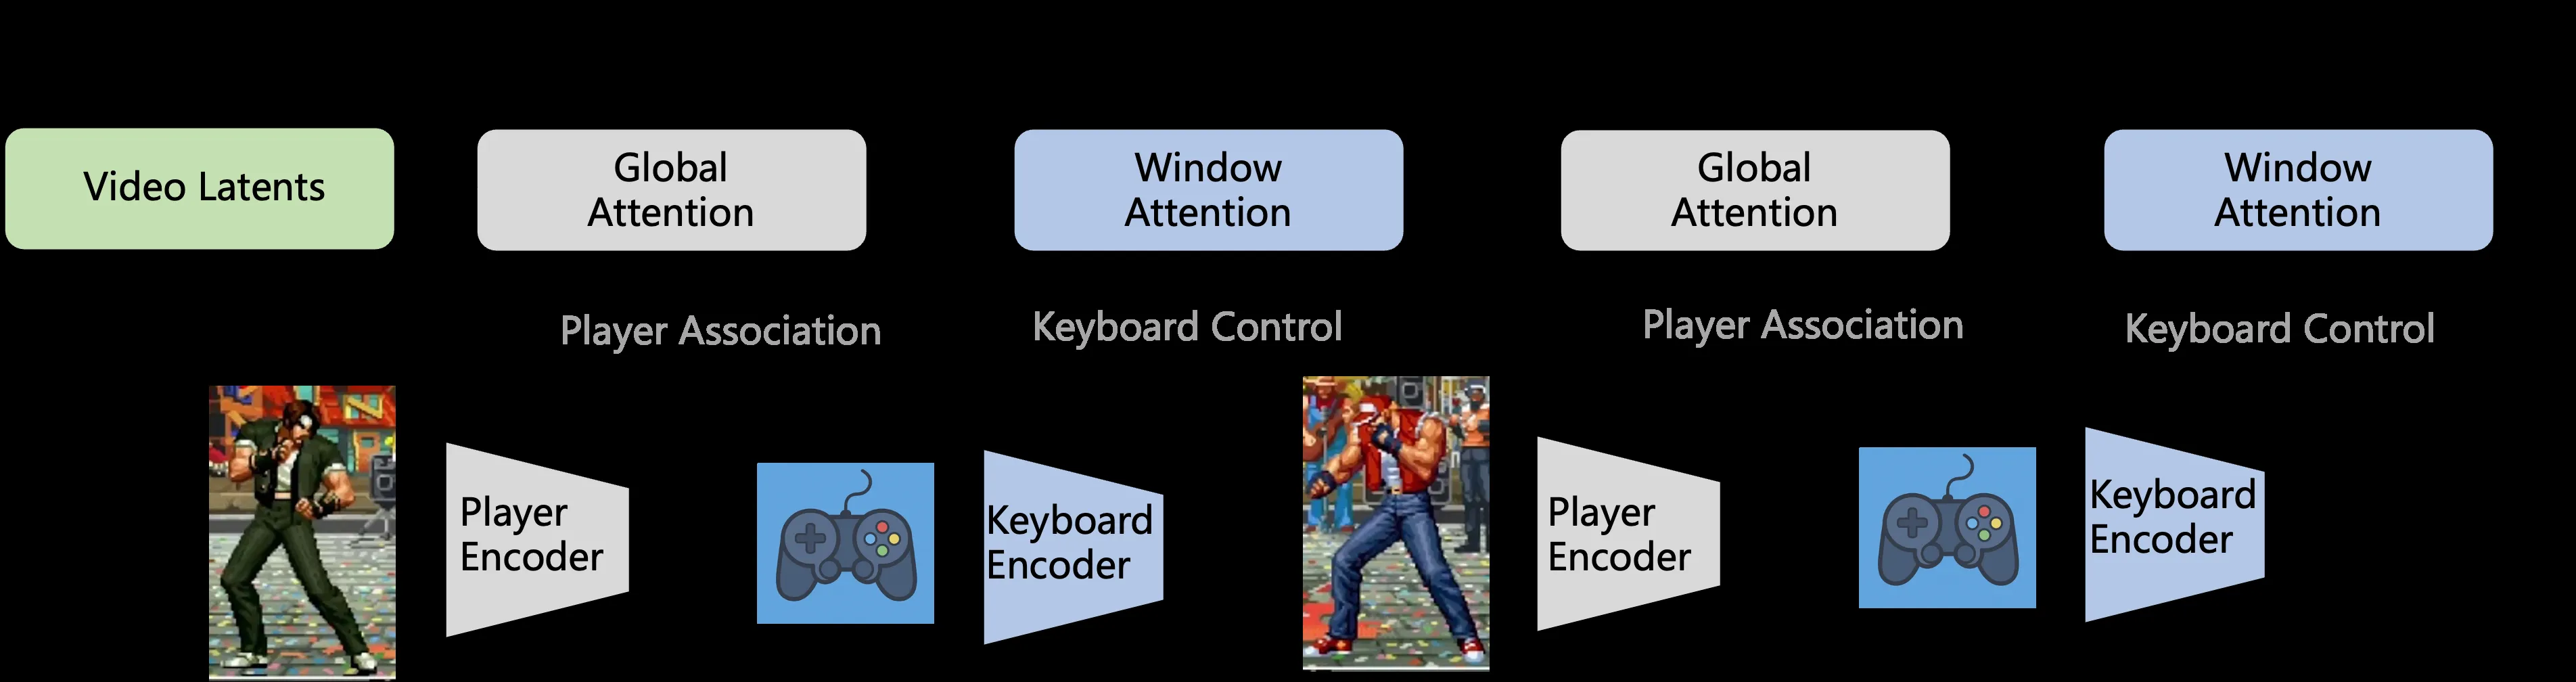
ID Crosstalk 问题: 当两个角色交叉或相互遮挡时,模型可能丢失哪个 8 键集合控制哪个角色的追踪。
解决方案:
- Reference-image grounding:为每个玩家提供预设的角色参考图像,通过冻结 CLIP 编码器产生固定身份嵌入
- Sequential identity binding:
- 每个 player 依次执行:video latents → cross-attention to CLIP feature → 注入该 player 的 8 个按键
- 同一 forward pass 内串行处理两个 player
- 第一个 player 的 identity-binding-then-key-injection sub-block 先于第二个
与 Solaris / MultiWorld 的区别:
- Solaris 使用学习型 additive 身份嵌入,MultiWorld 使用旋转位置编码(Agent Identity Embedding)
- WanToFight 使用冻结 CLIP 视觉编码器,鲁棒性更强,可泛化到位置交换和视觉遮挡
- 序列式设计自然扩展到 N 玩家
课程学习训练策略
| 阶段 | 内容 | 目标 |
|---|---|---|
| Single-player actions | 仅一个 player 活跃的序列 | 学习单个按键到角色动画的映射 |
| Multi-player actions | 两个 player 同时输入的序列 | 建立稳定的 identity-to-key 绑定 |
| Full gameplay | 全速对战数据 | 学习长程游戏逻辑(连招、位置交换、击退恢复) |
直接在全量双人对战数据上训练不稳定——键盘信号相对于视觉复杂度过于稀疏,模型难以区分角色特定控制与背景动态。三阶段课程学习显著加速收敛并提升多玩家控制的可靠性。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个四合一生成式游戏引擎 | 同时支持多玩家、实时、复杂物理、对抗 | Tab. 1:能力对比表;KOF ‘97 格斗场景 |
| Player Association | 参考图像驱动的跨注意力身份绑定 | Fig. 3:架构;Tab. 3:消融实验(79-94pp 提升) |
| 块因果自回归生成 | 结合 Diffusion Forcing/CausVid/SelfForcing 思想 | Sec. 3.2.1:三阶段训练;2 块 KV 缓存 |
| 窗口注意力 + 门控融合 | 局部因果控制 + 噪声鲁棒性 | Eq.(2):门控公式;Sec. 3.2.2 详细设计 |
| DMD 蒸馏 + Pruned VAE | 4 步学生模型匹配教师性能 | Tab. 2:4-step student vs multi-step teacher <0.03 gap |
| 三阶段课程学习 | 单玩家 → 双玩家 → 完整对战 | Sec. 3.3:策略描述;Sec. 4.5 ablation |
| 数据收集流水线 | 人工 → 策略训练 → 自动化回放 | Sec. 3.1:构建 KOF ‘97 游戏域配对数据集 |
五、代码实现分析
Note: 代码未开源。
实现细节:
- 基于 Wan-1.3B 视频扩散 Transformer 微调
- 自定义块因果注意力掩码(block-causal mask)
- 1D 卷积时域压缩对齐 keyboard/video latent
- 冻结 CLIP ViT encoder 用于身份嵌入
- 自定义 DMD distillation 训练 pipeline
- 结构化剪枝 VAE decoder
硬件要求:
- 训练:多 GPU(未明确)
- 推理:单张 NVIDIA RTX 5090,30 FPS @ 512×384
六、实验结果
实验设置
| 配置项 | 值 |
|---|---|
| 基础模型 | Wan-1.3B |
| 分辨率 | 512×384 |
| 帧率 | 30 FPS |
| 硬件 | 单张 NVIDIA RTX 5090 |
| Chunk 长度 | 8 帧 (~0.27s) |
| KV 缓存 | 最近 2 chunks (16 帧) |
| DMD 步数 | 4 步 |
| Transformer blocks | 30 (每 3 个注入一次键盘条件) |
| 输入键位 | P1: WASD + UIJK; P2: 方向键 + 小键盘 7,8,4,5 |
测试集(500 个输入序列):
- 150 基本单玩家动作
- 100 组合单玩家输入
- 100 无接触双玩家序列
- 150 有接触双玩家序列
评估指标:
- LPIPS( perceptual similarity,越低越好)
- SSIM(structural similarity,越高越好)
- DINOv2(high-level visual similarity cosine,越高越好)
Ground truth 通过 KOF ‘97 模拟器用相同输入重渲染获得,像素级对齐。
定量评估(Tab. 2)
| 方法 | LPIPS ↓ | SSIM ↑ | DINOv2 ↑ |
|---|---|---|---|
| Floor (重复首帧) | 0.49 | 0.52 | 0.71 |
| 多步教师(无 DMD,上界) | 0.15 | 0.74 | 0.85 |
| WanToFight (4-step student) | 0.17 | 0.71 | 0.82 |
| w/o Player Association | 0.29 | 0.57 | 0.69 |
| w/o Gated keyboard injection | 0.19 | 0.69 | 0.80 |
| w/o Curriculum training | 0.22 | 0.66 | 0.78 |
关键发现:
- 4-step 学生模型与多步教师在 LPIPS/SSIM/DINOv2 上差距 ≤ 0.03,DMD 蒸馏有效
- 移除 Player Association 导致双玩家类别性能显著下降(LPIPS 0.17→0.29),主要在 ID crosstalk 场景
- 移除门控使模型对噪声输入更敏感(LPIPS 0.17→0.19)
- 跳过三阶段课程学习产生质量下降(LPIPS 0.17→0.22)
多玩家身份绑定一致性(Tab. 3)
通过 VLM judge 评估,每序列使用输入不对称协议(不同角色 + 可区分的动作脚本)。
| 场景 | 测试数 | WanToFight (%) | w/o Player Association (%) |
|---|---|---|---|
| 静态位置 | 100 | 100 | 84 |
| 跳跃穿越位置交换 | 100 | 100 | 21 |
| 追逐/交叉位置交换 | 100 | 99 | 9 |
| 视觉重叠/遮挡 | 100 | 97 | 3 |
| 长时间会话 (>60s) | 100 | 91 | 0 |
| 总体 | 500 | 97 | 23 |
关键发现:
- Player Association 在位置交换场景下表现尤为关键(100% vs 21%,79pp 差距)
- 视觉遮挡场景差距最大(97% vs 3%,94pp 差距)
- 无身份绑定时长时间会话完全失效(0% vs 91%)
- 静态位置场景下基础模型仍有 84% 表现,说明空间位置本身提供了弱身份线索
定性评估
单玩家键盘控制(Fig. 4):
- 移动、跳跃、蹲伏、基本攻击、击中对手均正确响应
- 组合输入(对角跳跃、蹲伏攻击)产生预期动作
- chunk 边界处角色动画连续,快速输入无明显跳帧
双玩家身份绑定(Fig. 5):
- 角色交叉侧边、视觉重叠时,键盘-to-角色绑定保持一致
- 未观察到 ID crosstalk 故障模式
- 基本战斗物理(击退、击晕、倒地动画)正确生成
长时间生成(Sec. 4.4):
- 两分钟完整对战(~3600 帧)无明显视觉退化
- 显著超过 161 帧(~5.4s)的训练视野
- 验证了滚动 KV 缓存在流式推理中的有效性
七、相关工作
生成式游戏引擎
- GameNGen (2408.14837):DOOM 实时生成,支持射击但仅限单玩家
- Oasis (2412.03568):Minecraft 实时生成,支持对象移动和建造
- Yan (2508.08601):探索基础交互式视频生成,碰撞检测有限
- Matrix-Game (2506.18701) / Matrix-Game 2.0 (2508.13009):实时可交互世界模型
- Multiverse:Gran Turismo 双视角竞速,非实时
- Solaris (2602.22208):Minecraft 合作双玩家,非实时
- MultiWorld (2604.18564):It Takes Two 合作多智能体,非实时
- WorldMem (2504.12369):长期一致性世界模拟,单玩家
流式自回归视频生成
- Diffusion Forcing (2307.04997):引入独立 per-frame timesteps,使自回归 rollout 自然涌现
- CausVid (2311.18828):通过 ODE regression + DMD 将双向教师转为因果学生
- SelfForcing (2506.08009):进一步缩小 train-test gap,在学生生成上监督
Few-Step 蒸馏
- DMD (2311.18828):在保留 timestep 上最小化学生与教师的分布散度
- 与一致性蒸馏不同,DMD 不要求逐步骤匹配,只需在离散 timestep 上匹配分布
八、核心创新总结
- 四合一生成式游戏引擎:首次在同一系统中实现多玩家控制、实时推理、复杂物理交互和对抗性玩法,填补了格斗游戏领域的空白
- Player Association 模块:参考图像驱动的跨注意力身份绑定,通过冻结 CLIP 编码器解决 ID crosstalk,与 Solaris/MultiWorld 的学习型嵌入方案形成鲜明对比
- 块因果自回归 + DMD 蒸馏:三阶段训练(双向 → 因果 → 蒸馏),4-step 学生匹配多步教师性能,实现单卡 30 FPS
- 局部因果键盘控制:窗口注意力(size=3)+ 门控融合,适应格斗游戏中突发性高频率输入
- 三阶段课程学习:单玩家 → 双玩家 → 完整对战,渐进难度显著提升训练稳定性
- 自动化数据收集流水线:人工录制 → 策略训练 → 自动化回放,构建了游戏域配对数据集
九、局限性
- 复杂动画视觉保真度:Wan-1.3B 骨干容量有限,512×384 分辨率丢失精细 sprite 细节,翻滚、特殊技等高频率运动区域偶尔出现粗糙姿势或局部伪影
- 长时间累积漂移:两分钟以上对局中,小误差逐 chunk 累积逐渐降低视觉质量
- 单游戏范围:仅在 KOF ‘97 上训练,迁移到其他格斗游戏需要扩展训练数据和统一角色/动作表示
- 多玩家扩展未验证:Player Association 可扩展至 N 玩家,但 时的注意力复杂度、训练数据需求和视觉容量尚未表征
- 代码未开源
十、未来方向
- 更强的骨干模型和更高分辨率以提升视觉质量
- SelfForcing-style 训练进一步缩小 train-test gap
- 扩展到多格斗游戏和统一多游戏引擎
- 验证 Player Association 在 玩家时的扩展性
- LLC prefetch 策略和自适应 chunk 长度
十一、参考资源
- arXiv: 2607.12592
- 项目页面: https://humanaigc.github.io/wantofight/
- 相关论文: Wan-1.3B (2503.20314), HunyuanVideo (2412.03603), GameNGen (2408.14837), Oasis (2412.03568), Solaris (2602.22208), MultiWorld (2604.18564), Diffusion Forcing (2307.04997), CausVid (2311.18828), SelfForcing (2506.08009), DMD (2311.18828)
- 基础模型: Wan-1.3B (video diffusion transformer), CLIP (identity embedding)
附图索引
| 编号 | 文件名 | 说明 |
|---|---|---|
| Figure 1 | figure-1-WanToFight_gameplay_generation.png | WanToFight 实时键盘输入生成游戏画面 |
| Figure 2 | figure-2-WanToFight_overview_autoregressive_video_diffusion.png | WanToFight 自回归视频扩散引擎总览 |
| Figure 3 | figure-3-Player_Association_identity_embedding.png | Player Association 身份嵌入架构 |
| Figure 4 | figure-4-Keyboard_control_validation_single_player.png | 单玩家键盘控制验证 |
| Figure 5 | figure-5-Gameplay_validation_two_player.png | 双玩家对战验证 |
| Table 1 | 论文中 Table 1 | 生成式游戏引擎能力对比 |
| Table 2 | 论文中 Table 2 | 动作精度和消融实验 |
| Table 3 | 论文中 Table 3 | 多玩家身份绑定一致性评估 |