WanToFight: Real-Time Generative Game Engine for Multi-Player Combat Interaction
First generative game engine combining multi-player control, real-time inference, complex physical interaction, and adversarial gameplay in KOF '97
WanToFight: Real-Time Generative Game Engine for Multi-Player Combat Interaction
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | WanToFight: Real-Time Generative Game Engine for Multi-Player Combat Interaction |
| 作者 | Li Hu, Guangyuan Wang, Peng Zhang, Bang Zhang |
| 机构 | Tongyi Lab, Alibaba (通义实验室) |
| 论文 | arXiv:2607.12592 |
| 代码 | — (未公开) |
| Project Page | https://humanaigc.github.io/wantofight/ |
| 发布 | 2026-07-14 |
| 许可 | — |
二、核心思想
问题定义
传统游戏开发依赖三个独立编写的组件:手工制作的素材、硬编码的游戏逻辑,以及将二者组合为视频帧的渲染引擎。这一流程劳动密集型,玩家体验受限于开发者预先设定的规则和素材。近期视频扩散模型的进展使得”单一模型替代传统管线”——即生成式游戏引擎(Generative Game Engine)——成为可能,该引擎从玩家输入直接联合合成游戏逻辑与视觉效果。
然而,已有生成式游戏引擎主要聚焦于单人第一人称场景(如 DOOM、Minecraft),或非实时合作设定。以下四个能力在格斗游戏中缺一不可,却从未被联合实现:
- 多玩家控制 (Multi-Player Control) — 两个玩家同时通过键盘输入控制各自角色
- 实时推理 (Real-Time Inference) — ≥30 FPS 单消费级 GPU
- 复杂物理交互 (Complex Physics) — 精确到帧的攻击判定、击退、KO 机制
- 对抗性玩法 (Adversarial Gameplay) — 直接战斗、伤害与 KO,区别于竞速或合作
解决方案概述
WanToFight 基于 Wan-1.3B 视频扩散 Transformer,提出三个核心组件来填补上述空白:
- 流式自回归游戏引擎 — 分块(chunk-wise)自回归生成 + 块因果注意力(block-causal attention)+ 滚动 KV 缓存,支持无限时长的连续对局生成。
- 视觉锚定的玩家关联模块(Player Association) — 通过参考图像 + 冻结 CLIP 编码器绑定每个玩家的键盘信号与其角色身份,防止多玩家时的 ID 串扰。
- 门控局部因果键盘注入模块 — 每 3 个 DiT 块插入一次 cross-attention 注入,配合数据依赖的 sigmoid 门控和时间窗口限制,确保控制信号的局部因果性。
配合 4 步 DMD 蒸馏学生模型 + 结构化剪枝 VAE 解码器,系统在单张 NVIDIA RTX 5090 上以 512×384 分辨率维持 30 FPS 完整对局生成。
三、技术架构
整体框架图
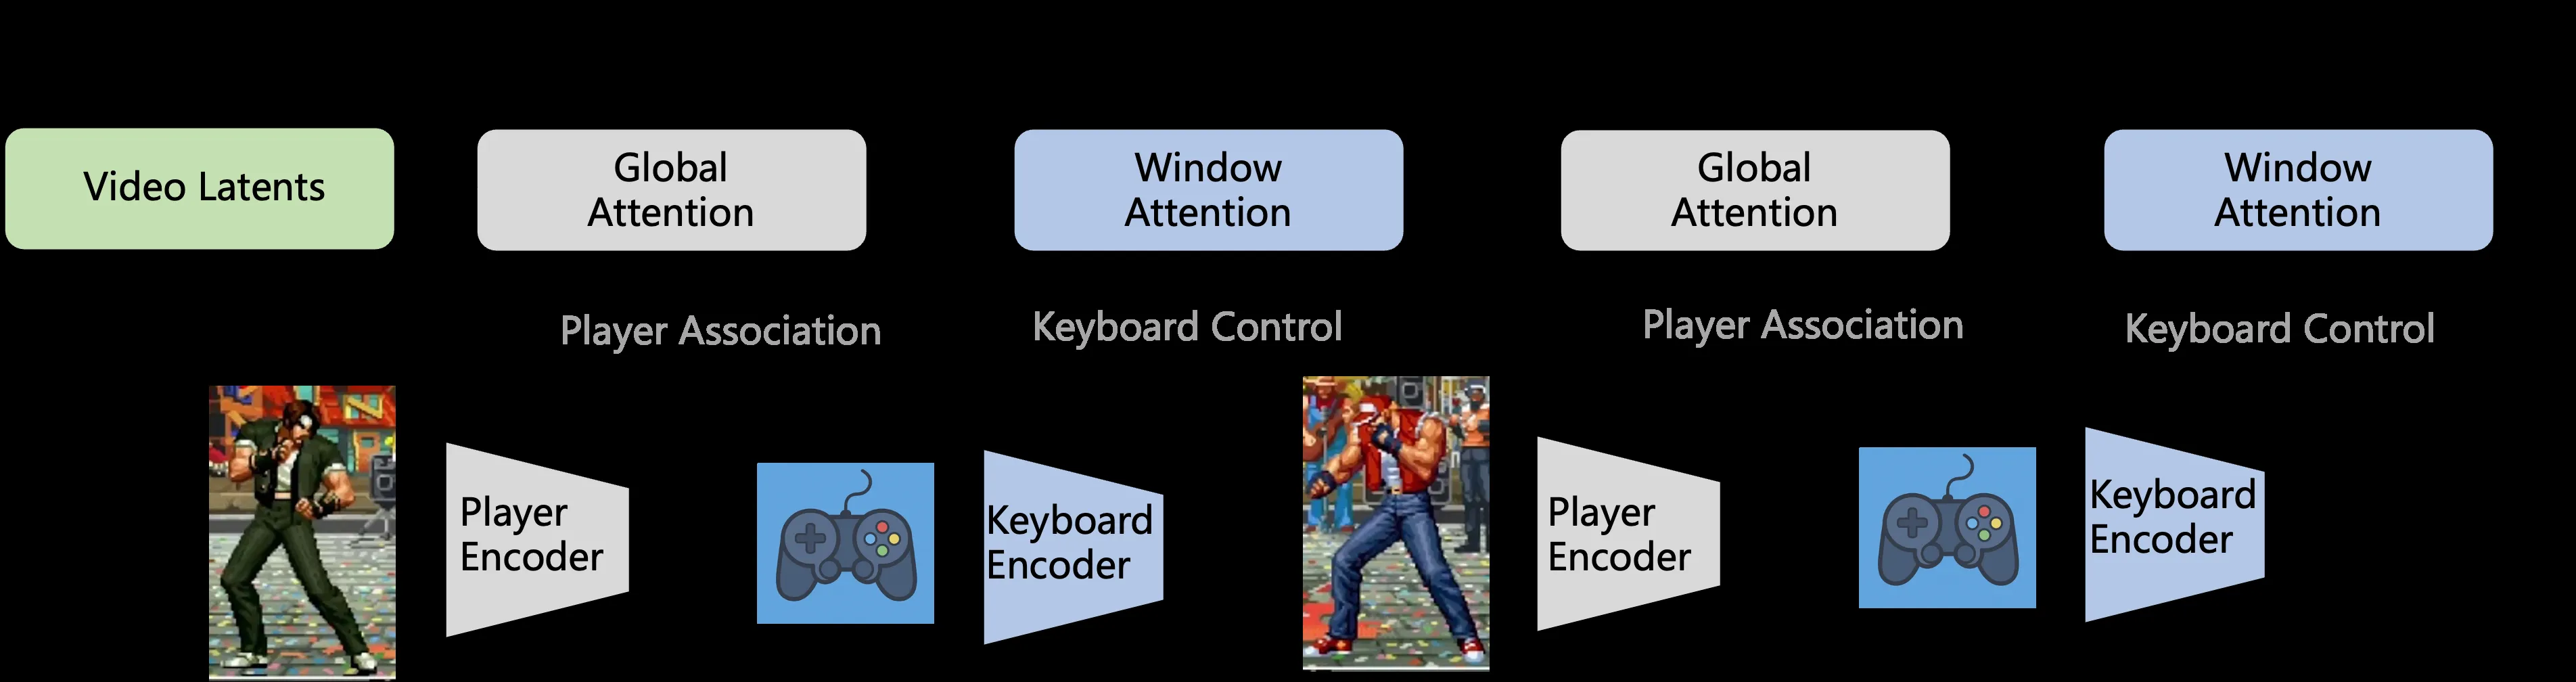
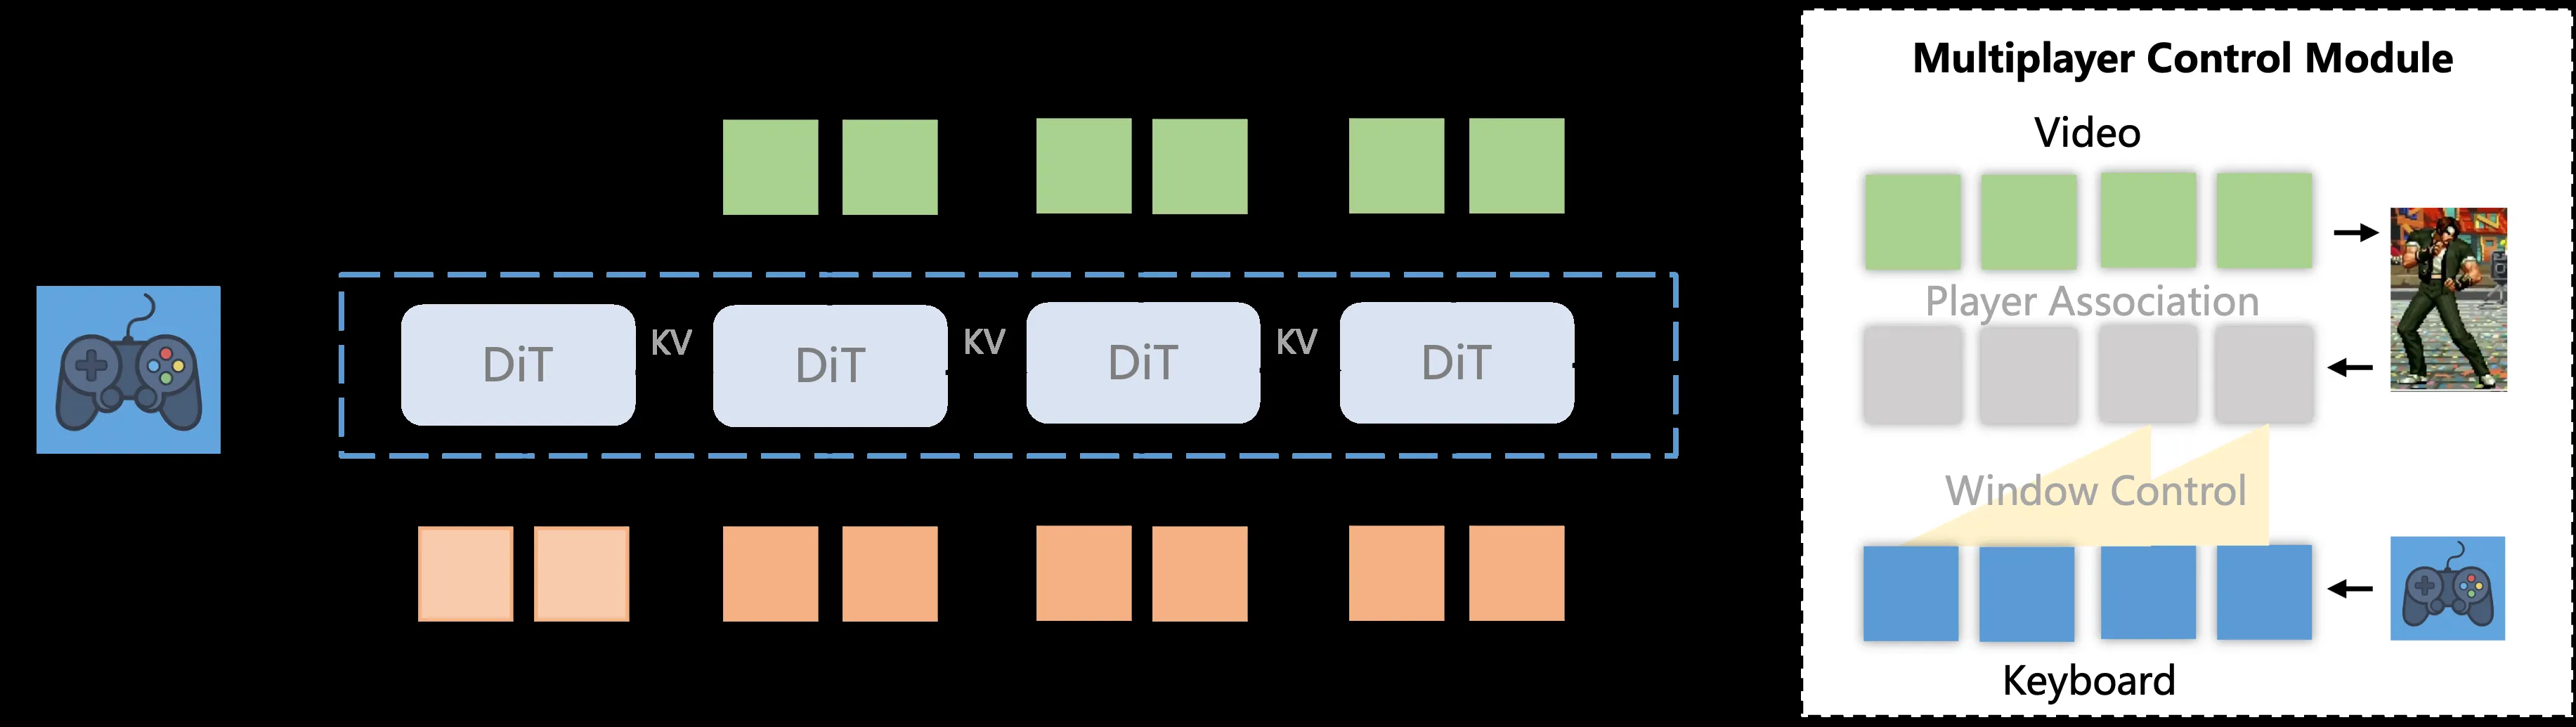
WanToFight 的核心是一个自回归视频扩散引擎,按 chunk 逐段生成游戏画面。给定初始帧和键盘输入流,模型通过缓存的注意力状态 conditioning 上一 chunk 来生成下一 chunk。Player Association 模块通过参考图像驱动的注意力将每个玩家的键盘信号绑定到对应角色;Window Attention 机制限制每个视频 latent 仅关注邻近的键盘 latents,强制控制的局部因果性。
核心公式
问题建模:
其中 表示视频帧序列, 表示对应的键盘输入序列。 为 chunk 长度(约 0.27 秒 @ 30 FPS)。
门控融合:
其中 为 sigmoid 函数, 是 cross-attention 输出, 是数据依赖的门控信号, 替换 作为注入 DiT backbone 的贡献。该门控可以抑制无关输入(如不可中断动画期间的按键),同时保留决定性输入的贡献。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Backbone | Wan-1.3B 视频扩散 Transformer | 30 个 DiT block, 1.3B 参数量 |
| Chunk Generator | 分块自回归生成器 | 每 chunk 帧, 约 0.27s |
| Block-Causal Attention | 块因果注意力掩码 | 每 chunk 内双向,跨 chunk 仅看当前+前 2 个 |
| Rolling KV Cache | 滚动 KV 缓存 | 保留最近 2 chunks (16 帧) 的 penultimate denoising step 的 KV |
| Keyboard Encoder | 1D 卷积编码 | 16 维二进制向量 → 时间压缩对齐视频 latent |
| Keyboard Injection | Cross-attention 注入 | 每 3 个 block 一处,共 10 处注入点 |
| Window Attention | 时间窗口限制 | 窗口大小 3(当前 latent + 前 2 个键盘 latent) |
| Gated Fusion | Sigmoid 门控 | 数据依赖的门控过滤噪声输入 |
| Player Association | 参考图像身份绑定 | 冻结 CLIP 编码器 + cross-attention, 串行处理 |
| DMD Distiller | 分布匹配蒸馏 | 全参数优化,压缩至 4 步学生模型 |
| Pruned VAE Decoder | 结构化剪枝解码器 | 减少参数量,在游戏域帧上微调 |
训练流程
WanToFight 采用 三阶段训练管线:
Stage 1: 双向预训练 (Bidirectional Pretraining)
- 在游戏数据上 fine-tune Wan-1.3B,保留原始双向注意力
- 每个训练样本包含 161 帧(约 20 个 chunk,每 chunk 8 帧)
- 同步训练键盘控制模块
- 长训练窗口的意图:捕捉跨 chunk 的多 chunk 动力学(跳跃弧线、击退轨迹、连招恢复动画等)
Stage 2: 因果适配 (Causal Adaptation)
- 将双向模型转换为块因果模型以支持流式推理
- 密集注意力掩码替换为块因果掩码:chunk 内双向,chunk 间只看当前 + 前 2 个 chunk
- 不同 chunk 分配独立的扩散时间步(借鉴 Diffusion Forcing 思想),防止模型坍缩到单一噪声水平
- 推理时维护滚动 KV 缓存(最近 2 chunks = 16 帧)
Stage 3: 效率优化 (Efficiency Optimization)
- DMD 蒸馏:全参数分布匹配蒸馏,将因果教师压缩为 4 步学生模型
- 剪枝 VAE 解码器:结构化减少参数量并在游戏域帧上微调,降低每帧解码成本
Curriculum Training(课程学习)
在 Stage 1 双向预训练期间采用三阶段课程:
- 单人动作 — 模型学习单个按键到角色动画的映射
- 多人动作 — 双玩家同时输入,促使 Player Association 建立稳定的身份-按键绑定
- 完整对局 — 全速比赛数据,学习长线游戏逻辑(连招、位置交换、击退恢复、攻防节奏)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个四合一生成式游戏引擎 | 同时支持多玩家控制、实时推理、复杂物理交互、对抗性玩法 | Tab. 1 对比所有现有方法无一同时满足四项 |
| 视觉锚定的 Player Association | 用冻结 CLIP 编码的参考图像绑定玩家身份,而非可学习的嵌入 | Tab. 3: 位置交换场景下 100% vs 基线 21%,遮挡场景 97% vs 33% |
| 块因果注意力 + 滚动 KV 缓存 | 每 chunk 内双向、跨 chunk 因果,仅缓存最近 2 chunks | 支持超过训练时长 10 倍以上的连续对局(~2 分钟 vs 训练 ~5.4 秒) |
| 门控局部因果键盘注入 | 每 3 个 block 注入 + 窗口大小 3 的时间限制 + sigmoid 门控 | 抑制不可中断动画期间的无效按键,提升高频输入稳定性 |
| 4 步 DMD 蒸馏 + 剪枝 VAE | 全参数蒸馏压缩 + 结构化解码器剪枝 | 单张 RTX 5090 上 30 FPS @ 512×384,LPIPS 仅比教师高 0.02 |
五、实验结果
基准测试
Action Accuracy(动作准确率)— 在 500 条受控输入序列上评估:
| Method | LPIPS ↓ | SSIM ↑ | DINOv2 ↑ |
|---|---|---|---|
| Repeat first frame (floor) | 0.49 | 0.52 | 0.71 |
| Multi-step teacher (no DMD, upper bound) | 0.15 | 0.74 | 0.85 |
| WanToFight (Ours) | 0.17 | 0.71 | 0.82 |
| w/o Player Association | 0.29 | 0.57 | 0.69 |
| w/o Gated keyboard injection | 0.19 | 0.69 | 0.80 |
| w/o Curriculum training | 0.22 | 0.66 | 0.78 |
关键发现:
- 4 步学生模型与多步教师仅相差 0.02 LPIPS / 0.03 SSIM / 0.03 DINOv2,证明 DMD 蒸馏几乎无损视觉保真度
- 移除 Player Association 后性能显著下降,尤其在双人类别中键盘偶尔驱动错误角色
- 移除门控使模型对噪声输入更敏感
- 跳过课程训练导致质量下降
多玩家身份绑定一致性
| Scenario | # Tests | WanToFight (%) ↑ | w/o Player Association (%) ↑ |
|---|---|---|---|
| Static positions | 100 | 100 | 84 |
| Position swap via jump-over | 100 | 100 | 21 |
| Position swap via chase/cross | 100 | 99 | 9 |
| Visual overlap / occlusion | 100 | 97 | 33 |
| Long session (>60 s) | 100 | 91 | 0 |
| Overall | 500 | 97 | 23 |
Player Association 在位置交换和遮挡场景下带来 79–94 个百分点的巨大提升,证明视觉参考锚定远优于隐式输入拼接。
定性验证
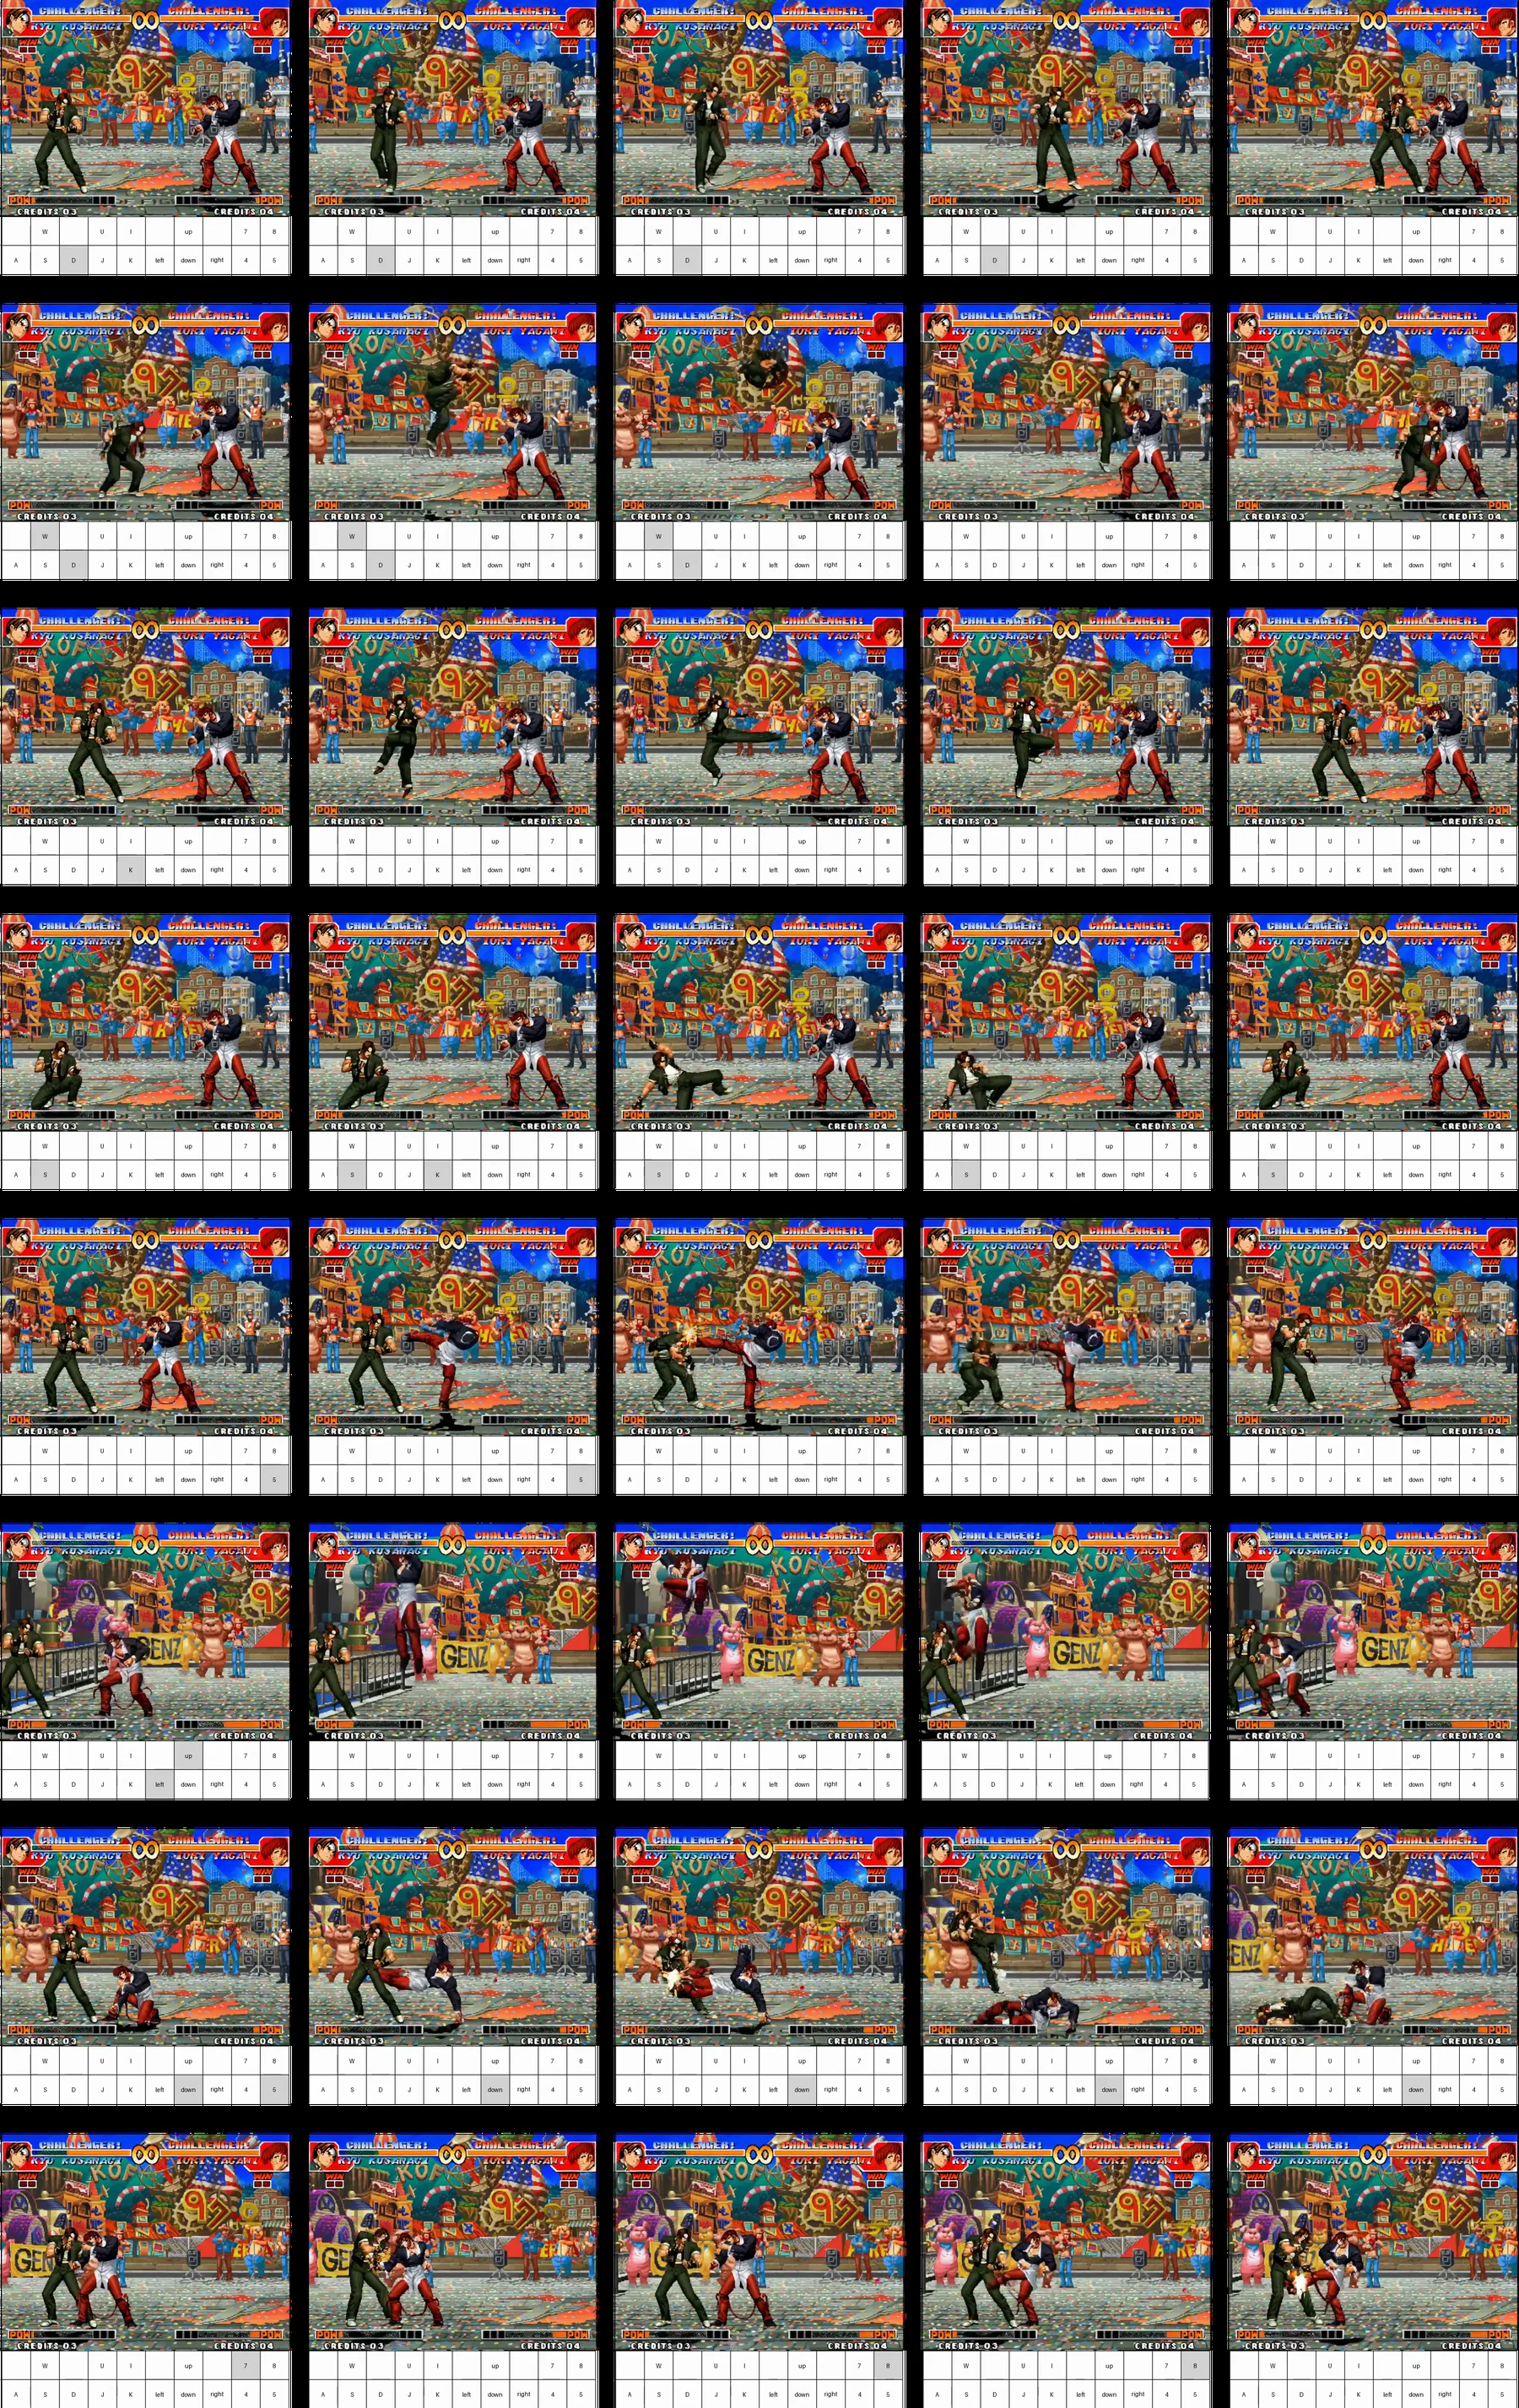
单人模式下,系统对基本移动、跳跃、蹲伏、攻击、命中对手等动作响应准确。复合输入(如向右上方跳跃、蹲伏攻击)产生预期动作。Chunk 边界处动画连续,快速输入无跳帧。
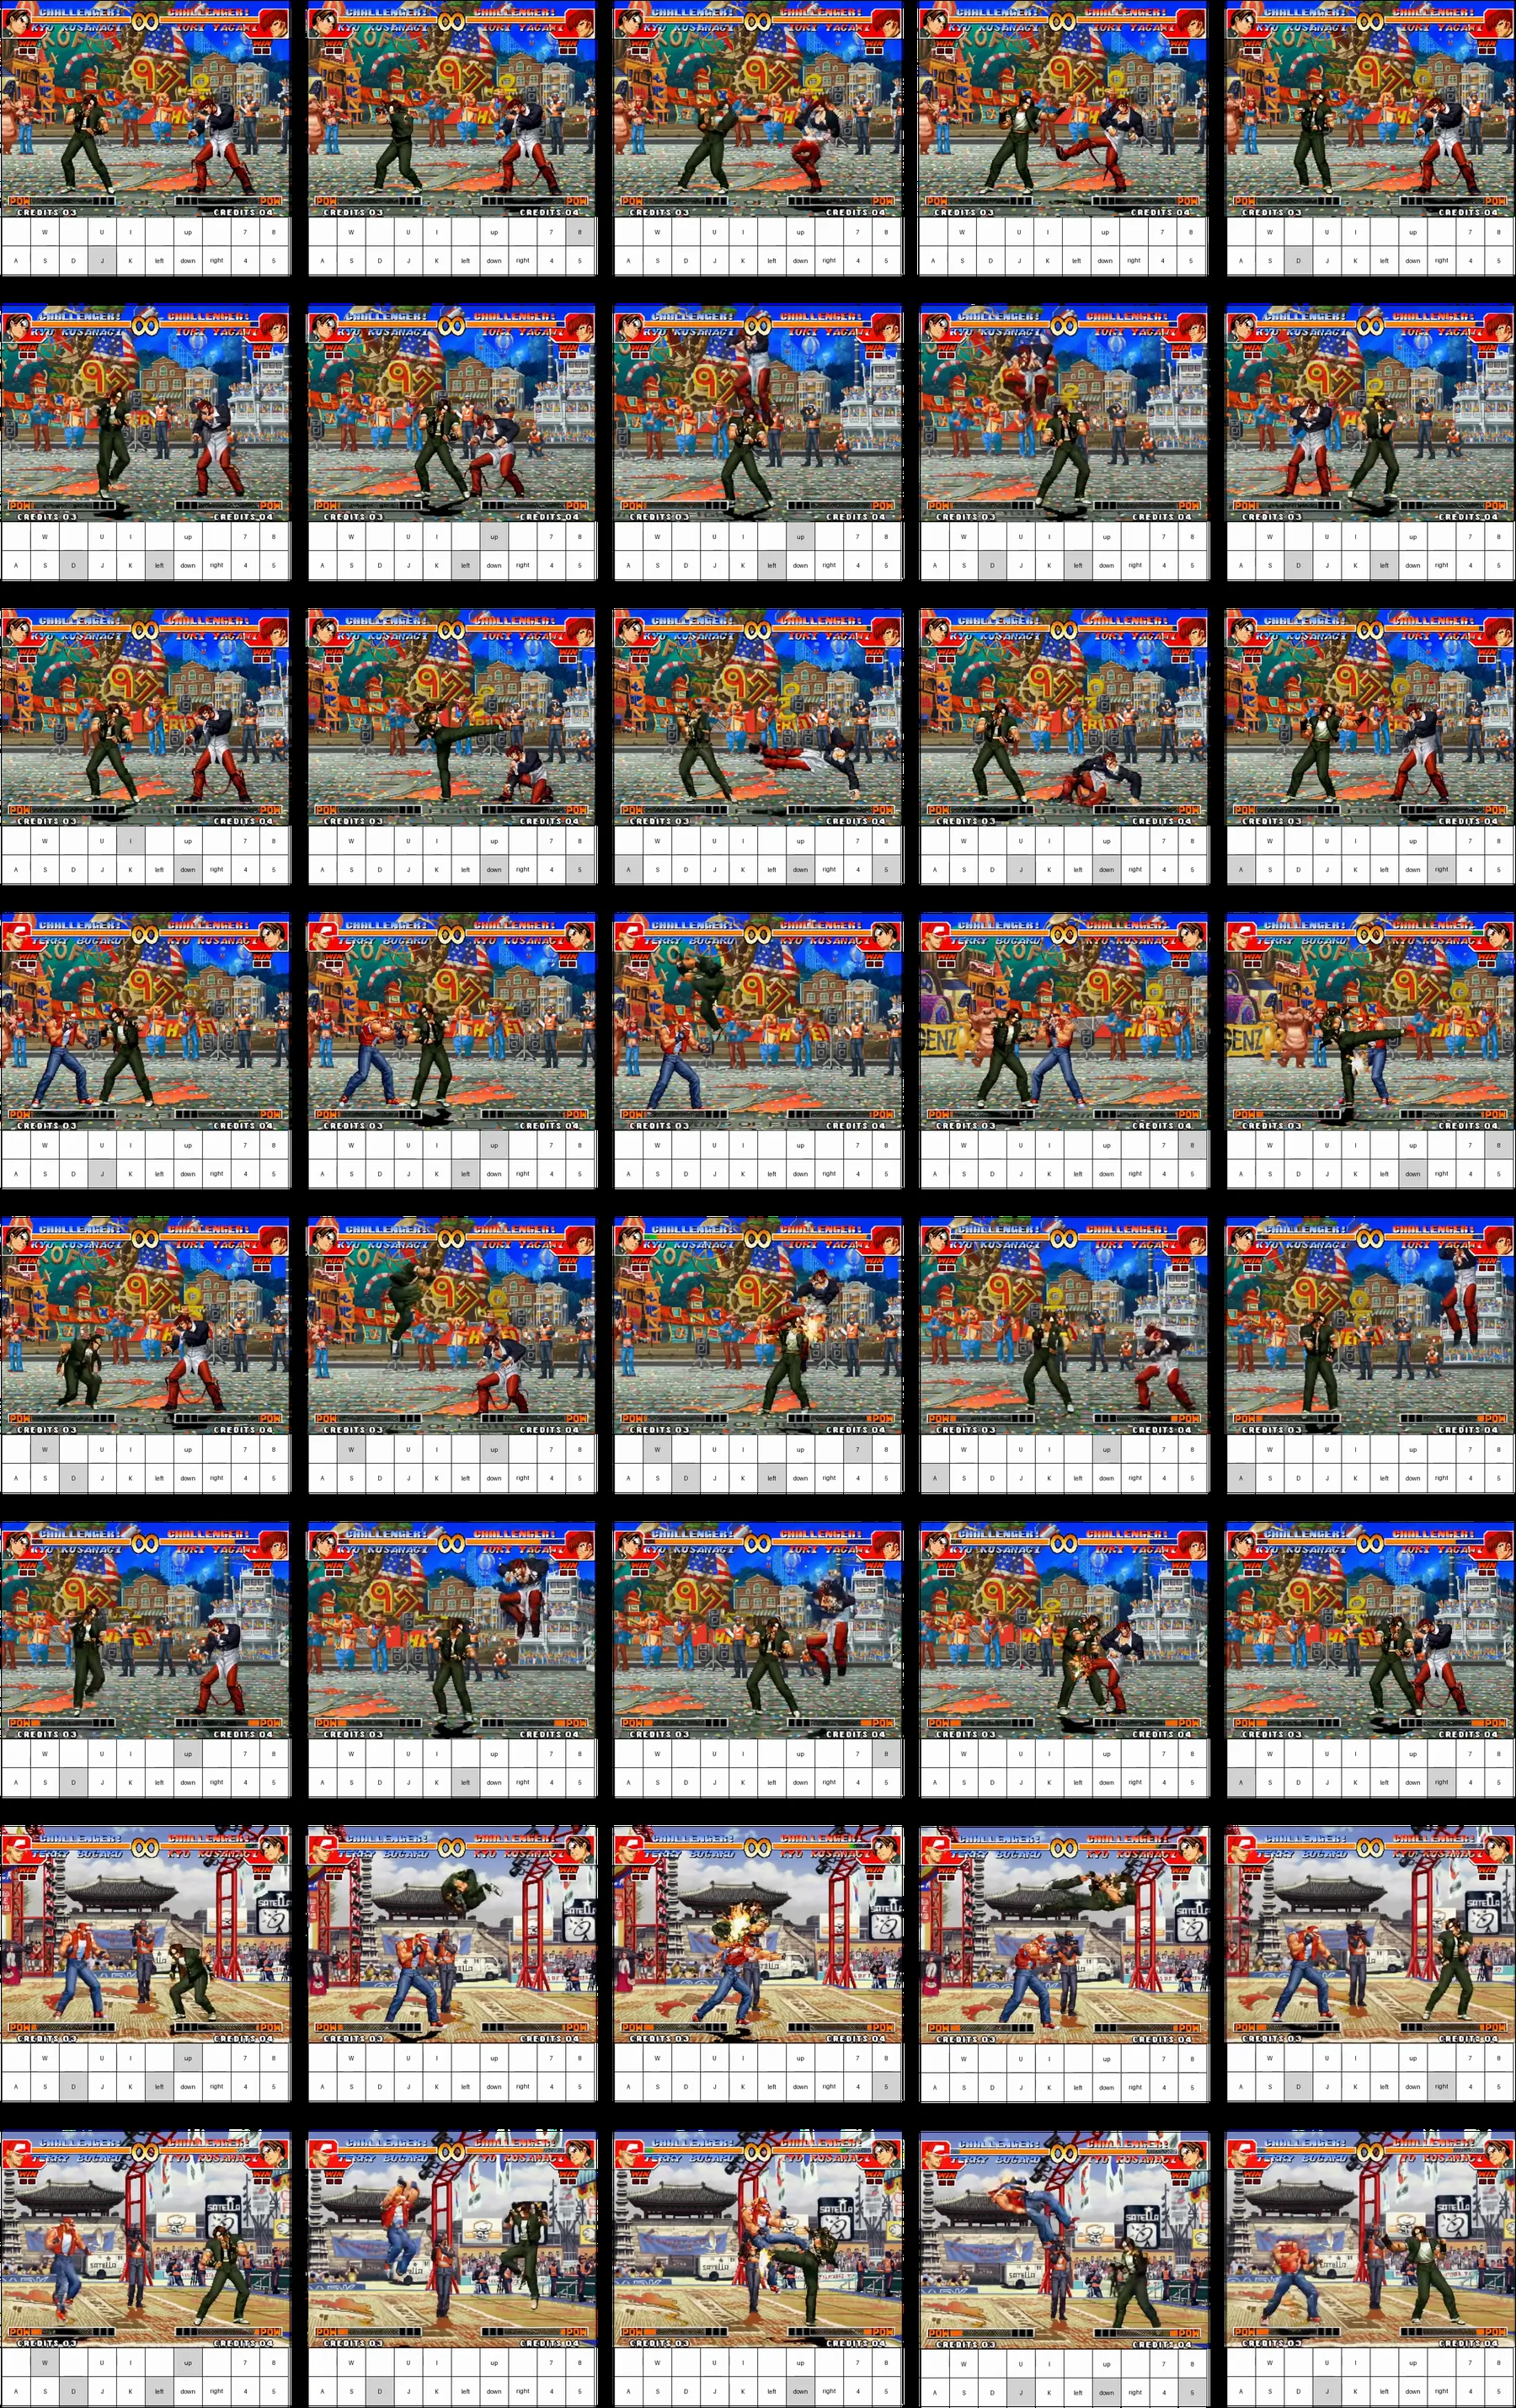
双人模式下,即使角色交叉换位或视觉重叠,键盘-角色绑定保持稳定。碰撞产生合适的击退、命中僵直和倒地动画。
长时间生成
通过将角色接触延迟以避免早期 KO,系统生成了从对局开始到 KO 的连续约 2 分钟 gameplay,远超 161 帧(~5.4 秒)的训练时长,验证了滚动 KV 缓存在流式推理中的有效性。
五、代码实现分析
本项目代码未公开,但从论文描述可推断核心实现要点:
- Backbone: 基于 Wan-1.3B (
wanrepo),修改注意力掩码为块因果 - KV Cache: 在 penultimate denoising step 缓存 KV,每 chunk 生成后更新
- Keyboard Module: 1D Conv 编码 → Cross-attention 注入(每 3 blocks)→ Window mask (size=3) → Sigmoid gate
- Player Association: 冻结 CLIP 编码参考图像 → Cross-attention 绑定身份 → 串行注入按键
- Distillation: DMD 全参数蒸馏至 4 步
- VAE Pruning: 结构化剪枝 + 游戏域微调
六、局限性
- 复杂动画视觉保真度 — KOF ‘97 的翻跟头、特殊招式等高频率运动 regime 下,偶有粗略姿态或局部伪影。受限於 Wan-1.3B 的视觉容量和 512×384 输出分辨率。
- 长时间累积漂移 — 流式生成 + 双 chunk 滚动缓存足以覆盖 ~2 分钟对局,但小误差在多 chunk 间累积会逐步降低视觉保真度。
- 单游戏范围 — 仅在 KOF ‘97 上训练。迁移到其他格斗游戏需要扩展训练数据和统一的角色/动作表征。
- 多角色可扩展性未验证 — Player Association 可扩展至 N 玩家,但 N≥3 时的注意力复杂度、训练数据需求和视觉容量尚未验证。
七、总结
核心贡献
- 首个四合一生成式格斗游戏引擎 — 联合多玩家控制、实时推理、复杂物理交互、对抗性玩法
- 流式自回归生成架构 — 块因果注意力 + 滚动 KV 缓存 + 独立 chunk 扩散时间步
- 视觉锚定的玩家关联模块 — 冻结 CLIP 参考图像绑定身份,彻底消除 ID 串扰
- 门控局部因果键盘注入 — 跨层注入 + 窗口限制 + sigmoid 门控,适应突发性输入
- 高效蒸馏方案 — 4 步 DMD + 剪枝 VAE 解码器,单卡 RTX 5090 达 30 FPS
技术影响
同一技术路线(参考图像身份锚定 + 流式块因果自回归 + 少步蒸馏)应可扩展到其他需要实时每智能体控制的互动游戏类型。
未来方向
- 超越单一游戏,扩展到多游戏统一引擎
- 验证 N≥3 玩家的可扩展性
- 结合 Self-Forcing 风格训练缩小 train-test gap
八、参考资源
- arXiv: https://arxiv.org/abs/2607.12592
- Project Page: https://humanaigc.github.io/wantofight/
- Backbone: Wan-1.3B (https://arxiv.org/abs/2503.20314)
- DMD: Distribution Matching Distillation (https://arxiv.org/abs/2311.18828)
- CLIP: Learning Transferable Visual Models (https://arxiv.org/abs/2103.00020)