Scaling Mixture-of-Experts Video Pretraining for Embodied Intelligence
LingBot-Video — 首个开源大规模 MoE 视频基础模型,面向具身智能的单流扩散 Transformer,稀疏 MoE + 五阶段课程预训练 + 多维奖励 GRPO 后训练
Scaling Mixture-of-Experts Video Pretraining for Embodied Intelligence: LingBot-Video
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Scaling Mixture-of-Experts Video Pretraining for Embodied Intelligence |
| 作者 | Shuailei Ma*, Jiaqi Liao*, Xinyang Wang*, Jingjing Wang*, Chaoran Feng, Zijing Hu, Chong Bao, Zichen Xi, Yuqi Gan, Weisen Wang, Yanhong Zeng, Qin Zhao, Zifan Shi, Wei Wu, Hao Ouyang, Qiuyu Wang, Shangzhan Zhang, Jiahao Shao, Yipengjing Sun, Liangxiao Hu, Lunke Pan, Nan Xue, Kecheng Zheng, Yinghao Xu, Xing Zhu, Yujun Shen |
| 机构 | RobbyAnt |
| 论文 | https://arxiv.org/abs/2607.07675 |
| 代码 | https://github.com/robbyant/lingbot-video |
| 网站 | https://technology.robbyant.com/lingbot-video |
| Checkpoints | https://huggingface.co/robbyant/lingbot-video |
二、核心思想
问题定义
视频生成模型与具身智能之间存在根本性的领域错配(domain mismatch)。现有视频基础模型主要优化感知质量——如真实感、美学和文本对齐——而非物理正确性或可控性。虽然这些目标产生视觉上引人注目的结果,但并不明确强制执行与物理交互约束的一致性,如接触稳定性、刚体动力学或在干预下的长视域状态一致性。互联网规模视频提供丰富的视觉多样性,但不保证具身交互约束的保真度。
具体而言,现有方法在三个紧密耦合的维度上存在不足:
- 架构:大多数基于扩散的视频 Transformer 依赖密集计算,所有参数在所有 token 和时间步均匀激活,导致推理成本高昂且可扩展性有限
- 数据:训练语料库以互联网视频为主,缺乏机器人具身先验或精确交互动力学
- 训练目标:当前对齐策略主要优化美学质量和文本-视频对应关系,未纳入显式的物理可行性、任务完成或长视域奖励信号
解决方案概述
LingBot-Video 是一个专为具身智能设计的 DiT 视频预训练范式,通过三个集成组件解决上述限制:
- 稀疏 MoE 视频框架:采用 Mixture-of-Experts 替代密集框架,实现稀疏条件计算,提升推理效率的同时扩展模型容量以应对复杂时空动态
- 机器人增强预训练语料库:构建数据画像引擎(Data Profiling Engine),将标准互联网视频与大量机器人导向片段(包括操作、导航和第一人称视角)统一,赋予基础模型对动作和世界动力学的内在理解
- 多维奖励系统:超越美学目标,纳入物理合理性和任务导向成功信号,鼓励模型学习符合具身环境的动力学和交互
LingBot-Video 是迄今为止首个大规模开源 MoE 视频基础模型,旨在弥合数字视频创作与物理执行之间的差距。
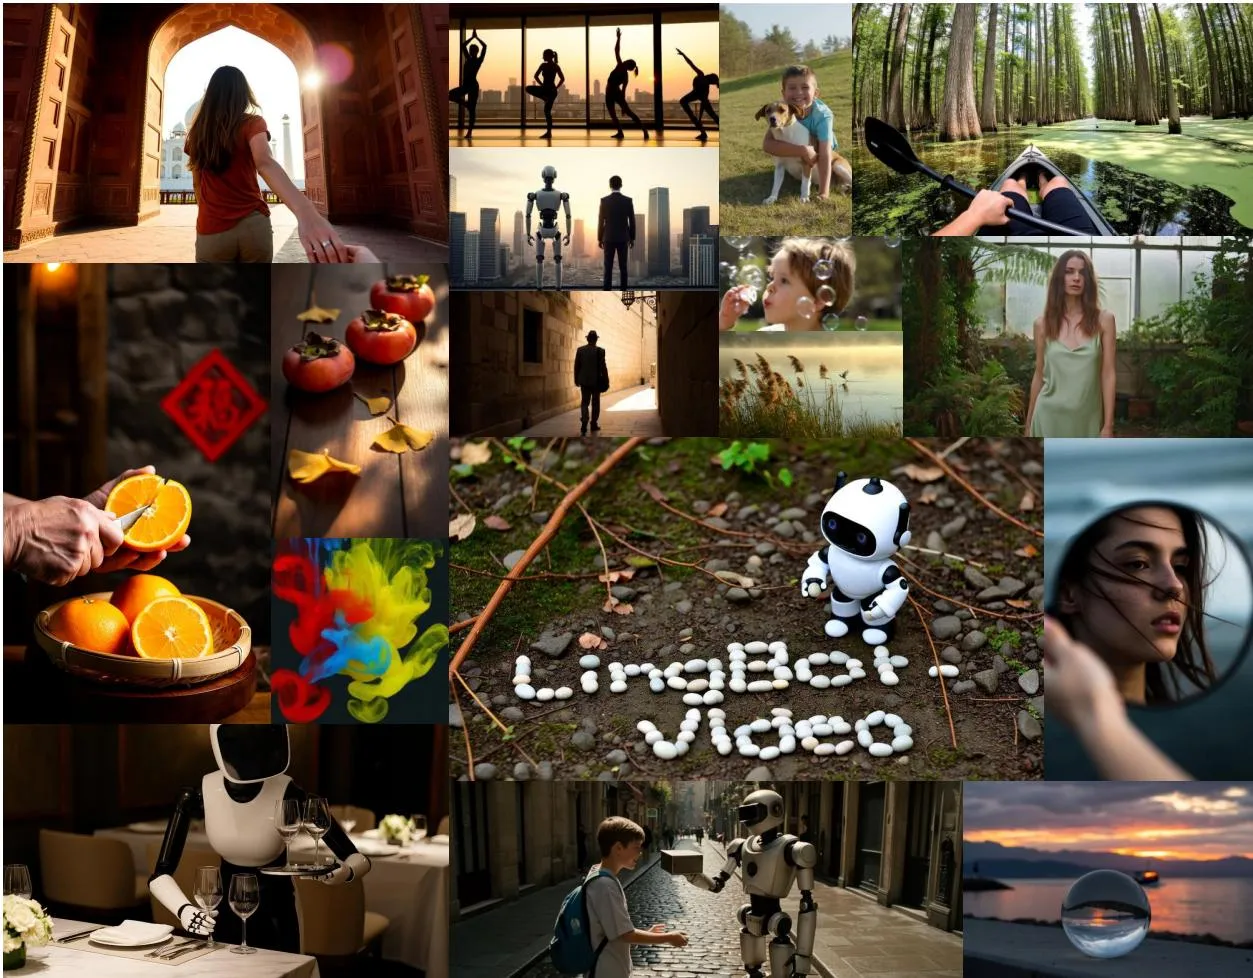
三、技术架构
整体框架图
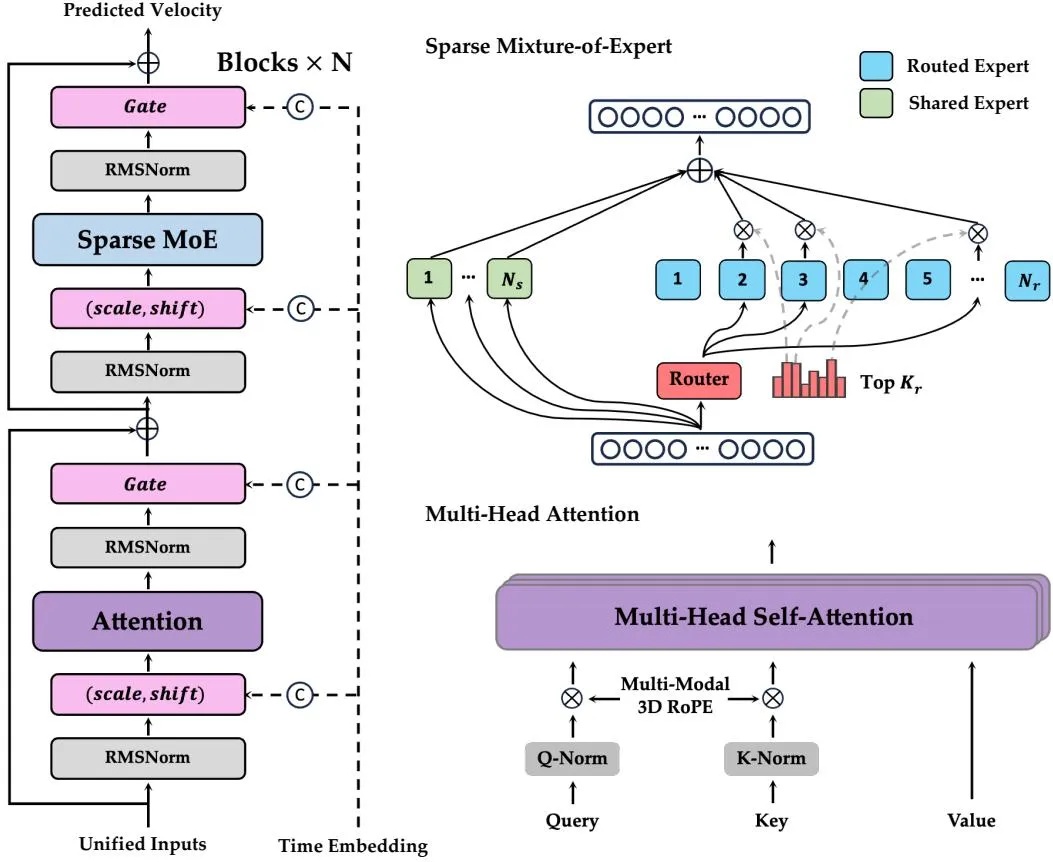
LingBot-Video 采用级联设计,由任务统一的基线生成器和精炼器组成。
基线生成器:使用单流扩散 Transformer(Single-Stream Diffusion Transformer)处理紧凑视觉潜在变量和多模态条件。使用 Qwen3-VL-4B 从多模态指令提取条件,Wan2.1-VAE 进行高效视觉潜在压缩。
精炼器(Refiner):将视频从 480p 超分到 1080p,学习从退化条件到干净目标的条件 rectified flow。
┌─────────────────────────────────────────────────────┐
│              LingBot-Video Architecture              │
├─────────────────────────────────────────────────────┤
│  Unified Input Formulation                          │
│  ┌──────────┐  ┌──────────┐  ┌──────────┐          │
│  │ Condition│+│Visual Latent│→│Single Seq│          │
│  │  Tokens  │  │   Patches  │  │ Token    │          │
│  └──────────┘  └──────────┘  └──────────┘          │
│                    ↓                                  │
│  Multi-Modal 3D RoPE (non-overlapping coords)       │
│  Condition: (i, 0, 0)  i=1..L                       │
│  Visual:     (L+1+f, h, w)                         │
│                    ↓                                  │
│  ┌──────────────────────────────────────────┐       │
│  │     Stacked Transformer Blocks           │       │
│  │  ┌────────────────────────────────────┐  │       │
│  │  │ Attention Branch                   │  │       │
│  │  │  • QK-Norm (per-head RMSNorm)      │  │       │
│  │  │  • Multi-Modal 3D RoPE             │  │       │
│  │  │  • Single-stream self-attention    │  │       │
│  │  └────────────────────────────────────┘  │       │
│  │  ┌────────────────────────────────────┐  │       │
│  │  │ Sparse MoE Branch                  │  │       │
│  │  │  • Ns shared experts (always-on)    │  │       │
│  │  │  • Nr routed experts (top-Kr)       │  │       │
│  │  │  • Sigmoid router + online bias     │  │       │
│  │  │  • SwiGLU MLP per expert           │  │       │
│  │  └────────────────────────────────────┘  │       │
│  │  AdaLN-Single modulation                 │       │
│  └──────────────────────────────────────────┘       │
│                    ↓                                  │
│  Velocity Prediction → Denoising Loop                │
├─────────────────────────────────────────────────────┤
│  Cascaded Refiner (480p → 1080p)                    │
│  Base generates → Downsample+Blur → UpSample        │
│  → VAE Encode → Noisy LR condition → Rectified Flow │
└─────────────────────────────────────────────────────┘
核心公式
1. 统一输入公式 (Unified Input Formulation)
每个训练样本表示为单个 token 序列,包含视觉潜在 patch 和条件 token。图像目标被表示为特殊单帧(T = 1)的视频生成情况。
2. 多模态 3D RoPE
给定 L 个条件 token 和 F × H × W 视觉潜在网格:
- 条件 token 使用时间坐标
(i, 0, 0),其中i = 1, ..., L - 视觉 patch token 使用
(L + 1 + f, h, w) - Query 和 Key head 维度在时间、垂直、水平轴上分割,独立应用旋转频率
3. AdaLN-Single 调制
在 transformer 栈之前计算共享的时间步调制一次。每个 block 添加层特定的可训练调制表到共享信号。
4. 稀疏 MoE 架构
在每个 transformer block 中,保留单流 FFN 残差分支结构,仅将其密集前馈计算替换为 token 选择的稀疏 MoE 层:
m(\mathbf{u}_t) = \sum_{i=1}^{N_s} E_i^{(s)}(\mathbf{u}_t) + \sum_{j \in \mathcal{R}_b(\mathbf{u}_t)} g_{t,j} E_j^{(r)}(\mathbf{u}_t) \tag{1}
其中 是选定的路由专家集合, 和第 个共享专家函数, 是第 个路由专家函数。每个专家实现为 SwiGLU MLP。 为共享专家数, 为总路由专家数。
5. Sigmoid 路由器与在线偏差校正
token 的路由亲和力:
\alpha_{t,j} = \text{Sigmoid}(\mathbf{u}_t^\top \mathbf{r}_j) \tag{2}
其中 是 token 和路由专家 之间的路由器亲和力, 是第 个路由专家的可学习路由器嵌入。采用 DeepSeek 风格的组限制路由策略:将 路由专家分为 组。添加在线校正偏置后 ,选择 top- 组,每组得分为其 top-2 偏置校正亲和力得分之和。
最终门控值:
g'_{t,j} = \begin{cases} \alpha_{t,j}, & \text{if } \tilde{\alpha}_{t,j} \in \text{TopK}_{K_r}(\{\tilde{\alpha}_{t,k} \mid k \in \mathcal{G}_b(\mathbf{u}_t)\}) \\ 0, & \text{otherwise} \end{cases} \tag{3}
g_{t,j} = \gamma \frac{g'_{t,j}}{\sum_{k=1}^{N_r} g'_{t,k}} \tag{4}
其中 是路由缩放因子。
在线偏差更新:
b_j \leftarrow b_j - \eta \cdot \text{sign}(n_j - \bar{n}) \tag{5}
均值中心化处理:
b_j \leftarrow b_j - \frac{1}{N_r}\sum_{k=1}^{N_r} b_k \tag{6}
6. 序列级辅助损失
序列级平衡损失鼓励每个打包视频序列内的平衡专家使用:
\mathcal{L}_{\mathrm{seq}} = \frac{1}{S} \sum_{s=1}^{S} \sum_{j=1}^{N_r} f_j^{(s)} P_j^{(s)} \tag{7}
平均归一化路由概率:
P_j^{(s)} = \frac{1}{T_s} \sum_{t=1}^{T_s} p_{t,j}, \quad p_{t,j} = \frac{\alpha_{t,j}}{\sum_{k=1}^{N_r} \alpha_{t,k}} \tag{8}
归一化分配频率:
f_j^{(s)} = \frac{N_r}{K_r T_s} c_j^{(s)}, \quad c_j^{(s)} = \sum_{t=1}^{T_s} \mathbf{1}[\alpha_{t,j} \in \text{TopK}_{K_r}(\{\alpha_{t,k} \mid 1 \leq k \leq N_r\})] \tag{9}
总训练目标:
\mathcal{L}_{\mathrm{aux}} = \lambda_{\mathrm{aux}} \mathcal{L}_{\mathrm{seq}}, \quad \mathcal{L} = \mathcal{L}_{\mathrm{diff}} + \mathcal{L}_{\mathrm{aux}} \tag{10, 11}
7. 精炼器 Flow Matching
精炼器从退化条件 向干净目标潜在 学习条件 rectified flow:
\mathbf{x}_t = \left(1 - \frac{t}{\tau}\right) \mathbf{x}_0 + \frac{t}{\tau} \mathbf{x}_\tau, \quad v_{\mathrm{ref}}^\star = \frac{\mathbf{x}_\tau - \mathbf{x}_0}{\tau} \tag{12}
8. 系数保持采样 (CPS)
速度预测 给出干净和噪声估计:
\hat{\mathbf{x}}_0 = \mathbf{x}_{t_i} - t_i \hat{v}_\theta, \quad \hat{\epsilon} = \mathbf{x}_{t_i} + (1 - t_i) \hat{v}_\theta \tag{13}
CPS 转换到 :
\mathbf{x}_{t_{i+1}} = \mu_\theta + s_i \epsilon, \quad \mu_\theta = (1 - t_{i+1}) \hat{\mathbf{x}}_0 + \sqrt{t_{i+1}^2 - s_i^2} \hat{\epsilon} \tag{14}
其中 是新的高斯噪声, 是注入噪声尺度, 控制探索强度(实验中 )。
时间步平衡梯度重加权:
\kappa_k = 2 s_k \left|\frac{\partial \mu_\theta}{\partial \hat{v}_\theta}\right|, \quad \frac{\partial \mu_\theta}{\partial \hat{v}_\theta} = (1 - t_k)t_{k+1} \cos\left(\frac{\eta \pi}{2}\right) - t_k(1 - t_{k+1}) \tag{15}
\lambda_k = \frac{\kappa_k^{-1}}{\frac{1}{N} \sum_{j=0}^{N-1} \kappa_j^{-1}} \tag{16}
9. 多维奖励优势归一化与 GRPO 损失
\hat{A}^{(i)} = \sum_r w_r \frac{R_r(\mathbf{x}_0^{(i)}, c) - \mu_r}{\sigma_r + \delta} \tag{17}
\mathcal{L}_{\mathrm{GRPO}}(\theta) = -\mathbb{E}\left[\lambda_k \hat{A}^{(i)} \log \pi_\theta(\mathbf{x}_{t_{k+1}}^{(i)} \mid \mathbf{x}_{t_k}^{(i)})\right] \tag{18}
10. 负感知真实视频微调 (DiffusionNFT)
偏好对构造:
\mathbf{x}_t^w = (1 - t)\mathbf{x}_0^w + t\varepsilon, \quad \mathbf{x}_t^l = (1 - t)\mathbf{x}_0^l + t\varepsilon \tag{19}
隐式正/负策略:
\hat{v}_{\mathrm{pos}} = \beta \hat{v}_\theta + (1 - \beta) \hat{v}_{\mathrm{old}}, \quad \hat{v}_{\mathrm{neg}} = (1 + \beta) \hat{v}_{\mathrm{old}} - \beta \hat{v}_\theta \tag{20}
\mathcal{L}_{\mathrm{NFT}}(r) = r\|\hat{v}_{\mathrm{pos}} - v\|^2 + (1 - r)\|\hat{v}_{\mathrm{neg}} - v\|^2 \tag{21}
\mathcal{L}_{\mathrm{chosen}} = \|\hat{v}_{\mathrm{pos}}^w - v^w\|^2, \quad \mathcal{L}_{\mathrm{reject}} = r\|\hat{v}_{\mathrm{pos}}^l - v^l\|^2 + (1 - r)\|\hat{v}_{\mathrm{neg}}^l - v^l\|^2 \tag{22}
\mathcal{L}_{\mathrm{KL}} = \frac{1}{2}(\|\hat{v}_\theta^w - \hat{v}_{\mathrm{ref}}^w\|^2 + \|\hat{v}_\theta^l - \hat{v}_{\mathrm{ref}}^l\|^2) \tag{23}
\mathcal{L}_{\mathrm{RealNFT}} = \mathcal{L}_{\mathrm{chosen}} + \mathcal{L}_{\mathrm{reject}} + \lambda_{\mathrm{KL}} \mathcal{L}_{\mathrm{KL}} \tag{24}
11. DMD2 蒸馏
\nabla_\theta \mathcal{L}_{\mathrm{DMD}} = \mathbb{E}_{z,t,\epsilon}\left[-w_t(s_{\mathrm{real}}(x_t, t, c) - s_{\mathrm{fake}}(x_t, t, c)) \frac{\partial G_\theta(z,c)}{\partial \theta}\right] \tag{25}
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Single-Stream DiT | 统一视觉和条件 token 的单流 transformer | 共享 transformer blocks |
| Sparse MoE Layer | 共享专家 + 路由专家,SwiGLU MLP | MoE 13B-A1.4B-E128 (默认) |
| Sigmoid Router | DeepSeekMoE 风格,组限制路由 | top-Kr=8, Nr=128 |
| Online Bias Correction | 无辅助损失的负载均衡 | sign-based 更新 |
| Sequence-wise Aux Loss | 序列级专家平衡损失 | λ_aux 权重 |
| AdaLN-Single | 共享时间步调制 + 层特定表 | zero-initialized |
| Multi-Modal 3D RoPE | 非重叠时间坐标 | 条件 (i,0,0), 视觉 (L+1+f,h,w) |
| QK-Norm | per-head RMSNorm 稳定注意力 | 扩散/视觉 DiT 标准 |
| Wan2.1-VAE | 视觉潜在压缩 | 高压缩比 |
| Qwen3-VL-4B | 多模态条件提取 | 条件编码 |
| Cascaded Refiner | 480p → 1080p 级联精炼 | 条件 rectified flow |
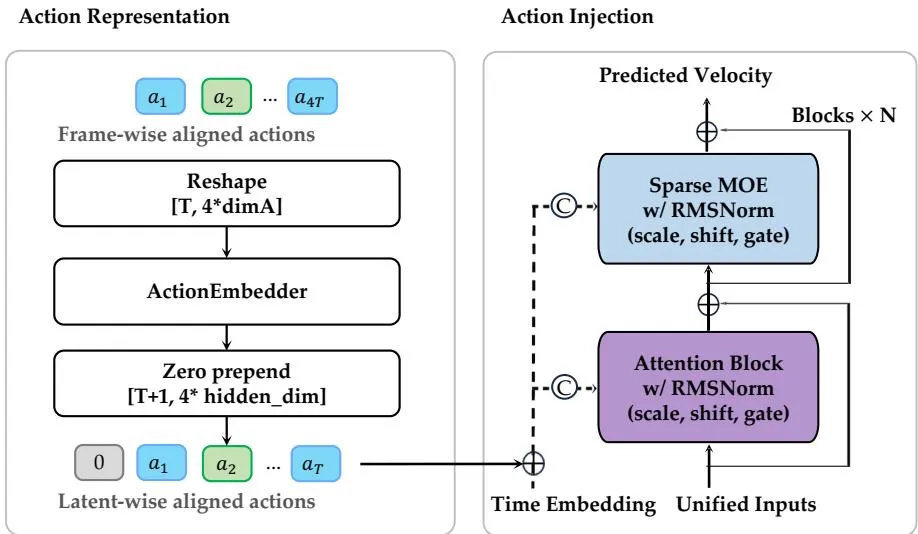
| ActionEmbedder | A2V 动作编码 | 零初始化最后一层 |
训练流程
五阶段渐进式预训练课程:
| 阶段 | 内容 | 分辨率 | 任务 |
|---|---|---|---|
| Stage 1 | 纯图像先验获取 | 192p | T2V (T=1),建立文本-视觉语义对齐 |
| Stage 2 | 引入视频 + 源扩展 | 192p | T2V,注入 >70,000 小时具身数据 |
| Stage 3 | 更高分辨率重新过滤 | 480p | T2V + TI2V 联合 |
| Stage 4 | 加权分布均衡 | 480p | T2V + TI2V,alias table 采样 |
| Stage 5 | 高质量精炼子集 | 1080p | 条件精炼轨迹 |
后训练阶段:
- GRPO 强化学习:6 维奖励模型(视觉质量、文本-视频对齐、动态程度、运动连贯性、人体运动一致性、物理合理性)
- 负感知真实视频微调:DiffusionNFT 框架,真实视频作为正样本,生成视频作为负样本
- Action-to-Video (A2V):8k 步,batch size=64,LR=1e-5,GR-1 数据集
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 稀疏 MoE 视频预训练 | 首次从零开始扩展 MoE 视频扩散模型,容量-计算解耦 | Fig. 3-7: E=128 最优,MoE 13B-A1.4B 显著优于 Dense 1.3B |
| Sigmoid Router + 在线偏差校正 | 无辅助损失的负载均衡,避免梯度冲突 | Eq. 2-6: sign-based bias update + mean centering |
| 序列级辅助损失 | 针对视频生成长序列的逐序列平衡,而非批次级 | Eq. 7-11: 防止隐藏单个视频的路由不平衡 |
| 细粒度专家分割 | 128 experts, top-8 routing vs 64 experts, top-4 | Fig. 4: 组合空间 vs ,性能差距显著 |
| 数据画像引擎 | 五维结构化标注(结构、语义、运动、相机、质量) | Fig. 9: VLM + 专用评分模型联合标注 |
| 世界知识拓扑图 | 50K 叶概念 + 1K 中间类别 + 25 顶层组 | Fig. 10: 分布感知采样 + 训练反馈闭环 |
| 密集结构化描述 | 四类型 caption(图像、视频、VLA、第一人称) | 时间戳动作、相机标签、世界知识 |
| 六维奖励系统 | 超越美学,纳入物理合理性 | 文本-视频对齐用 VQA,动态程度用 VLM,物理合理性用框架证据 |
| CPS + 单步探索 GRPO | 精确信用分配,避免 SDE 转换伪影 | Eq. 13-18: 仅一个去噪步骤随机 |
| 负感知真实视频微调 | DiffusionNFT 前向过程优化,避免 reward hacking | Eq. 19-24: 真实视频作为 chosen,生成视频作为 rejected |
| A2V 世界模型适配 | 动作条件未来视觉 rollout | Fig. 14: ActionEmbedder + 残差注入 |
| 级联精炼器 | 480p base → 1080p refiner,条件 rectified flow | Fig. 8: 合成退化 + 上采样 |
五、基础设施
异构数据管道与 Token 预算打包
- Token 预算打包:按目标 token 预算构建 mini-batch,而非固定样本数
- 一维 packed batch:,统一处理图像、视频、不同条件模态
- Smart-fill sampler:动态搜索 rank-local 候选池填充剩余 token 预算
四维并行训练
| 并行维度 | 说明 |
|---|---|
| DP (Data Parallelism) | 主要吞吐量扩展维度 |
| FSDP (Fully Sharded DP) | 参数量子化 |
| SP (Sequence Parallelism) | 长序列上下文分区 |
| EP (Expert Parallelism) | MoE token 路由 |
六、实验结果
内部基准评估
通用质量维度:运动质量、文本遵循、视觉一致性、美学质量
具身领域维度:人机交互、物理模拟、机器人、第一人称视角、导航
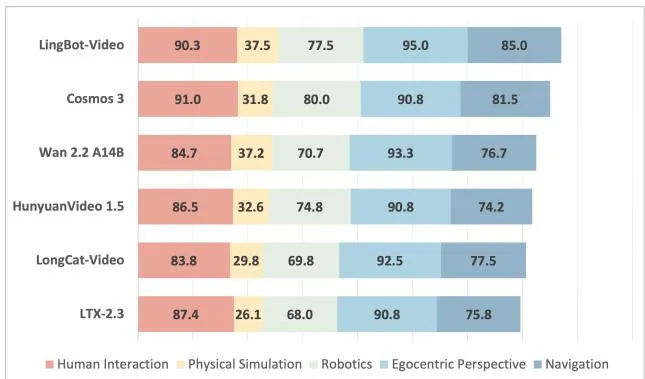
LingBot-Video 在 TI2V 任务上取得开源模型最佳性能,在通用质量和具身领域得分均排名第一。T2V 任务中具身领域得分同样领先。
RBench 评估
| Model | Type | Avg. | Manip. | Spatial | Multi-entity | Long-hor. | Reasoning | Single arm | Dual arm | Quadruped | Humanoid |
|---|---|---|---|---|---|---|---|---|---|---|---|
| LingBot-Video | open-source | 0.620 | 0.578 | 0.643 | 0.444 | 0.634 | 0.505 | 0.636 | 0.639 | 0.758 | 0.689 |
| Cosmos3 Super | open-source | 0.581 | 0.487 | 0.642 | 0.444 | 0.591 | 0.395 | 0.615 | 0.623 | 0.739 | 0.691 |
| Wan 2.6 | closed-source | 0.607 | 0.546 | 0.656 | 0.479 | 0.514 | 0.531 | 0.666 | 0.681 | 0.723 | 0.667 |
| Seedance 1.5 pro | closed-source | 0.584 | 0.577 | 0.495 | 0.484 | 0.570 | 0.470 | 0.648 | 0.641 | 0.680 | 0.692 |
| Veo 3 | closed-source | 0.563 | 0.521 | 0.508 | 0.430 | 0.530 | 0.504 | 0.634 | 0.610 | 0.689 | 0.637 |
| Wan 2.2 A14B | open-source | 0.507 | 0.381 | 0.454 | 0.373 | 0.501 | 0.330 | 0.608 | 0.582 | 0.690 | 0.648 |
| HunyuanVideo 1.5 | open-source | 0.460 | 0.442 | 0.316 | 0.312 | 0.438 | 0.364 | 0.513 | 0.526 | 0.634 | 0.595 |
| LongCat-Video | open-source | 0.437 | 0.372 | 0.310 | 0.220 | 0.384 | 0.186 | 0.586 | 0.576 | 0.681 | 0.621 |
LingBot-Video 在 RBench 上以 0.620 平均分领先所有开源模型,在操作、空间关系、长视域规划、单臂/双臂、四足等具身任务上全面领先。
Physics-IQ Verified 评估
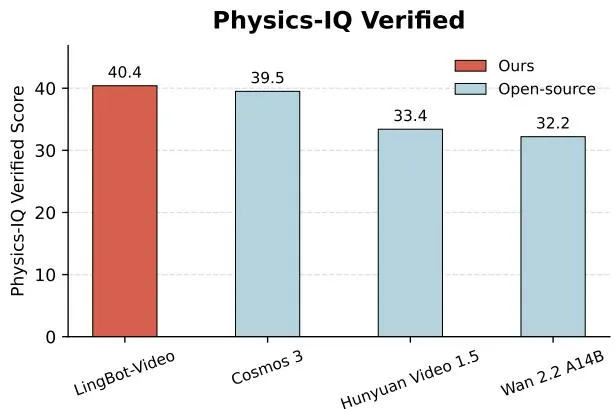
LingBot-Video 在 Physics-IQ Verified I2V 上得分为 40.4,在开源模型中排名第一,略高于 Cosmos 3 (39.5)。相较于 HunyuanVideo 1.5 (33.4) 和 Wan 2.2 A14B (32.2) 优势明显。
扩展实验
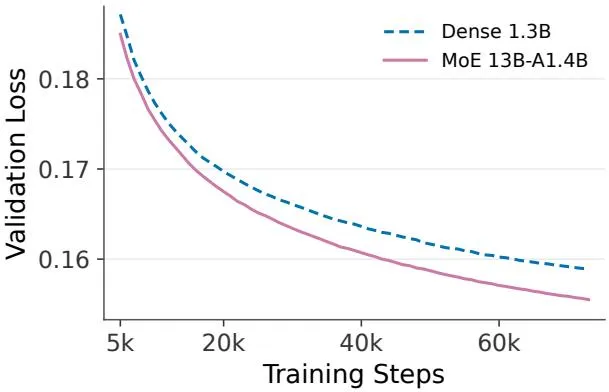
- 容量-计算解耦:Fig. 5 显示 MoE 13B-A1.4B 在相同活跃计算预算下显著优于 Dense 1.3B
- 跨计算优势:Fig. 6a 显示 MoE 30B-A3B 接近 Dense 14B 性能
- 可扩展至 120B:Fig. 6b 显示 MoE 13B→30B→60B→120B 呈现可预测的 scaling trajectory
推理效率
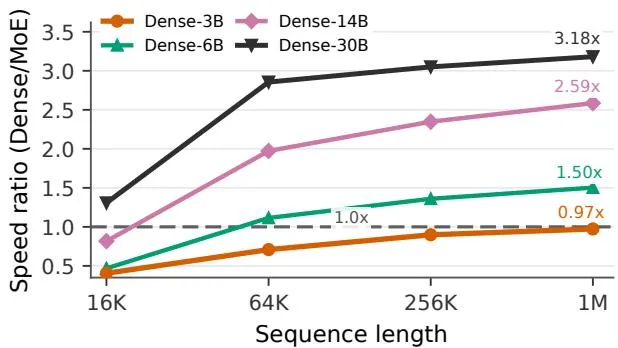
在 1M token 序列长度下:
- vs Dense 3B: 0.97×(近持平,路由开销小)
- vs Dense 6B: 1.50×
- vs Dense 14B: 2.59×
- vs Dense 30B: 3.18×
用户研究 (GSB)
T2V: LingBot-Video 在 Wan 2.2 5B、LongCat-Video、Wan 2.2 A14B、LTX-2.3 上 Good rate 超过 Bad rate;与 HunyuanVideo 1.5 和 Cosmos 3 竞争接近。
TI2V: LingBot-Video 在所有开源基线上 Good rate 超过 Bad rate,与 Cosmos 3、LTX-2.3 有明显优势。
后训练定性改进
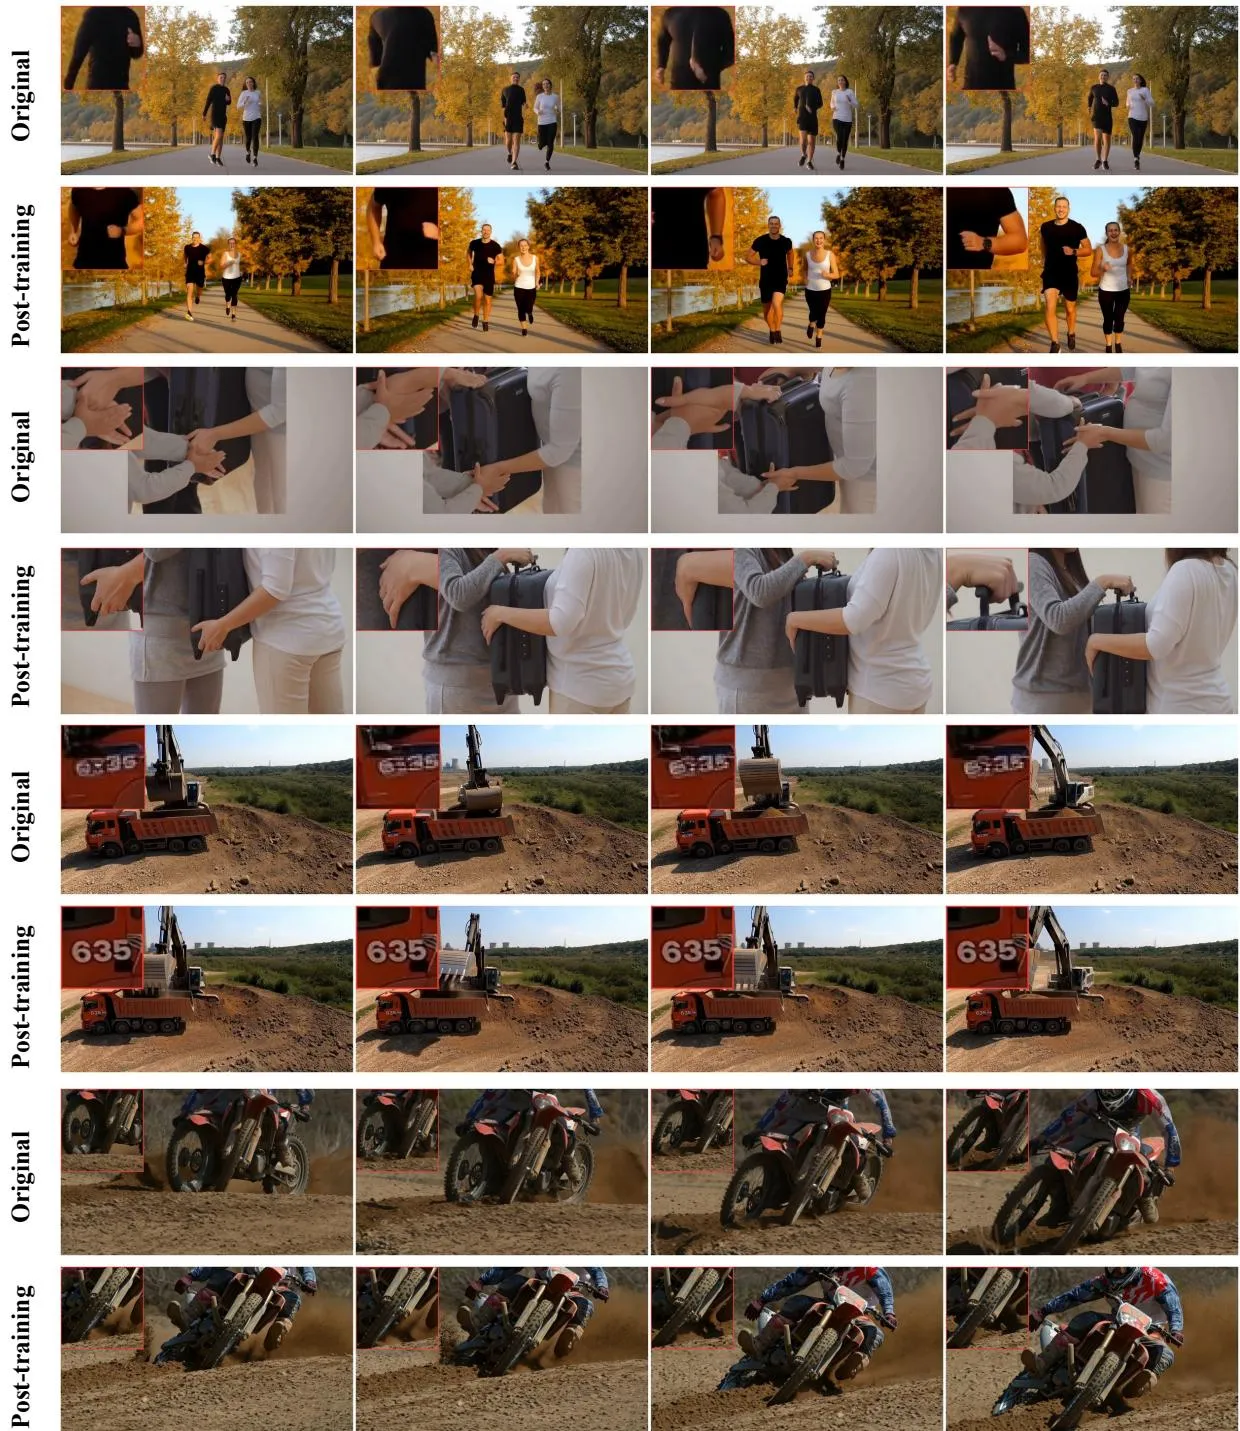
后训练有效解决关键伪影:不一致的手部和肢体合成、模糊或不正确的文本渲染、结构物体变形。
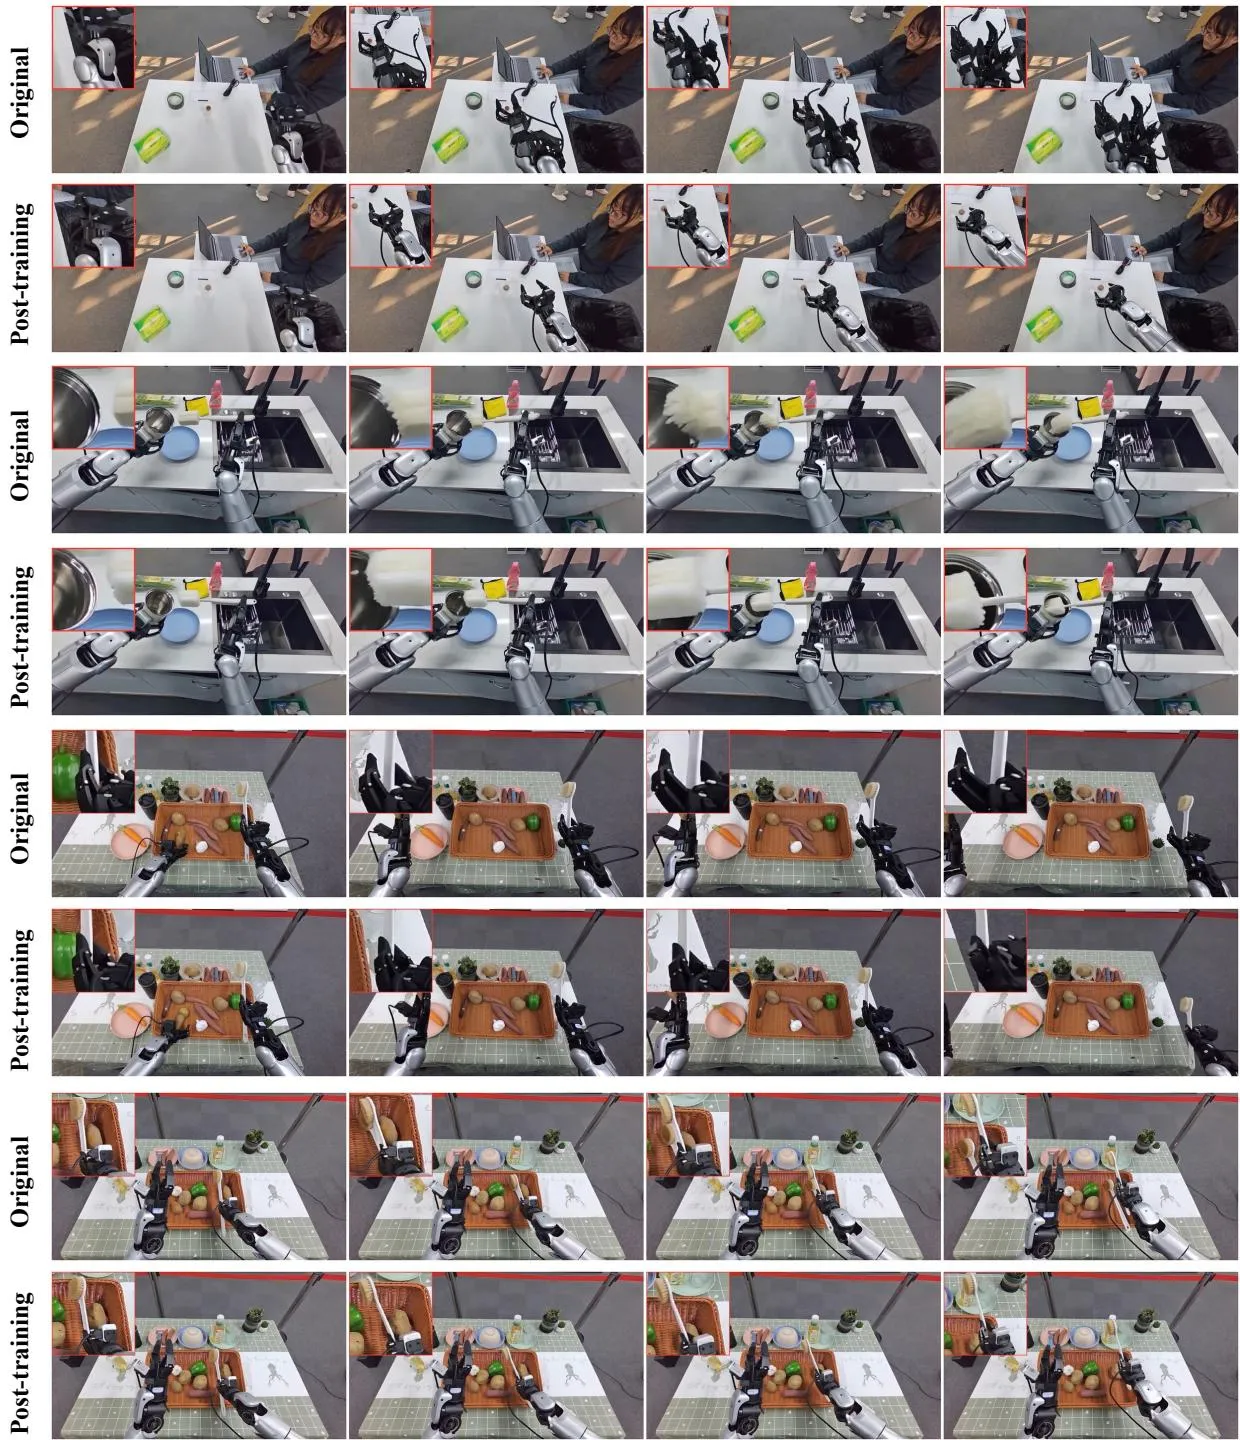
具身场景中显著提升物理合理性:解决机械臂和抓取物体的结构失真、非物理穿透、物体提前释放和物体重复。
与 DreamDojo 对比
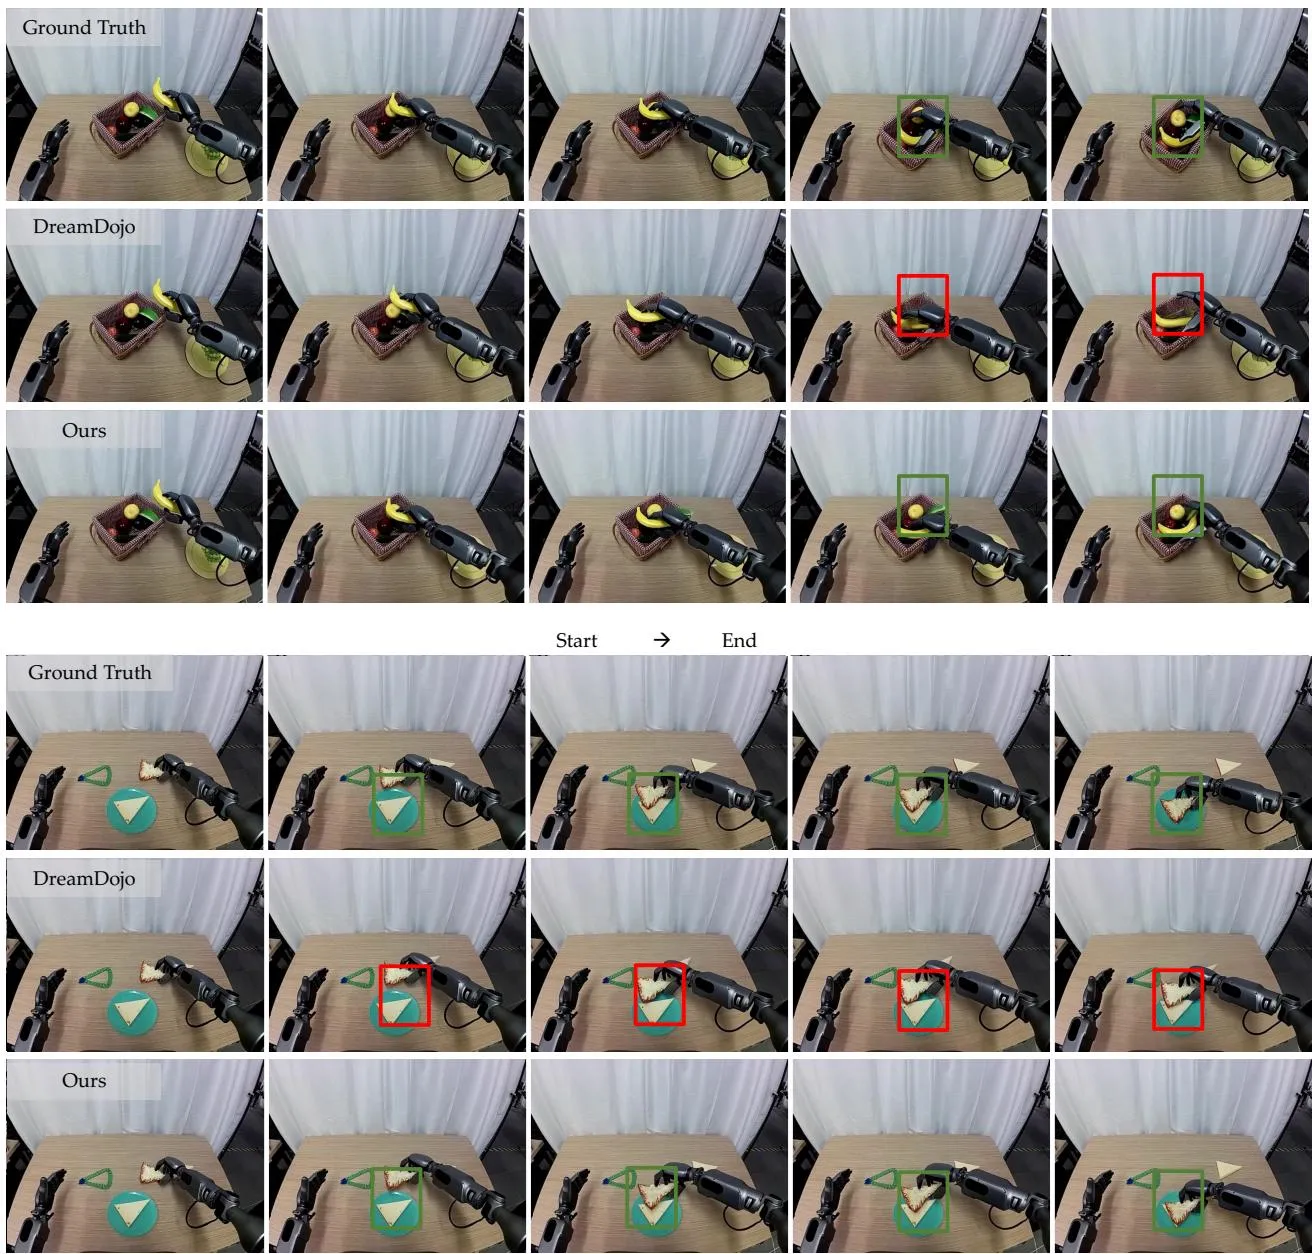
在 EgoDex Eval 和 DreamDojo-HV Eval 上,LingBot-Video-A2V 展现出更好的物理定律遵循和动作跟随能力。
七、相关工作
- Cosmos 3 (NVIDIA): 多模态世界模型,LingBot-Video 在 RBench 具身任务上全面领先
- LongCat-Video (美团): 13.6B 视频生成,LingBot-Video 在具身领域得分显著超越
- HunyuanVideo 1.5 (腾讯): 8.3B 轻量级模型,RBench 得分 0.460 vs LingBot-Video 0.620
- DreamDojo (ETH Zürich): 通用机器人世界模型,LingBot-Video-A2V 在物理遵循上更优
- V-JEPA 2 / 2.1 (Meta): 自监督视频模型,LingBot-Video 是生成式而非预测式世界模型
- LingBot-World (2601.20540): RobbyAnt 前身世界模型,LingBot-Video 是其视频生成方向的扩展
八、总结
核心贡献
- 首个开源大规模 MoE 视频基础模型:从零扩展 MoE 视频扩散框架,实现容量-计算解耦
- 机器人增强预训练语料库:数据画像引擎 + 世界知识拓扑图 + 密集结构化描述,注入 >70,000 小时具身数据
- 多维奖励 RL 后训练:6 维奖励模型 + CPS + 单步探索 GRPO + 负感知真实视频微调 (DiffusionNFT)
- A2V 世界模型适配:动作条件未来视觉 rollout,支持机器人策略评估和规划
技术影响
LingBot-Video 定位为具身 AI 的三个关键角色:
- 数据引擎:大规模合成高保真低成本训练数据
- 策略评估器:安全地评估机器人策略的视觉模拟器
- 动作规划器:预测”下一步会发生什么”以辅助实时决策
局限性
- 当前聚焦于视频生成,未涵盖多模态交互(如语音、触觉)
- RBench 在闭源模型 Wan 2.6 上仍有差距 (0.607 vs 0.620 open-source 最佳)
- 扩展至 120B 参数仅为早期训练轨迹验证,未达完全收敛
九、参考资源
- 论文: https://arxiv.org/abs/2607.07675
- 代码: https://github.com/robbyant/lingbot-video
- 网站: https://technology.robbyant.com/lingbot-video
- Checkpoints: https://huggingface.co/robbyant/lingbot-video
- RBench: https://github.com/DiveDeepIntoBR/DiveDeepIntoBR.github.io
- Physics-IQ Verified: https://arxiv.org/abs/2606.18943