LingBot-World-Infinity: Infinite Worlds with Versatile Interactions
一个因果视频生成世界模型,实现无限长、实时响应的交互式世界模拟,支持多种角色动作和环境事件,并引入Pilot-Director双智能体协作框架
LingBot-World-Infinity: Infinite Worlds with Versatile Interactions
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LingBot-World-Infinity: Infinite Worlds with Versatile Interactions |
| 作者 | Zelin Gao, Qiuyu Wang, Jiapeng Zhu, Jingye Chen, Zichen Liu, Qingyan Bai, Jiahao Wang, Yufeng Yuan, Hanlin Wang, Yichong Lu, Ka Leong Cheng, Haojie Zhang, Jian Gao, Tianrui Feng, Yuzheng Liu, Yao Yao, Yinghao Xu, Xing Zhu, Yujun Shen, Hao Ouyang |
| 机构 | Robbyant(阿里通义) |
| 论文 | arXiv:2607.07534 |
| 代码 | github.com/robbyant/lingbot-world-v2 |
| 模型 | huggingface.co/robbyant/lingbot-world-v2 |
| 网站 | technology.robbyant.com/lingbot-world-v2 |
| 发布 | 2026-07-08 |
二、核心思想
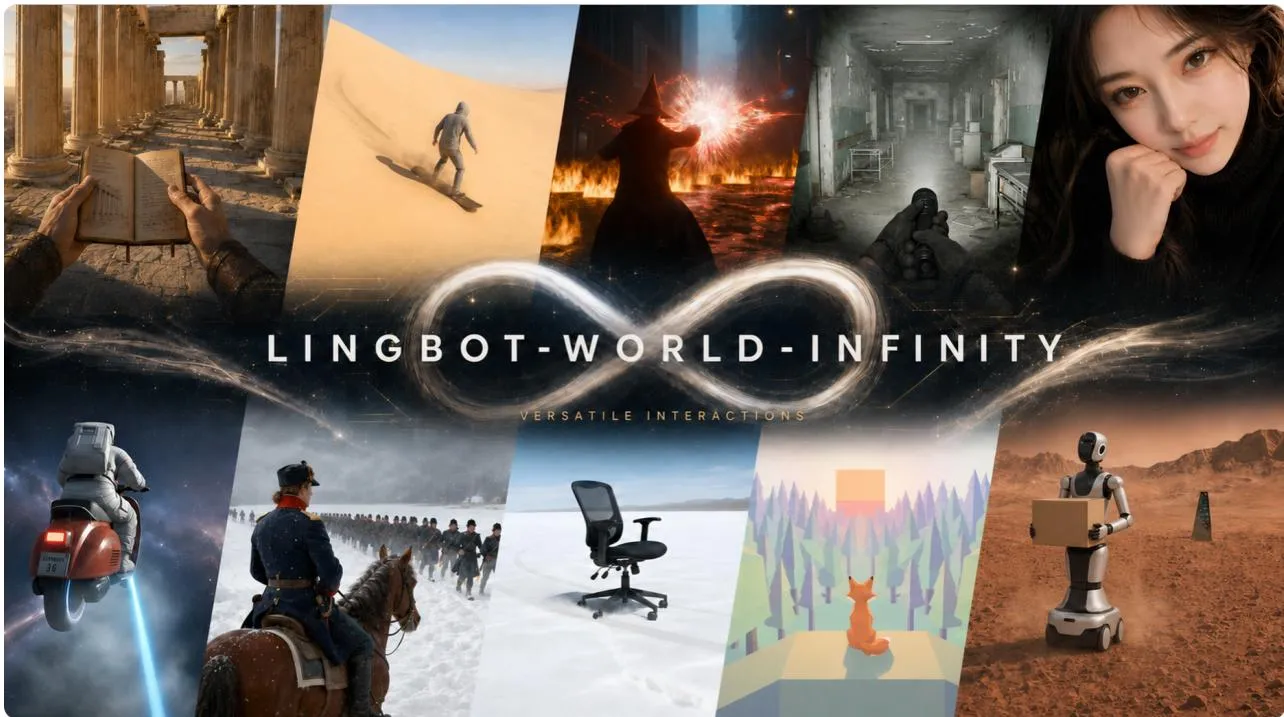
LingBot-World-Infinity(又称 LingBot-World 2.0)是一个先进的交互式世界模型,在 LingBot-World 基础上进行了四项关键升级:(1) 通过精心设计的因果预训练范式实现无界交互视界,同时保持稳定的输出质量;(2) 从基座模型蒸馏出实时变体,支持 720p @ 60fps 视频流响应;(3) 引入更丰富的交互元素——包括攻击、射箭、施法、射击等新动作类型以及更丰富的文本驱动事件;(4) 首创将智能体框架(agentic harness)应用于世界建模领域,其中 pilot 智能体负责规划和执行角色行为,director 智能体负责在场景推进中合成新的环境元素。
问题定义
现有交互式世界模型面临两个根本性限制:(a) 长视界稳定性不足——由于每一帧都基于之前生成的帧进行条件生成,误差会反馈累积,导致纹理模糊、几何扭曲、场景漂移,大多数系统仅能稳定数秒到数分钟;(b) 高保真交互计算成本高昂——渲染详细视频同时响应实时输入对算力预算压力巨大,先前的工作通常以牺牲分辨率、流畅度或控制力为代价换取交互能力。
解决方案概述
该工作的核心思路是:因果预训练 + 一致性蒸馏 + 分布匹配蒸馏 + Pilot-Director 双智能体框架。首先训练一个具有强抗漂移能力的因果视频生成模型作为 teacher backbone,然后通过一致性蒸馏(Consistency Distillation)和分布匹配蒸馏(DMD)将其压缩为 few-step student 模型以实现实时推理,最后围绕生成核心构建 pilot(执行层)与 director(语义规划层)协同的智能体框架,将帧预测器转变为自我维持、目标导向的开放世界。
三、技术架构
整体框架图
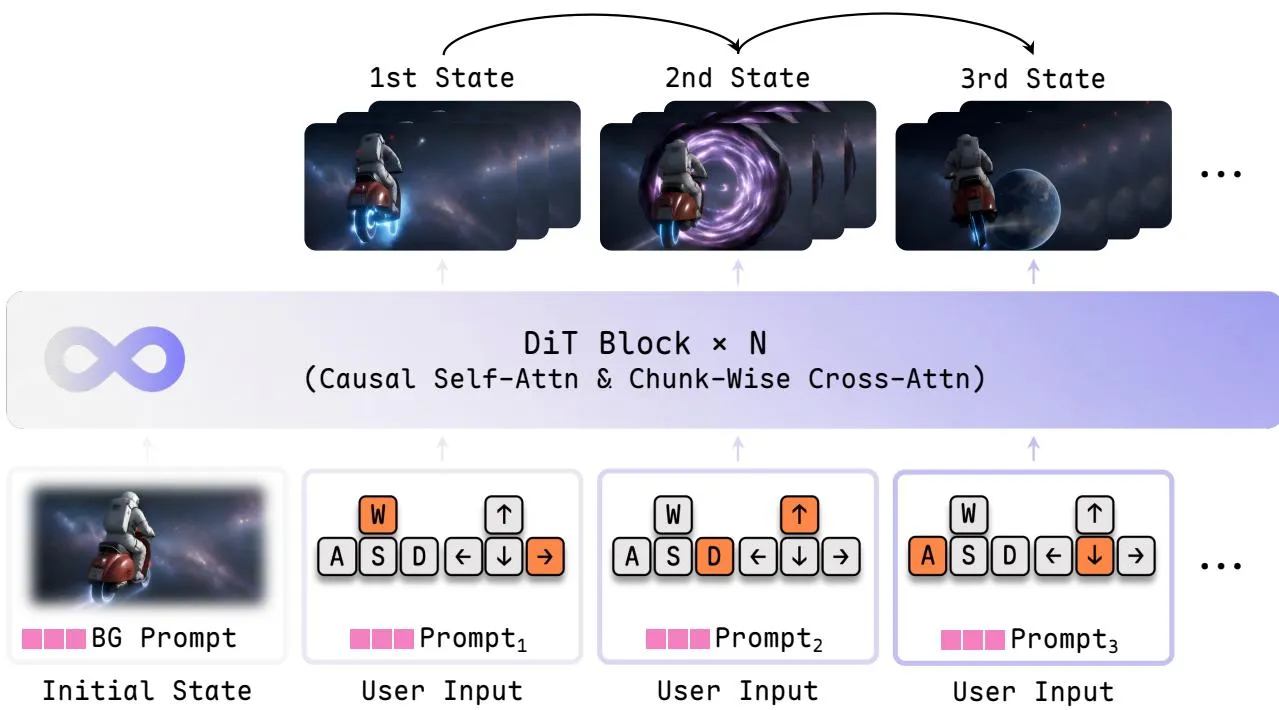
LingBot-World-Infinity 采用两阶段训练策略:(1) 预训练阶段学习因果、动作条件的世界模型;(2) 后训练阶段将模型蒸馏为实时生成器并抑制长视界漂移。
核心公式
1. 因果世界生成过程(Causal Generative Process)
其中 表示时刻 的视觉状态, 表示截至当前时刻的用户输入序列(包括控制信号和行动提示)。
2. 条件 Flow-Matching 训练目标
其中 为 noisy latent, 为相机位姿, 为 prompt。
3. 一致性蒸馏损失(Consistency Distillation)
其中 为因果条件变量, 为学生参数 的指数移动平均(EMA), 是通过沿教师 PF-ODE 轨迹积分得到的 latent。
4. 分布匹配蒸馏损失(Distribution Matching Distillation, DMD)
其中 和 分别近似 noised data distribution 和 noised student distribution 的 score 函数。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Causal DiT Backbone | 因果扩散 Transformer 骨干,支持 camera pose 和 chunk-wise prompt 条件输入 | 14B 参数 |
| MoBA Attention Mask | Mixture of Bidirectional and Autoregressive 混合注意力掩码,在 teacher forcing mask 上附加双向组件 | 自注意力 + 交叉注意力双掩码 |
| Plücker Camera Embedding | 相机位姿编码,将每条视线的六维坐标通过 AdaLN 注入扩散过程 | 6D |
| Chunk-wise Prompts | 每个视频 chunk 分配独立 caption,实现时间局部化语义控制 | — |
| Consistency Model Student | 从 teacher 蒸馏的 few-step 学生模型,支持 720p@60fps 实时生成 | 1.3B 参数 |
| Spatio-Temporal Refiner | VAE 解码后附加的空间-时间细化模块,提升局部细节和帧率 | TensorRT 编译 |
| Dynamic KV Cache | 根据当前控制信号自适应调整缓存内容的动态调度机制 | — |
| Director Agent (VLM) | Vision-Language Model 作为”导演”,负责宏观语义规则和因果推理 | Qwen3.5 / Qwen3.6 |
| Pilot Agent (Video Gen) | Video Generator 作为”飞行员”,负责低层物理动态和高保真视觉过渡 | Distilled DiT |
训练流程
Stage 1: Pre-Training(因果世界模型预训练)
- 数据源:三类互补数据——自采集第一人称视频(真实世界交互)、游戏/UE 合成数据(精确场景几何和时间对齐交互信号)、大规模网络视频(开放域覆盖)
- 数据管线:(1) 数据获取与标准化;(2) TransNet V2 分段 + 技术指标过滤(美学评分、亮度范围、OCR 文本占比、运动统计)+ VLM 语义分析;(3) 多维度标注——全局 caption + 多 track 事件级标注 + chunk-wise 优化 caption
- 训练目标:条件 flow-matching objective (Eq. 2),使用 MoBA 混合注意力掩码
Stage 2: Post-Training(Few-Step 蒸馏)
- 一致性蒸馏(CD):将 teacher 的多步去噪轨迹蒸馏为 few-step student(Eq. 3)
- 分布匹配蒸馏(DMD):在长 self-rollout 轨迹上优化 student,减少累积漂移(Eq. 4)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| MoBA 混合注意力掩码 | 在 teacher forcing mask 上附加双向全注意力块,缓解纯 teacher forcing 的过拟合问题,同时促进从双向到自回归的平滑过渡 | 作为正则化项维持视觉保真度,配合对应的 cross-attention mask(teacher forcing 部分用 lower-triangular pattern 防止未来信息泄漏,双向部分用 global prompt) |
| 因果预训练的抗漂移特性 | 在预训练阶段即强制因果性,而非后处理修复,使模型具有结构性抗漂移能力 | 与 prior causal models 对比(Fig. 12),在长时间生成中保持纹理清晰和几何稳定 |
| CD + DMD 联合蒸馏 | 一致性蒸馏减少采样步数,DMD 提升保真度并抑制 self-rollout 漂移,两者互补 | 最终实现 720p@60fps 实时生成,60 分钟不间断生成无可见质量衰减(Fig. 10) |
| Pilot-Director 双智能体框架 | VLM 作为 Director 做因果推理和事件提案,Video Generator 作为 Pilot 将语义指令落地为物理一致的时空 rollout | 支持两种交互模式(直接语义交互 + SAM 辅助物体交互)和两种干预方式(全局状态切换 + 局部实体注入) |
| 多维度视频标注管线 | 多 track 事件级标注(主体可见性、运动状态、交互状态、环境动态、静态场景)+ chunk-wise 优化,解决 train-inference 不匹配 | 使模型能够响应随时间变化的指令和控制信号(Fig. 2) |
五、代码实现分析
项目结构
lingbot-world-v2/
├── README.md                  # 项目说明、快速开始
├── website/                   # 项目网站 (technology.robbyant.com)
└── [模型权重]                  # HuggingFace checkpoints
关键实现细节
- 模型架构:基于 DiT(Diffusion Transformer)的因果视频生成模型,主干 14B 参数,蒸馏学生模型 1.3B 参数
- 并行推理:采用 hybrid parallel inference 策略跨多 GPU 分布式计算,使用 xdit 等推理引擎
- TensorRT 编译:Spatio-temporal refiner 和 VAE 解码均编译为 TensorRT 引擎,多 GPU 并行执行
- 异步流水线:Latent 生成与帧重建异步流水,VAE 解码在专用 worker 上并行,减少关键路径延迟
- 流式传输:解码结果增量流式传输,不等待整 chunk 完成,降低端到端交互延迟
六、实验结果
基准测试
Table 1: 与现有交互式世界模型对比
| 维度 | M-G 3.0 | D-W | LingBot-World | HappyOyster | Genie 3 | Ours |
|---|---|---|---|---|---|---|
| 生成时长 | Minutes | Minutes | Minutes | Minutes | Minutes | Hours (Infinite) |
| 语义交互 | None | None | None | Few | Few | Infinite |
| 领域 | Game | General | General | General | General | General |
| 动态程度 | Medium | Medium | High | Medium | Medium | High |
| 实时 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| 开源 | ✓ | ✓ | ✓ | ✗ | ✗ | ✓ |
- LingBot-World-Infinity 是唯一在通用领域实现小时级(无限)生成时长的模型
- 唯一同时具备扩展持续生成、高动态度、语义交互和实时性能的完全开源系统
长视界稳定性验证
- 60 分钟不间断生成(Fig. 10):覆盖 20 个不同场景,全程无可见质量衰减
- 定性对比(Fig. 11):在长视界生成中保持稳定的视觉和物理一致性
- 因果预训练对比(Fig. 12):相比 prior causal models,在长时间 rollout 中保持纹理清晰、几何稳定
交互能力
- 支持丰富动作空间:战斗、射箭、施法、射击等角色动作
- 支持动态环境变化:天气转换(雪/雨)、昼夜交替等
- 支持局部实体注入:召唤鸟群、特定生物等
七、相关工作
- Genie 3 (Google DeepMind): 闭源世界模型,分钟级生成,few 语义交互
- DreamX (Team2026): 通用交互式世界模型,分钟级生成
- Matrix-Game 3.0: 开源实时流式交互式世界模型,分钟级生成
- HappyOyster: 闭源实时世界模型,分钟级生成
- LingBot-World (v1): 前代版本,分钟级生成,本工作在其基础上升级为无限视界版本
- SkyReels-v2: 无限长度电影生成模型
- LongLive / LongLive2.0: 实时交互式长视频生成,NVFP4 并行基础设施
- Causalcine: 实时自回归多镜头视频叙事生成
八、总结
核心贡献
- 开源 SOTA 因果世界模型:关键突破在于耐久性(durability)——领先的视觉质量与强抗漂移能力结合,既提供可用的 backbone 也提供高质量的蒸馏 teacher
- 实时蒸馏模型:在 720p @ 60fps 下渲染无边界、无漂移的交互式世界,经超过 1 小时连续生成验证无质量损失
- 丰富的可控动作空间:超越导航,包含战斗、射箭、施法、射击等角色动作,以及即时的环境变化
- Pilot-Director 双智能体框架:将模型编排为自维持、目标导向、开放-ended 的交互式体验
局限性
- 长期记忆缺失:模型未真正”记住”已生成的世界——离开上下文窗口的区域被重新生成而非召回,世界在外观上持久但不在身份上持久
- 身份和风格一致性:超长 rollout 中特定角色外观可能微妙变化,整体艺术风格可能逐渐漂移
- 物理理解有限:模型仅从像素学习动力学,无显式的几何或碰撞概念,偶尔出现物理上不合理的人工产物(如物体相交)
- 计算资源需求大:虽然蒸馏模型实时运行,但仍需大量计算资源,在消费级硬件上实现实时高保真世界建模需要进一步效率提升
九、参考资源
- 项目网站: https://technology.robbyant.com/lingbot-world-v2
- GitHub: https://github.com/robbyant/lingbot-world-v2
- HuggingFace Checkpoints: https://huggingface.co/robbyant/lingbot-world-v2
- arXiv: https://arxiv.org/abs/2607.07534