W4A4 Quantization for Inference on Wan2.2-I2V-A14B
面向ICME 2026 W4A4量化挑战赛的Wan2.2-I2V-A14B视频扩散模型4bit权重/4bit激活推理方案。将LLM量化领域的SmoothQuant逐通道平滑与MixQ稀疏离群列拆分迁移到视频扩散FFN,并叠加块级HiF4权重打包与双分支GEMM。在VBench I2V上各项指标相对FP16降幅控制在2–3.5%,运动平滑度反而提升+0.4%,全面优于原生HiFloat4基线(后者跌约5%)。
W4A4 Quantization for Inference on Wan2.2-I2V-A14B (ICME 2026 Challenge)
一、论文概述
| 项目 | 内容 |
|---|---|
| arXiv ID | 2606.29337 |
| 标题 | W4A4 Quantization for Inference on Wan2.2-I2V-A14B |
| 作者 | Yidong Chen, Chengyu Shi, Jiahao Liu |
| 提交日期 | 2026-06-28 |
| 学科分类 | cs.CV, cs.DC |
| 比赛 | ICME 2026 Low-Bit-width Large-Model Quantization Challenge, Sub-Challenge 1 |
| 目标模型 | Wan-AI/Wan2.2-I2V-A14B(图生视频 diffusion transformer) |
| 数值格式 | HiFloat4 (HiF4) / MXFP4 |
| 代码 | https://github.com/shch-y/icme |
二、核心思想
问题定义:ICME 2026 挑战赛 Sub-Challenge 1 要求将 Wan2.2-I2V-A14B 的线性层同时量化到 4bit 权重和 4bit 激活(W4A4),配合 HiF4/MXFP4 数值格式,尽可能保留 OpenS2V-5M / VBench I2V 感知质量。允许保留的 FP16 Transformer block 数上限:MXFP4 ≤5、HiF4 ≤2。目标分辨率 720×1280×61 帧。
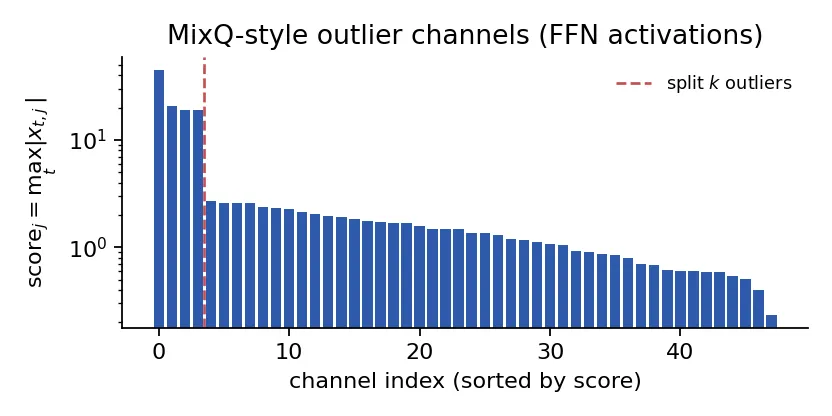
直接对 video diffusion transformer 做 W4A4 rounding 的痛点与 LLM 一致:FFN 激活重尾离群通道 —— 少数通道幅值远大于分布主体,膨胀 per-tensor scale 并把 4bit SNR 打崩。
解决方案:作者把 LLM 量化两条正交经验搬到 Wan2.2:
- SmoothQuant:以逐通道正因子 将激活离群幅度迁移到权重侧(数学等价的 fold),大幅收缩 activation range;
- MixQ:把少量重尾列拆到 FP16 高精度分支,其余走 W4A4 主路径;
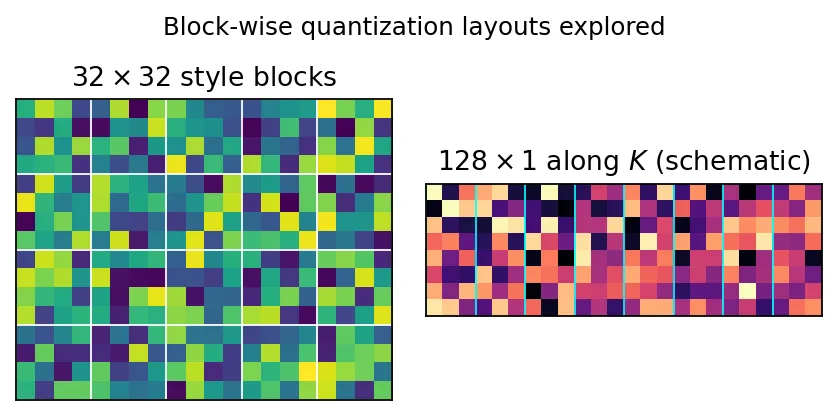
- 块级 HiF4 权重打包:32×32 tiles 或 128×1 K-major 条带,随 outlier 分布给权重分组做细粒度 scale。
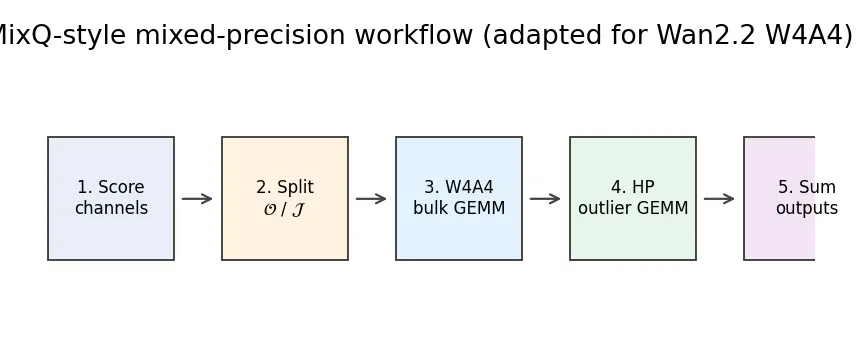
三者构成 offline calibration → SmoothQuant fold → MixQ 列拆 → block HiF4 打包 → dual-branch GEMM 的端到端 pipeline。
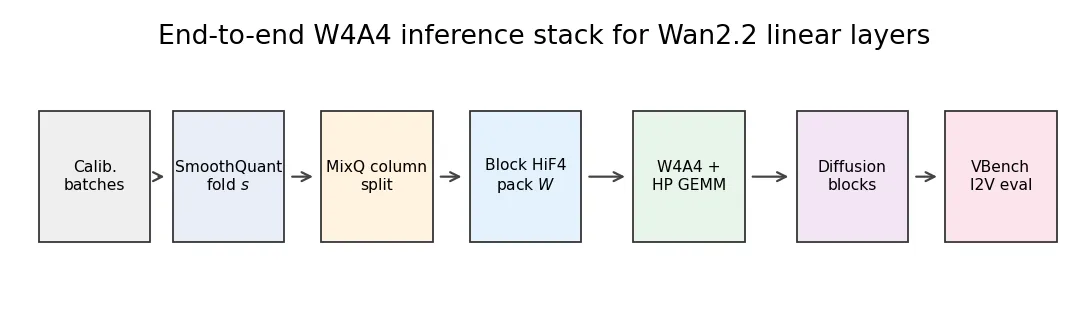
三、技术架构/方法
3.1 观察:Wan2.2 FFN 激活重尾
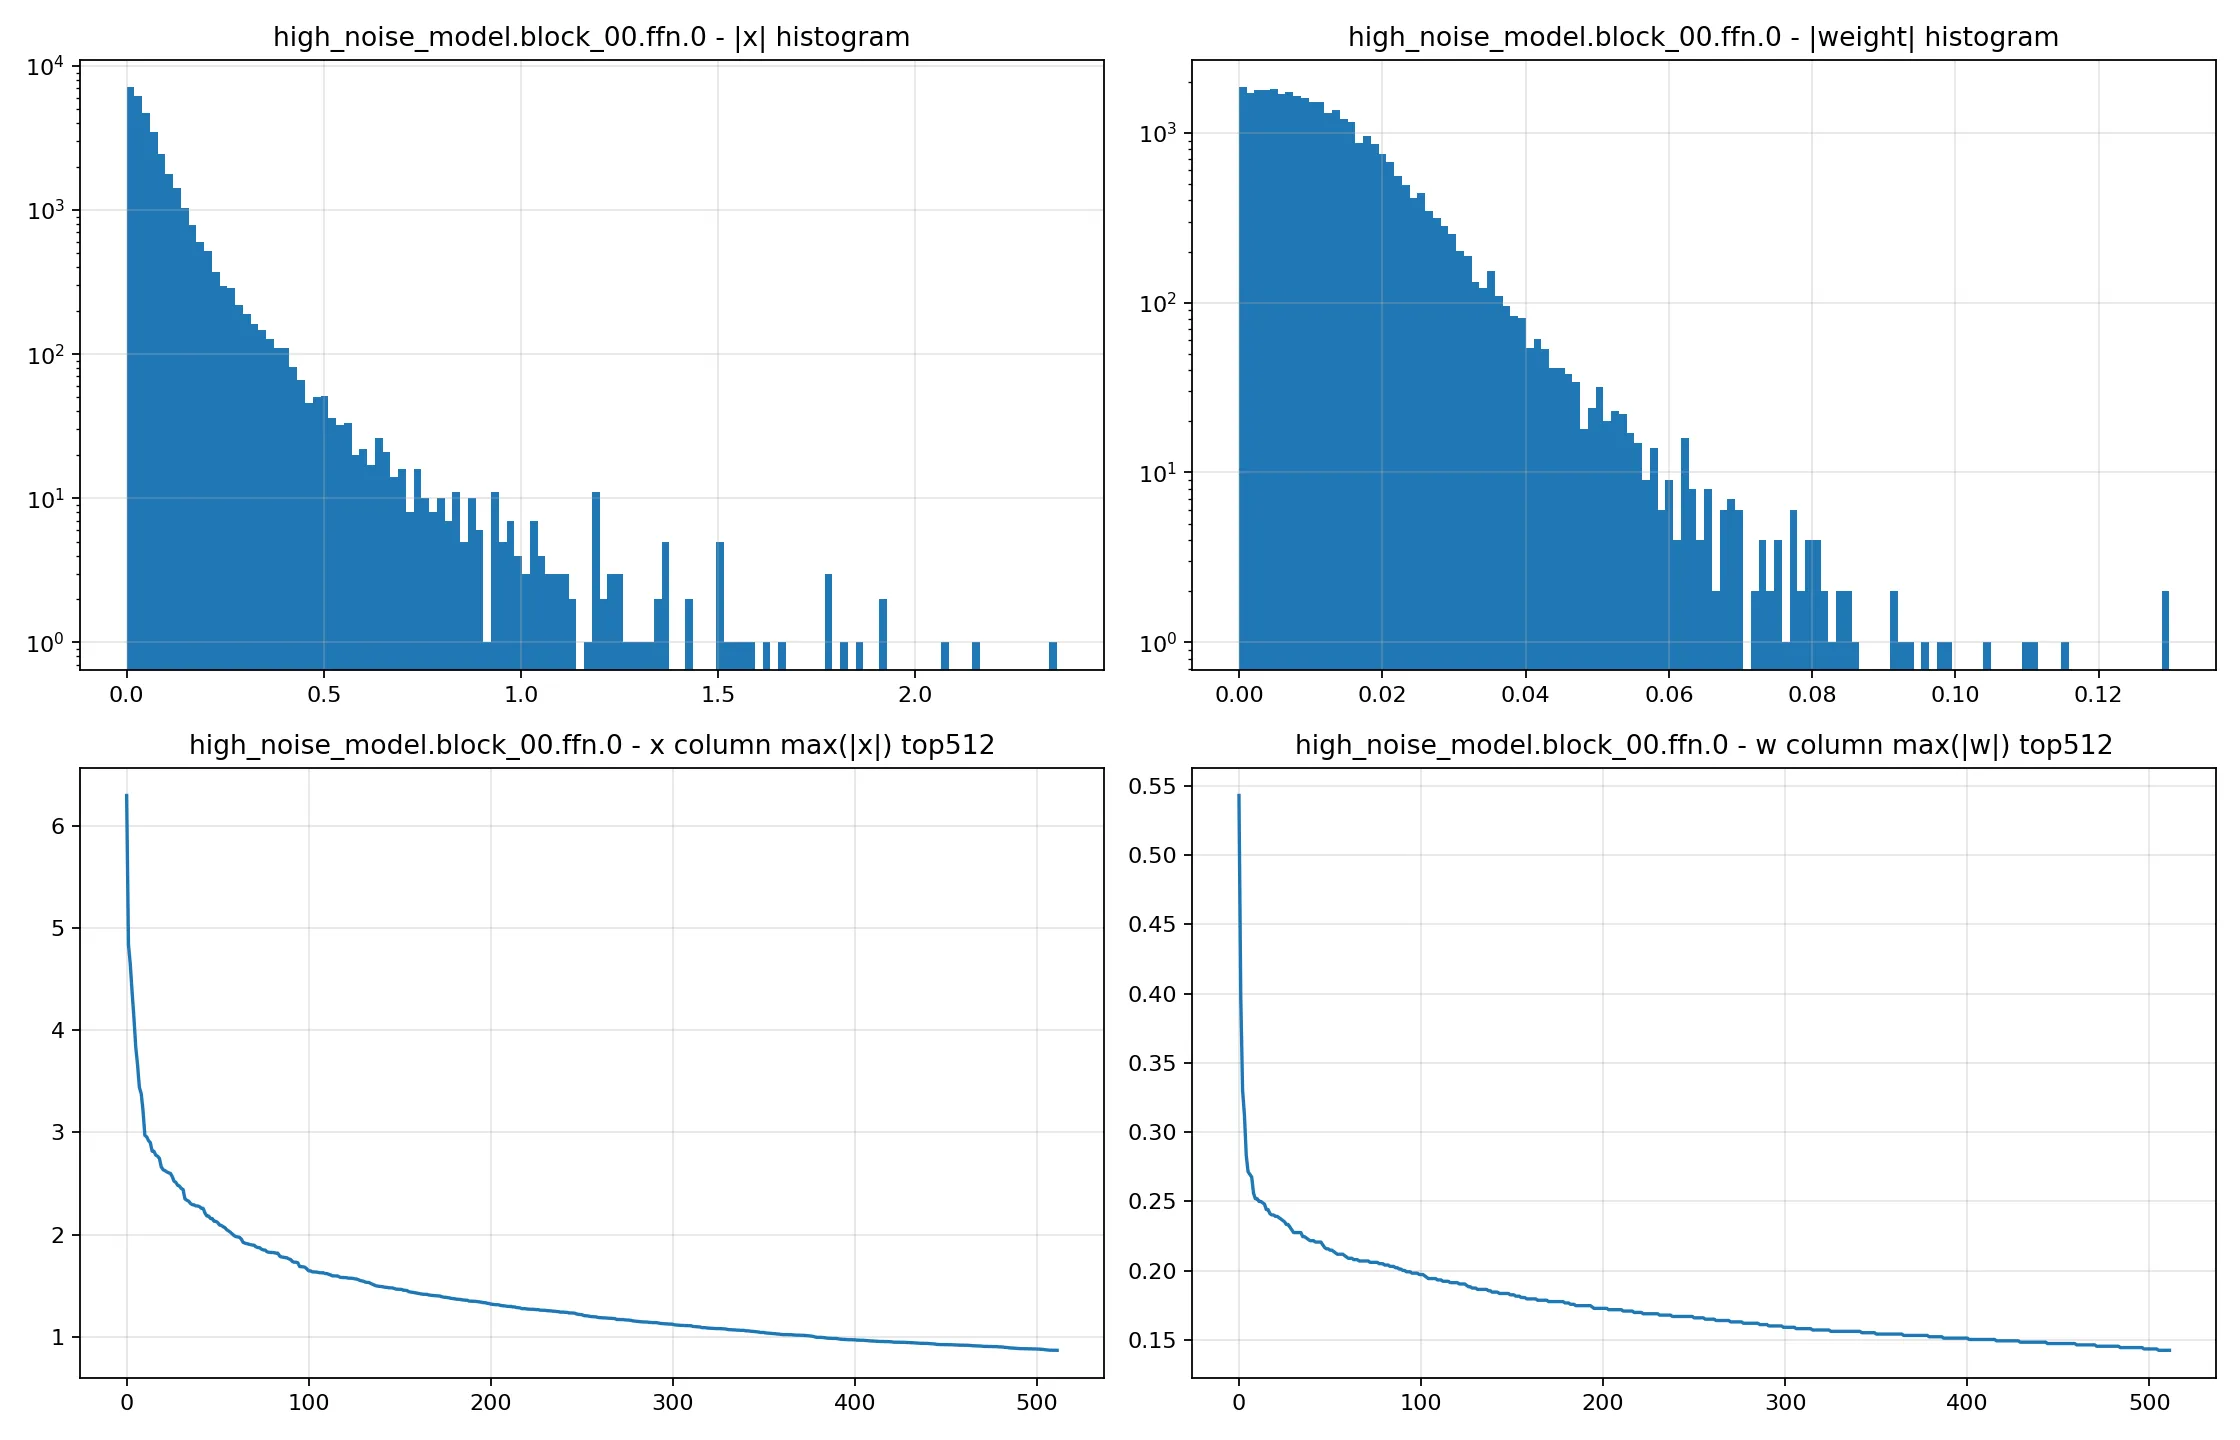
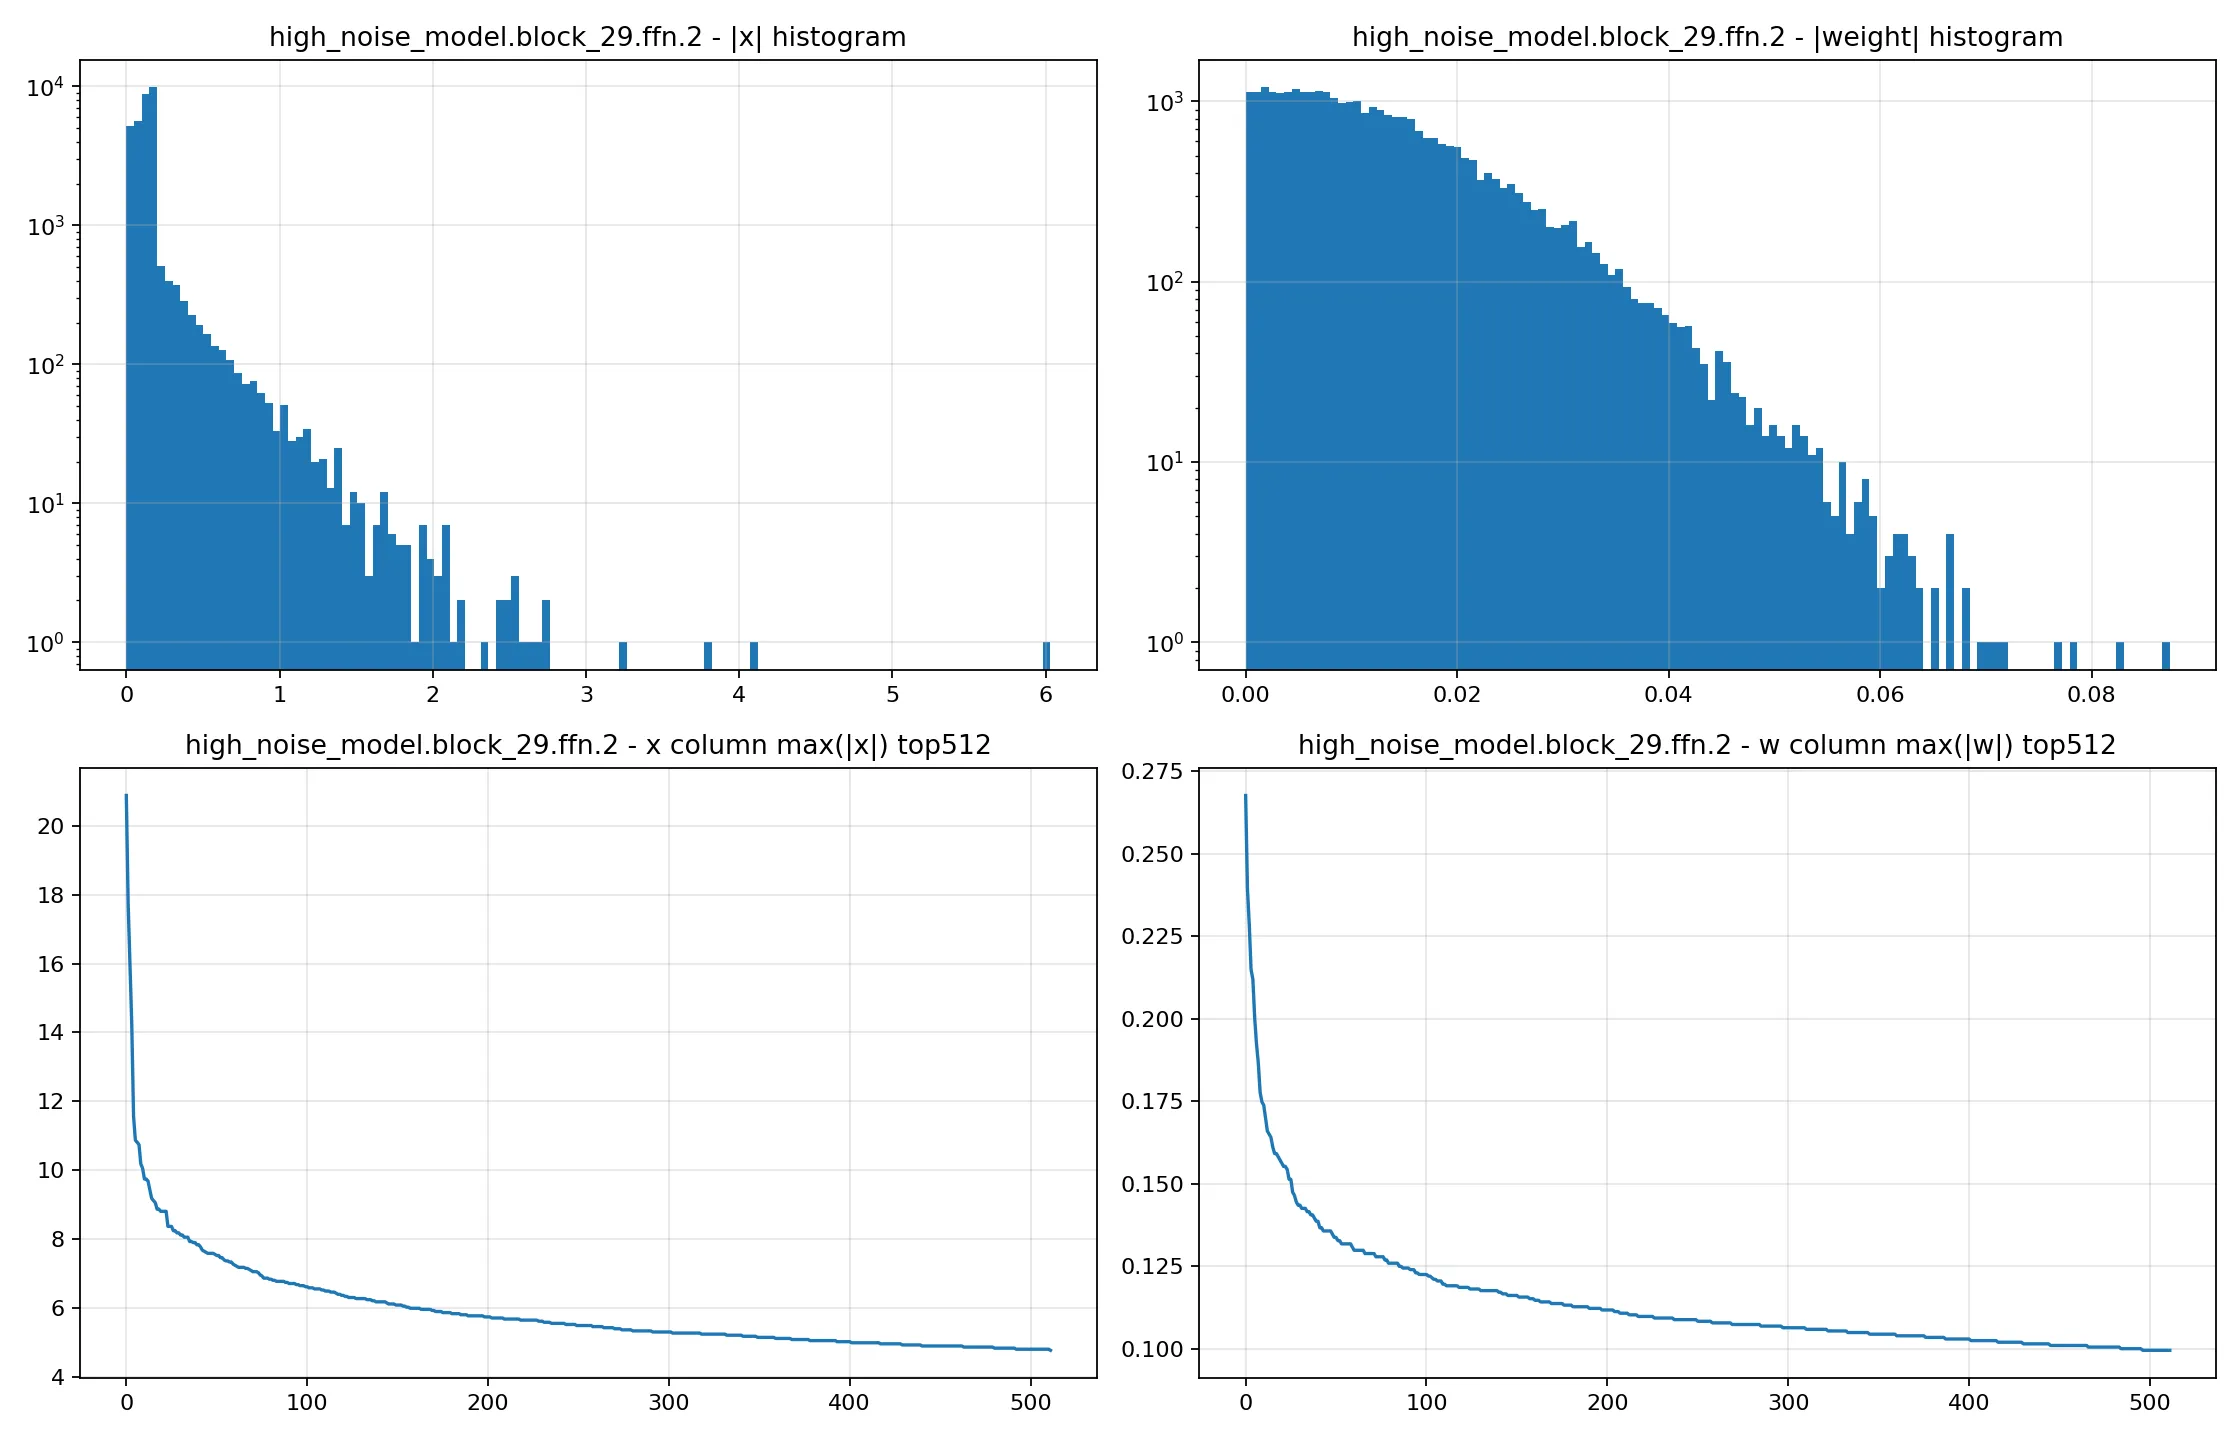
高噪 block_00.ffn.0 的校准统计显示:activation 列 max > 6.0,而 weight 列 max < 0.6;|x| 直方图在 |x|>1.5 处仍有明显尾部。这些尾部在 per-tensor 或粗粒度 per-channel W4A4 下直接决定 quantizer step,把绝大多数小幅通道压到少数 bin 里。
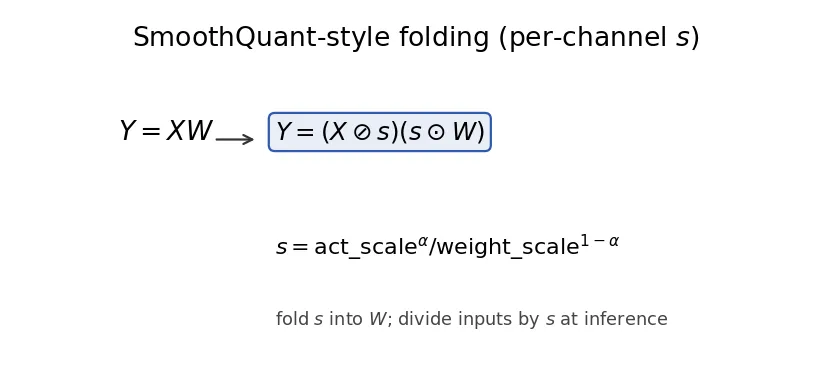
3.2 SmoothQuant 逐通道平滑
对线性层 ,引入正因子向量 :
校准时收集激活/权重逐通道幅度,取
越大,越多动态范围被推入 。FFN up-projection 上作者取 。 会在离线阶段 folded 进 master 权重,推理时激活先除以 再走 HiF4 quantize。
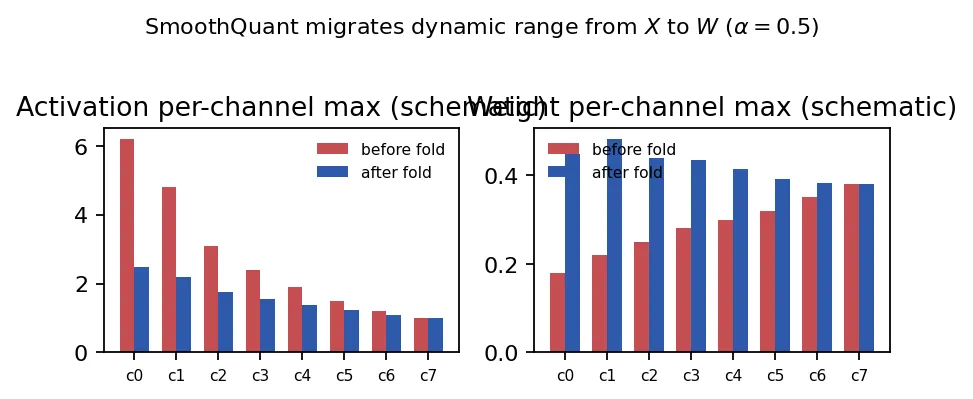
3.3 MixQ 列拆 + 双分支 GEMM
对 计算逐列打分:
选 top- 列构成静态离群集合 ,。层输出:
其中 走 HiF4/MXFP4 W4A4, 走 FP16/BF16。与原 MixQ 不同:视频扩散 token 是时空 token,作者放弃 MixQ 的在线预测,改用静态 ,每层保存稀疏索引列表, 保持极小以满足 challenge 高精度预算。
3.4 块级 HiF4 权重打包
在 fold 与列抽取之后,剩余权重按 block-wise scale 打包:评估 32×32 tiles 与 128×1 K-major stripe。前者对局部离群 tile SNR 更好,后者匹配 GEMM 内存序。每 block 的指数与 4bit payload 并列存储。
3.5 设计理由
- SmoothQuant 是全局线性再平衡,能拉低多数通道尾部但无法根除最重尾;
- MixQ 是选择性保护,只在 fold 后剩余的重尾列上花高精度预算;
- 先 smoothing 再 splitting,可让高精度分支 更小, 保持在挑战赛”允许的高精度预算”内;
- 深层 block(如 block_29.ffn.2)尾部结构相似但幅度略降,同一 recipe 通用(图6)。
四、核心创新
| 创新点 | 说明 |
|---|---|
| LLM→视频扩散的 W4A4 recipe 迁移 | 首次系统地把 SmoothQuant + MixQ 组合用到 Wan2.2 视频 DiT FFN |
| 静态离群列 | 用 OpenS2V-5M 校准得到的 static top- 列取代 MixQ 的在线预测,减少推理调度复杂度、便于挑战赛审计 |
| 双分支 GEMM 与 block HiF4 融合 | 主路径 W4A4 + 窄路径 FP16 + 32×32 / 128×1 tile 权重打包 |
| Layer-wise 与 | 建议深/浅层用不同 与 以进一步缩小 gap |
五、实验结果
VBench I2V 指标(相对 FP16 的百分比变化)
| Method | Aesthetic | I2V subj. | Imaging | Motion | Subj. cons. |
|---|---|---|---|---|---|
| FP16 baseline | 0.5445 | 0.9626 | 0.7086 | 0.9730 | 0.9199 |
| Native HiFloat4 | 0.5173 (−5.0%) | 0.9145 (−5.0%) | 0.6732 (−5.0%) | 0.9243 (−5.0%) | 0.8739 (−5.0%) |
| Ours (W4A4) | 0.5274 (−3.1%) | 0.9375 (−2.6%) | 0.6936 (−2.1%) | 0.9769 (+0.4%) | 0.8875 (−3.5%) |
- Native HiFloat4 各项均掉约 5%;
- 本文 W4A4 pipeline 在四项指标上把 gap 收窄到 2–3.5%;
- Motion smoothness 反超 FP16 +0.4%,说明”结构化混合精度 + smoothing”对视频扩散 FFN 优于均匀 4bit rounding;
- 剩余 gap 集中在 aesthetic / subject consistency,作者认为源于 4bit activations 对精细外观细节的截断。
定性讨论
- 单用 SmoothQuant 无法处理最重尾的 outlier 列;
- 单用 MixQ 需要更多高精度列,可能超挑战赛预算;
- 联合使用可让 保持很小同时把 activation range 收进 4bit 可表示区间;
- 尾部结构在深层持续存在,共享 recipe 有效。
六、总结
核心贡献
- 将 SmoothQuant + MixQ + block HiF4 打包组合迁移到视频扩散 W4A4 推理;
- 在 Wan2.2-I2V-A14B 上全部 VBench I2V 指标击败原生 HiFloat4 基线,与 FP16 差距压缩到几个百分点内;
- 提供可审计的确定性推理图(静态 、离线 fold),便于 challenge 复现。
技术影响
- 证明 LLM 量化经验(激活离群列 + 平滑)可有效迁移到时空扩散 transformer;
- 双分支 GEMM 为 HiF4/MXFP4 硬件路径提供了可落地的 outlier 处理模板;
- Layer-wise 参数调整(, )与 MXFP4 5-层 FP16 允许量结合是明确的下一步。
局限性
- 未探索把 MixQ 的 token-locality 在线预测扩展到 spatio-temporal 扩散 token;
- 未在 720P 之外分辨率或多模型上验证;
- 校准依赖 OpenS2V-5M 抽样,未做校准数据鲁棒性研究;
- 挑战赛报告,模型/评测受限于赛制。
七、参考资源
- 论文原文:https://arxiv.org/abs/2606.29337
- HTML 版本:https://arxiv.org/html/2606.29337v1
- 代码:https://github.com/shch-y/icme
- 参考文献:SmoothQuant (Xiao et al. ICML 2023)、MixQ (Chen et al. SC 2024)、Wan2.2 (Wan-AI)