TurboServe: Serving Streaming Video Generation Efficiently and Economically
首个面向流式视频生成服务的调度系统。将服务建模为在线调度问题,通过迁移感知的 min-max 会话再平衡与负载驱动的 GPU 自动扩缩,配合 GPU-CPU 卸载和 RDMA 会话迁移,联合优化每 chunk 最差延迟与 GPU 成本。在生数科技生产 trace 上,相比基线平均降低最坏每 chunk 延迟 37.5%(最高 51.6%)、降低 GPU 运营成本 37.2%(最高 49.0%),且与离线 oracle 相比调度成本仅差 6.1%。
TurboServe: Serving Streaming Video Generation Efficiently and Economically
一、论文概述
| 项目 | 内容 |
|---|---|
| 论文标题 | TurboServe: Serving Streaming Video Generation Efficiently and Economically |
| 作者 | Youhe Jiang, Haoxu Wang, Haotong Bao, Kai Jiang, Jianfei Chen, Jun Zhu, Fangcheng Fu, Jintao Zhang |
| 提交日期 | 2026-06-17 |
| arXiv ID | 2606.19271 |
| 学科分类 | cs.DC(分布式、并行与集群计算) |
| 部署方 | 生数科技(Shengshu Technology) |
二、核心思想
问题定义
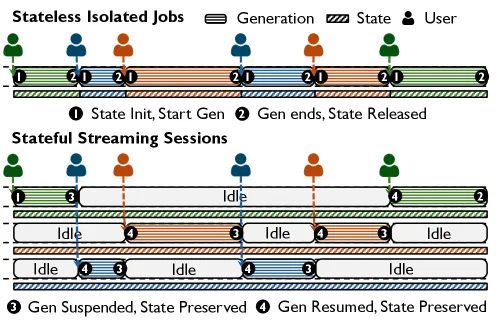
流式视频生成(Streaming Video Generation,例如 StreamDiffusionV2、Self-Forcing、HYWorldPlay、LongLive)是一种新兴的服务负载:用户与长生命周期的会话交互,视频以 chunk 为单位逐步生成,会话必须跨活跃/空闲期保持状态,反复被调度并在严格的每 chunk 延迟约束下投递。这种模式违反了 FastVideo、xDiT、TridentServe 等现有面向”一次性、无状态”视频生成系统的假设,带来两大挑战:
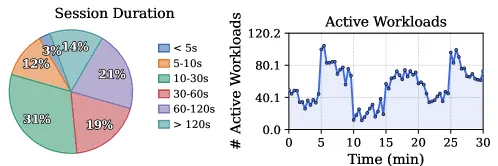
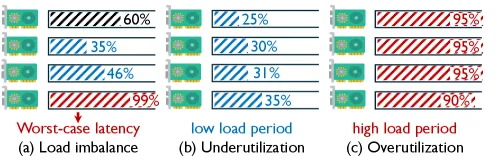
- 挑战 1:会话时长异质性 —— 会话时长从数秒到数十分钟不等(Figure 2 左)。当长时间会话累积后,最初的放置决策变差,某些用户失去实时性。
- 挑战 2:时序需求异质性 —— 活跃会话数在突发和空闲之间剧烈波动(Figure 2 右)。
解决方案概述
提出 TurboServe ——首个专为流式视频生成设计的服务系统。其核心是一个 闭环调度框架,联合调度:
- 迁移感知的会话放置控制器(Placement Controller)
- 负载驱动的 GPU 自动扩缩控制器(Autoscaling Controller)
底层通过合并 chunk 处理(coalesced chunk execution)、GPU-CPU 卸载暂停/恢复、以及基于 NCCL/NIXL 的 RDMA GPU-GPU 迁移来支撑上层决策。
三、技术架构/方法
系统总览
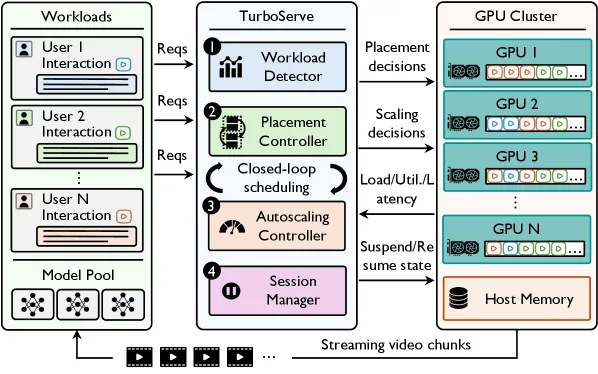
TurboServe 由四大组件构成(Figure 5):workload detector(滑窗提取负载信号)、placement controller、autoscaling controller、session manager。
问题形式化
系统维护动态大小的 GPU 池 ,每张 GPU 至多容纳 个并发会话且不违反 per-chunk 延迟约束。事件驱动调度:在会话到达、离开或活跃/空闲切换时触发 decision epoch 。
决策变量:
- 活跃 GPU 数
- 放置函数 :将会话 映射到某个 GPU (execution)或 (suspend)
目标:联合最小化每 chunk 最坏延迟 与运营成本 。
放置控制器(Placement Controller)
在固定 GPU 预算 下近似求解:
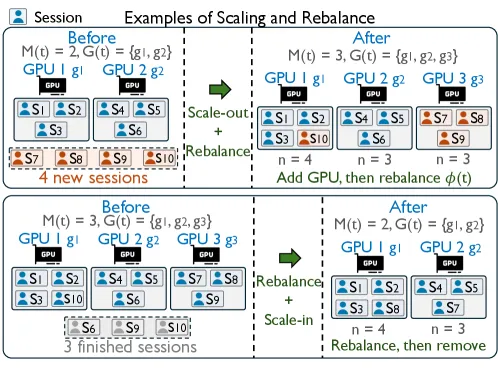
Migration-aware min-max rebalancing:设 为分配到 的会话数, 为瓶颈 GPU。对 上的会话 尝试迁移到目标 ,用 - 网络模型评估迁移代价 ,收益函数:
只有当 时才执行迁移。控制器从上一时刻的 增量更新,避免不必要迁移。
自动扩缩控制器(Autoscaling Controller)
根据 workload detector 提供的运行时反馈(负载、利用率、per-chunk 延迟)动态调整 GPU 预算 ,做 scale-out 与 scale-in 决策。
部署机制
会话管理:每个 worker 内存分三部分——共享模型副本、按会话隔离的 state 区域(prompt/控制 embedding、时序 / KV cache、chunk 历史特征、latent buffers、output metadata)、以及会话所有权表。这样只需迁移 per-session state 区域而无需搬运模型副本。
GPU-GPU 迁移:仅在 chunk 边界迁移,保证一致性;使用 RDMA / NIXL 风格的单边 GPU memory access。
GPU-CPU 卸载:空闲会话状态 offload 到 host memory,释放 GPU 槽位;活跃时再 restore。视频生成属计算密集型,不使用 LLM 中常用的重计算策略。
四、核心创新
| 创新点 | 描述 | 效果 |
|---|---|---|
| 流式视频生成服务问题形式化 | 首次将流式视频生成建模为”会话放置 + GPU 供给”联合在线调度 | 为闭环控制奠定形式化基础 |
| Migration-aware min-max rebalancing | 在 chunk 边界通过 - 网络模型评估迁移代价、按收益 增量迁移 | 与 oracle 差距仅 3.6%(最高 6.5%),调度快 10× 以上 |
| 负载驱动 GPU autoscaling | 基于滑窗需求信号做 scale-out/in,无需未来先知 | 与离线 oracle 相比 GPU 成本差距 6.1%(最高 8.3%) |
| Coalesced chunk execution | 同 GPU 上多个 ready 会话合批一次推理 | 摊薄模型执行开销,提升 GPU 利用率 |
| 会话状态化运行时 | execution/suspend/terminate 三态机 + GPU-CPU 卸载 + RDMA 迁移 | 解耦会话生命周期与 GPU 驻留 |
五、实验结果
实验设置
- 硬件:Cluster 1 = 16× H20(NVLink 956 GB/s,IB 50 GB/s);Cluster 2 = 64× B300。
- 模型:LongLive-1.3B 及更大变体。
- 负载:生数科技生产 trace(Trace 1-6)。
- 指标:最坏 per-chunk 延迟;GPU 运营成本。
- 基线:TurboServe base(round-robin + FCFS)、+ LAG(Load-Aware Greedy)、+ MAG(Memory-Aware Greedy)。
端到端结果
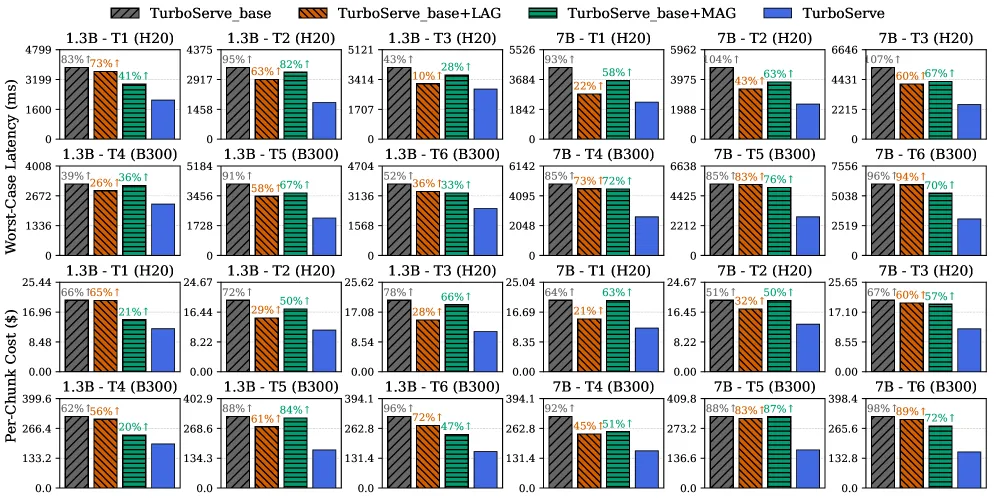
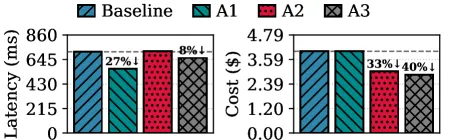
- 延迟(匹配成本):TurboServe 相比基线平均降低最坏 per-chunk 延迟 37.5%,最高 51.6%。
- 1.3B 模型 + Trace 1 + Cluster 2 上,相比 LAG / MAG / base 分别降低 20.5% / 26.6% / 28.2%。
- 成本(匹配延迟):平均降低 GPU 运营成本 37.2%,最高 49.0%。
- 同上配置下,相比 base / LAG / MAG 分别降低 38.3% / 35.9% / 16.7%。
消融实验
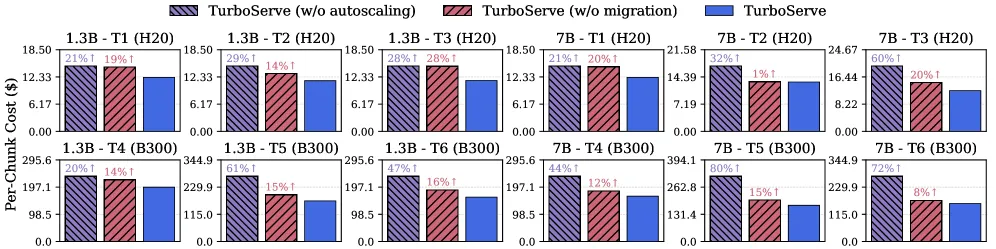
| 消融项 | 平均成本增加 | 最高成本增加 |
|---|---|---|
| 关闭 migration | 15.0% | 28.0% |
| 关闭 autoscaling | 42.9% | 80.4% |
调度算法有效性
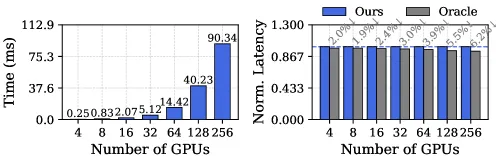
- 调度效率:64 GPU 集群下调度耗时 < 15 ms(< 2% chunk 生成时间);256 GPU 下 < 0.1 s。
- 调度效果:与穷举 oracle 相比放置质量差距 3.6%(最高 6.5%),调度耗时快 10× 以上。
- Autoscaling 与离线 oracle:三条生产 trace 上成本差距 6.1%(最高 8.3%)。
六、总结
核心贡献
- 提出首个面向流式视频生成服务的系统,识别并形式化了会话时长异质性与时序需求异质性两大挑战。
- 设计闭环调度框架:迁移感知 min-max 会话再平衡 + 负载驱动 GPU 自动扩缩,用 平衡收益与迁移成本。
- 部署级运行时支持 coalesced chunk execution、GPU-CPU 状态卸载、RDMA GPU-GPU 状态迁移。
技术影响
- 生产 trace 上 37.5% 延迟下降、37.2% 成本下降,直接落地生数科技服务栈。
- 为未来”长会话 + 交互式”生成式 AI 服务(如 world model、实时视频交互)提供参考模板。
局限性
- 只考虑同构 GPU 集群;异构 GPU 场景未讨论。
- 与 LLM serving 常用的重计算/KV 复用等策略互补性未研究。
- 迁移一致性仅在 chunk 边界,对更细粒度(子 chunk)迁移未覆盖。
七、参考资源
- arXiv: https://arxiv.org/abs/2606.19271
- HTML 全文:https://arxiv.org/html/2606.19271v1
- 相关系统:StreamDiffusionV2、Self-Forcing、LongLive、HYWorldPlay、FastVideo、xDiT、TridentServe