DreamX-World 1.0: A General-Purpose Interactive World Model
A general-purpose interactive text/image-to-video world model supporting camera navigation, scene revisits, and promptable events with 16 FPS streaming on 8x RTX 5090
DreamX-World 1.0: A General-Purpose Interactive World Model
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DreamX-World 1.0: A General-Purpose Interactive World Model |
| 作者 | Yancheng Bai, Rui Chen, Xiangxiang Chu, Rujing Dang, Hao Dou, Bingjie Gao, Qiwen Gu, Siyu Hong, Jiachen Lei, Geng Li, Jifan Li, Ruimin Lin, Qingfeng Shi, Bingze Song, Lei Sun, Jing Tang, Ruitian Tian, Jun Wang, Jiahong Wu, Pengfei Zhang, Shen Zhang, Jiashu Zhu |
| 机构 | AMAP-ML (阿里巴巴地图机器学习团队) |
| 论文 | https://arxiv.org/abs/2606.16993 |
| 代码 | https://github.com/AMAP-ML/DreamX-World |
| 项目页 | https://amap-ml.github.io/DreamX_World |
| 发布 | 2026-06-15 (v1) |
| 许可 | Non-exclusive distribution license (arXiv default) |
二、核心思想
问题定义
交互式世界模型需要同时解决三个核心挑战:
- 相机控制:如何将指定的相机轨迹转化为跨场景的一致视角变化,而不大幅增加计算成本
- 长时序场景保持:当早期视图离开上下文窗口后又重新访问时,如何防止风格/颜色漂移
- 连续交互的延迟:如何在减少扩散步数的同时保持视觉质量和相机控制能力
解决方案概述
DreamX-World 1.0 是一个通用交互式文本/图像到视频的世界模型,支持可控的长时序生成。核心特性:
- 相机导航:6-DoF 相机轨迹控制
- 场景重访:能够回到之前观察过的区域
- 可提示事件:跨写实、游戏风格和风格化领域的可组合事件控制
- 实时流式推理:8× RTX 5090 上达到 16 FPS
数据引擎结合了相机精确的 Unreal Engine 渲染、动作丰富的游戏录制和带有恢复相机几何的真实视频。通过将双向视频生成器转换为少步自回归世界模型,并引入强化学习对齐来恢复蒸馏后的质量。
三、技术架构
整体框架图
DreamX-World 的训练流水线分为五个渐进阶段:
┌─────────────────────────────────────────────────────────────────────┐
│              DreamX-World Progressive Training Pipeline              │
├─────────────────────────────────────────────────────────────────────┤
│                                                                     │
│  Stage 1: Camera-Aware Training                                     │
│  ┌─────────────────────────────────────────────────────────────┐   │
│  │  Base: Wan2.2-TI2V (Diffusion Transformer)                  │   │
│  │  + E-PRoPE (Efficient Projective Positional Encoding)       │   │
│  │  → 6-DoF camera pose conditioning                           │   │
│  └─────────────────────────────────────────────────────────────┘   │
│                    ↓                                                │
│  Stage 2: Memory-Conditioned Scene Persistence                      │
│  ┌─────────────────────────────────────────────────────────────┐   │
│  │  z_pack = [z_M | z_H | z_C_tau]                              │   │
│  │  • z_M: Memory frames (geometry-based retrieval)            │   │
│  │  • z_H: Recent history frames                               │   │
│  │  • z_C_tau: Noisy target latents                            │   │
│  │  + Exposure bias mitigation (SVI-style error injection)     │   │
│  └─────────────────────────────────────────────────────────────┘   │
│                    ↓                                                │
│  Stage 3: Event Instruction Tuning                                  │
│  ┌─────────────────────────────────────────────────────────────┐   │
│  │  Hierarchical captioning + dense time-aligned events        │   │
│  │  → 5 levels: promptable, object, region, multi-entity, IO   │   │
│  └─────────────────────────────────────────────────────────────┘   │
│                    ↓                                                │
│  Stage 4: AR Long Video Generation & Distillation                   │
│  ┌─────────────────────────────────────────────────────────────┐   │
│  │  Bidirectional → Few-step AR via:                           │   │
│  │  • Causal forcing on large-scale video                       │   │
│  │  • LongLive adaptation (long rollouts)                       │   │
│  │  • Infinity-RoPE (extended AR context)                       │   │
│  │  • DMD-forcing (camera-controlled distillation)             │   │
│  │  • I2V DMD (first-frame VAE-decoded condition)              │   │
│  └─────────────────────────────────────────────────────────────┘   │
│                    ↓                                                │
│  Stage 5: Reinforcement Learning Alignment                          │
│  ┌─────────────────────────────────────────────────────────────┐   │
│  │  Reward models: camera-control + video-quality              │   │
│  │  • DiffusionNFT soft update with KL regularization          │   │
│  │  • Gradual update strategy for few-step stability           │   │
│  └─────────────────────────────────────────────────────────────┘   │
│                    ↓                                                │
│  Inference: AR Streaming + Optimizations                            │
│  ┌─────────────────────────────────────────────────────────────┐   │
│  │  • Chunk-wise generation (noise start + few-step sampler)   │   │
│  │  • Rolling KV cache + chunk-relative camera param.          │   │
│  │  • INT8 SageAttention + mixed-precision DiT                 │   │
│  │  • 75%-pruned VAE decoding + async pipeline parallelism     │   │
│  │  → 16 FPS on 8× RTX 5090                                    │   │
│  └─────────────────────────────────────────────────────────────┘   │
│                                                                     │
└─────────────────────────────────────────────────────────────────────┘
核心组件详解
E-PRoPE (Efficient Projective Positional Encoding)
PRoPE 为每个 token 计算矩阵:
其中 是世界到图像的投影矩阵, 是标准旋转位置编码。
E-PRoPE 的空间降采样:
- 5 秒 720P 视频的 VAE 产生 S = 18,480 个 token
- 降采样到 N = 4,096 个 token 后再进行 PRoPE 注意力
- >4.5× 减少,训练时间减少 ~50%,推理减少 ~30%
Memory-Conditioned Scene Persistence
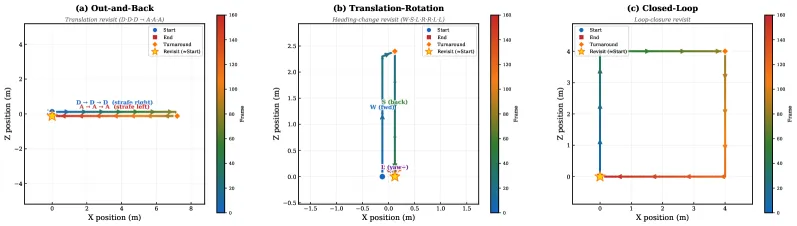
记忆检索使用相机几何和视图重叠(而非仅时间邻近性),RoPE 嵌入为记忆帧添加时间上下文。
曝光偏差缓解:借鉴 Stable Video Infinity (SVI) 的错误注入技术,扰动条件 token 但保持目标干净。
DMD-Forcing 蒸馏
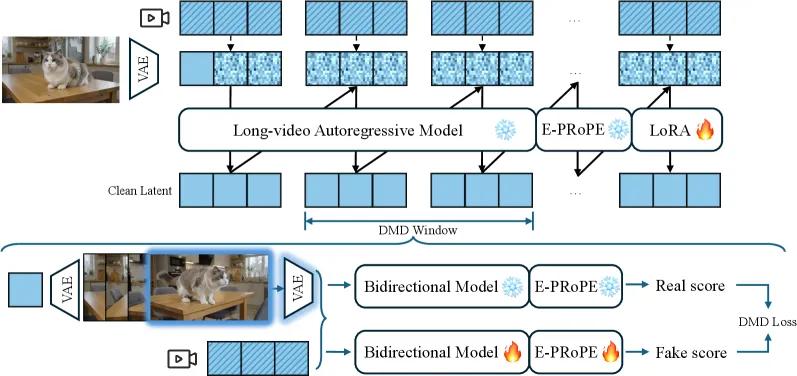
将双向模型转换为自回归模型的三个关键技术:
- 因果强制 (Causal Forcing):在大规模视频数据上训练
- LongLive 适应:长序列上的长 rollout 训练
- DMD-Forcing:E-PRoPE AR 学生从双向 E-PRoPE 教师通过 DMD 监督在局部时间窗口上蒸馏
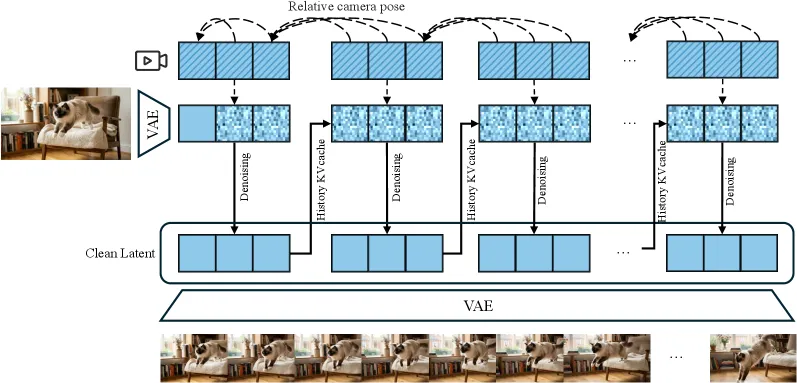
流式推理
每个 chunk 从噪声开始,在文本提示 + chunk-relative 相机轨迹 + 滚动 KV cache 下用少步采样器去噪。Chunk-relative 相机参数化防止条件信号在长序列中减弱。
模型架构
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 基座模型 | Wan2.2-TI2V (Diffusion Transformer) | ~3.92B 参数 (DreamX-World-1.0-5B) |
| 视频编解码器 | Wan2.2 VAE | 75%-pruned for inference |
| 相机控制 | 6-DoF poses with E-PRoPE | 空间降采样 4.5× |
| 注意力优化 | INT8 SageAttention | 量化注意力层 |
| 推理硬件 | 8× RTX 5090 | 混合精度 DiT + 异步流水线并行 |
数据引擎
DreamX-World 的数据系统整合三种来源:
| 数据来源 | 说明 | 相机姿态 |
|---|---|---|
| UE 生成数据 | Unreal Engine 5,第一人称自由相机 + 第三人称角色驱动 | 逐帧 GT 标注 |
| 真实世界数据 | SpatialVID, RealEstate10K, Sekai, DL3DV | MegaSaM 稀疏估计 + 插值 |
| 游戏数据 | Sekai-Game, OmniWorld-Game | 引擎导出 → 统一坐标系 |
数据清洗三阶段:
- 基本过滤(时长/帧率不足、覆盖文字过多、黑边、CLIP 余弦相似度检测视觉变化)
- 几何相机姿态清洗(SLERP 旋转插值、平移线性插值、异常检测)
- 视频标注与属性标记(全局描述 + 美学质量、运动强度、场景类别、视觉风格)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| E-PRoPE | 轻量级投影位置编码,保留 PRoPE 的相机几何但降采样空间 token | 训练 -50%,推理 -30%,相机控制得分几乎不变 (73.89→73.75) |
| Memory-Conditioned Scene Persistence | 基于几何的记忆检索 + 残差回收 | 在重访一致性评估中领先所有基线 |
| DMD-Forcing 蒸馏 | 相机控制的少步自回归蒸馏 | 将双向模型转为少步 AR,配合 RL 恢复质量 |
| 事件指令微调 | 分层标注策略(全局描述 + 密集时间对齐实体事件) | 唯一支持全部 5 级事件控制的模型 |
| RL 对齐 | DiffusionNFT + 渐进更新策略 | 蒸馏后恢复相机控制和视觉质量 |
| 16 FPS 流式部署 | INT8 SageAttention + 混合精度 DiT + 75% 剪枝 VAE + 异步流水线并行 | 8× RTX 5090 实测 |
五、代码实现分析
GitHub: https://github.com/AMAP-ML/DreamX-World
DreamX-World 的关键实现:
- 基于 Wan2.2-TI2V 初始化,引入 E-PRoPE 到 DiT 注意力层
- 自回归 chunk-wise 生成,每个 chunk 从噪声开始
- 滚动 KV cache 跨 chunk 传递条件
- chunk-relative 相机参数化(防止长期条件衰减)
- I2V 模式仅第一个 chunk 用首帧 VAE 解码条件替换
六、实验结果
基准测试
E-PRoPE vs PRoPE 对比 (Omni-WorldBench, 1280×720, 8× H20):
| 指标 | PRoPE | E-PRoPE | 变化 |
|---|---|---|---|
| 相机控制 | 73.89 | 73.75 | -0.19% |
| 图像质量 | 66.15 | 66.75 | +0.91% |
| 动态度 | 87.5 | 85.83 | -1.91% |
| 过渡检测 | 96.67 | 98.33 | +1.72% |
| 时间闪烁 | 96.02 | 96.17 | +0.16% |
| 运动平滑 | 98.65 | 98.79 | +0.14% |
| 延迟 (秒) | 80 | 59 | -26.3% |
基本评估 (5 秒视频):
| 指标 | DreamX-World 1.0 (5B) | HY-WorldPlay 1.5 | LingBot-World |
|---|---|---|---|
| 相机控制 | 0.098 | 0.079 | — |
| 质量 | 0.232 | 0.202 | — |
| 过渡 | 0.246 | 0.200 | — |
| 闪烁 | 0.142 | 0.110 | — |
| 动态 | 0.216 | 0.251 | — |
| 总体 | 0.991 | 0.992 | — |
综合评分 (Abstract):
- DreamX-World 1.0: 84.76 (相机控制 73.75)
- HY-WorldPlay 1.5: 80.79
- LingBot-World: 80.45
事件控制能力对比
| 事件级别 | DreamX-World | HY-WorldPlay | LingBot-World |
|---|---|---|---|
| 可提示事件 | ✓ | ✓ | ✓ |
| 对象级事件 | ✓ | ✓ | ✓ |
| 区域引导事件 | ✓ | ✗ | ✗ |
| 多实体组合 | ✓ | ✗ | ✗ |
| 实体间交互 | ✓ | ✗ | ✗ |
DreamX-World 是唯一支持全部 5 级事件控制的模型。
长时序评估 (30 秒 rollout)
DreamX-World 在长时序生成上同样领先,各项指标均优于基线。
记忆重访一致性评估
| 重访指标 | DreamX-World 1.0 | HY-WorldPlay 1.5 | LingBot-World |
|---|---|---|---|
| delta PSNR | 最佳 | — | — |
| delta SSIM | 最佳 | — | — |
| delta LPIPS | 最佳 | — | — |
| delta DINO-Sim | 最佳 | — | — |
| delta VPR-Sim | 最佳 | — | — |
| delta SP-Match | 最佳 | — | — |
DreamX-World 在所有重访指标上领先。
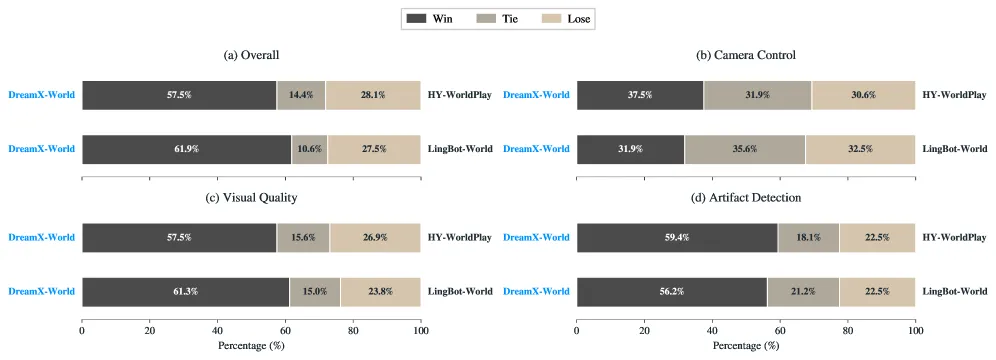
人类偏好研究
盲测对比 DreamX-World 1.0 vs HY-WorldPlay 1.5 vs LingBot-World,DreamX 在 Win/Tie/Lose 指标上表现最优。
七、相关工作
- 世界模型: Genie, GameNGen, GameGen-X, HY-World, LingBot, RELIC
- 相机控制: MotionCtrl, CameraCtrl, AC3D, PRoPE
- 长时序生成: Self-Forcing, SVI, LongLive, Infinity-RoPE, Causal Forcing
- 高效采样: DMD, SageAttention, TeaCache, ParaVAE
- 扩散模型 RL: DDPO, Flow-GRPO, DiffusionNFT, WorldCompass, Astrolabe
- 世界模型评估: WorldScore, Omni-WorldBench, WBench
八、总结
核心贡献
- DreamX-World 1.0:首个支持全栈交互式世界生成的通用模型
- E-PRoPE:高效投影位置编码,4.5× 空间降采样,训练 -50%,推理 -30%
- Memory-Conditioned Scene Persistence:几何驱动的记忆检索 + 曝光偏差缓解
- DMD-Forcing 蒸馏:将双向模型转为少步自回归,配合 RL 对齐恢复质量
- 16 FPS 实时流式部署:INT8 SageAttention + 混合精度 DiT + 75% 剪枝 VAE
- 全面的事件控制:唯一支持 5 级事件控制的模型
- 完整评估体系:基本评估 + 长时序 + 记忆重访一致性 + 人类偏好
技术影响
“World modeling is a full-stack problem: data curation, training, evaluation, and inference acceleration must be organized and improved from a global perspective.”
DreamX-World 展示了从数据引擎 → 渐进训练 → 推理加速 → 全面评估的全栈方法。
局限性
- 长时序视觉/几何一致性:物体外观/布局漂移仍然存在
- 冲突控制信号:当事件产生的视觉效果与后续观察不相容时
- 自动评估不完善:仍需人类/任务级评估
未来工作
- 以角色为中心的世界模型:持久身份、多角色协调
- 原生音视频世界模型:同步语音、环境音、动作依赖音频作为交互信号
九、参考资源
- arXiv: https://arxiv.org/abs/2606.16993
- GitHub: https://github.com/AMAP-ML/DreamX-World
- 项目页: https://amap-ml.github.io/DreamX_World
- 评估硬件: 8× RTX 5090 (推理), 8× H20 (训练)
- 基座模型: Wan2.2-TI2V
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 2 | 系统概览 | system-overview.png |
| Figure 6 | 记忆条件化场景持久性 | memory-conditioning.png |
| Figure 7 | DMD-Forcing 蒸馏 | dmd-distillation.png |
| Figure 9 | 自回归流式推理 | streaming-inference.png |