GF-DiT: Scheduling Parallelism for Diffusion Transformer Serving
GF-DiT 把 GPU 并行度视为一等可调度资源,将 DiT 请求拆为可独立调度的 trajectory tasks 并支持在线 GPU 重分配;提出 group-free collectives 用符号缓冲区 + 边协商实现毫秒级动态通信组,把 communicator 建立时间从 778 ms 降到约 60 μs;相比静态并行 pipeline 吞吐提升最多 6.01×、平均延迟降低最多 95%、SLO 违约率降低最多 90%。
GF-DiT: Scheduling Parallelism for Diffusion Transformer Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| arXiv ID | 2606.13501 |
| 标题 | GF-DiT: Scheduling Parallelism for Diffusion Transformer Serving |
| 作者 | Xinwei Qiang, Yifan Hu, Shixuan Sun, Jing Yang, Han Zhao, Chen Chen, Yu Feng, Jingwen Leng, Minyi Guo |
| 机构 | Shanghai Jiao Tong University · Guizhou University |
| 提交日期 | 2026-06-11 |
| 学科 | cs.DC; cs.LG; cs.PF |
| 链接 | https://arxiv.org/abs/2606.13501 |
二、核心思想
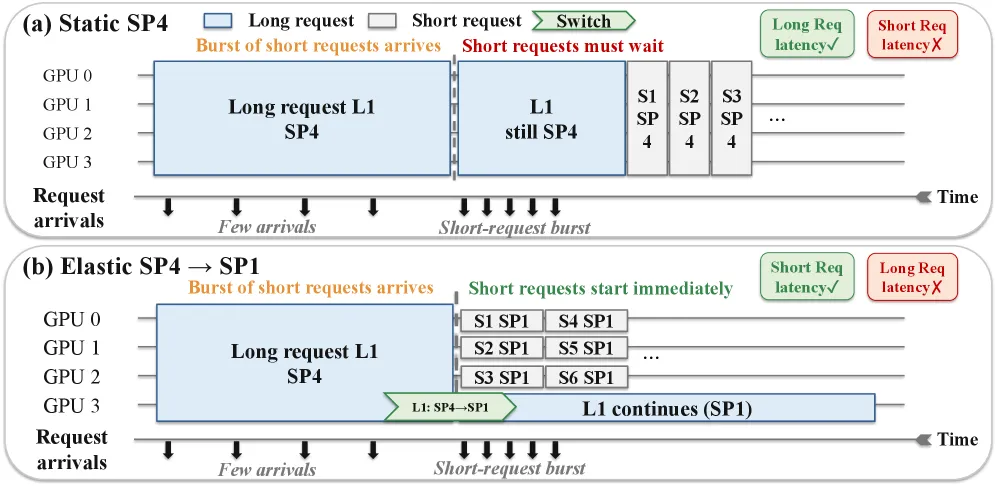
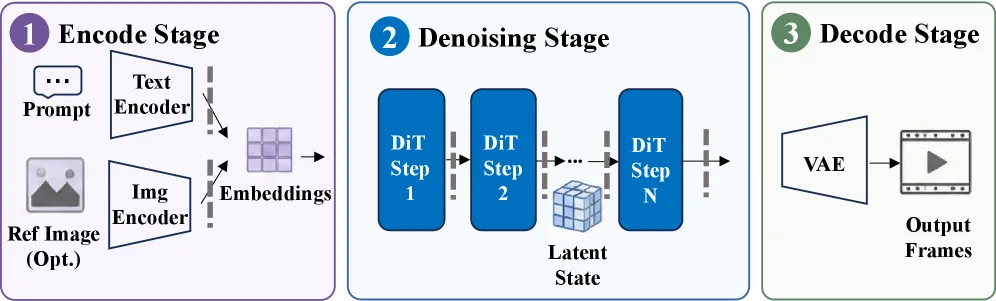
问题定义:Diffusion Transformer (DiT) 已成为 T2I / T2V 主流架构,推理由 encoder → denoising(几十步 iter,主导耗时)→ decoder 三阶段构成。现有系统(vLLM-Omni、SGLang Diffusion)给每个请求一个固定并行配置 (SP1/SP4/SPmax 等) 并在整个生命周期不变,导致:(a) 长请求 HoL blocking 短请求;(b) 轻量阶段(encoder/decoder)与小请求无法充分利用大规模并行,反之大请求被欠配。
解决方案:把 GPU 并行度视为一等可调度资源。GF-DiT 是策略可编程的弹性 DiT 服务运行时:
- 可重调度 trajectory tasks:把请求拆为独立调度的 encoding / decoding / 单步 denoising 任务,任务边界即是重调度点。
- Group-Free Collectives (GFC):轻量通信抽象,用对称缓冲区 + 边协商代替 NCCL 的进程组,实现在线组的低开销动态形成与重构,把 communicator 建立时间从 778 ms 降到 ~60 μs。
- 策略可编程:EDF / SRTF-SP1 / SRTF-SPmax / FCFS 等可作为策略层选择。
三、技术架构 / 方法
3.1 关键性质
- 轻量执行状态:stage 与 denoise step 之间交换的是数 MB~数十 MB 的 latent/embedding,可低成本迁移。
- 可预测执行结构:denoising trajectory 在开始前基本确定,可准确估计成本与未来资源需求。
3.2 系统架构
GF-DiT 由控制平面(事件驱动调度)+ 执行平面(Worker)构成。请求转换为 trajectory task graph,调度器在任务边界重新决定执行 layout(GPU 集合 + 并行度)。
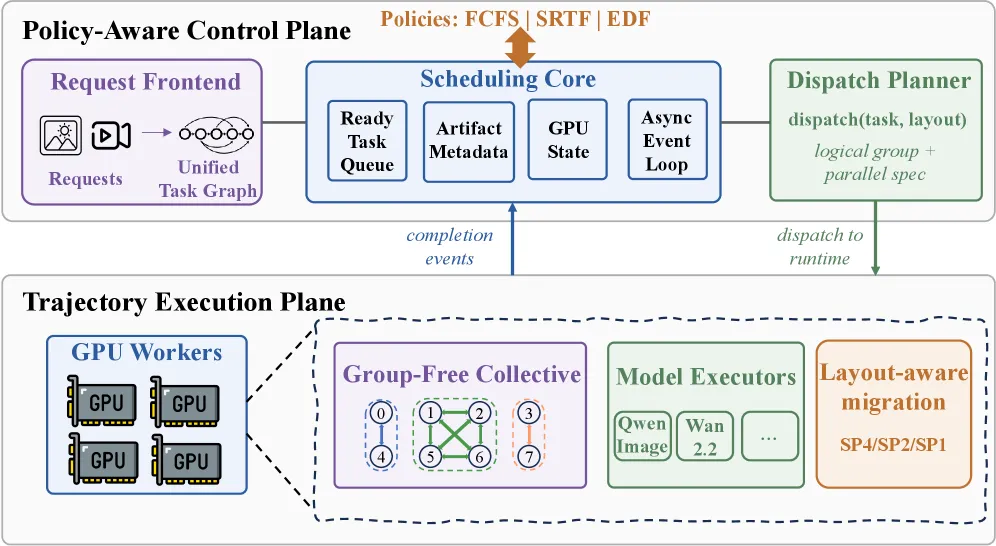
- Execution Layouts:静态并行策略成为一组”layout” 选项(SP1、SP4、SPmax、CFG 并行、patch pipeline 等),任意组合。
- Policy Interface:Scheduling policy 是可插拔的 (EDF, SRTF-SP1, …);simulator + cost model 用于策略预筛选。
- Model Adapters:将 vLLM-Omni 现有 DiT 模型接入 GF-DiT。
- Layout-Aware Artifact Migration:迁移 KV/latent 时按新 layout 复制/切分对应 artifact。
3.3 Group-Free Collectives (GFC)
问题:NCCL 依赖预建 process group,形成 SP4→SP2 之类的动态子组需要昂贵初始化。
方案:
- Scope & Ordering Assumptions:约束调度器只在任务边界改变组,保证局部有序。
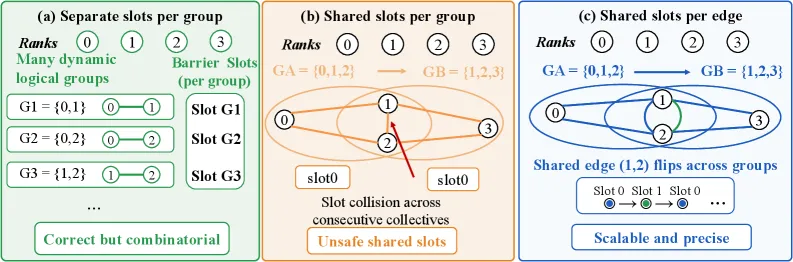
- Symmetric Buffers + Logical Groups:所有 rank 共享同一固定对称缓冲区结构,逻辑组由元数据描述而非 communicator 对象。
- Edge-Based Agreement:重叠组通过”边协商”取代额外的每组 slot,避免组合爆炸。
- Backend-Aware Execution:可复用底层 NCCL kernel 或直接调用低层 primitive。
3.4 调度策略
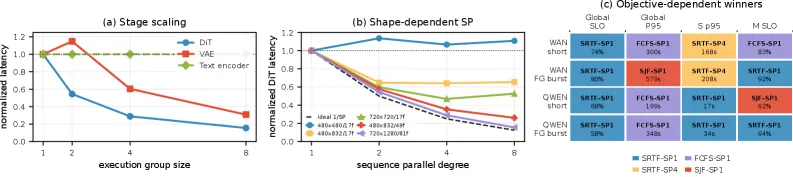
- EDF:按 deadline 排 trajectory task,用估计完成时间从 layout 池选并行度。
- SRTF-SP1:短任务优先,SP1 保并发。
- SRTF-SPmax:短任务优先,大并行组减执行时间。
- FCFS-SP1 / FCFS-SP4 / Legacy:静态 baseline,用于对比。
Simulator + cost model 允许在真实运行前对策略排序。
四、核心创新
| 创新点 | 说明 |
|---|---|
| 并行度作一等资源 | 首次把 DiT serving 中 GPU 并行度视为可动态调度资源 |
| Trajectory Task 抽象 | 请求分解为可独立调度的 encoding/decode/单步 denoising 任务,每步都是重调度点 |
| Group-Free Collectives | 对称缓冲 + 边协商替代 NCCL 进程组,动态组建立 778 ms → 60 μs |
| 策略可编程运行时 | EDF/SRTF/SPmax 等作为 policy 层选择;simulator 供预筛 |
| Layout-aware artifact migration | 支持 KV/latent 在不同 layout 间的高效迁移 |
五、实验结果
测试床:4-GPU H20 与 4-GPU A100;模型 Wan2.2、Qwen-Image 等主流 DiT。 工作负载:short workload + foreground-burst workload(S/M/L 请求混合)。 Baseline:Legacy(vLLM-Omni 静态并行)、FCFS-SP1、FCFS-SP4、SRTF-SPmax 等。
主结果
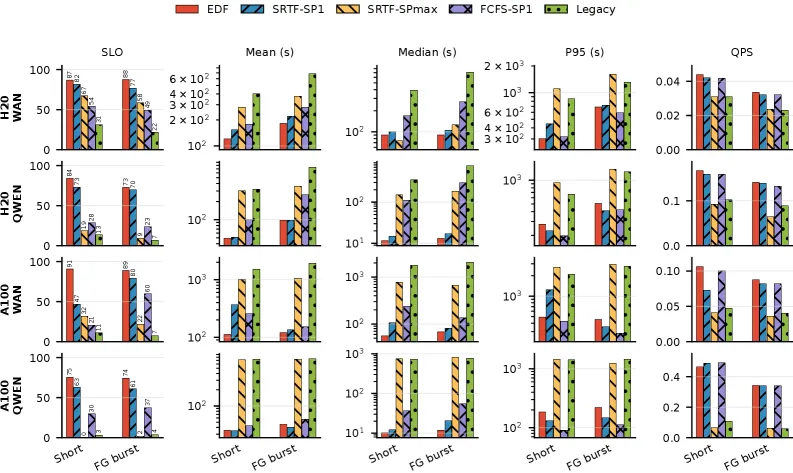
- 相比 Legacy:吞吐提升最多 6.01×,mean latency 降低最多 95.3%,SLO 违约率降低最多 89.6%。
- EDF 是所有 SLO 场景赢家:A100 Wan2.2 foreground burst SLO attainment 7.5% → 88.8%;H20 Qwen-Image foreground burst 6.2% → 72.8%。
- Legacy 与 SRTF-SPmax 在 A100 Qwen-Image foreground burst 只能完成 37% 与 39% 的请求(客户端超时),而其它策略几乎全部完成。
- 不同目标不同赢家:SRTF-SP1 在若干 Qwen-Image 上给出最低 mean latency;FCFS-SP1 在 A100 Qwen-Image short 上给出最低 P95。这支持”策略层选择”设计目标。
运行时开销
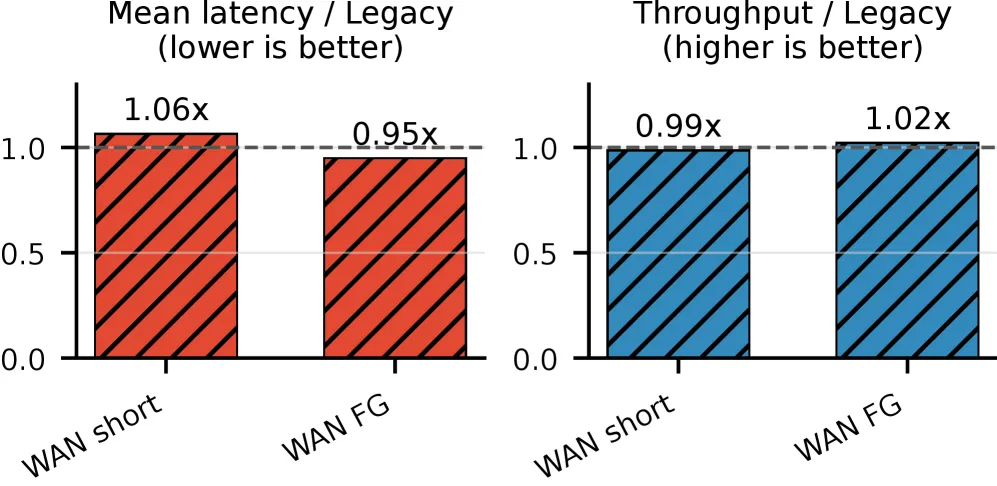
FCFS-SP4 让 GF-DiT 与 Legacy 使用同一执行顺序与 layout;吞吐/mean latency 与 Legacy 匹配,说明可编程性零开销。
GFC vs NCCL
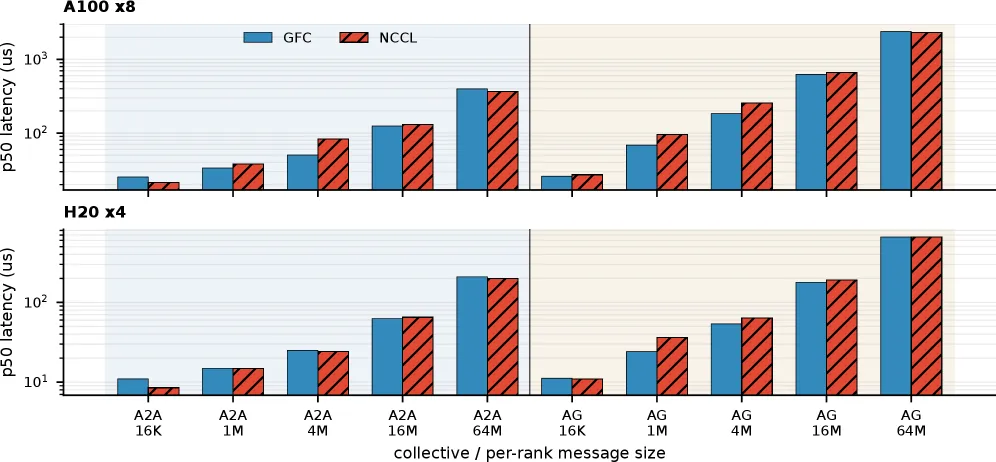
- 组建立:778 ms → ~60 μs(约 1.3 万倍)。
- 稳态:A100 4 MB all-to-all 83.0 μs → 50.4 μs;H20 1 MB all-gather 36.5 μs → 24.1 μs。小消息略慢(同步/缓冲开销尚未优化)。
到达率扩展
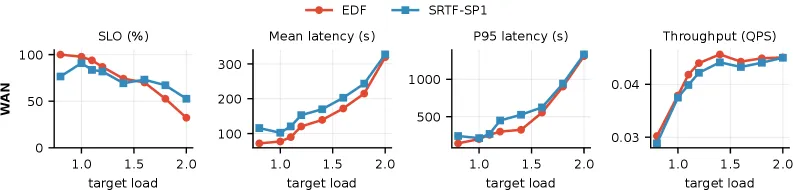
- 低/中负载 EDF 更好;持续过载时 EDF 反而用大 SP 组反复救援 tight-deadline,SRTF-SP1 通过保 SP1 并发完成更多请求,SLO attainment 反超。表明弹性并行的收益随负载而变。
仿真器保真度
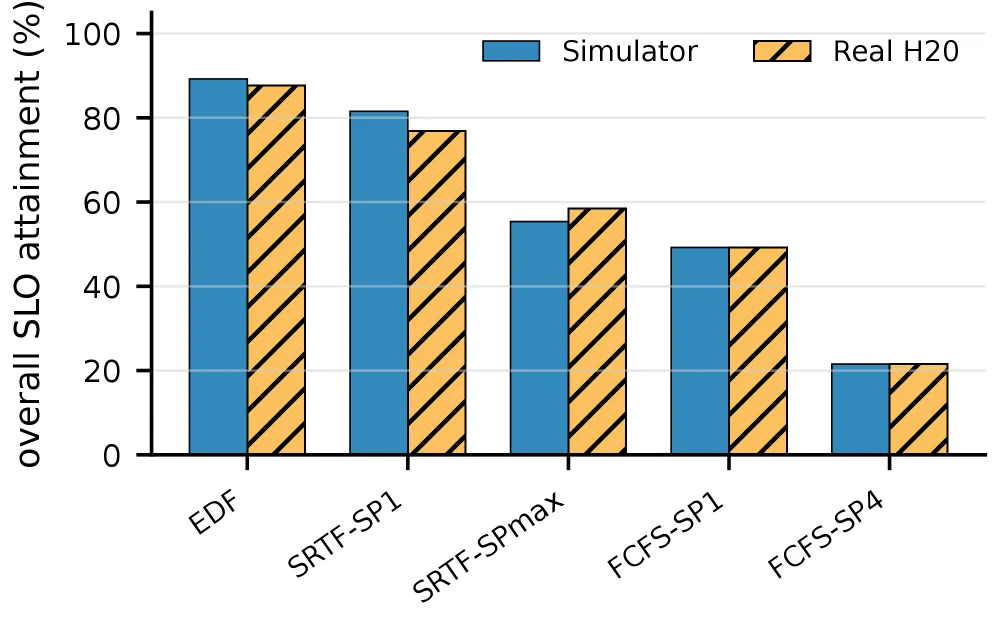
- 5 种 policy 的 SLO attainment 仿真与真机差 ≤ 4.7 pp,可用于策略筛选。
六、总结
- 核心贡献:为 DiT 服务提出”并行度=资源”的调度视角;trajectory task + GFC + 可编程 policy 使弹性并行落地。
- 技术影响:让静态 SP1/SP4/SPmax 的选择成为可组合的策略问题;GFC 展示了 collective library 之外的另一种”数据面通信抽象”。
- 局限性:目前只在 4-GPU H20/A100 上验证,超大集群与跨节点通信未评估;GFC 小消息慢;重调度粒度到 denoising step,未探索 DiT 层内更细粒度。
七、参考资源
- 论文原文:arXiv:2606.13501
- 实现基线:vLLM-Omni、SGLang Diffusion、FastVideo
- 相关系统:TridentServe、TetriServe、GenServe、DiffServe、PatchedServe
- 通信库:NCCL、RCCL、UCC、UCCL、MSCCL、DeepEP