M*: A Modular, Extensible, Serving System for Multimodal Models
M* 提出 Walk Graph 抽象把组合式多模态模型建模为组件级 dataflow 图 + 命名 Walks;请求成为图上的遍历。四种组合原语(Sequential/Parallel/Loop/DynamicLoop)与流式边策略统一表达 UMM、Omni、SpeechLM、VLA 与世界模型。BAGEL T2I 端到端延迟低 20%,Qwen3-Omni TTS RTF 快 2.9×、吞吐高 2.7×,V-JEPA 2 机器人 rollout 提速 12.5×。
M*: A Modular, Extensible, Serving System for Multimodal Models
一、论文概述
| 项目 | 内容 |
|---|---|
| arXiv ID | 2606.12688 |
| 标题 | M*: A Modular, Extensible, Serving System for Multimodal Models |
| 作者 | Atindra Jha, Naomi Sagan, Keisuke Kamahori, Irmak Sivgin, Rohan Sanda, Steven Gao, Mark Horowitz, Luke Zettlemoyer, Olivia Hsu, Jure Leskovec, Baris Kasikci, Stephanie Wang |
| 机构 | Stanford · University of Washington · CMU |
| 提交日期 | 2026-06-10 |
| 学科 | cs.LG; cs.AI; cs.DC |
| 链接 | https://arxiv.org/abs/2606.12688 |
二、核心思想
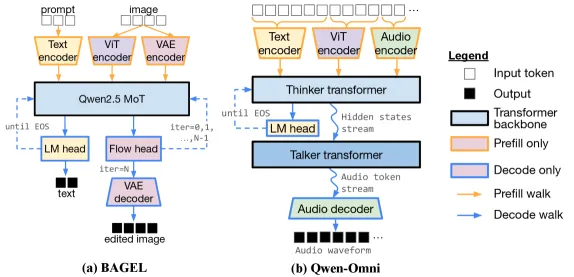
问题定义:新一代组合式多模态模型(Unified MM、Omni、SpeechLM、VLA、World Model)由视觉编码器、语言主干、扩散/流头、音频编解码器、动作生成器与世界预测器组合而成。现有 LLM serving 栈(vLLM、SGLang)为自回归文本设计,无法自然表达跨 stage 循环、内部并行(CFG)、Thinker–Talker 流水线、模态相关执行路径等模式。stage-DAG(vLLM-Omni、SGLang-Omni)也无法捕捉非 AR 循环、stage 内并行、任务差异化路径。
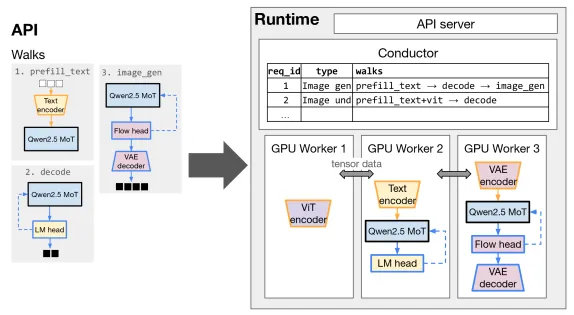
解决方案:M* 提出 Walk Graph 抽象。模型作者只需声明 : 是组件级计算图, 是命名 Walk 集合;每个请求执行为对图的一次或多次遍历。运行时负责调度、批处理、张量传输、KV cache 管理、TP、CUDA graph、continuous batching 等所有物理执行。
三、技术架构 / 方法
3.1 Walk Graph API
模型描述为 ,,。请求依据每模型的状态机在完成一个 Walk 后决定下一个 Walk。四种组合原语:
- Sequential:串接子图,前者输出→后者输入。
- Parallel:并发扇出,例如 CFG 三分支。
- Loop:有界迭代,per-iter 与累积输出。
- DynamicLoop:可提前退出的循环(EOS / rollout horizon)。
Streaming edges(StreamingGraphEdge)与三种 ChunkPolicy:
- Fixed():每 个触发一次。
- SlidingWindow(, ):缓冲 后触发,前进 。
- LeftContext(, ):为每 帧块预置 帧左上下文。
3.2 抽象对比
| 系统 | 图节点 | 组合原语 | 每模型执行路径 | 循环 | 放置粒度 |
|---|---|---|---|---|---|
| vLLM-Omni | Engine-instance stage | Flat DAG | prefill+decode | stage 内 | stage |
| SGLang-Omni | Worker-pool stage | Flat DAG | prefill+decode | stage 内 | stage |
| M* | 模型组件 | Seq / Par / Loop / Stream | 灵活 | 任意子图 | 组件(可选 Walk) |
3.3 BAGEL 图示例
7 个节点(vit_encoder、vae_encoder、LLM、LLM_cfg_text、LLM_cfg_img、combine_cfg、vae_decoder)和 6 个 Walk。image_gen = Sequential(Loop(49, Sequential(Parallel(3 CFG branches), combine_cfg)), vae_decoder)。
3.4 Walk Graph 解锁的能力
- 模态感知调度:调度器仅追踪请求当前 GraphNode 与 Walk,只执行完成请求所需组件。
- 灵活并行:TP 声明在 GraphNode 层;Parallel 原语原生支持 CFG、多路 MPC、多分支采样等。
- 灵活放置:per-node 的 GPU rank 映射;同一逻辑节点在不同 Walk 中可选不同 rank,天然支持 PD 分离与独立扩缩容;同 rank 下自动多路复用一份 LLM。
- 循环优化:Loop / DynamicLoop 让 CUDA graph、continuous batching 对循环透明;调度器可交错 flow step 与 AR decode。
- 可扩展的流式策略:三种 ChunkPolicy 覆盖评估中所有模型。
3.5 运行时
HTTP Server + 每 server 一个 Conductor(管理 per-request Walk 状态、通过 ZeroMQ 派发工作)+ 每 GPU 一个 Worker(执行本地子图,直接把张量路由到下游 worker)。跨 rank 图边即 IPC 张量传输,流式边在消费端实例化 per-request buffer。集成 paged attention、CUDA graph、continuous batching、fused projection、FlashInfer speculative planning。
四、核心创新
| 创新点 | 说明 |
|---|---|
| Walk Graph 抽象 | 把组合式多模态模型形式化为 (计算图, 命名 Walks) + 状态机 |
| 四种组合原语 | Sequential / Parallel / Loop / DynamicLoop 表达所有主流多模态执行结构 |
| 流式边 + ChunkPolicy | Fixed / SlidingWindow / LeftContext 覆盖所有实测流式模型 |
| 组件级放置 | per-GraphNode 映射到 GPU rank;跨 Walk 可差异化,实现天然 PD 分离与共享 |
| 循环优化传承 | CUDA graph、continuous batching、paged attention 对 Loop/DynamicLoop 透明 |
| 单一配置多任务 | 一份配置同时高效服务 T2I / I2I / I2T,突破 vLLM-Omni 两配置权衡 |
五、实验结果
硬件:single 4×H100 或 8×H200;per-request p50/p95。
BAGEL-7B(1024×1024,50-step flow)
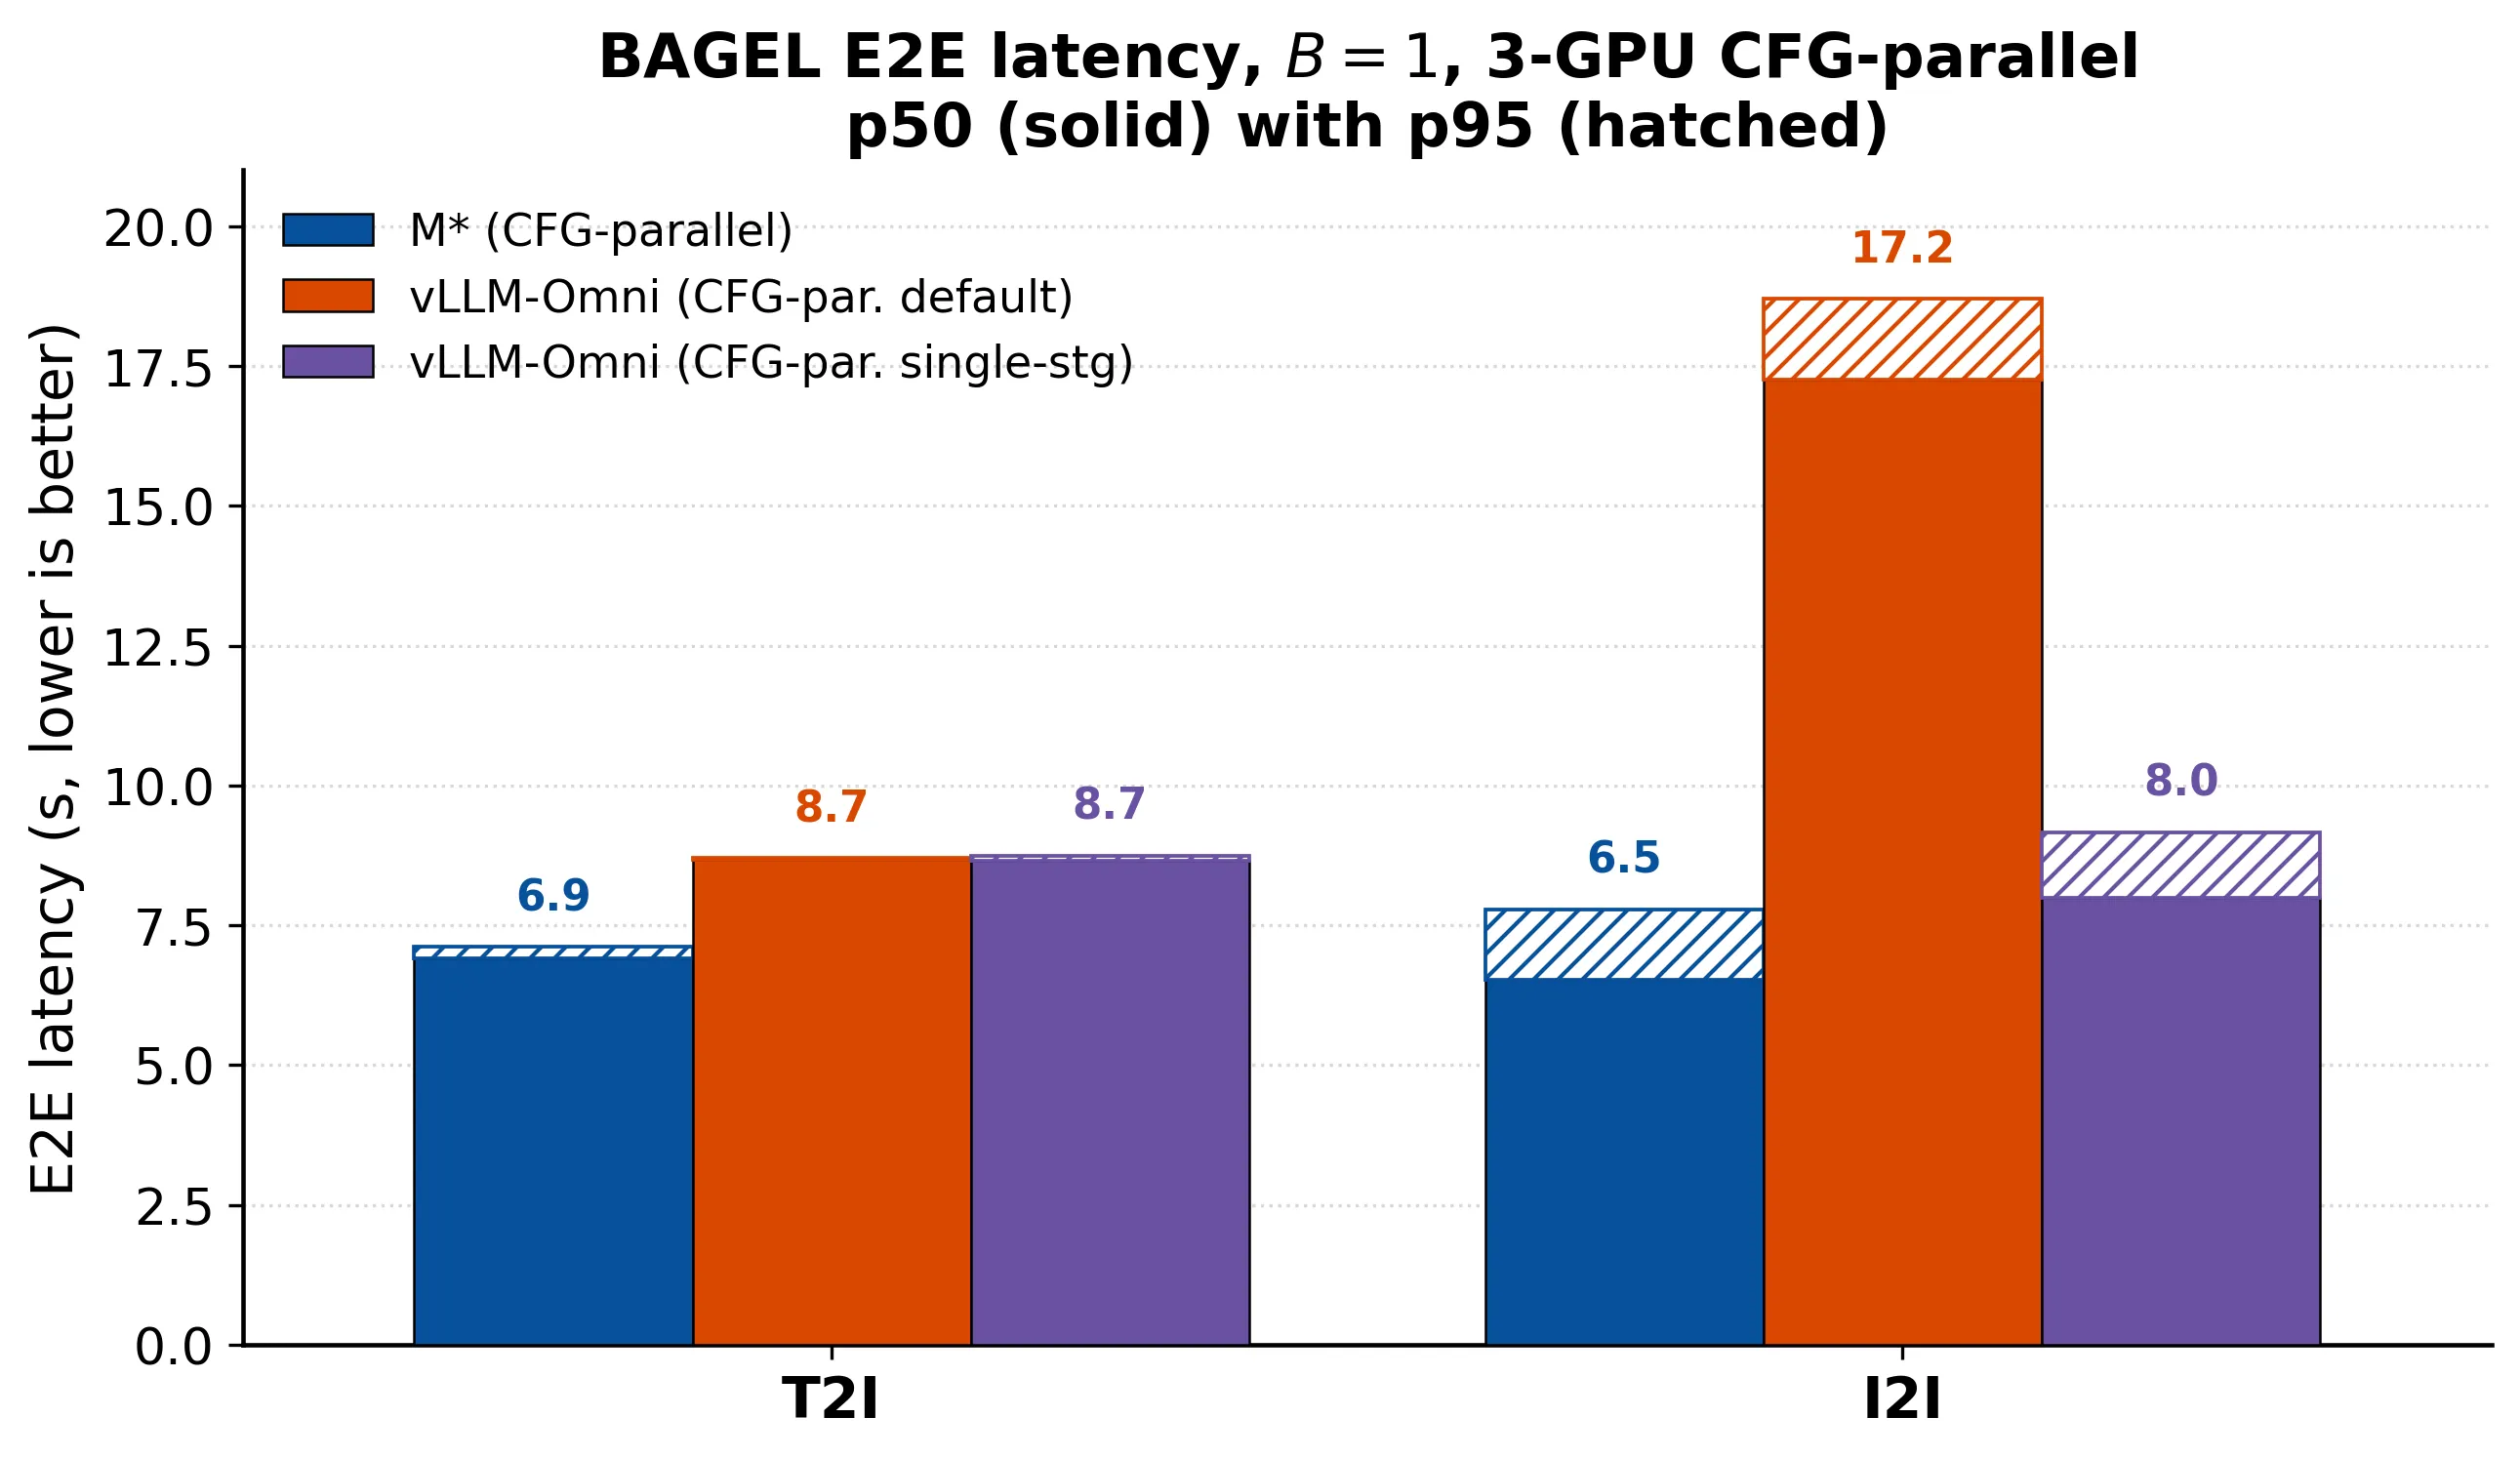
- 3-GPU CFG 并行 T2I():p50 E2E 相对单 stage vLLM-Omni 1.25×,I2I 1.22×。
- 与默认(Thinker + DiT 分离)vLLM-Omni 比:I2I 优势扩大到 2.64×(省去 Thinker→DiT KV 传输)。
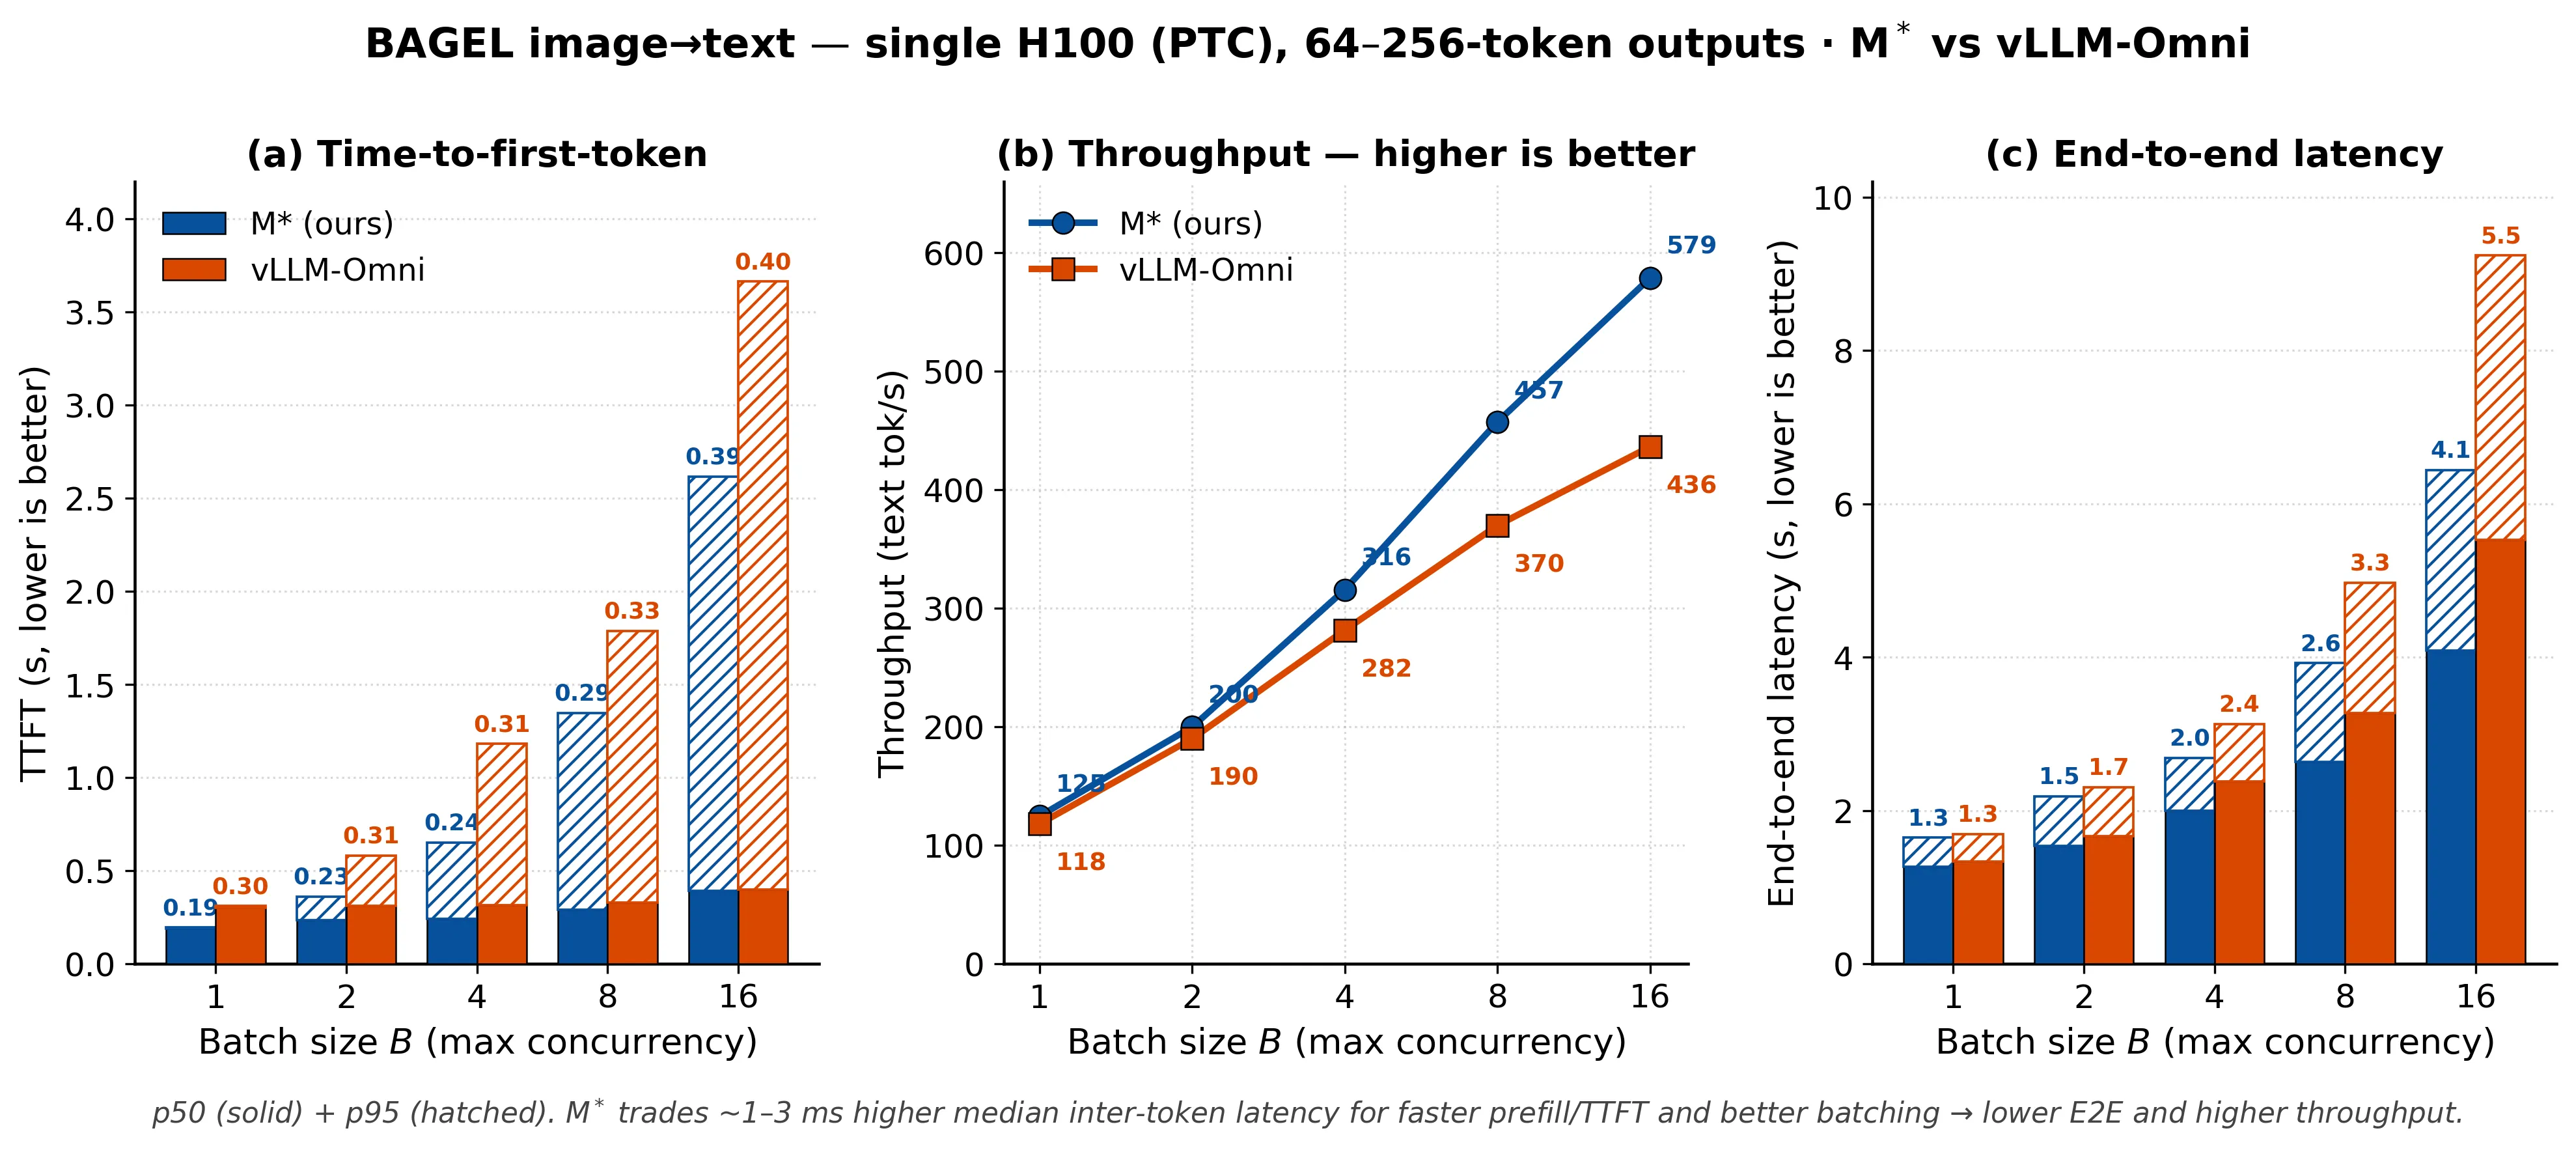
- I2T(single H100,output 64–256): 时吞吐 +32.7%,E2E ↓25.5%,p50 TTFT 33% (B=1) → 14% (B=16),p95 TTFT ↓28%。
- 与 vLLM-Omni 两配置对比:单 M* 一份配置在 T2I/I2I/I2T 均更优;
vLLM-Omni-default强于 T2I/I2T 但 I2I 差,single-stage相反且 41 tok/s(默认的一半),无 continuous batching / streaming。
Qwen3-Omni-30B(Seed-TTS)
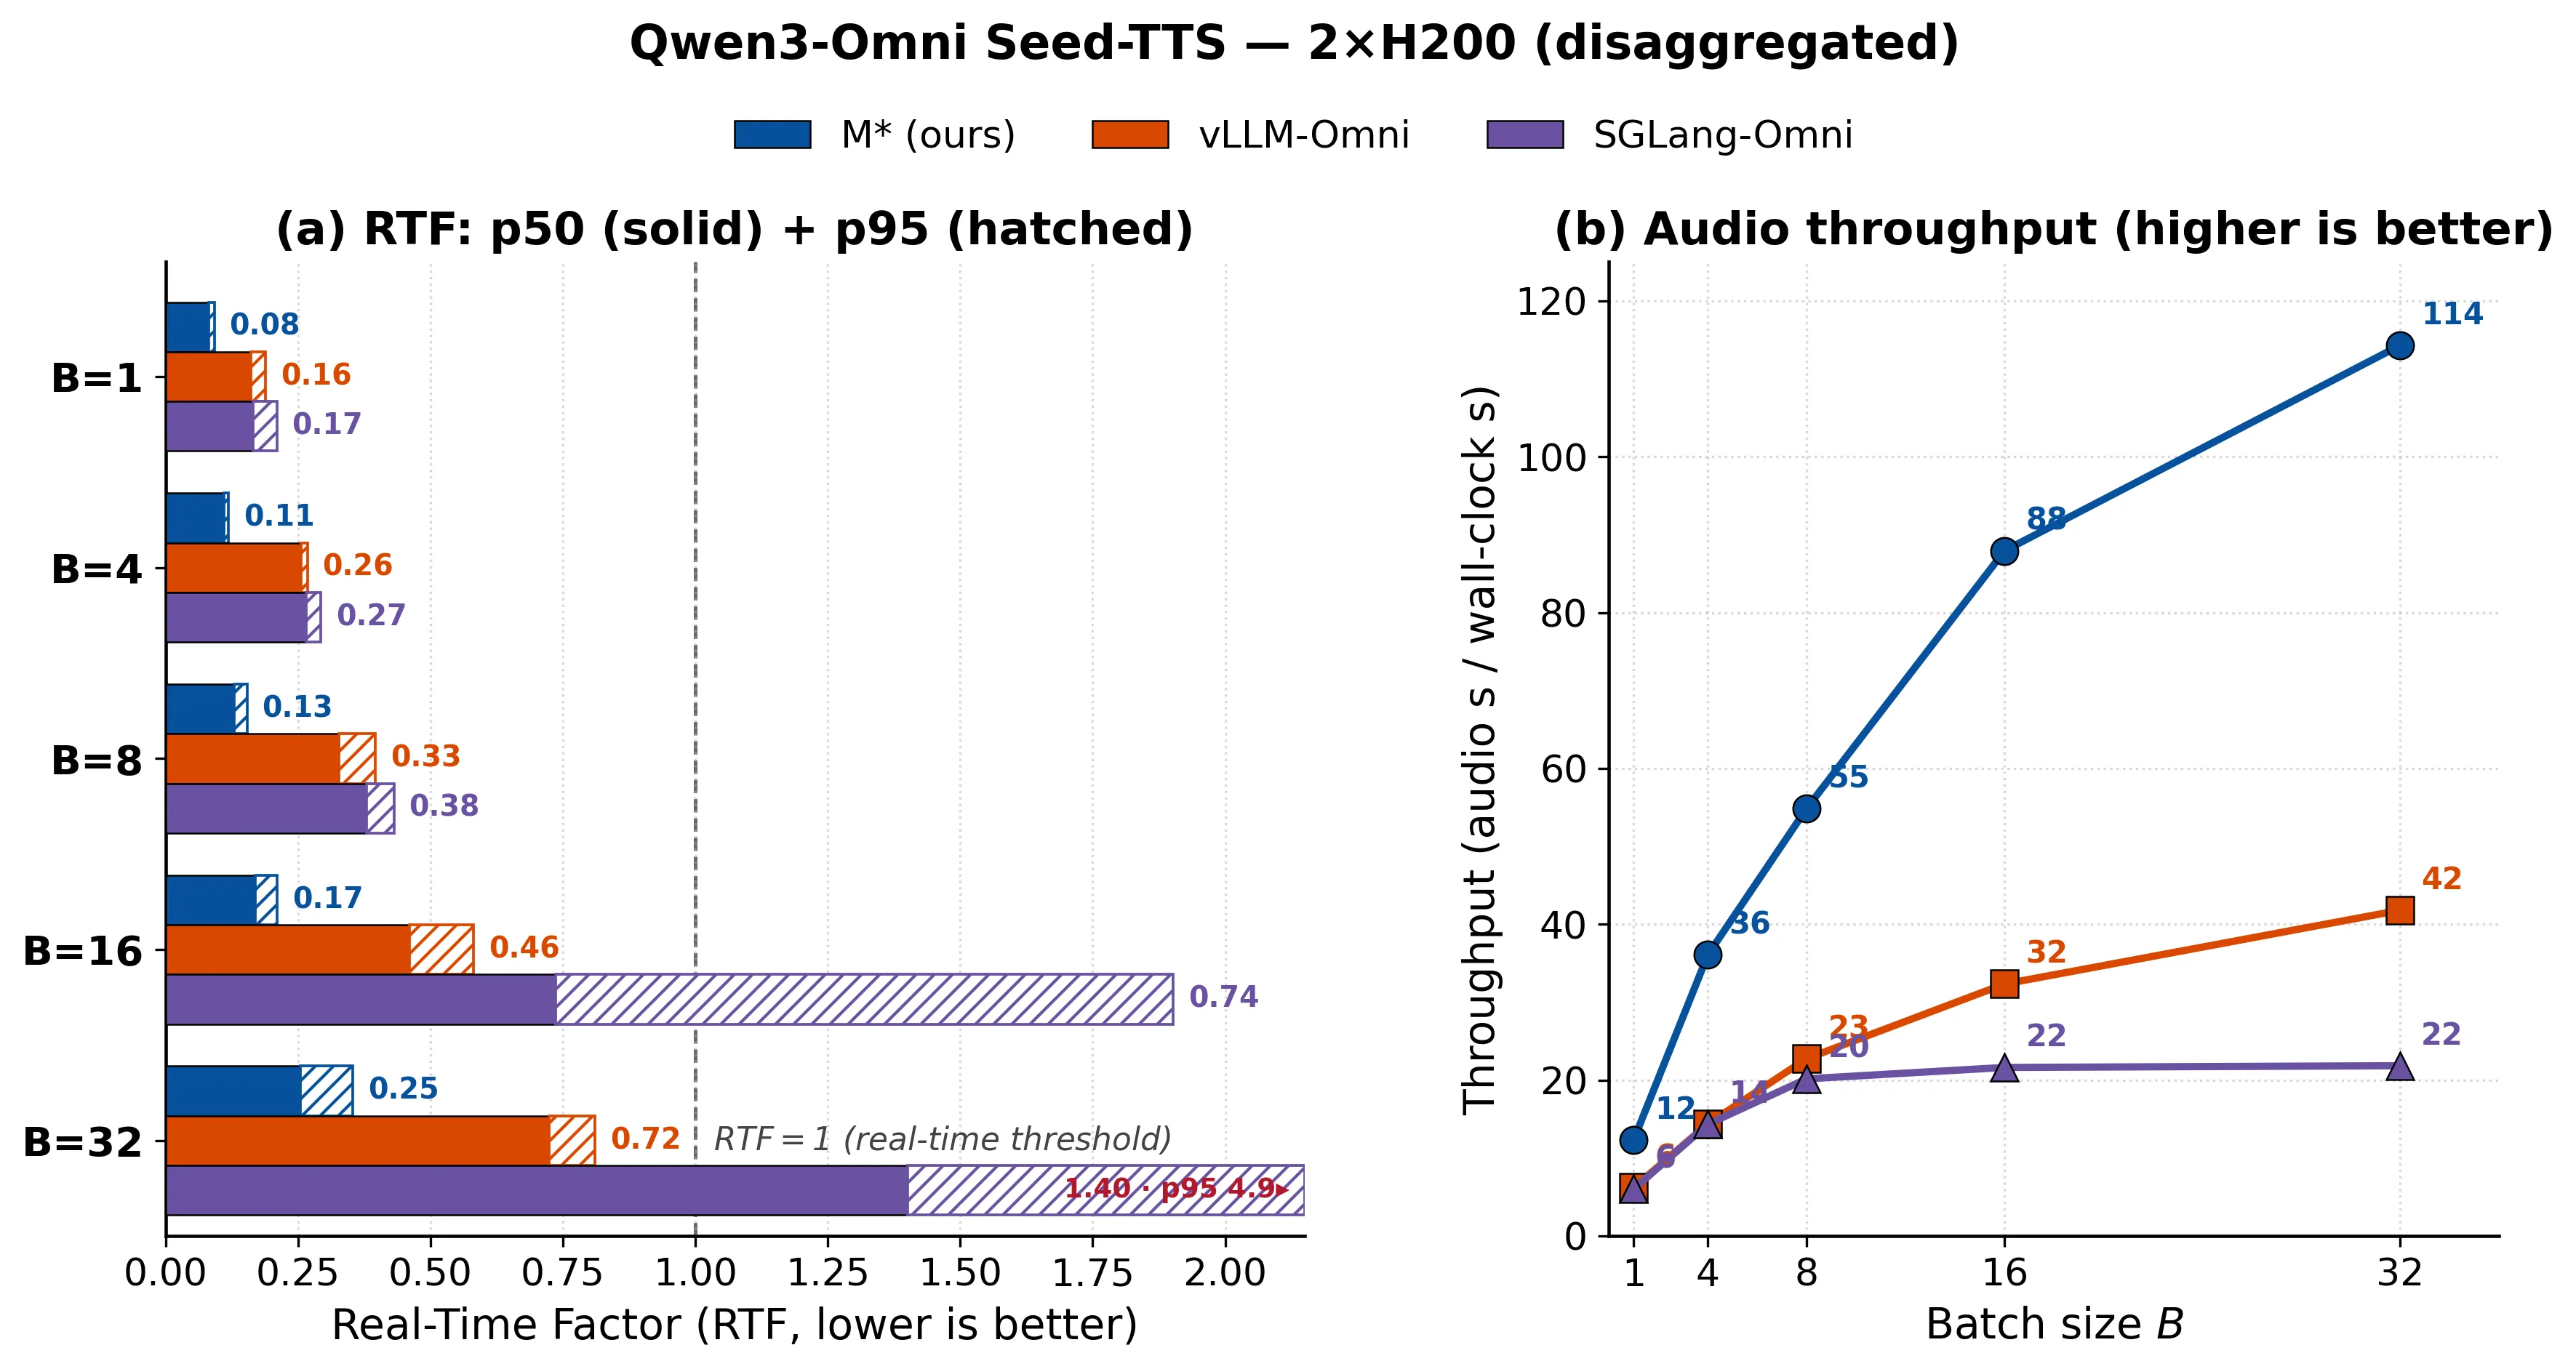
- 2× H200: 时 vs vLLM-Omni RTF 快 2.9×、吞吐 2.7×;vs SGLang-Omni RTF 4.0×。
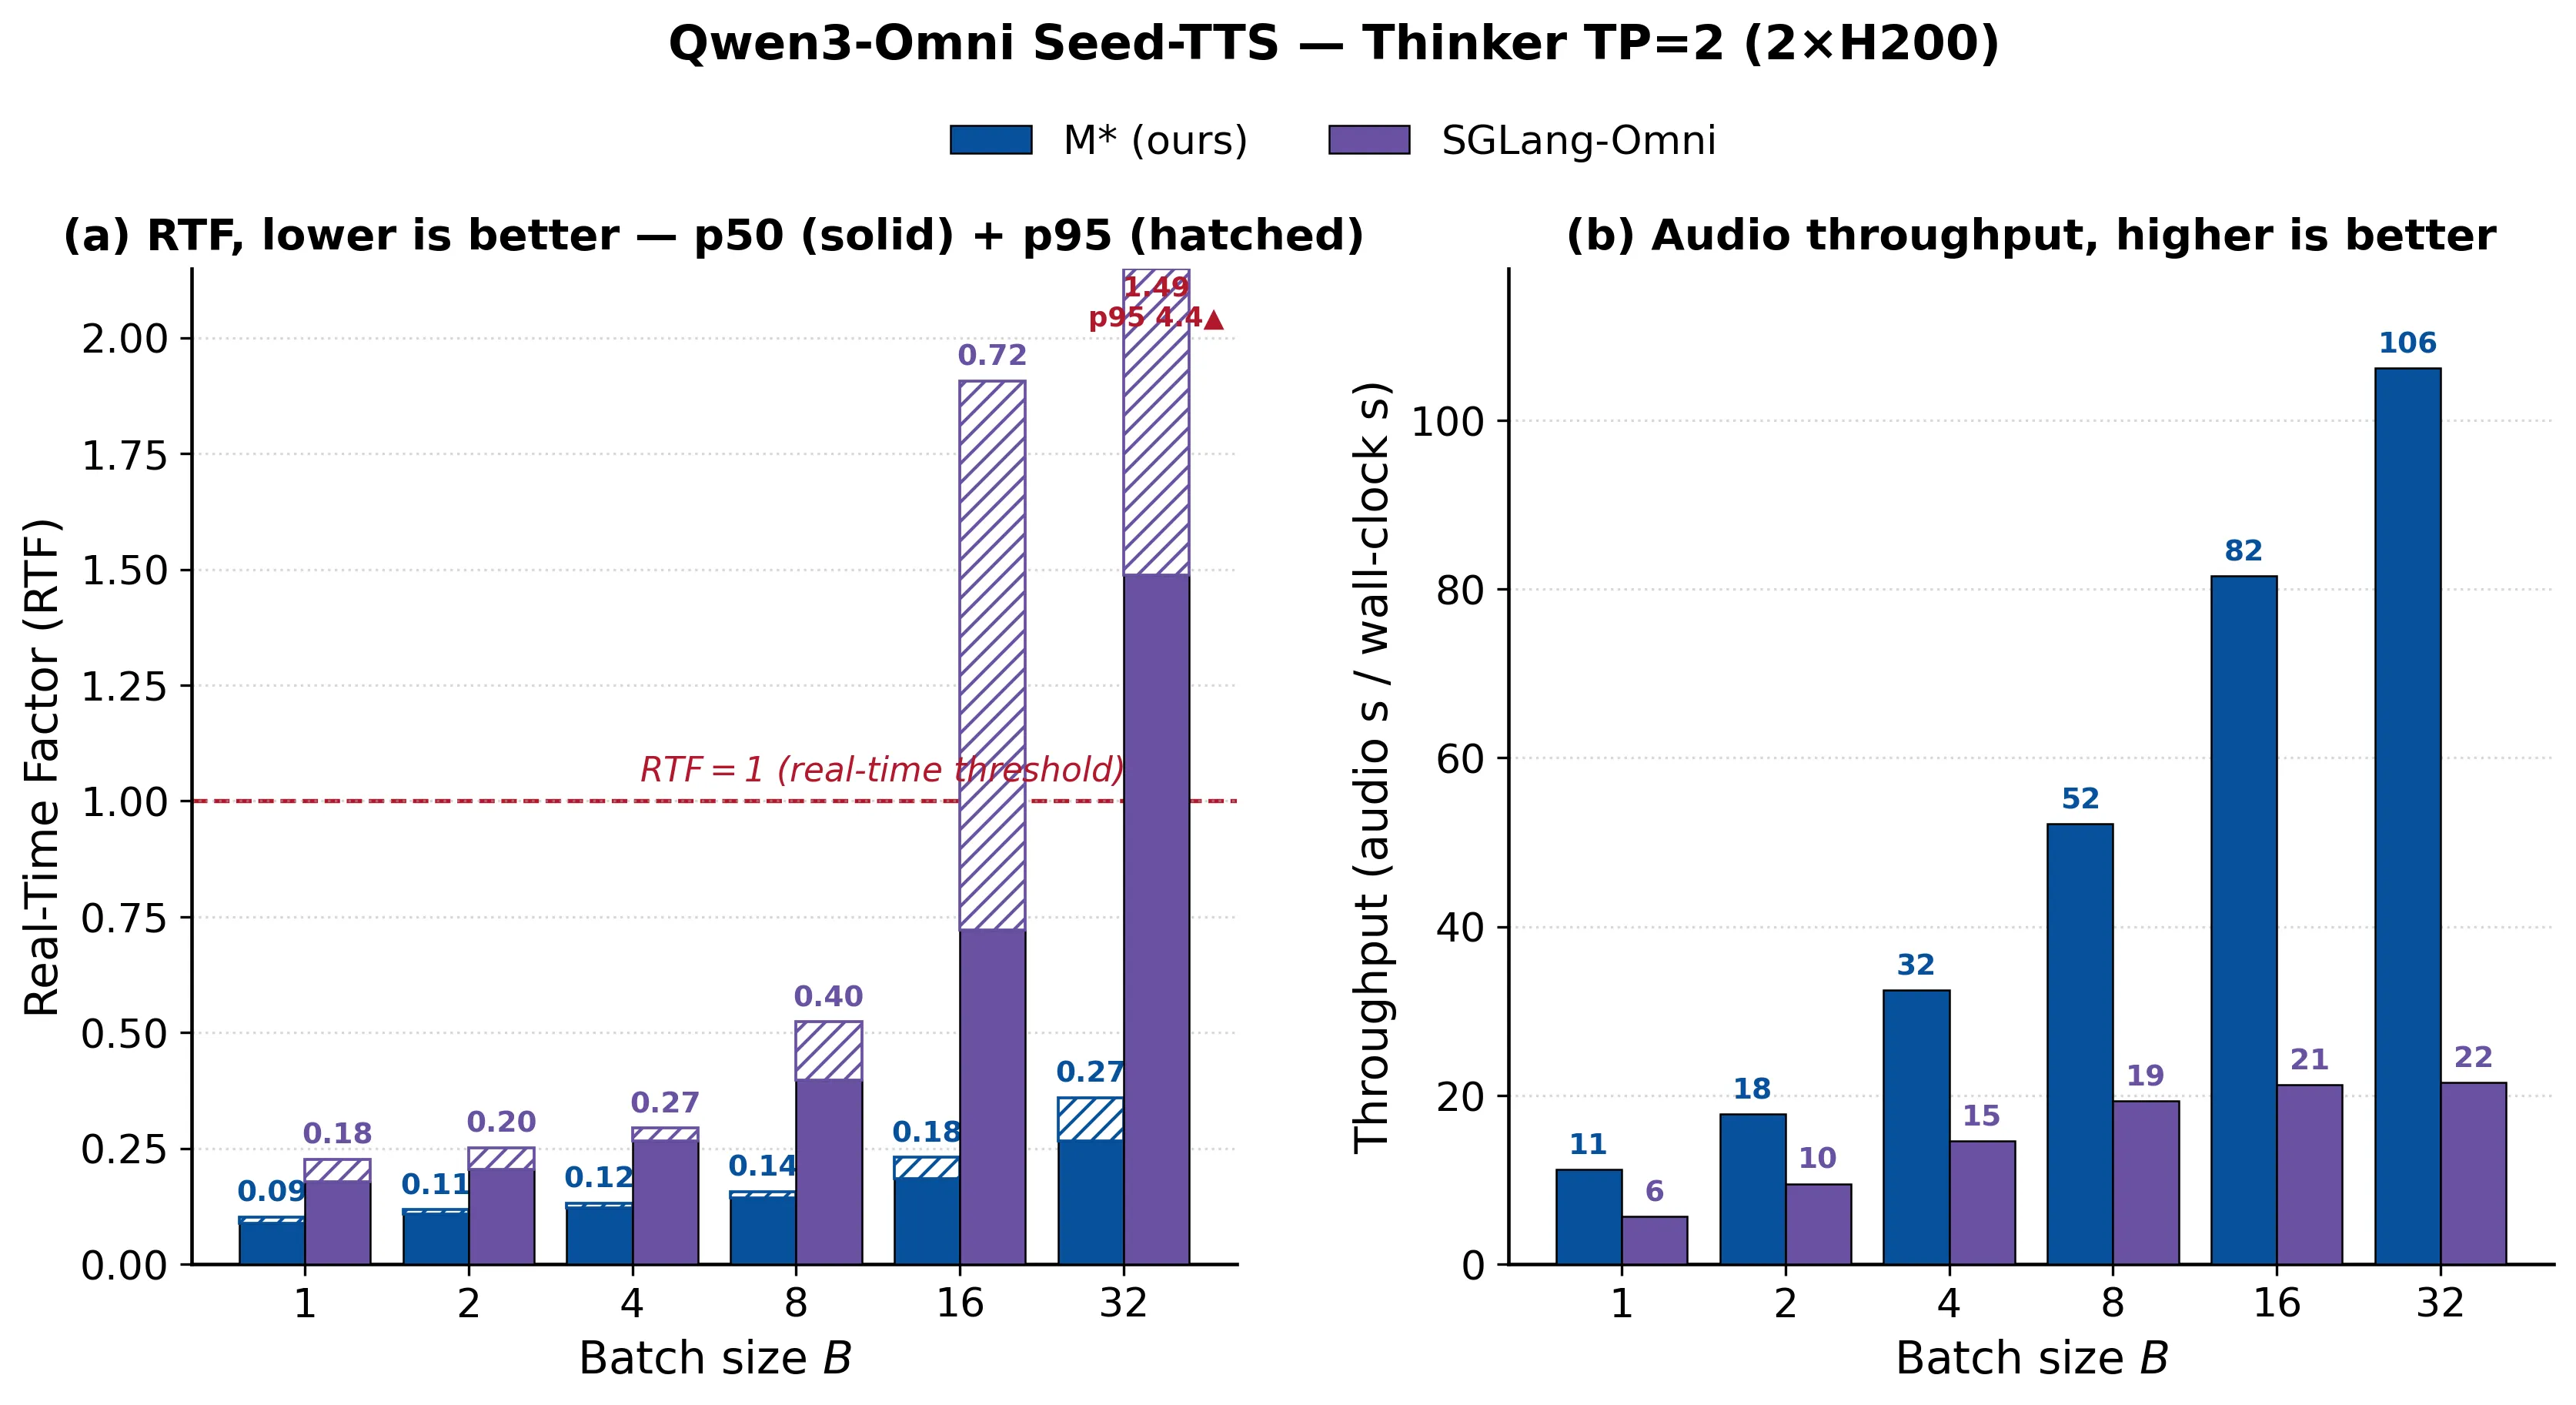
- Thinker TP=2 (3× H200):RTF 与吞吐相对 SGLang-Omni 保持相似领先。
- 优势来源:Talker 及 multi-token predictor 循环整体 CUDA graph 捕获;Talker+Code2Wav 同 Worker 进程共存,无 IPC。
Orpheus-3B(single H200,5 trials)
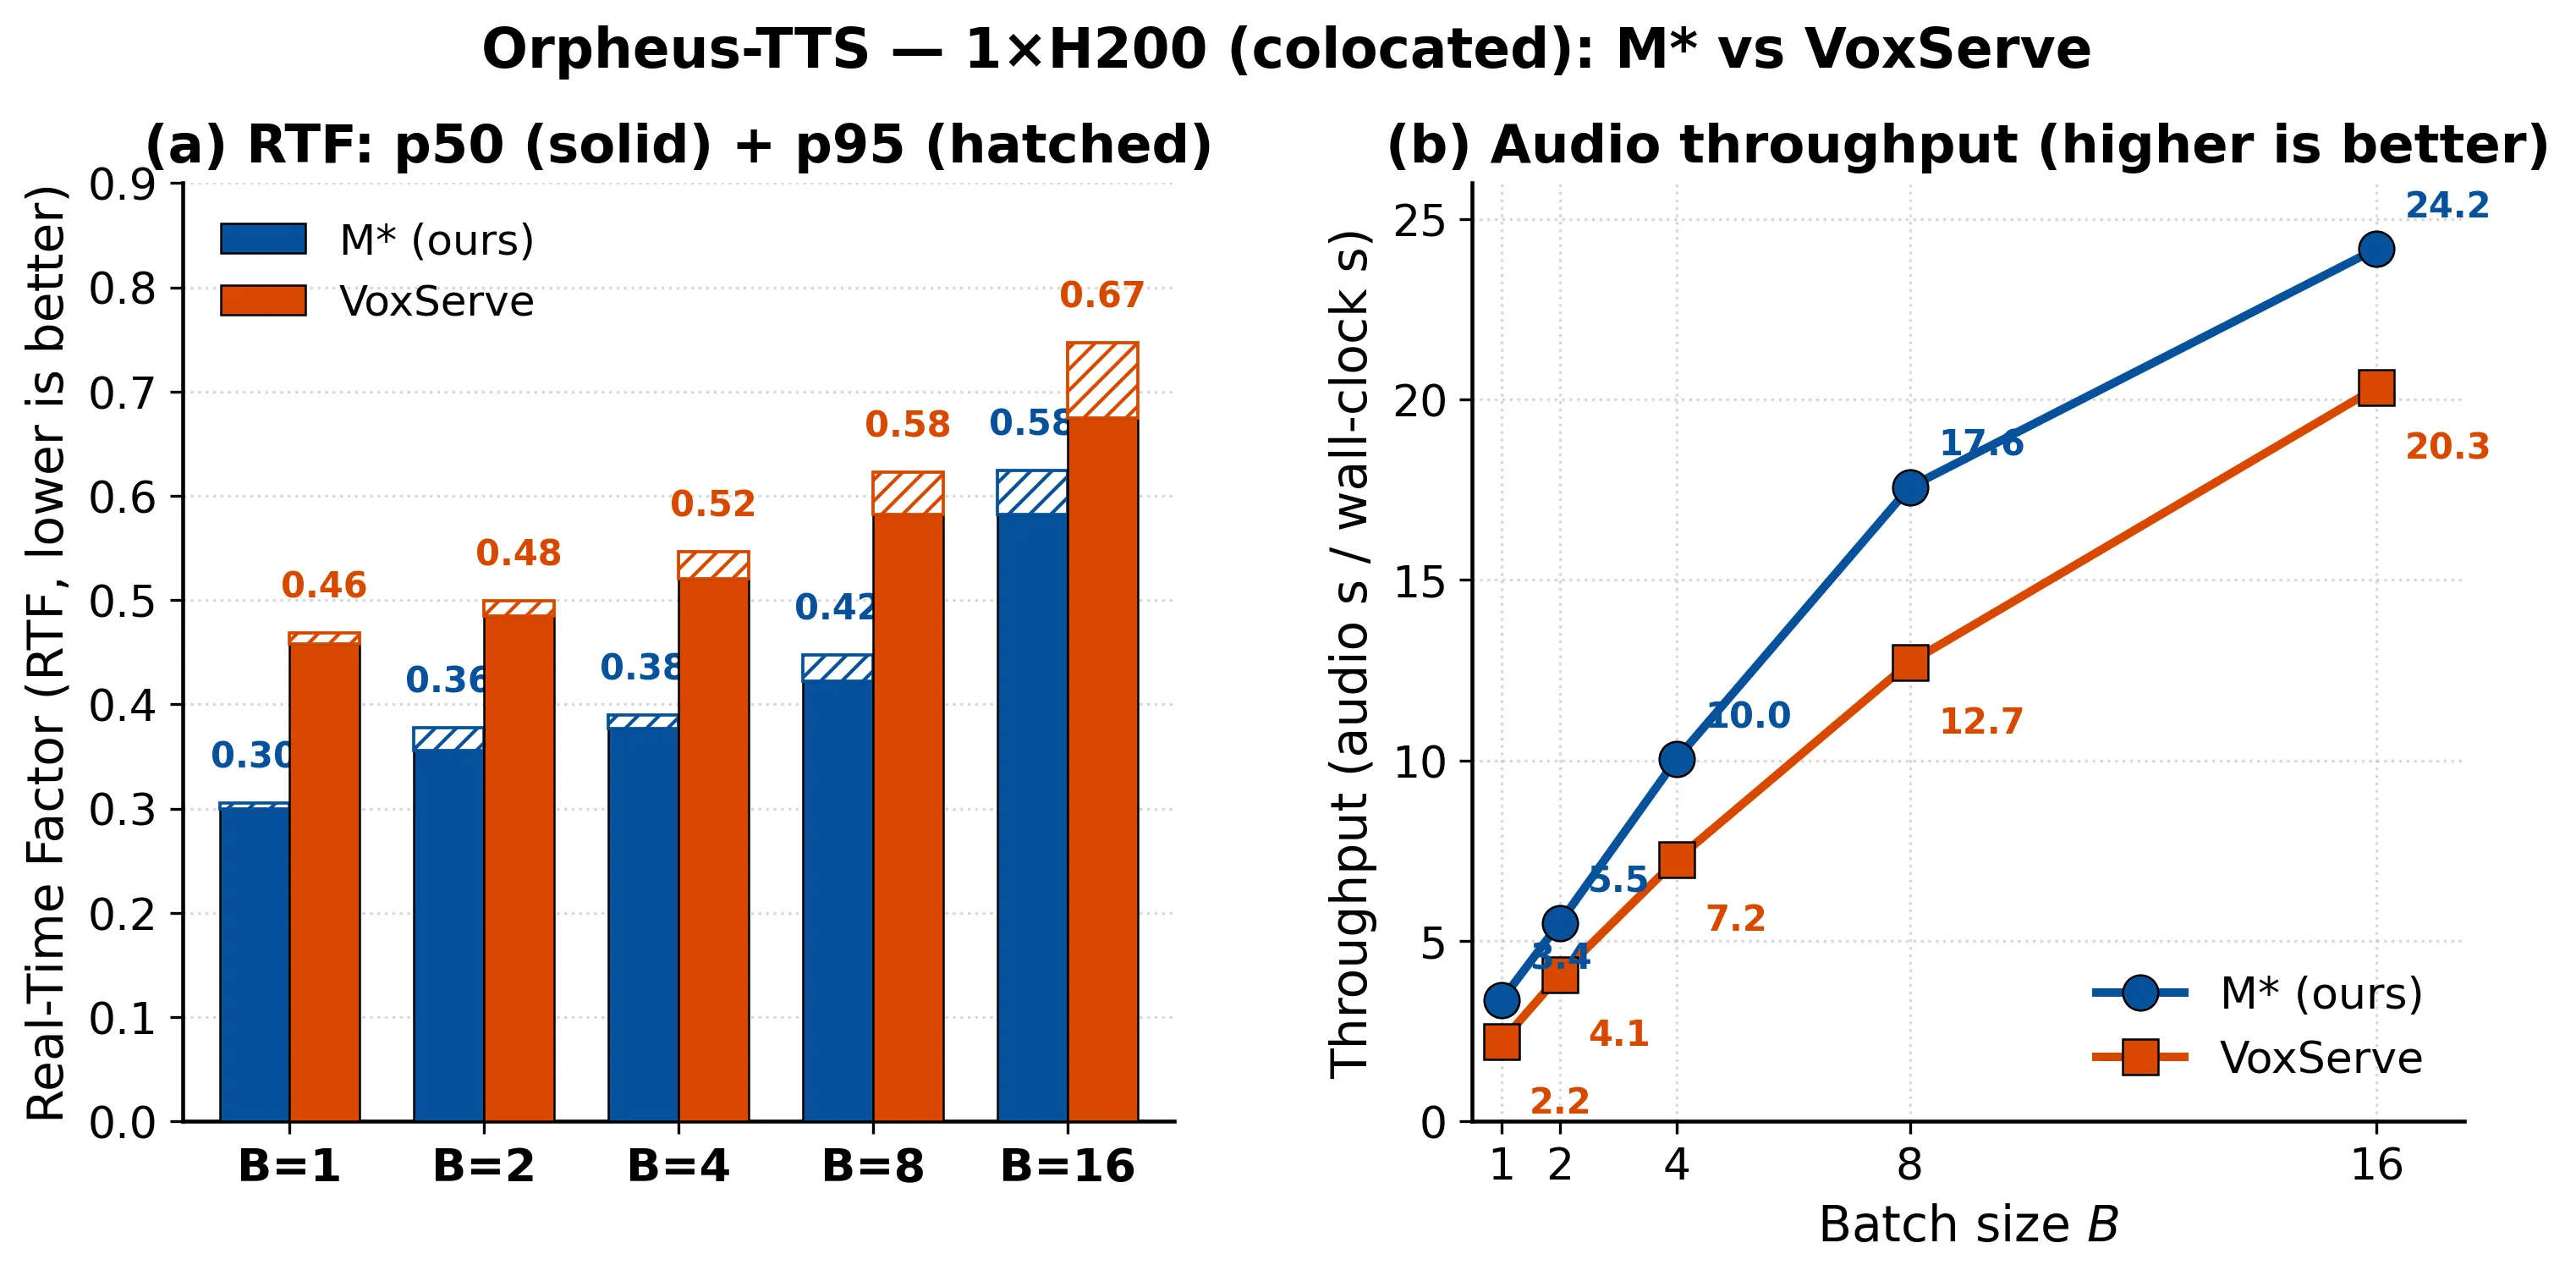
- 相对 VoxServe: p50 RTF ↓ 13.6%;吞吐提升 20% () 至 52% ()。
V-JEPA 2-AC(world model rollout, H100, DROID)
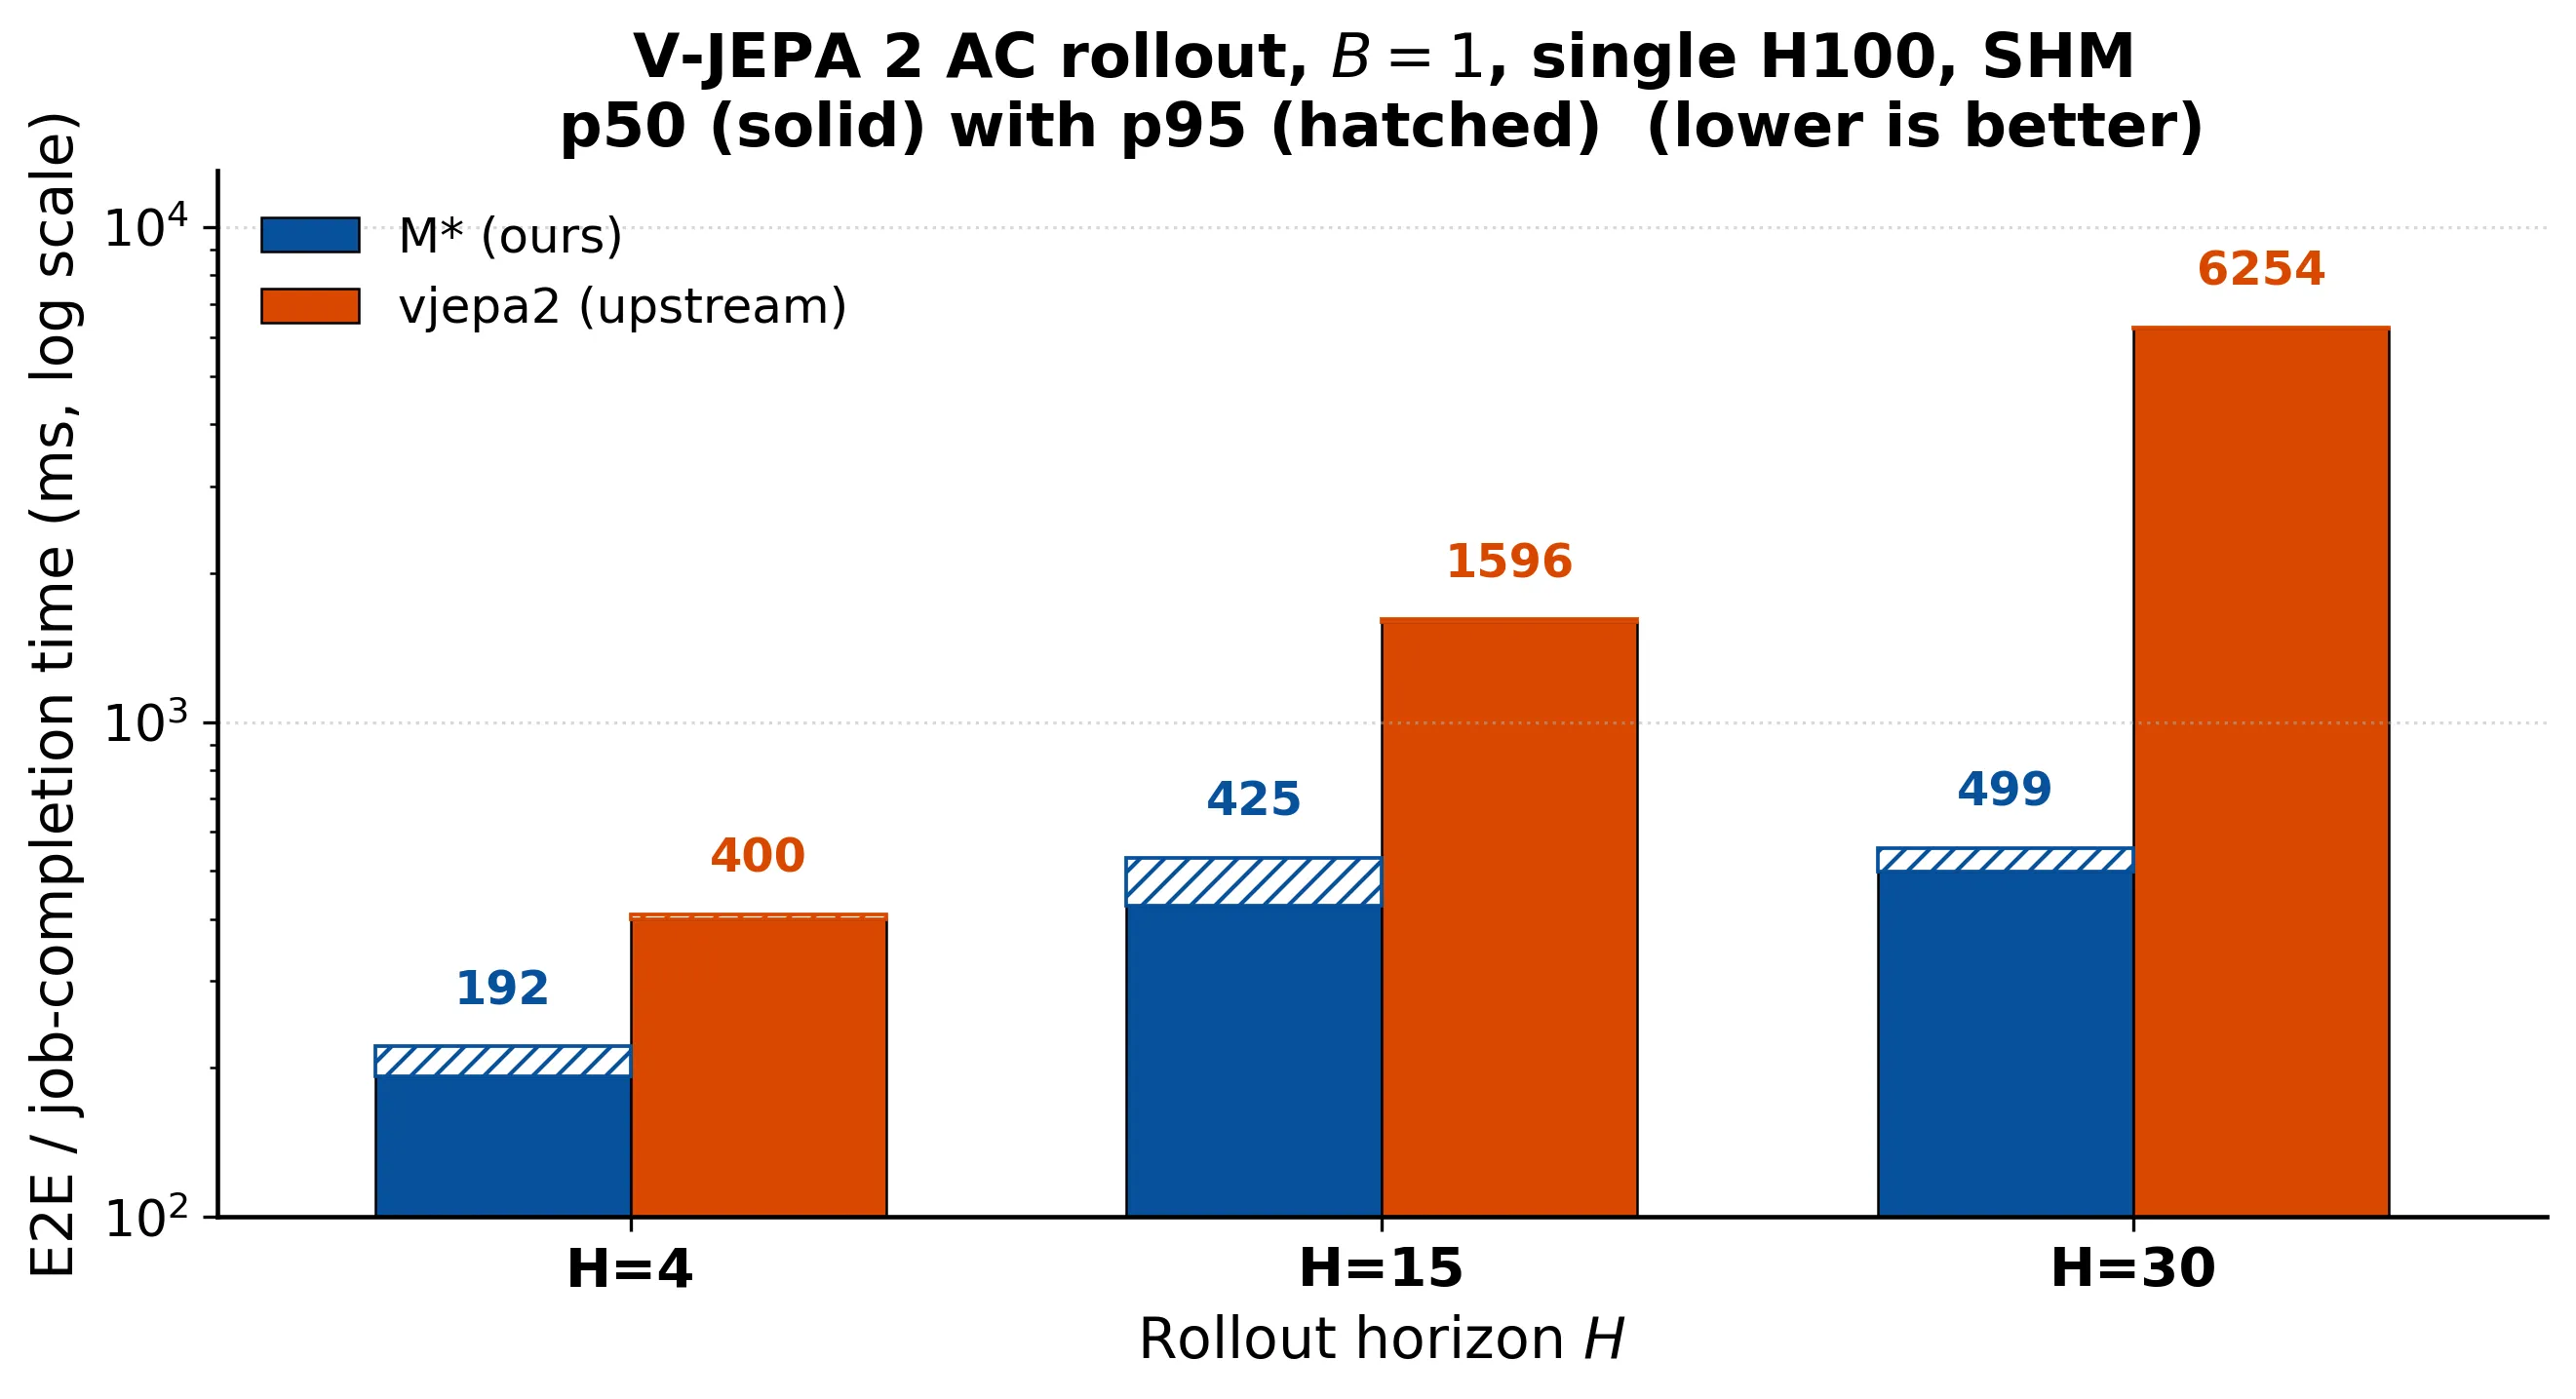
- 相对 Meta 原生实现,:p50 2.08×;:3.76×;:12.5×。
- 提速源自 DynamicLoop + paged-attention KV cache,避免重复 prefill。
六、总结
- 核心贡献:Walk Graph 抽象把”模型架构”与”运行时”彻底解耦,让 20% 端到端延迟改进(BAGEL T2I)、2.9×/2.7× RTF/吞吐(Qwen3-Omni TTS)、12.5× rollout 加速(V-JEPA 2)成为通用运行时优化的自然收益。
- 技术影响:为组合式多模态模型建立”day-zero”的服务抽象,让 CFG 并行、Thinker–Talker 流水线、世界模型 rollout 在同一系统统一表达。
- 局限性:图作者需理解四种原语与 ChunkPolicy 语义;跨 rank 张量传输目前依赖 ZeroMQ,跨节点性能未评估;只与两家多模态 baseline 对比。
七、参考资源
- 论文原文:arXiv:2606.12688
- Baseline:vLLM-Omni、SGLang-Omni、VoxServe、Meta vjepa2
- 模型:BAGEL-7B、Qwen3-Omni-30B、Orpheus-3B、V-JEPA 2 vitg-AC
- 数据集:VBench、Food101、Seed-TTS、DROID