Next Forcing: Causal World Modeling with Multi-Chunk Prediction
多块预测(MCP)训练框架,通过轻量辅助模块同时去噪多个未来视频块,加速世界动作模型训练与推理
Next Forcing: Causal World Modeling with Multi-Chunk Prediction
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Next Forcing: Causal World Modeling with Multi-Chunk Prediction |
| 作者 | Gangwei Xu¹², Qihang Zhang¹†, Jiaming Zhou¹⁴, Xing Zhu¹, Yujun Shen¹, Xin Yang²‡, Yinghao Xu³¹‡ |
| 机构 | ¹Robbyant, ²HUST, ³HKUST, ⁴HKUST (GZ) |
| 论文 | arXiv:2606.11187 |
| HTML | arXiv HTML |
| 主页 | https://gangweix.github.io/next-forcing/ |
| 发布 | 2026-06 (cs.CV) |
| 基于 | LingBot-VA + Wan2.2 Transformer backbone (30 layers) |
二、核心思想
问题定义
World Action Models (WAMs) 通过联合建模未来视频和动作来学习操作策略,已成为具身智能的新范式。其主导训练目标是 teacher-forced next-chunk denoising:模型以真实历史块为条件,去噪当前带噪块。
然而,这种逐块预测存在根本性缺陷——myopic supervision(短视监督)问题:
- 预测下一个块本质上是局部任务,存在 appearance shortcut(外观捷径):相邻块在视觉上高度相似,模型只需学习从干净过去块到当前块的近恒等映射,辅以少量残差修正,即可压低大部分去噪损失
- 该捷径比学习真实动力学容易得多,会吸收大量梯度信号,使模型缺乏捕获长程时间演化的压力
- 高帧率下问题尤其严重:50 fps 时相邻块的外观差距缩小到捷径几乎无损失,标准 teacher forcing 收敛显著变慢且最终精度更低
解决方案概述
Next Forcing 将局部单块目标转化为长程多块目标,迫使模型学习潜在动力学而非依赖外观捷径。这一思想在语言建模中已被验证——multi-token prediction (MTP)(DeepSeek、Gloeckle et al.)通过训练辅助模块预测多个未来 token,提升样本效率并加速推理。
将 MTP 适配到视频世界模型面临三重挑战:
- 预测目标是连续视频潜变量而非离散语言 token
- 生成通过迭代去噪而非单步采样
- 时间依赖跨越多个不同尺度的时间视野
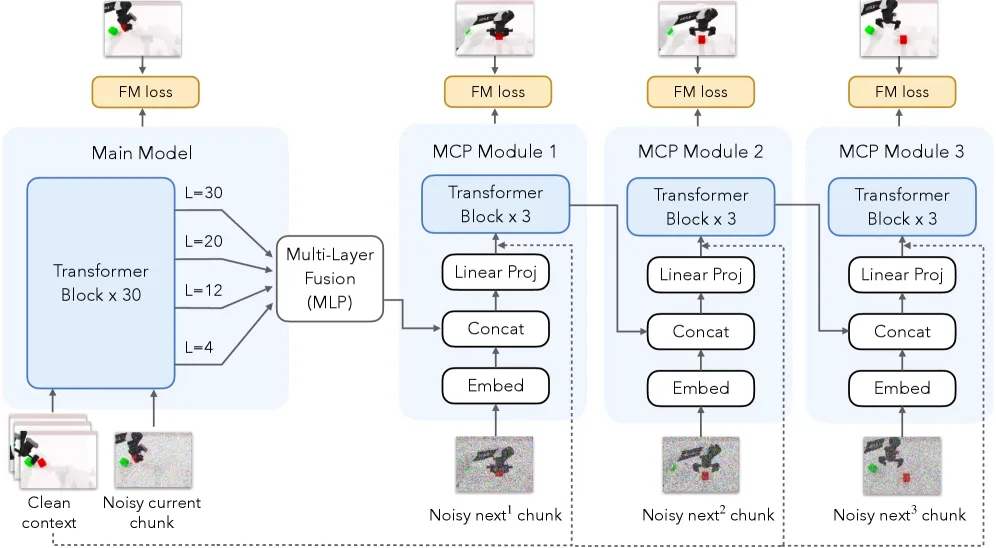
Next Forcing 的解决方案:在标准 teacher forcing 主目标基础上,引入 Multi-Chunk Prediction (MCP) 目标——主模型去噪当前块,同时三个轻量 MCP 模块通过因果链分别去噪 next1、next2、next3 未来块,每层基于前一层输出。训练时提供密集的多尺度时间监督;推理时 MCP 模块可丢弃(零开销部署)或保留(并行块生成,2× 加速)。
核心结果:RoboTwin 基准 94.1/93.5%(Clean/Random),50 fps 下 2.3× 训练收敛加速,推理 2× 加速,通用视频预训练 FVD 降低超过 50%。
三、技术架构
预备知识:Flow Matching
Flow matching (Lipman et al., 2023) 是学习速度场的生成建模框架。给定干净样本 和高斯噪声 ,时刻 的带噪样本通过线性插值构造:
神经网络 以条件 预测速度 ,训练目标为:
时间步 以 timestep shift 参数 采样。推理时通过 ODE solver 从 (纯噪声)积分到 (干净数据)。
预备知识:Teacher Forcing 自回归视频生成
基于 LingBot-VA 框架,模型操作于预训练 VAE 编码的视频潜变量,以 帧为块生成视频。每个自回归步骤 ,模型以干净历史块 和语言指令 为条件去噪当前带噪块:
MCP 目标:多块预测
时间块移位(Temporal Chunk Shifting)
给定训练视频潜变量 ( 通道、 块数、 高宽),每个块含 帧( 每步从 随机采样以增强时间尺度鲁棒性)。对每个 MCP 深度 ,构造时间移位目标:
超出序列边界的块通过复制最后一块填充。每个 是向未来移位 块的视频。
独立噪声注入(Independent Noise Injection)
每个移位目标使用 flow matching 公式独立加噪(各自的时间步和噪声样本):
使用专用 timestep shift 参数 采样,且 ,将 MCP 模块偏向更高噪声水平。动机:高噪声水平下 MCP 输入携带较少自身目标信息,模块被迫更依赖主模型表征去噪,将 MCP 损失梯度推入主模型而非让轻量 MCP 模块自己吸收监督。
MCP 位置编码
块移位并入旋转位置编码(RoPE):
使每个 MCP 模块接收其预测未来块的位置信息。
链式 MCP 模块(Chained MCP Modules)
多层特征融合(Multi-Layer Feature Fusion)
从主模型 30 个 transformer 层的 4 个中间层 收集隐状态(同时包含带噪当前潜变量和干净历史潜变量),捕捉不同深度表征。多尺度特征沿特征维拼接后经两层 MLP 压缩:
其中 为潜 token 数, 为隐藏维度。反向传播时 MCP 损失梯度经 流入中间层,为早期和后期阶段提供时间感知监督。
跨深度因果链(Causal Chain Across Depths)
三个 MCP 模块形成因果链。对每个深度 ,带噪移位目标 经共享 patch embedding 层,并与前一层输出融合:
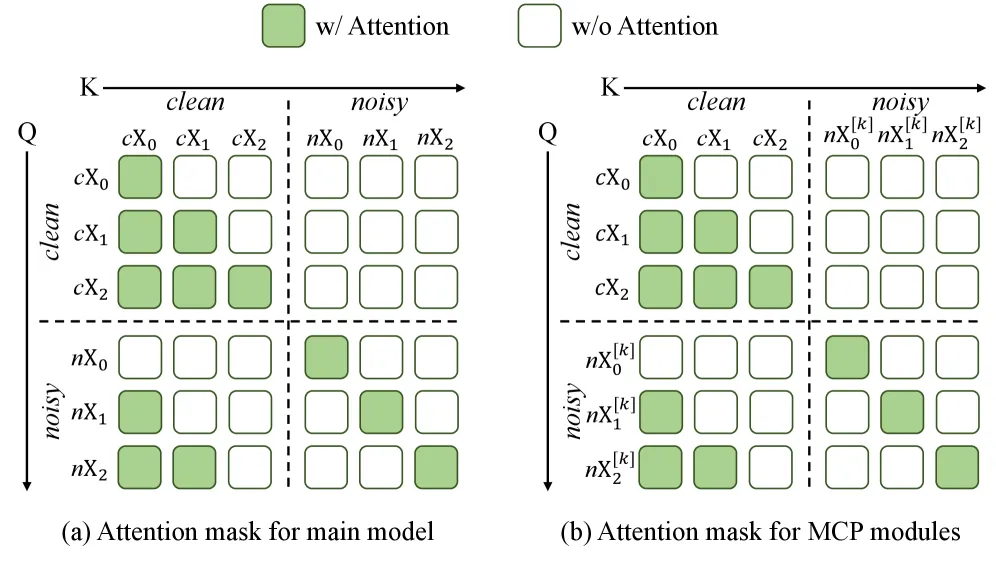
其中 。融合表征经 3 个轻量 transformer 块处理,预测 flow matching 速度 。输出同时作为下一深度的 ,使深度 2 基于深度 1 特征、深度 3 基于深度 2。MCP 模块与主模型共享相同 attention mask,每训练步只需构造一次 mask。
联合视频-动作架构
参照 LingBot-VA,Next Forcing 联合建模视频预测与动作解码,分解为两阶段:预测未来视觉动态 → 通过逆动力学解码动作:
其中 为到块 的观测历史, 为动作历史, 为语言指令。视频流先预测下一视觉状态 ,动作流以包含预测未来块 的观测为条件解码 。
两个流实现于统一 Mixture-of-Transformers (MoT) 架构,视频流与动作流通过每层跨模态注意力融合。MCP 模块作用于视频流,改进的视频表征经共享跨模态注意力传播到动作流,间接提升动作解码。
训练目标
主损失:视频流和动作流两个 flow matching 损失。视频动态损失监督视频流预测未来视觉状态:
动作损失通过逆动力学监督动作流:
其中 为真实动作序列, 包含当前与未来观测的视觉上下文。
MCP 损失:每个 MCP 模块在时间移位目标 (式 4)上以 flow matching 损失监督:
最后 个填充块从损失计算中排除。
总损失:
推理
MCP 模块是训练监督机制,但可在推理时复用。两种模式共享同一训练 checkpoint:
零开销模式(Zero-Overhead Mode):丢弃所有 MCP 模块(融合 MLP、投影层、轻量 transformer 块)。主模型与标准自回归流程完全一致,架构、延迟、内存占用与基线相同。所有质量提升来自 MCP 目标在训练时注入主模型的增强信号,测试零成本。
并行块生成模式(Parallel Chunk Generation Mode):保留 MCP 模块摊薄一次主模型前向的成本。单个去噪轨迹中,主模型生成当前块的同时,depth-1 MCP 模块同步生成下一块。MCP transformer 块比主模型轻一个数量级,添加几乎免费。每自回归步前进两块而非一块,实现 2× 推理加速。depth-2/3 不使用(其预测在下一步被主模型取代),但同一机制可扩展至更高加速比(代价是累积漂移,留作未来工作)。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 主模型 | Wan2.2 Transformer backbone,30 层 | ,noisy history aug. 概率 0.5 |
| MCP 模块 | 3 个深度,每深度 3 个轻量 transformer 块 | , |
| 特征融合 MLP | 拼接主模型层 {4,12,20,30} 隐状态 | 两层 MLP → |
| MCP 投影层 | 融合前一深度输出与嵌入的移位目标 | |
| 视频流 + 动作流 | MoT 架构,跨模态注意力融合 | 视频流 + 逆动力学动作解码 |
| VAE | 预训练视频自编码器 | 操作于视频潜变量 |
训练流程
- 先在大规模多具身数据集上预训练,再在 RoboTwin 上后训练(沿用 LingBot-VA)
- RoboTwin:2,500 Clean 演示(每任务 50)+ 25,000 Random 演示(每任务 500),最多 50k 步
- 64 GPUs 训练,多帧率(12/25/50 fps)评估
- 块大小 从 随机采样,
- MCP 模块权重从主模型最后几层初始化
- 消融实验:16 GPUs,仅 2,500 Clean 演示,25 fps,20k 步
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 多块预测目标(MCP) | 将单块 teacher forcing 扩展为 next1/next2/next3 多未来块预测,提供密集时间监督,打破外观捷径 | 50 fps 下 5k 步相对提升 93.1%(70.2/61.6% vs 45.5/31.9%),2.3× 收敛加速 |
| 跨深度因果链 | 3 个 MCP 模块形成因果链,近未来预测为远未来预测提供信息,各深度共享 attention mask | 深度 2/3 叠加改进最终精度 |
| 多层特征融合 | 从主模型层 {4,12,20,30} 融合中间特征,将 MCP 监督梯度推入主模型不同深度 | 移除多层融合后 SR 从 85.8% 降至 83.6% |
| 高噪声时间步偏移 | ,迫使 MCP 依赖主模型表征而非自身输入 | 移除后模块自己吸收监督,主模型受益减少 |
| 训练/推理双用 | MCP 模块训练时提供监督,推理时保留实现并行块生成 | 2× 推理加速,质量损失可忽略(Table 4) |
五、代码实现分析
(论文未公开代码;主页提供项目介绍。)
架构基于 LingBot-VA,backbone 为 Wan2.2 Transformer(30 层)。MCP 模块的关键实现要点:
- 正向传播:主模型 30 层前向过程中在 4 个中间层 {4, 12, 20, 30} 收集隐状态,包含带噪当前潜变量与干净历史潜变量
- 特征融合:多尺度特征沿特征维拼接 → 两层 MLP →
- 链式解码:对每个深度 ,移位目标经共享 patch embedding → 与前层输出拼接投影 → 3 个 transformer 块 → 预测速度
- Mask 共享:MCP 模块与主模型共享 attention mask,每训练步只构造一次(附录 A)
- 权重初始化:MCP 模块权重从主模型最后几层初始化
推理模式切换:同一 checkpoint,零开销模式丢弃 MCP(融合 MLP + 投影层 + transformer 块);并行模式保留 depth-1 MCP,主模型与 MCP 各生成一块,每步前进两块。
六、实验结果
RoboTwin 基准(Table 1)
平均成功率(%,50 任务)。Clean:固定初始配置;Random:随机化物体位姿与场景布局。
| 方法 | X-VLA | π₀ | π₀.₅ | Motus | Being-H0.7 | Fast-WAM | LingBot-VA | Next Forcing |
|---|---|---|---|---|---|---|---|---|
| Clean | 72.9 | 65.9 | 82.7 | 88.7 | 90.2 | 91.9 | 92.9 | 94.1 |
| Random | 72.8 | 58.4 | 76.8 | 87.0 | 89.6 | 91.8 | 91.5 | 93.5 |
Next Forcing 在 Clean 和 Random 设置均取得最高成功率,超越所有 VLA 和 WAM 方法。
训练收敛分析(Figure 1 + Table 5)
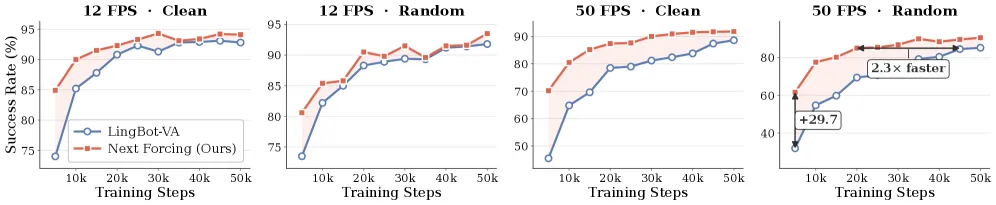
12 fps:Next Forcing 收敛约 2× 快于 LingBot-VA——10k 步达到 90.0%(基线 ~20k 步),最终精度更高(94.1/93.5% vs 92.8/91.8%)。
50 fps(差距显著放大):
| 训练步 | LingBot-VA Clean/Random | Next Forcing Clean/Random |
|---|---|---|
| 5k | 45.5 / 31.9 | 70.2 / 61.6(+24.7 / +29.7) |
| 10k | 64.8 / 54.7 | 80.5 / 77.6 |
| 20k | 78.5 / 69.4 | 87.4 / 85.0 |
| 50k | 88.6 / 85.2 | 91.8 / 90.5 |
5k 步时 Next Forcing 已超过基线 45k 步精度(仅 20k 步即匹配),2.3× 训练加速。
为什么高帧率下 MCP 更有效? 高帧率下相邻块几乎相同,next-chunk 去噪可经外观复制平凡求解。多块预测打破此捷径:超前 2 或 3 块的块具有显著视觉差异,只能通过理解底层物理动态预测,迫使模型发展时间感知表征。
PhyWorld 基准(Table 3 + Figure 3)
评估纯视频生成模型从视觉数据发现并遵循物理定律(匀速直线运动、弹性碰撞、抛物线运动等)的能力。移除动作流,报告 FVD(越低越好)和 Abnormal Ratio(违反物理定律的视频百分比,越低越好)。
| 方法 | FVD OOT | FVD IT | Abnormal Ratio OOT | Abnormal Ratio IT |
|---|---|---|---|---|
| LingBot-VA | 5.3 | 3.5 | 12% | 3% |
| Next Forcing | 4.7 | 3.2 | 8% | 2% |
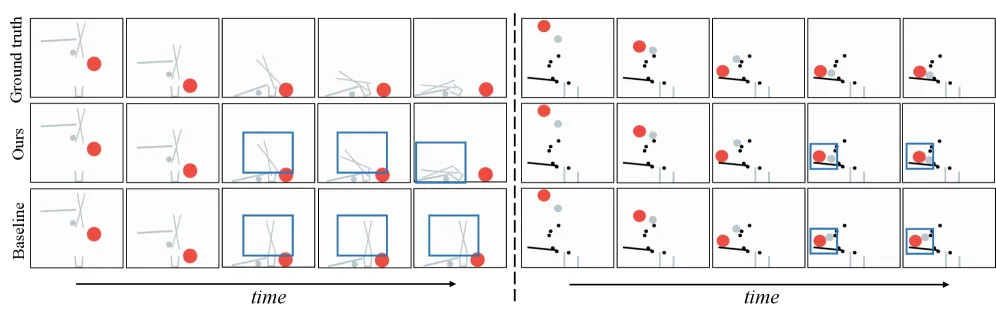
OOT(out-of-template)设置下增益更大,表明多块预测鼓励可泛化的物理动态而非模板特定记忆。
通用视频预训练(Figure 4)
约 350 万个 5-10 秒视频片段(以人类活动为主),移除动作流,32 GPUs 训练。两个各 1,024 样本的 held-out 测试集:Test Set 1 人类活动视频,Test Set 2 相机驱动场景动态。
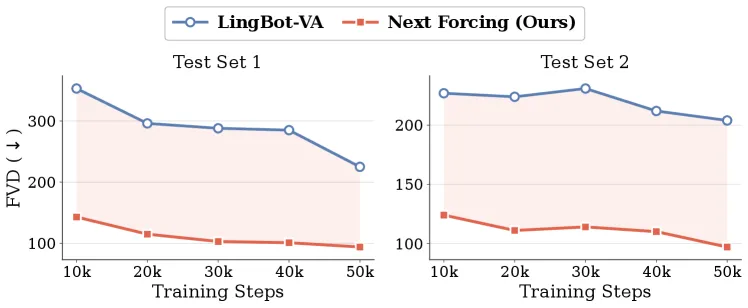
50k 步时 Next Forcing 在 Test Set 1 降低 FVD 58%(94 vs 225),Test Set 2 降低 52%(97 vs 204)。10k 步的 Next Forcing 已在两个测试集超越 50k 步的 LingBot-VA。
消融实验(Table 2)
RoboTwin Clean 子集,16 GPUs,20k 步。默认基线: + noisy history augmentation;默认 MCP: + 多层融合 + 主模型权重初始化 + 每深度 3 个 transformer 块。
基线消融(LingBot-VA):
| 配置 | SR (%) |
|---|---|
| Baseline (default ) | 75.6 |
| 65.3 | |
| 78.4 | |
| 77.6 | |
| 77.2 | |
| w/o noisy history aug. | 69.8 |
MCP 模块消融:
| 配置 | SR (%) |
|---|---|
| Baseline + MCP (default) | 85.8 |
| 83.2 | |
| w/o multi-layer fusion | 83.6 |
| w/o weight init | 83.8 |
| transformer blocks = 1 | 86.5 |
| transformer blocks = 5 | 85.0 |
关键结论:MCP 带来 +10.2 点(75.6 → 85.8);(接近主模型)效果更差,验证高噪声偏移的有效性;多层融合与权重初始化各贡献约 2 点;1 个 transformer 块已足够(86.5%),更多块收益递减。
推理加速(Table 4)
| 推理模式 | 12 fps Clean/Random | 25 fps Clean/Random | 50 fps Clean/Random |
|---|---|---|---|
| Standard | 94.1 / 93.5 | 92.6 / 91.4 | 91.8 / 90.5 |
| MCP-accelerated (2×) | 93.5 / 90.6 | 91.0 / 89.8 | 92.2 / 91.3 |
MCP 加速推理(2× 吞吐)在各帧率下质量损失可忽略(约 0-2 点),50 fps 甚至略高。
七、相关工作
World Action Models (WAMs)
- LingBot-VA (Li et al., 2026):联合建模视频预测与动作解码的 VLA 框架,Next Forcing 的直接基线
- 其他 WAM 方法(Ye et al., 2026 等):共同采用 teacher-forced next-chunk denoising 目标
多 token 预测(Multi-Token Prediction)
- DeepSeek-AI (2024)、Gloeckle et al. (2024):训练辅助模块预测多个未来 token,提升样本效率与推理加速——Next Forcing 在视频领域的灵感来源
视频生成世界模型
- 自回归视频生成:以预训练 VAE + transformer backbone 逐块生成
- Flow matching (Lipman et al., 2023):连续生成建模框架,Next Forcing 的训练基础
- PhyWorld (Kang et al., 2024):评估视频生成模型物理定律遵循度的基准
架构
- Wan2.2 (Wan Team, 2025):30 层 transformer backbone
- Mixture-of-Transformers (Liang et al., 2024b):视频流与动作流的统一 MoT 架构
- RoPE (Su et al., 2024):旋转位置编码,MCP 位置偏移的基础
八、总结
核心贡献
- 问题洞察:识别 teacher-forced next-chunk denoising 的 myopic supervision 问题——外观捷径使模型缺乏长程动力学学习压力,高帧率下尤为严重
- MCP 训练目标:将 MTP 思想适配到连续视频潜变量,引入 next1/next2/next3 多块预测,提供密集多尺度时间监督
- 链式 MCP 架构:跨深度因果链 + 多层特征融合 + 高噪声时间步偏移,将监督梯度有效推入主模型各深度
- 双用推理:同一 checkpoint 支持零开销部署与 2× 并行块生成,质量损失可忽略
- SOTA 结果:RoboTwin 94.1/93.5%,50 fps 2.3× 训练加速,PhyWorld FVD/Abnormal Ratio 全面改善,通用视频预训练 FVD 降超 50%
技术影响
Next Forcing 表明训练目标设计是提升自回归视频生成的关键轴(超越上下文构造与噪声调度)。多块预测为世界模型提供了高效的时间监督信号,其”训练时增强、推理时可选加速”的双用机制对 WAM 部署极具实用价值。
局限性
- MCP 模块引入额外训练成本
- 并行推理加速目前限于 2×(仅用 depth-1),更高加速比需处理累积漂移
- 评估集中于 RoboTwin/PhyWorld/通用视频,更广泛具身场景待验证
- 论文未公开代码
九、参考资源
- arXiv 论文: https://arxiv.org/abs/2606.11187v1
- arXiv HTML: https://arxiv.org/html/2606.11187v1
- 项目主页: https://gangweix.github.io/next-forcing/
- LingBot-VA: https://arxiv.org/abs/2509.10958
- Wan2.2: https://github.com/Wan-Video/Wan2.1