Echo-Infinity: Learning Evolving Memory for Real-Time Infinite Video Generation
可学习进化记忆的实时无限视频生成框架,首次实现 24 小时(>130万帧)实时视频生成
Echo-Infinity: Learning Evolving Memory for Real-Time Infinite Video Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Echo-Infinity: Learning Evolving Memory for Real-Time Infinite Video Generation |
| 作者 | Yuxuan Bian, Zeyue Xue, Songchun Zhang, Shiyi Zhang, Weiyang Jin, Yaowei Li, Junhao Zhuang, Haoran Li, Jie Huang, Haoyang Huang, Nan Duan, Qiang Xu |
| 机构 | 香港中文大学、京东 Joy Future Academy、香港科技大学、清华大学、香港大学、北京大学、中国科学技术大学 |
| 论文 | arXiv:2606.04527 |
| 代码 | github.com/Echo-Team-Joy-Future-Academy-JD/Echo-Infinity |
| 项目页 | echo-team-joy-future-academy-jd.github.io/Echo-Infinity |
| 发布 | 2026-06-03 |
| 许可 | 未明确 |
二、核心思想
问题定义
自回归视频生成面临两大瓶颈:
| 瓶颈 | 说明 | 现有方法的局限 |
|---|---|---|
| KV 缓存无限增长 | 历史帧的 KV 缓存随视频长度线性增长 | 窗口截断丢失历史、启发式压缩不够灵活 |
| RoPE 溢出/外推 | 时序位置编码超出训练范围 | 训练-测试不一致,导致质量退化 |
核心矛盾:现有方法使用预定义的 KV 缓存调度或固定比例压缩,无法在保持历史信息的同时实现常数计算成本。
解决方案概述
Echo-Infinity 受人类记忆巩固机制启发,提出可学习进化记忆:
- Memory Queries:端到端可训练的记忆查询,通过注意力和门控机制动态过滤、抽象、压缩任意长度历史
- Unified Relative RoPE Recipe:统一的相对 RoPE 调度,训练和推理时保持所有时序 ID 在预训练范围内
- 首次实现 24 小时实时视频生成:在单张 H100 上生成 >130 万帧,仅比无记忆基线多 10.6% 开销
三、技术架构
整体框架图
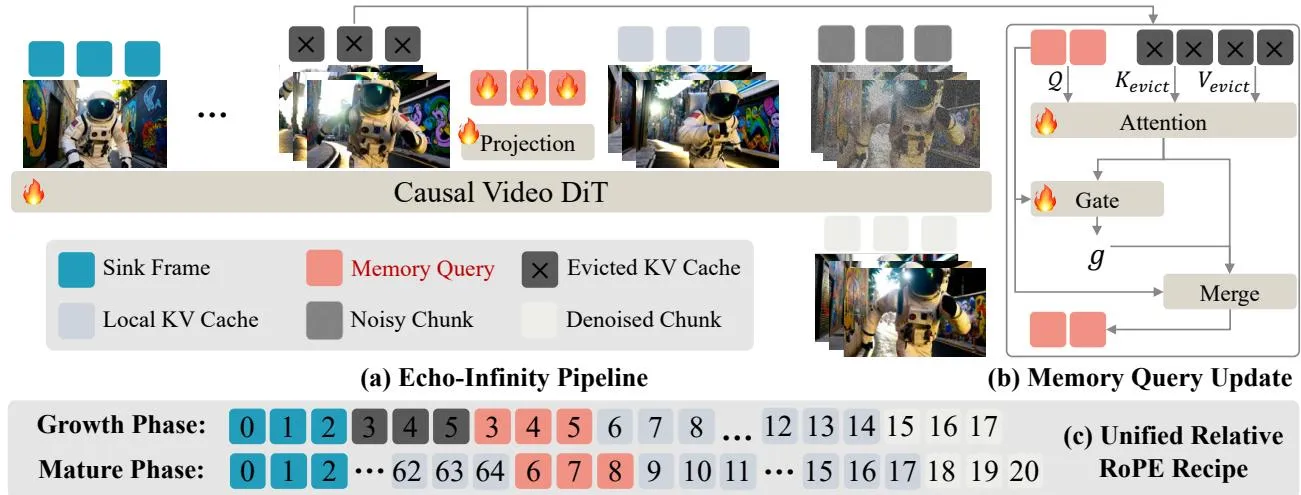
Echo-Infinity 的架构分为三个层次:
Echo-Infinity Architecture
├── Three-Tier KV Cache
│   ├── Sink Frames (N_S=3): 持久全局锚点
│   ├── Memory Queries (N_Q=3): 可学习进化记忆
│   └── Local Window (N_W=9): 短期工作缓冲
├── Memory Update Mechanism
│   ├── Cross-Attention Encoder (L_enc=2 layers)
│   ├── Sigmoid-Gated Residual
│   └── End-to-End Optimization
└── Unified Relative RoPE
    ├── Growth Phase: 时序 ID 增长到 f_max
    └── Mature Phase: 时序 ID 固定在 f_max
核心创新:Memory Queries
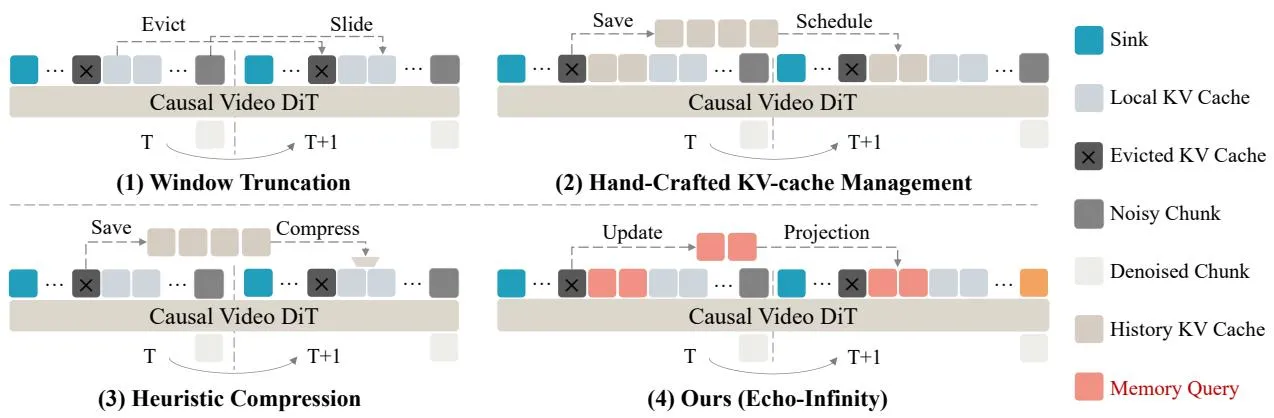
三层 KV 缓存组织:
| 组件 | 大小 | 功能 | 类比 |
|---|---|---|---|
| Sink Frames | N_S=3 | 持久全局锚点 | 基础定义记忆 |
| Local Window | N_W=9 | 短期工作缓冲 | 工作记忆 |
| Memory Queries | N_Q=3 | 进化长期记忆 | 长期记忆巩固 |
记忆更新公式:
其中:
- :2 层交叉注意力编码器
- :门控权重矩阵
- :sigmoid 激活函数
关键特性:
- 端到端优化:记忆参数与 DiT 联合训练
- 常数成本:N_Q 固定,计算开销不随视频长度增长
- 可泛化先验:即使禁用更新,优化后的 Q 仍能提升生成质量
Unified Relative RoPE Recipe
核心思想:训练和推理时使用相同的相对 RoPE 调度
两阶段调度:
- 增长阶段: 从 |sink| 增长到
- 成熟阶段: 固定在 ,旧帧 ID 向后旋转
训练流程
两阶段 DMD 训练:
| 阶段 | 内容 | 时长 | 优化目标 |
|---|---|---|---|
| Stage 1 | 标准调优(5s 视频) | 标准训练 | 端到端优化记忆参数 |
| Stage 2 | 流式长调优(60s 视频) | 长序列训练 | 跨子片段边界分离 Q 状态 |
超参数配置:
- 基础模型:Wan2.1-T2V-1.3B
- 分辨率:832×480 @ 16 FPS
- 内存编码器:L_enc=2, d=1536, 12 heads, head_dim=128
- 查询 token 数:T_Q = 3 × 1560 = 4680
- 最大时序 RoPE ID:f_max=20
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Memory Queries | 端到端可训练记忆,动态过滤/抽象/压缩历史 | 图 2-3,表 1-2 |
| Unified Relative RoPE | 统一训练-推理 RoPE 调度,避免外推/溢出 | 图 3(c) |
| Three-Tier KV Cache | Sink + Memory + Local 三层组织 | 算法 1 |
| 24 小时实时生成 | 首次实现 >130 万帧实时视频 | 图 6 |
| 可泛化记忆先验 | 优化后的 Q 即使禁用更新仍有效 | 表 3 |
五、实验结果
长视频生成(30s / 240s)
| 模型 | 参数量 | FPS | 30s Quality | 30s Semantic | 30s User Pref | 240s Quality | 240s User Pref |
|---|---|---|---|---|---|---|---|
| LongLive | 1.3B | 20.7 | 83.59 | 80.28 | 10.47% | 79.79 | 6.13% |
| MemFlow | 1.3B | 18.7 | 83.35 | 80.85 | 10.13% | 79.31 | 5.93% |
| Memorize-and-Generate | 1.3B | 21.7 | 83.69 | 81.01 | 14.73% | 75.49 | 2.13% |
| ∞-RoPE | 1.3B | 17.0 | 83.38 | 74.67 | 5.13% | 79.99 | 14.13% |
| Echo-Infinity | 1.3B | 18.5 | 85.61 | 82.01 | 59.53% | 81.23 | 71.67% |
关键发现:
- 30s 用户偏好:59.53%(vs 第二名 14.73%)
- 240s 用户偏好:71.67%(vs 第二名 14.13%)
- Quality 和 Semantic 分数均达到 SOTA
交互式长视频生成(60s)
| 模型 | Quality Score | 0-10s | 10-20s | 20-30s | 30-40s | 40-50s | 50-60s |
|---|---|---|---|---|---|---|---|
| LongLive | 79.38 | 34.08 | 32.09 | 32.03 | 31.55 | 30.88 | 30.49 |
| MemFlow | 79.91 | 33.48 | 31.94 | 31.95 | 30.87 | 30.53 | 30.23 |
| Memorize-and-Generate | 79.15 | 33.58 | 31.43 | 31.14 | 30.65 | 30.48 | 30.27 |
| ∞-RoPE | 79.22 | 33.15 | 32.47 | 31.41 | 30.46 | 30.29 | 30.17 |
| Echo-Infinity | 81.71 | 34.10 | 32.42 | 31.99 | 31.18 | 30.83 | 30.74 |
关键发现:
- Quality Score: 81.71(超越所有基线)
- CLIP Score 在各时间段均保持最高
24 小时实时生成
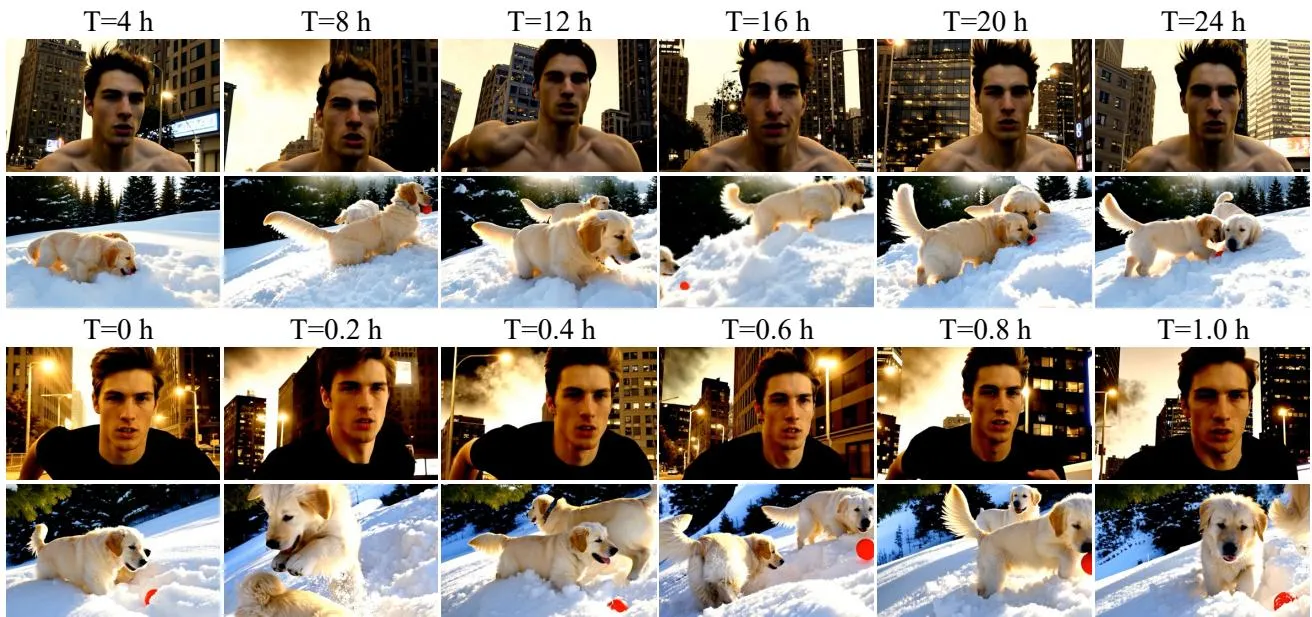
- 规模:>130 万帧 @ 18.5 FPS
- 时长:24 小时连续生成
- 效率:仅比无记忆基线多 10.6% 开销
- 硬件:单张 NVIDIA H100
短视频生成泛化
即使禁用记忆更新(Eq. 4),优化后的 Memory Queries 仍能作为可泛化的视频生成先验,提升生成质量。
六、消融实验
记忆机制消融
| 配置 | 30s Quality | 30s User Pref |
|---|---|---|
| Window Only | 83.59 | 10.47% |
| + Handcrafted KV | 83.35 | 10.13% |
| + Heuristic Compression | 83.69 | 14.73% |
| + Memory Queries (Echo-Infinity) | 85.61 | 59.53% |
RoPE 调度消融
| 配置 | 30s Quality | 30s Semantic |
|---|---|---|
| Absolute RoPE | 83.38 | 74.67% |
| Relative RoPE (inference only) | 79.99 | - |
| Unified Relative RoPE | 85.61 | 82.01% |
七、相关工作
| 工作 | 方法 | 差异 |
|---|---|---|
| LongLive | 窗口截断 + sink frames | 丢失历史信息 |
| MemFlow | 文本检索 KV 缓存管理 | 离线规则,固定预算 |
| Memorize-and-Generate | 启发式压缩 | 预定义压缩比,分离目标 |
| VideoSSM | SSM 进化全局记忆 | 需要架构级状态空间模块 |
| ∞-RoPE | 推理时相对 RoPE | 训练-测试不一致 |
八、总结
核心贡献
- Memory Queries:端到端可训练记忆,替代手工记忆管理,支持任意压缩比
- Unified Relative RoPE:统一训练-推理 RoPE 调度,消除外推/溢出风险
- Three-Tier KV Cache:Sink + Memory + Local 三层组织,模仿人类记忆层级
- 24 小时实时生成:首次实现 >130 万帧实时视频,仅 10.6% 额外开销
- 可泛化记忆先验:优化后的 Q 即使禁用更新仍有效
技术影响
- 无限视频生成:为实时无限视频生成提供实用路径
- 记忆机制创新:可学习记忆查询可推广到其他序列建模任务
- RoPE 调度:统一的相对 RoPE 方案可应用于其他长序列任务
- 产业应用:直播、游戏、虚拟现实等场景的实时视频生成
局限性
- 计算成本:虽然常数开销,但仍有 10.6% 额外计算
- 分辨率限制:当前仅支持 832×480 分辨率
- 帧率限制:16 FPS,对于某些应用可能不够
- 记忆容量:N_Q=3 可能无法捕获所有必要历史信息
- 评估局限:主要在 VBench-Long 和 MovieGen 上评估
九、参考资源
- 论文: arXiv:2606.04527
- 代码: github.com/Echo-Team-Joy-Future-Academy-JD/Echo-Infinity
- 项目页: echo-team-joy-future-academy-jd.github.io/Echo-Infinity
- 基础模型:
- Wan2.1-T2V-1.3B - 视频扩散模型
- DMD - 分布匹配蒸馏
- CausalForcing - 因果强迫训练
- 相关工作:
- LongLive - 长视频生成
- MemFlow - 记忆流
- Self-Forcing - 自强迫生成
- 评估基准:
- VBench-Long - 长视频评估
- MovieGen - 电影生成