StateKV: Linear Scaling Video VLMs for Long Video Understanding
通过重要性基�的固定容量循环状态实现视频VLM的线性时间预填充,在长视频理解中接近全自注意力性能
StateKV: Linear Scaling Video VLMs for Long Video Understanding
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Linear Scaling Video VLMs for Long Video Understanding |
| 作者 | Cristobal Eyzaguirre, Jiajun Wu, Juan Carlos Niebles |
| 机构 | 未明确标注 |
| 论文 | arXiv:2605.31598 |
| 代码 | 未明确 |
| 发布 | 2026年5月29日 |
| 许可 | 未明确 |
二、核心思想
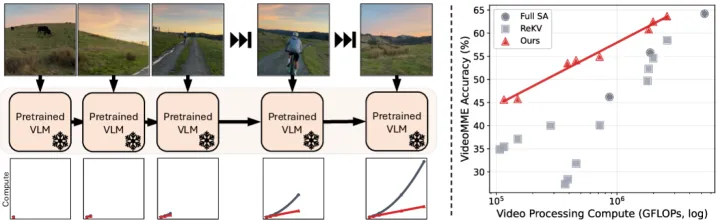
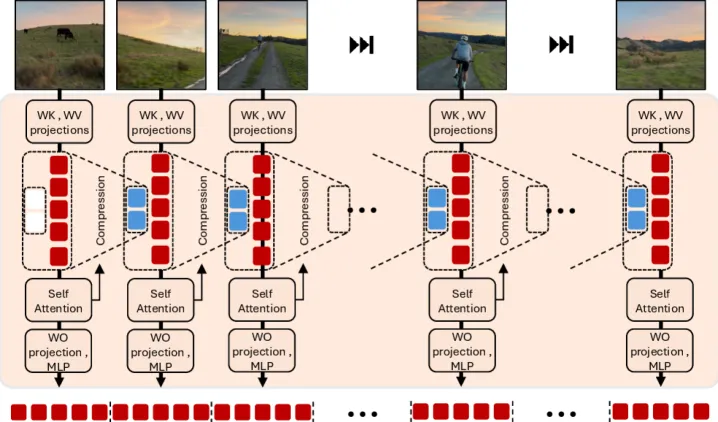
StateKV是一种推理时KV缓存预填充方法,将冻结的预训练VLM骨干网络适配到线性时间视频预填充。核心创新在于:
- 双缓存架构:固定容量的时间状态(cstate)用于跨帧上下文 + 完整的逐帧缓存(dstate)用于解码
- 重要性基选择:基于视频注意力统计选择最重要的token作为时间sink
- 渐进式状态更新:每帧刷新压缩状态,驱逐低重要性条目,接纳新显著token
问题定义
当前视频VLM的核心瓶颈:
- 计算复杂度:主流架构允许每帧关注所有先前视频token,导致二次方复杂度 O(N²)
- 现有方法局限:
- 帧子采样/视觉token裁剪:信息损失大,需保留约60% token避免严重退化
- 滑动窗口/近期偏差:基于启发式,缺乏原则性
- 固定预算压缩:最终生成上下文为 O(1),但可能丢失关键信息
解决方案概述
StateKV将流式视频预填充框定为用少量携带token近似全自注意力:
- 压缩状态(cstate):固定容量B(如1024 token),仅用于视频编码期间的跨帧上下文
- 详细状态(dstate):保留所有逐帧视频token,用于最终文本解码
- 复杂度:视频编码 O(N),解码 O(N),端到端线性
三、技术架构
整体框架图
StateKV的核心设计基于两个实证观察:
- 时间Sink假设:大多数跨帧注意力集中在少量历史token上,这些token的大小不随视频总长度增长
- 缓慢演化假设:有用的时间状态演化足够慢,下一状态可以从当前状态和当前帧良好近似
核心公式
全自注意力输出:
其中 是归一化注意力权重, 是值向量。
跨帧重要性: 对于帧 的查询token 和历史key ,跨帧重要性为:
候选池:
其中 是当前压缩状态中的token索引。
状态更新: 保留top-B候选:
RoPE位置编码: 维护虚拟序列长度 计算所有已处理token,独立于物理缓存长度:
使用相同的缩放参数 进行缓存构建和生成。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 压缩状态 cstate | 固定容量跨帧上下文 | B tokens(如1024) |
| 详细状态 dstate | 所有逐帧视频token | O(nT) 线性增长 |
| 重要性评分 | 基于视频注意力统计 | 逐层、逐头维护 |
| 位置编码 | 虚拟序列长度 | 与物理缓存解耦 |
训练流程
StateKV是推理时方法,无需训练或架构修改:
- 对每个Transformer层维护两个KV状态:dstate(详细)和cstate(压缩)
- 流式处理帧,每帧:
- 计算当前帧查询与cstate+当前帧key的注意力
- 更新dstate(追加当前帧KV)
- 更新cstate(基于重要性评分选择top-B token)
- 所有帧处理后,使用完整dstate进行文本解码
关键假设验证
假设1(时间Sink集中):
- top-256 token捕获约71%历史注意力质量
- top-1024 token捕获约83%
- top-4096 token捕获约93%
- 中间层集中度最高,首尾层较低
假设2(缓慢演化):
- 加权候选池召回率在B=16时达0.90-0.95
- B=256时达0.96-0.97
- top-1 oracle token的保持率在B=1时已达0.81-0.89
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 双缓存架构 | cstate用于编码,dstate用于解码 | 视频编码O(N),解码O(N) |
| 重要性基选择 | 基于注意力统计而非启发式 | 比滑动窗口捕获更多历史注意力质量 |
| 渐进式状态更新 | 每帧刷新压缩状态 | 候选池召回率0.96(B=256) |
| RoPE兼容性 | 虚拟序列长度解耦物理缓存 | 端到端相同缩放参数α |
与滑动窗口对比
关键发现:
- 注意力基选择在256 token时比滑动窗口(1帧=259 token)多捕获约0.59-0.62历史注意力质量
- 在1024 token时差距约0.57-0.61
- 第一帧和最后一帧吸引最多历史注意力质量,非纯近期模式
五、实验结果
基准测试
评估设置:
- 基准:VideoMME(无字幕)、MLVU、OVOBench(实时视觉感知子集)
- 采样:1 FPS,上限512帧
- 模型:InternVL3-1B/2B/8B,Qwen2.5-VL-3B/7B,LongVA-7B,LongVA-7B-Qwen2
Table 1: 主要结果
| 基准 | 方法 | InternVL3-1B | InternVL3-2B | InternVL3-8B |
|---|---|---|---|---|
| VideoMME | Full SA | 53.8 | 62.2 | 71.1 |
| ReKV | 46.4 | 50.1 | 62.1 | |
| StateKV | 52.1 | 61.0 | 69.7 | |
| MLVU | Full SA | 55.3 | 62.8 | 71.8 |
| ReKV | 45.1 | 47.7 | 55.7 | |
| StateKV | 54.6 | 61.8 | 70.5 | |
| OVOBench | Full SA | 45.1 | 52.6 | 60.8 |
| ReKV | 39.6 | 43.4 | 52.8 | |
| StateKV | 44.8 | 51.3 | 59.9 |
关键发现:
- StateKV平均接近全自注意力(约1点差距),比ReKV平均提升约10点
- 跨模型家族和参数规模的趋势一致
- 相同重要性基干预在不同骨干网络间迁移
计算-准确率前沿
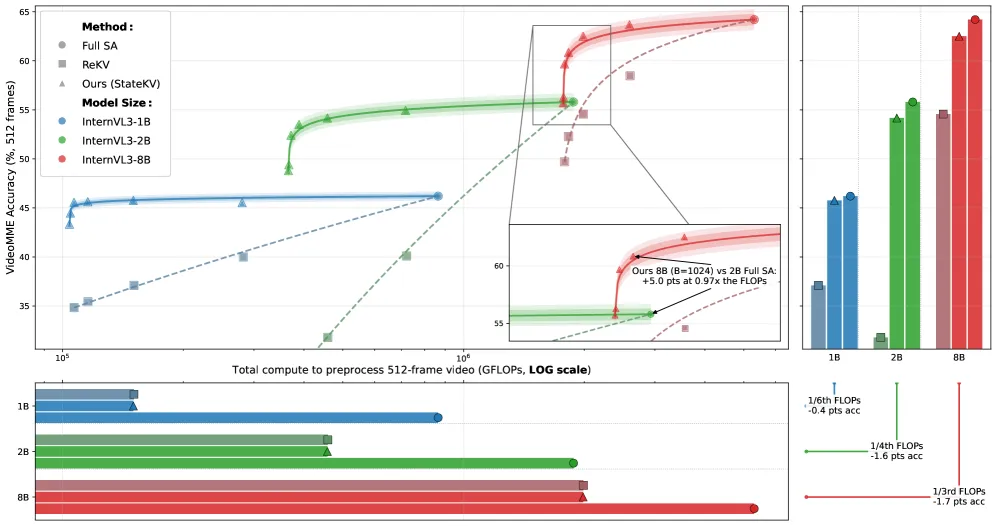
关键发现:
- StateKV在可比计算下一致比ReKV更接近全自注意力
- StateKV操作点遵循平滑的对数线性计算-准确率曲线
- 计算节省可再投资于模型规模:更大StateKV模型在低于更小全自注意力基线的计算预算下获得更高准确率
预填充FLOPs分析
512帧视频预填充FLOPs:
- StateKV显著减少视频预填充成本
- 更大模型+StateKV可在更小模型+全自注意力的计算预算下运行
消融实验
缓存预算缩放:
- StateKV随缓存预算增加单调提升
- 更大模型展现更强的缓存规模缩放
- InternVL3-8B StateKV在短视频上达到75.0%,匹配全自注意力
ReKV不稳定性:
- InternVL3-2B在多个设置中系统性退化
- InternVL3-8B在MLVU上展现类似不稳定性
- 严格近期偏差可能与某些骨干网络学习的注意力模式不匹配
墙钟时间分析
每帧前向传播延迟(单NVIDIA L40S GPU,batch size 1):
- 即使使用不高效的eager注意力路径,StateKV的固定每帧成本最终超过线性增长的全自注意力
- 自定义Triton内核进一步减少StateKV每帧墙钟时间
- 交叉点取决于模型大小和压缩预算
六、相关工作
| 方向 | 代表工作 | StateKV优势 |
|---|---|---|
| 帧/token裁剪 | ATP, Frame-Voyager | 不减少信息,保持线性复杂度 |
| 混合架构 | VAMBA | 无需训练或架构修改 |
| 固定预算压缩 | MovieChat, InfiniPot-V | 保留完整逐帧细节用于解码 |
| 流式预填充 | ReKV | 重要性基选择 vs 滑动窗口 |
| KV缓存压缩 | H2O, SnapKV | 专注视频特有注意力结构 |
七、总结
核心贡献
- 将流式视频预填充框定为用少量携带token近似全自注意力
- 提出双缓存架构:固定容量cstate用于编码,完整dstate用于解码
- 重要性基选择比滑动窗口捕获更多历史注意力质量
- 在3个长视频基准和7个模型上接近全自注意力性能,平均比ReKV提升约10点
技术影响
- 实现视频VLM的线性时间预填充,无需训练或架构修改
- 计算节省可再投资于更大模型,在相同计算预算下获得更高准确率
- 为实时流式视频理解提供实用解决方案
局限性
- 机制验证仅在现有模型和测试输入上进行,非普遍或根本性
- 需要访问逐层注意力权重,不能使用融合FlashAttention/SDPA内核
- 自定义Triton内核可缓解但需系统工程
- 未测试的骨干网络或未来模型可能不展现相同行为