Veda: Scalable Video Diffusion via Distilled Sparse Attention(蒸馏式稀疏注意力)
面向大规模视频扩散 Transformer(DiT)的稀疏注意力加速框架。核心洞见:生成质量并非由稀疏率本身决定,而取决于稀疏掩码与全注意力 tile 级几何结构的对齐程度。Veda 把 tile 选择建模为对全注意力的显式重建问题:(1) 蒸馏式 tile 打分——用轻量估计器从全注意力 backbone 蒸馏 tile 级分数,配合 TripPool(Avg/Max/Min 三元统计)与逐头 MLP 投影降低估计误差,训练时对 backbone 特征做 stop-gradient 解耦掩码学习与特征学习;(2) 逐头 tiling 搜索(Head-aware Tiling)——为每层每头分配 (p_t,p_h,p_w) 分块配置以最小化稀疏输出与全注意力输出的 Frobenius 误差;(3) 硬件高效 tile-skipping kernel(ThunderKittens/Hopper TMA+Warp Specialization,达 FA3 80% MFU)。在 Waver-T2V-12B 720P 10 秒视频上取得 5.1× 端到端、10.5× 自注意力加速,注意力开销从 92% 降至 50%,且序列越长收益越大。
Veda: Scalable Video Diffusion via Distilled Sparse Attention(蒸馏式稀疏注意力实现可扩展视频扩散)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Veda: Scalable Video Diffusion via Distilled Sparse Attention |
| 作者 | Shihao Han, Hao Yang, Xinting Hu, Xiaofeng Mei, Yi Jiang, Xiaojuan Qi |
| 论文 | arXiv:2605.30325(v1, 2026-05-28) |
| 投稿 | ICML(Machine Learning) |
| 许可 | CC BY 4.0 |
| 验证模型 | Waver-T2V(1B/12B)、Wan2.1-T2V(1.3B/14B) |
一句话总结:视频 DiT 的自注意力随时空序列长度呈二次增长,是长视频高分辨率生成的主要瓶颈。Veda 发现决定生成质量的不是稀疏率,而是稀疏掩码对全注意力 tile 级几何结构的对齐程度,据此把 tile 选择转化为对全注意力的显式重建(蒸馏)问题,配合逐头分块与硬件高效 kernel,在极高稀疏率(90%–95%)下几乎无质量损失,实现 5.1× 端到端加速。
二、核心思想
问题定义
将 DiT 扩展到高分辨率长视频受限于自注意力的二次计算/显存成本。稀疏注意力是自然出路,但受限于 GPU 的块状矩阵乘法,稀疏必须在 tile(分块)粒度而非单 token 粒度实现——即把 token 分组为 tile,每个 query tile 只关注少量 key tile,形成可被 tile-skipping kernel 直接执行的 tile 掩码。
现有方法的两条路线及其缺陷
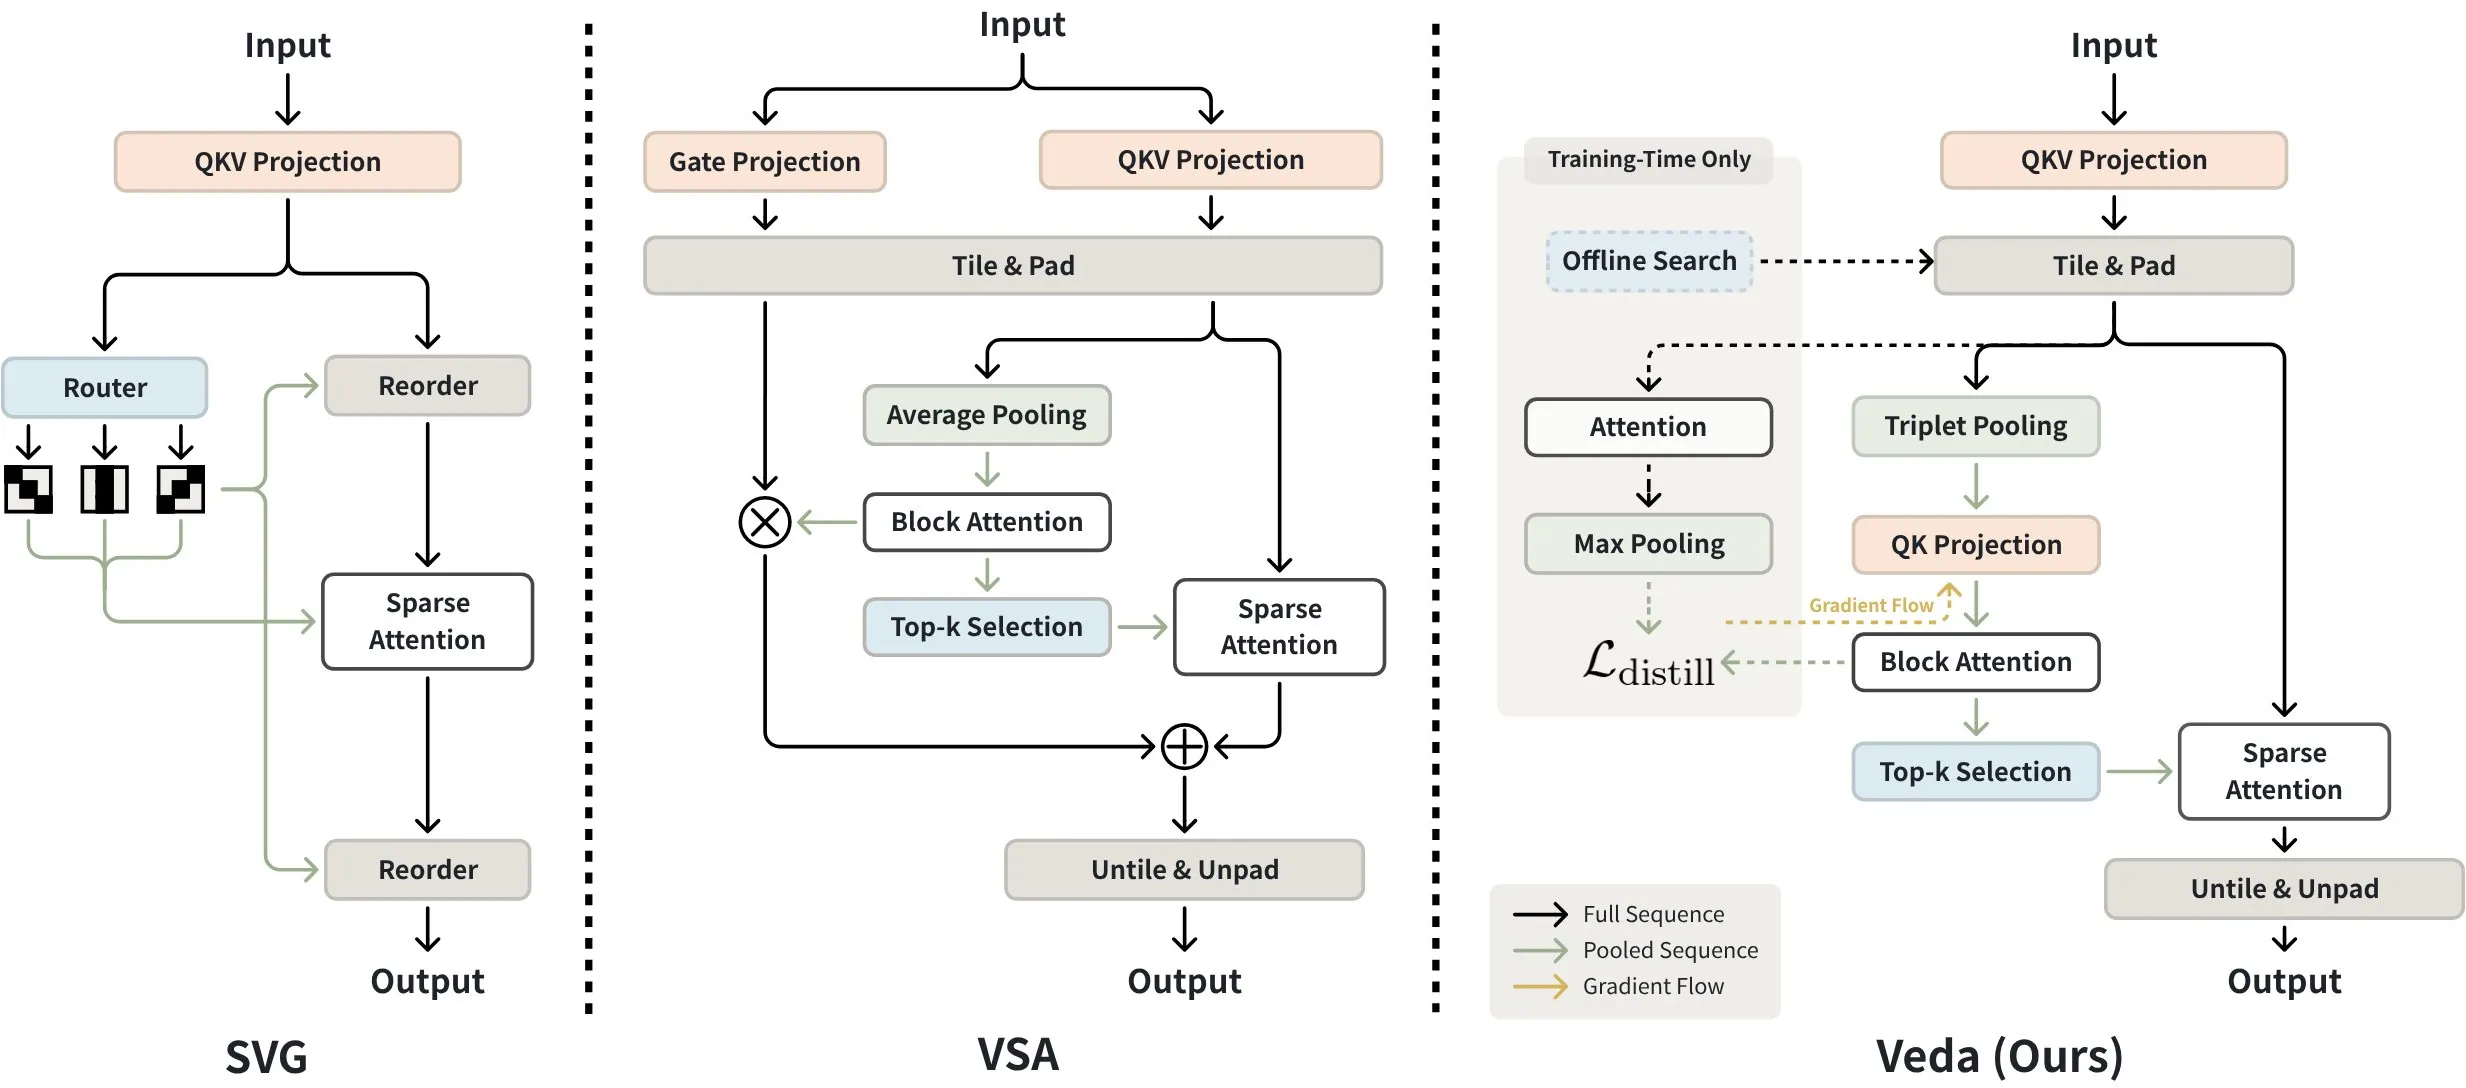
| 路线 | 代表 | 机制 | 缺陷 |
|---|---|---|---|
| 静态预定义模式 | SVG、STA | 用预训练模型的归纳偏置定义候选时空掩码,在线/离线搜索最优模式 | 与 DiT 学到的高度动态、逐头特异的注意力结构结构失配 |
| 动态 tile 选择 | VMOBA、VSA | 从压缩表示(池化特征/低秩近似)估计 tile 重要性并排序 | tile 重要性仅通过扩散目标隐式学习,缺乏显式监督;均值池化估计误差大,无法捕捉 tile 内显著峰值 |
两条路线在稀疏率超过中等水平后都出现明显质量退化:空间扭曲、水波纹(water-ripple)、时间闪烁等结构性伪影。
三项关键实证观察(Sec 3)
论文构造 Oracle 掩码(把全注意力矩阵 max-pool 成 tile 级分数图,保留最高响应 tile)作对照实验:
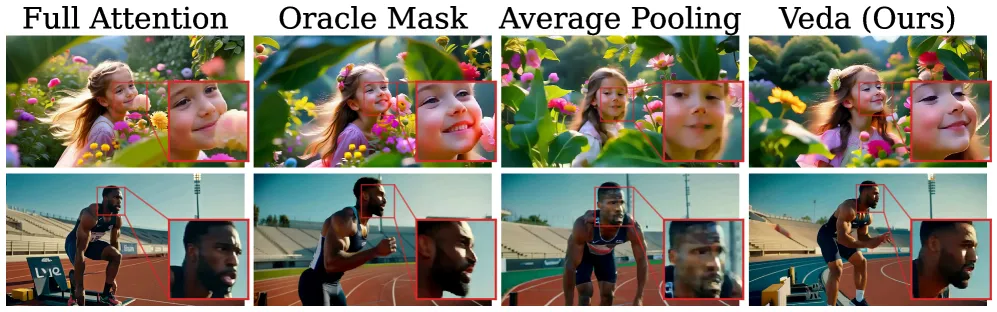
- 观察 1(结构性伪影):稀疏率 ≥90% 时,静态与动态基线都出现区别于语义幻觉的结构性伪影(水波纹、局部几何扭曲、帧间闪烁)。
- 观察 2(掩码质量主导,而非稀疏率):在相同 90% 稀疏率下,用全注意力导出的”最优”掩码生成质量远超池化掩码——瓶颈不是稀疏率本身,而是 tile 掩码是否保留了全注意力的 tile 级结构。
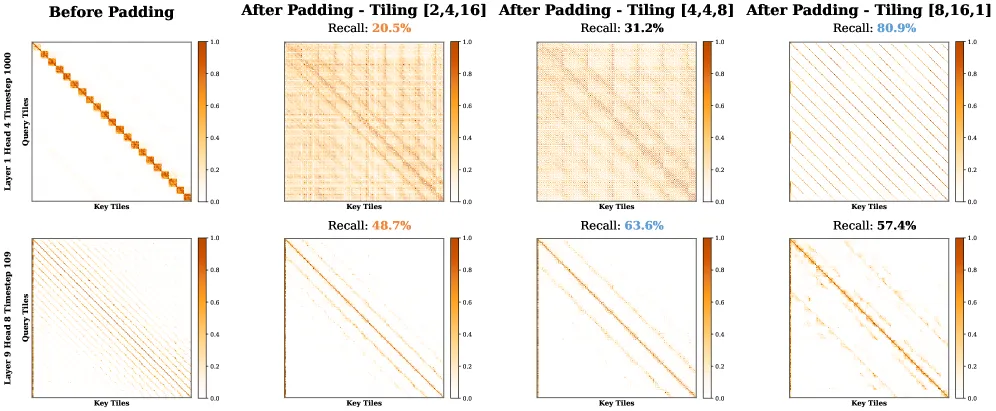
- 观察 3(逐头异质性):不同注意力头、不同扩散时间步的时空足迹差异显著,单一统一 tiling 策略必然次优。
Tile Recall 度量:为量化 tile 级对齐,定义稀疏方法选中的 top- key tile 集合 与全注意力 top- 集合 的召回率:
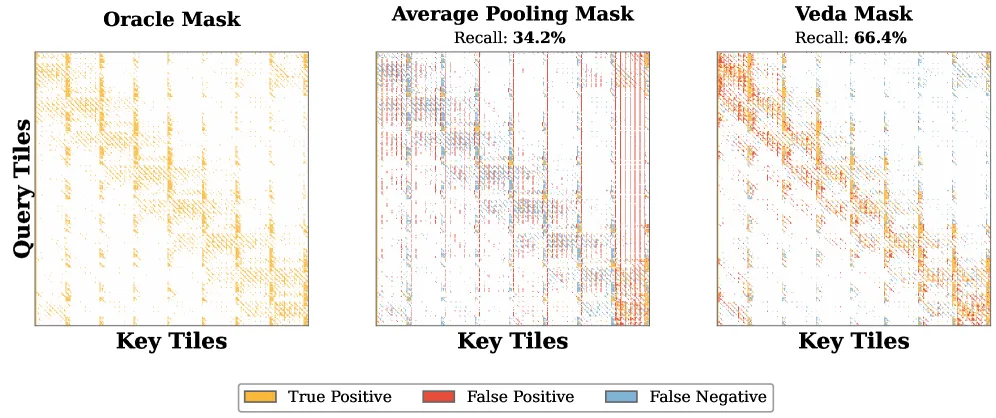
跨稀疏率实验表明,更高的 tile recall 与更少的结构性伪影强相关,是极高稀疏下稳定性的可靠指标。
三、技术架构
Veda 由三个组件构成:蒸馏式 tile 打分(降低估计误差)+ 逐头 tiling 搜索(降低结构失配)+ 硬件高效 kernel(把理论稀疏转为实际加速)。
3.1 蒸馏式 tile 打分(Distilled Tile Scoring)
目标:全注意力分数构建。 给定 ,全注意力图 ,用 max-pooling(而非平均)映射到 tile 级重要性:
选 max-pooling 是因为注意力分布通常稀疏且尖峰化;平均会用背景噪声稀释显著高频信号,而 max-pooling 保留关键依赖的存在性。
统计感知估计器(Statistic-Aware Estimator)。 对每个 query/key tile 构造 TripPool 三元统计描述子,再经逐头 MLP 投影 :
其中 为估计器隐维;每个头学习独立的投影权重。
优化目标。 对 行归一化、对 按 key tile 做 Softmax 得到逐 query 注意力权重 ,最小化行级 KL 蒸馏损失:
backbone 在稀疏执行下用标准扩散去噪目标 训练, 提供显式监督改善 tile 打分与 top- 选择。
关键设计——stop-gradient 解耦。 对送入估计器的 backbone 特征施加 stop-gradient,使掩码学习与特征学习解耦:
实验发现,若允许梯度回传到基座模型会导致明显质量退化。这表明把稀疏掩码学习与扩散目标隐式耦合是有害的——强迫生成 backbone 自己学习如何做稀疏注意力,会破坏其预训练表征能力。
3.2 逐头 tiling 搜索(Head-aware Tiling Search)
视频 DiT 各注意力头的时空依赖模式高度异质,统一 tiling 在高稀疏下次优。Veda 为每层每头分配分块配置 ,定义 个 token 如何分组为 个 tile。在固定 top- 预算下,搜索使稀疏输出与全注意力输出的 Frobenius 误差最小的配置:
即优先选择在固定 top- 预算下最忠实保留全注意力输出的 tiling(Algorithm 1)。
3.3 硬件实现(Hardware Implementation)
Tile-skipping 稀疏 kernel。 基于 ThunderKittens DSL,利用 NVIDIA Hopper 的异步 TMA(Tensor Memory Access) 和 Warp Specialization,用生产者-消费者范式解耦数据搬运与计算:producer warp 编排 TMA 只从全局内存取选中的非连续 key/value tile 进入环形共享内存缓冲区,consumer warp 同时执行 tensor core(WGMMA)计算,把稀疏内存 gather 的延迟隐藏在稠密矩阵运算之后。在 480P/81 帧()下达到 FlashAttention-3 约 80% 的 MFU。
高效 Ground-Truth 热图生成。 训练稀疏预测器需要从全注意力分布 导出 tile 级热图,但 softmax 归一化耦合了每行所有 key,难以在不存储 的情况下精确 pool。用 TileLang kernel 两遍计算:第一遍在 SRAM 做 tile-wise ,写出每个 tile 的未归一化最大值 + 运行行统计;第二遍完成行统计归一化恢复精确 tile 分数。达到 ~0.9× FA3 吞吐,且 tile 独立性支持只监督随机子集 query tile(partial query processing),大幅降低监督开销、加速训练而不明显损失性能。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 掩码质量 > 稀疏率洞见 | Oracle 掩码对照实验证明质量由 tile 级对齐决定,而非稀疏比例 | Fig 4,观察 2 |
| 显式蒸馏 tile 选择 | 把 tile 选择建模为对全注意力的显式重建,KL 蒸馏监督,区别于隐式学习 | 公式 (7) |
| TripPool 三元统计 | Avg⊕Max⊕Min 保留 tile 内显著峰值,优于均值/MaxMin 池化 | Table 2 消融 |
| stop-gradient 解耦 | 掩码学习不扰动预训练生成流形,稳定收敛 | Sec 4.1 |
| 逐头 tiling 搜索 | 每层每头 最小化 Frobenius 输出误差 | 公式 (9),Fig 10 |
| TMA/Warp-Spec kernel | ThunderKittens 把理论稀疏转为实际 wall-clock 加速(80% FA3 MFU) | Sec 4.3 |
五、实验结果
生成质量(VBench + 人工评测)
- VBench(Table 1,Waver 1.0 1B / 480P / 81F):Full Attn. wall time 69.3s;Veda(S=90%) 降至 31.9s 且多项指标持平或更优(Subject Cons. 0.940、Image Quality 0.699 均超过全注意力);Veda(S=95%) 30.6s。相比之下 Oracle Mask 因缺乏 kernel 优化反而 126.3s。
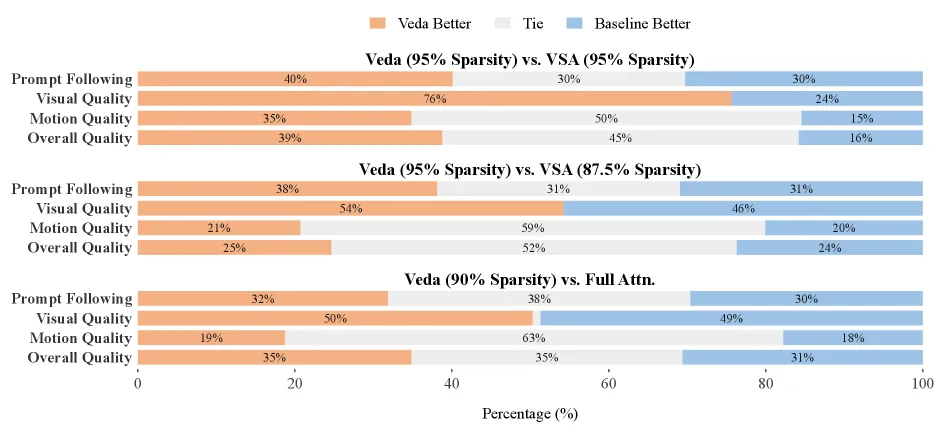
- 人工评测(Waver-T2V-1B,480P/81F,~34k tokens):Veda 在 90% 稀疏率下对全注意力达到 win/tie 持平;Veda 95% 稀疏优于 VSA 在更低稀疏率(87.5%)下的结果,在同等 95% 稀疏下大幅领先 VSA。
推理效率
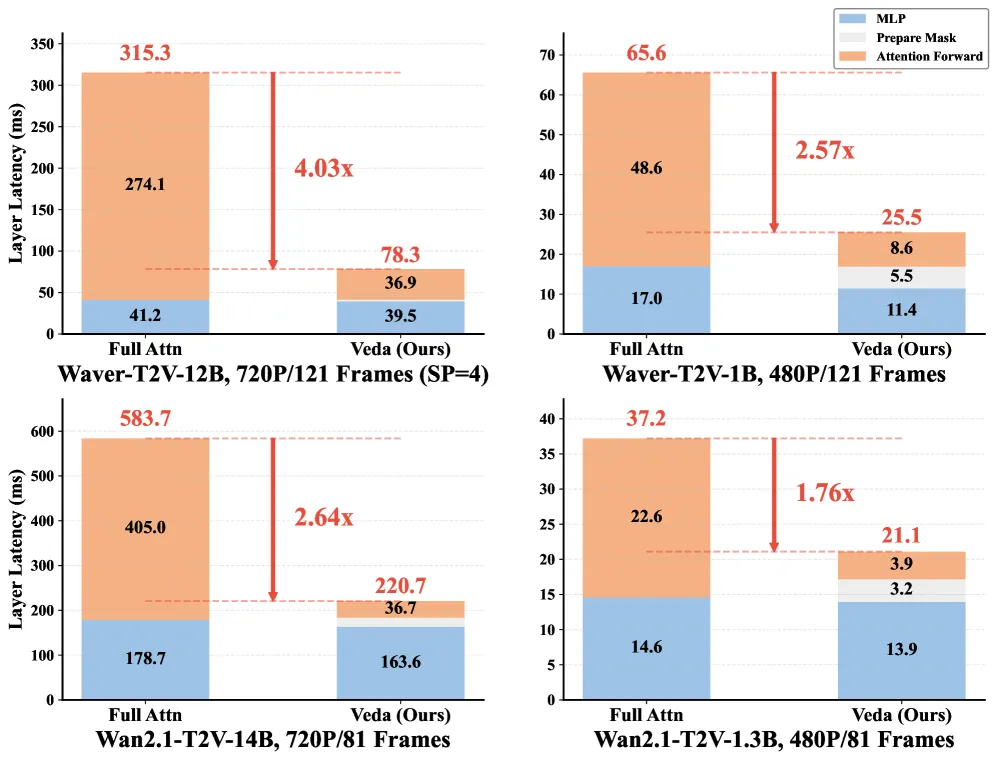
- Waver-T2V-12B(720P/121F):单 Transformer 层从稠密 315.3ms 降至 78.3ms(4.03×);Veda 分解为 MLP 39.5ms + 稀疏掩码准备 1.9ms + 稀疏注意力执行 36.9ms。
- Wan2.1-T2V-14B(720P/81F):583.7ms → 220.7ms(2.64×)。
- 序列长度可扩展性:50,220 tokens(480P/121F)对 FA3 有 2.57× 加速(25.5ms vs 65.6ms);扩到 245,760 tokens(720P/241F, SP=8)时 FA3 二次增长到 1576.5ms,Veda 近线性仅 309.1ms,5.1× 加速——序列越长收益越大。
消融实验
- 逐头 tiling(Fig 10):对比最优静态配置 ,Head-aware Tiling 在所有指标一致提升,Motion Quality +7.2%、Overall Quality +9.6%。静态基线中 (偏时间粒度)最优,优于 (偏空间)和 。
- Tile 统计(Table 2,训练损失↓):Triplet+Projector 0.912 < Avg+Projector 0.965 < MaxMin+Projector 0.982——三元池化最好地重建 oracle 注意力结构。
定性结果
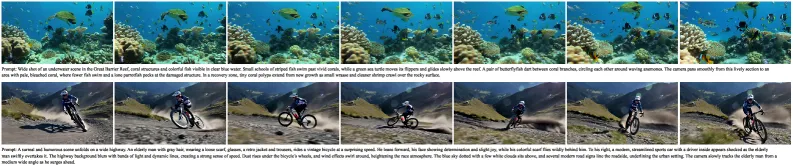
Waver-T2V-12B 在 95% 稀疏率下生成 720P/241 帧视频,质量无明显退化。
六、相关工作
- 静态稀疏:SVG (Xi et al., 2025)、STA (Zhang et al., 2025c) — 预定义时空模式。
- 动态稀疏:VMOBA (Wu et al., 2025)、VSA (Zhang et al., 2025b) — 池化/低秩估计 tile 重要性。
- 稠密注意力 kernel:FlashAttention-3 (Shah et al., 2024) — Veda 的加速基线。
- DSL/kernel 工具:ThunderKittens (Spector et al., 2024)、TileLang (Wang et al., 2025)。
- 基座视频 DiT:Waver、Wan2.1、HunyuanVideo、StepVideo 等。
七、总结
核心贡献
- 诊断:通过 Oracle 掩码对照实验,证明视频稀疏注意力的质量瓶颈是 tile 掩码与全注意力几何的对齐(tile recall),而非稀疏率本身。
- 方法:Veda 将 tile 选择建模为显式蒸馏重建问题,以 TripPool 三元统计 + 逐头 MLP + KL 蒸馏 + stop-gradient 降低估计误差,以逐头 tiling 搜索降低结构失配。
- 系统:基于 ThunderKittens/TileLang 的 tile-skipping kernel 与两遍热图生成,把理论稀疏转为实际加速(80% FA3 MFU)。
- 结果:Waver-T2V-12B 720P 10 秒视频 5.1× 端到端、10.5× 自注意力加速,注意力占比 92%→50%,且收益随序列长度增长。
技术影响
为高分辨率长视频 DiT 提供了可随分辨率扩展的稀疏注意力方案,且方法与基座解耦(stop-gradient),可迁移到不同视频扩散模型。
局限性
- 需要少量校准数据 与蒸馏训练(引入额外训练阶段)。
- 逐头 tiling 搜索在固定 top- 预算下进行,预算本身的自适应仍是开放问题。
- 主要在 Waver / Wan2.1 上验证,跨更多架构的普适性有待进一步检验。
八、参考资源
- 论文:Veda: Scalable Video Diffusion via Distilled Sparse Attention (arXiv:2605.30325)
- 相关文档:
- Waver: 面向逼真视频生成的统一基础模型(Veda 的主要验证基座 Waver-T2V-1B/12B)
- LTX-Video: 实时视频潜在扩散模型(视频扩散高效化的另一路线:压缩+架构)
- HunyuanVideo: 大规模视频生成框架
- Lean Attention(注意力 kernel 层面的加速)