minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models
全栈开源框架,将T2V/TI2V基础模型转换为相机可控的少步自回归视频世界模型
minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models |
| 作者 | Min Zhao, Hongzhou Zhu, Bokai Yan, Zihan Zhou, Yimin Chen, Wenqiang Sun, Kaiwen Zheng, Guande He, Xiao Yang, Chongxuan Li, Fan Bao, Jun Zhu |
| 机构 | ShengShu, Tsinghua University, Renmin University, HKUST, UT-Austin |
| 论文 | arXiv:2605.30263 |
| 发布 | 2026-05-30 |
| 主题 | cs.CV (Computer Vision) |
| 代码 | GitHub - shengshu-ai/minWM |
二、核心思想
问题定义
视频扩散基础模型在高质量视频生成方面取得了显著进展,但将它们转化为实时交互式视频世界模型仍具挑战。
交互式世界模型的要求:
- 可控(响应用户动作如相机轨迹)
- 因果(自回归生成)
- 低延迟(实时交互)
现有问题:技术分散在不同管道中,缺乏统一的端到端框架。
解决方案概述
minWM:全栈开源框架,构建实时交互式视频世界模型。
核心能力:
- 将现有双向T2V/TI2V基础模型转换为相机可控的少步自回归世界模型
- 端到端管道覆盖数据构建、可控微调、AR训练、少步蒸馏、流式推理
- 模块化和架构可扩展
支持的模型
| 模型 | 参数 | 架构 | 条件注入 |
|---|---|---|---|
| Wan2.1-T2V-1.3B | 1.3B | Cross-Attention | 文本到视频 |
| HY1.5-TI2V-8B | 8B | MMDiT | 文本+图像到视频 |
三、技术架构
整体框架
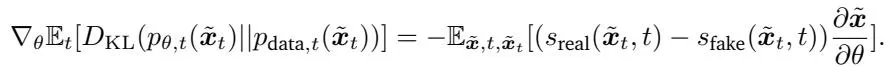
Figure 1: minWM概述。全栈管道将T2V/TI2V基础模型转换为相机可控的少步自回归世界模型。
两阶段方案
Phase 1:相机可控训练(双向扩散模型)
目标:微调双向视频扩散模型,使其能够遵循指定的相机轨迹。
技术:采用PRoPE(Projective Rotary Position Embedding)注入相机参数。
相机表示:
给定视频片段的相机参数 :
- :内参矩阵
- :世界到相机的外参变换
提升投影矩阵:
注意力注入(GTA形式):
优势:注意力交互显式依赖相对投影变换,联合编码相对相机内参和位姿。
Phase 2:AR扩散蒸馏(实时交互模型)
三阶段蒸馏流程:
| 阶段 | 方法 | 目标 |
|---|---|---|
| Stage 1 | AR扩散训练 | Teacher forcing微调为AR模型 |
| Stage 2a | 因果ODE初始化 | 离线ODE数据监督少步模型 |
| Stage 2b | 因果CD初始化 | 在线一致性蒸馏(无需离线数据) |
| Stage 3 | 非对称DMD | 对齐高质量双向教师分布 |
Stage 1:AR扩散训练
从双向扩散模型开始,通过teacher forcing微调为AR模型:
- 拼接干净视频和噪声版本
- 使用因果注意力掩码训练
- 获得自回归生成能力,但延迟高且质量受限
Stage 2a:因果ODE初始化
AR扩散模型生成PF-ODE轨迹,在预定义的少步时间步集上监督:
Stage 2b:因果CD初始化(Causal Forcing++)
消除离线ODE数据的存储开销:
Stage 3:非对称DMD
使用双向扩散模型对齐少步AR模型的高质量分布:
数据构建策略
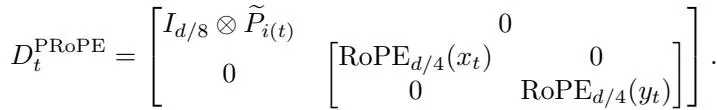
Figure 3: 三种数据构建策略。
| 策略 | 数据源 | 特点 |
|---|---|---|
| 估计相机位姿 | SpatialVid | 感知估计的位姿,效果不佳 |
| 3D重建+渲染 | DL3DV | 真值位姿,效果好 |
| WorldPlay生成 | OpenVid | 开源方案,真值轨迹 |
关键发现:真值相机位姿至关重要,感知估计的位姿难以实现可靠控制。
四、实验结果
延迟性能
Table 1: 首帧延迟对比(单A800 GPU)
| 模型 | 阶段 | 首帧延迟 | 加速比 |
|---|---|---|---|
| HY1.5-TI2V-8B | 双向多步 | 基线 | 1× |
| HY1.5-TI2V-8B | 少步AR | 极低 | 223.75× |
| Wan2.1-T2V-1.3B | 双向多步 | 基线 | 1× |
| Wan2.1-T2V-1.3B | 少步AR | 极低 | 236.64× |
关键结果:
- HY1.5: 223.75倍首帧延迟降低
- Wan2.1: 236.64倍首帧延迟降低
相机可控生成
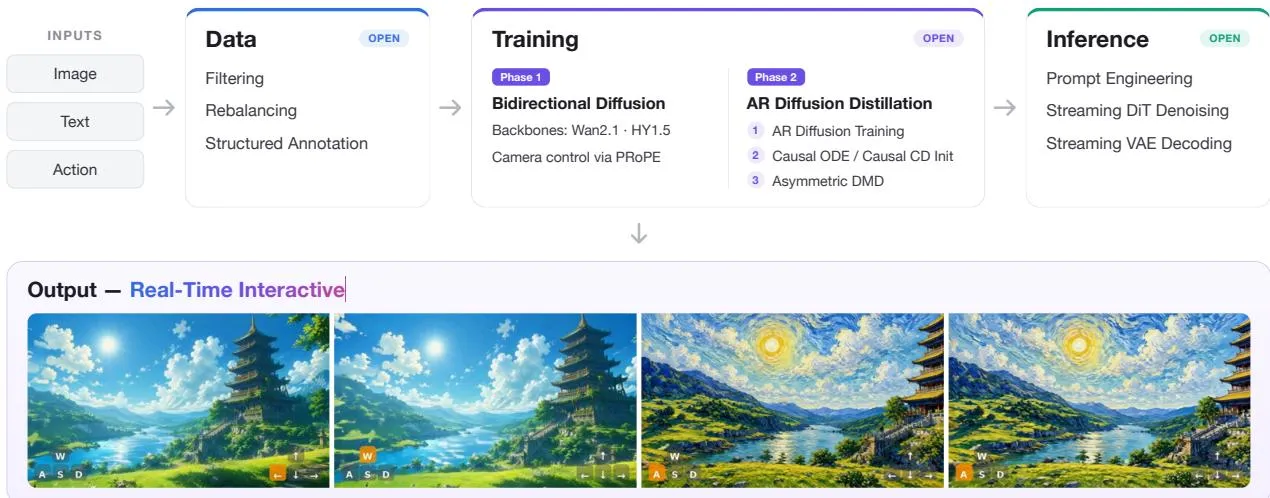
Figure 2: 蒸馏后少步AR模型的相机可控生成。
关键结果:
- 支持不同相机动作下的生成
- 蒸馏算法有效保持了模型的可控性
可控性训练阶段
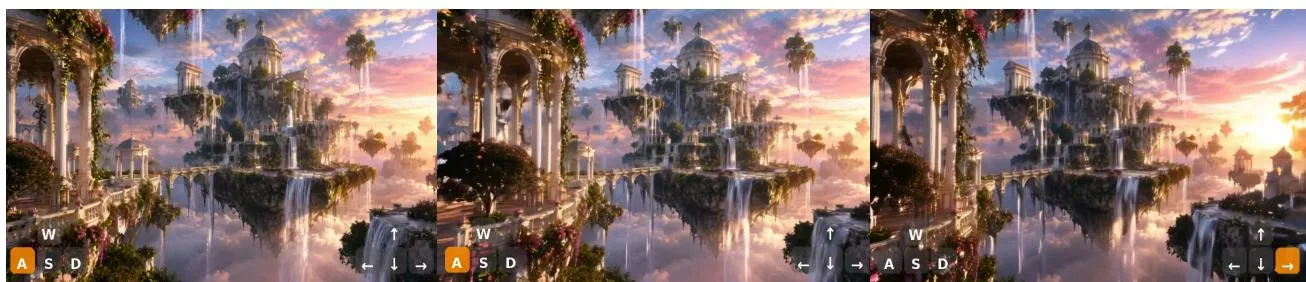
Figure 4: HY1.5可控性训练的不同阶段。
| 训练步数 | 可控性状态 |
|---|---|
| 1-2K步 | 完全不可控 |
| ~5K步 | 开始响应相机控制信号 |
| 8K步 | 实现强可控性 |
关键发现:可控性需要足够的训练步数(约5K-8K步)。
Batch Size消融
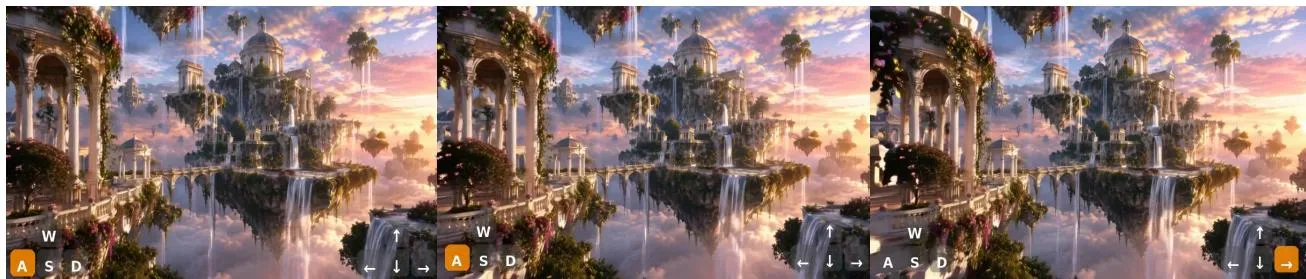
Figure 5: Wan2.1最小Batch Size需求。
| Batch Size | 可控性 |
|---|---|
| <4 | 通常失败 |
| 8 | 明显改善,但不稳定 |
| 16 | 成功完成全流程 |
关键发现:最小Batch Size为16才能成功学习相机可控性。
五、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 全栈框架 | 端到端管道覆盖全流程 | 可复现、可扩展 |
| 架构通用 | 支持Cross-Attention和MMDiT | Wan2.1和HY1.5验证 |
| Causal Forcing++ | 因果CD替代因果ODE | 消除离线数据开销 |
| PRoPE注入 | 投影旋转位置编码 | 有效相机控制 |
| 非对称DMD | 双向教师对齐AR学生 | 质量提升 |
| 开源全栈 | 脚本、检查点、文档、推理代码 | 降低门槛 |
六、与相关方法对比
| 方法 | 特点 | minWM优势 |
|---|---|---|
| HY-WorldPlay | 世界模型 | 可适配新数据和延迟目标 |
| SlowFast | AR蒸馏 | 统一框架,非单独管道 |
| Causal Forcing | 因果蒸馏 | 集成到完整框架 |
| Causal Forcing++ | 改进因果蒸馏 | 无需离线ODE数据 |
| Magi | Teacher forcing | 仅Stage 1,非完整流程 |
七、局限性
- 相机控制:目前仅支持相机控制,未来计划支持姿态等
- 模型支持:当前支持Wan2.1和HY1.5,需扩展更多模型
- 分辨率限制:480×832,更高分辨率需更多计算
- 数据依赖:需要真值相机位姿数据
八、总结
核心贡献
- 首个全栈开源框架:端到端覆盖视频世界模型构建全流程
- 架构通用性:支持不同类型的视频基础模型
- 实用消融:提供相机轨迹质量、训练步数、Batch Size的实践指导
- 开源生态:释放检查点、脚本、文档,降低复现门槛
性能总结
| 指标 | HY1.5-TI2V-8B | Wan2.1-T2V-1.3B |
|---|---|---|
| 首帧延迟降低 | 223.75× | 236.64× |
| 训练步数(可控性) | 8K步 | 16K步 |
| 最小Batch Size | 32 | 16 |
| 蒸馏步数 | 4步 | 4步 |
技术影响
minWM展示了全栈框架化的重要性:
- 统一管道:将分散的技术整合为可复现流程
- 模块化设计:便于替换和扩展组件
- 实用指导:消融实验提供实际部署参考
- 开源推动:降低视频世界模型研究门槛
九、参考资源
- 论文: arXiv:2605.30263
- 代码: GitHub - shengshu-ai/minWM
- 相关工作:
- Wan2.1 - T2V基础模型
- HunyuanVideo - TI2V基础模型
- Causal Forcing - 因果蒸馏
- Causal Forcing++ - 改进因果蒸馏
- PRoPE - 投影旋转位置编码