SIA: Self Improving AI with Harness & Weight Updates
提出 SIA 自改进循环——由 Feedback-Agent 同时更新任务专属 agent 的「harness(脚手架)」与「模型权重(LoRA)」,打破自改进 AI 的两大孤岛(仅改 scaffold / 仅改 weights)。在中文法律分类、GPU kernel 优化、单细胞 RNA 去噪三个对比领域上,双杠杆组合全面超越单独 scaffold 迭代:LawBench +25.1%、GPU kernel 快 12.4%、去噪 +20.4%(均超先前 SOTA)
SIA: Self Improving AI with Harness & Weight Updates
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SIA: Self Improving AI with Harness & Weight Updates |
| 作者 | Prannay Hebbar, Yogendra Manawat, Samuel Verboomen, Alesia Ivanova, Selvam Palanimalai, Kunal Bhatia, Vignesh Baskaran |
| 论文 | arXiv:2605.27276(v2,2026-05-28) |
| 发布 | 2026 年 5 月 26 日(v1),2026 年 5 月 28 日(v2) |
| 领域 | cs.AI(人工智能)、cs.CL(计算语言学) |
| 基座模型 | 任务专属 agent:openai/gpt-oss-120b;Meta-Agent & Feedback-Agent:Claude Sonnet 4.6 |
| 权重更新 | LoRA(rank r=32,学习率 4×10⁻⁵) |
二、核心思想
问题定义
人类是构建和改进 AI 的瓶颈:模型由研究者设计和后训练,包裹模型的 agent 由工程师搭建脚手架、写 prompt、调试和调优。“AI 能自己想办法改进自己”这一长期目标仍未实现。
现有自改进研究分裂为两个基本不相交的孤岛(silos):
- 孤岛 1 — Harness/scaffold 自改进:一个 meta-agent 跨代重写任务专属 agent 的脚手架(系统 prompt、工具分发逻辑、重试策略、答案抽取代码),而模型权重保持固定。代表:Darwin Gödel Machine、Meta-Harness、Hyperagents。经验观察:scaffold 编辑集中在软件工程卫生(parsing、retries、dispatch),很少带来 base model 在任何 prompt 下都无法产生的领域推理。
- 孤岛 2 — Test-time post-training:一条手写的 RL 流水线在测试时基于任务反馈更新模型自身权重,而 harness 固定在单一 prompt-and-grader 模板。代表:TTRL、Discover 系列 test-time training、TTT。局限:增益来自内部策略改变,但交付它的流水线由人类工程化,不适配 scaffold agent 会暴露的任务结构。
核心 gap:两个孤岛孤立运作——harness 工作让模型固定,test-time training 让 harness 固定。
解决方案概述
SIA(Self Improving AI) 提出一个自改进循环:由一个语言模型 agent(Feedback-Agent)同时更新任务专属 agent 的 harness 与权重。给定一个任务规范和一个 verifier(验证器),系统在无进一步人类干预下同时改进其脚手架和模型权重。
两个杠杆,一个循环:
- Harness update(脚手架更新):权重固定,Feedback-Agent 演化 scaffold → 让模型变得 agentic,塑造它如何搜索和行动;
- Weight update(权重更新):scaffold 固定,通过 Feedback-Agent 自选的 RL 方法更新 LoRA 权重 → 建立 domain intuition(领域直觉),这是任何 prompt 或 scaffold 都无法灌输的。
核心结论:组合两个杠杆在全部三个 benchmark 上超越单独 scaffold 迭代——LawBench 超先前 SOTA 25.1%、GPU kernel 快 12.4%(1,017 vs 1,161 μs)、去噪超 SOTA 20.4%。
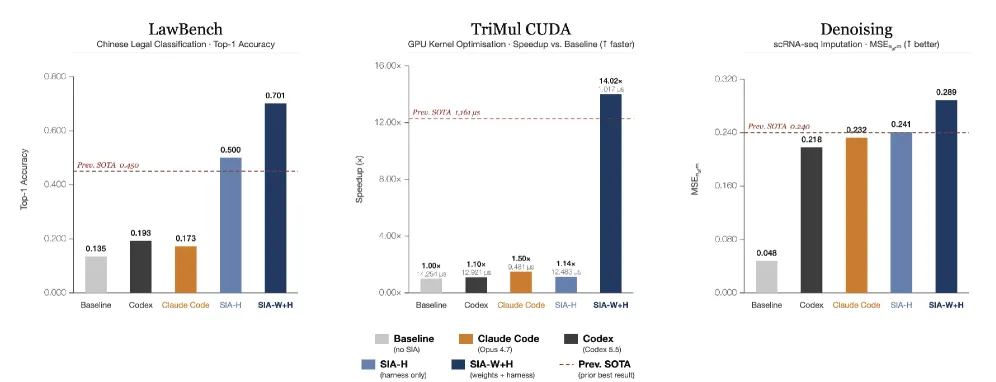
图 1:SIA 跨三个多样任务。每个面板对比三个操作点:Baseline(第一代,无 SIA)、SIA-H(仅 harness 更新)、SIA-W+H(harness + 权重更新),分别在 LawBench Top-1 准确率、TriMul CUDA 加速比、scRNA-seq 去噪 mse_norm 上。虚线标记先前 SOTA。SIA-W+H 在全部三个任务上严格优于 SIA-H。
三、研究问题(Research Questions)
- RQ1(整体论点):单独 harness 迭代(权重固定)能改进任务专属 agent 多少?两个杠杆一起跑(在单一循环中迭代更新 harness 与权重)能否突破 harness-only 的天花板?组合方法是否跨对比领域一致超越单独 scaffold 迭代?
- RQ2(机制:每个杠杆改变了什么):权重更新是否浮现出 scaffold 编辑触及不到的领域知识?harness 迭代是否产生质上不同的(外部基础设施)改变?
四、背景与预备(关键定义)
Agent 的组成
一个任务专属 agent 是接收任务实例、产出答案的程序,分解为:
| 组件 | 说明 |
|---|---|
| LLM | 底层语言模型,权重 θ(全程用 gpt-oss-120b) |
| System prompt | 前置于每次模型调用、框定任务的固定文本 |
| Tool-dispatch logic | 解析模型工具调用输出并路由到 handler(文件 I/O、代码执行、数据集查找、grader 调用)的 Python 代码 |
| Answer extraction | 将模型响应转为 benchmark 格式预测的代码 |
| Grader | orchestrator 调用、计算每实例 reward 的确定性验证器 |
Scaffold(= harness):agent 中固定的非权重部分——system prompt、tool-dispatch、answer extraction 及任何支撑基础设施的并集,即 agent 中”固定代码而非模型输出”的每一部分。
两类 Meta-Agent
- Meta-Agent(ℳ):从任务规范 𝒰 和参考实现 ℛ 生成初始脚手架:
- Feedback-Agent(ℱ):读取上一代脚手架 、执行轨迹 、性能指标 ,合成改进脚手架:
轨迹与反馈循环
不同于仅基于聚合指标改进的系统,ℱ 接收完整轨迹 ——运行 对评估数据集 𝒟 的完整结构化执行日志(每个实例的每个 prompt、模型响应、工具调用、工具结果、抽取答案),从而能诊断具体失败模式而非只对汇总统计做反应。
每代三阶段协议:① Execution( 在 sandbox 内跑 𝒟,捕获 )→ ② Analysis(ℱ 接收源码、、)→ ③ Improvement(ℱ 产出改进报告 + 下一代 agent )。
五、方法
5.1 整体框架
SIA 是由三个 LLM 组件驱动的可配置循环:Meta-Agent、Task-Specific Agent、Feedback-Agent。Meta-Agent 初始化脚手架;每次执行后,Feedback-Agent 观察轨迹和性能,然后在每一步动态地在两个互补动作间选择:harness update(权重固定的脚手架演化)或 training algorithm update(scaffold 固定、通过 Feedback-Agent 自选的 RL 方法更新权重)。动作选择与训练算法选择都条件于任务类型和观察到的 reward 动态。“Harness Update Phase”和”Weight Update Phase”是软标签,不是刚性顺序阶段。
图 2:SIA 概念视图(两杠杆一循环)
┌──────────────────────────────────────────────────────────┐
│  (a) 两个互补杠杆                                          │
│                                                            │
│   Harness (scaffold)          Weights θ (LoRA)             │
│   prompts · tools             low-rank adapter             │
│   retries · parsing           on base LLM                  │
│   ↑ edited by                 ↑ updated by RL              │
│   Feedback-Agent ─────┬───────┘                            │
│         harness update│weight update                       │
│                                                            │
│   先前工作只转一个旋钮;SIA 两个都转。                     │
│                                                            │
│  (b) 交错步序列示例(7 步)                                │
│   A1→A2→A3→θ1→A4→θ2→θ3                                     │
│   FB: H  H  W  H  W  W  (Feedback-Agent 决策)             │
│   harness harness weight harness weight weight             │
│   metric 曲线从两类步都上升,各贡献不同增益               │
└──────────────────────────────────────────────────────────┘
图 2:(a) 两个互补杠杆——文本脚手架 + LoRA adapter。每次执行后 Feedback-Agent 选择下一动作:harness update 或 weight update,两杠杆自由交错,非锁定顺序阶段。(b) 7 步序列示例,展示 Feedback-Agent 在 harness 与 weight 更新间交替,metric 曲线从两类步都上升。
图 3:SIA 系统架构
   Task spec 𝒰 ──┐
                  ├──► Meta-Agent ──► 初始化 scaffold A1
   Verifier V  ──┘         │
                           ▼
              ┌──► Task-Specific Agent ──► 在 Environment 执行 ──► 轨迹 τ
              │                                                    │
              │                                                    ▼
              └──── Feedback-Agent ◄──── 分析轨迹,选择下一动作
                     │  update harness  或  update weights
                     └─► 反馈给 Task-Specific Agent(循环直到 step 预算耗尽)
图 3:Meta-Agent 从 𝒰 与 V 初始化脚手架;Task-Specific Agent 在 Environment 执行产出轨迹;Feedback-Agent 分析轨迹并选择下一动作——合成改进脚手架(harness update)或触发权重更新——再反馈给 Task-Specific Agent,循环至 step 预算耗尽。
5.2 系统组件
所有实验中,Meta-Agent 与 Feedback-Agent 用 Claude Sonnet 4.6;任务专属 agent 用 gpt-oss-120b(harness 步)或其 RL 适配 checkpoint(训练步)。
5.3 Harness 更新
Feedback-Agent 选择 harness update 时,循环跑一步脚手架演化(Execution → Analysis → Improvement)。rollout 由当前模型 (base 或 RL 适配)产生,权重 θ 固定,仅 scaffold 改变:
Sample-task 正则化:Meta-Agent 在脚手架生成时条件于一组多样任务规范,缓解对单一 benchmark 实例的过拟合。
5.4 权重更新:Feedback-Agent 自选 RL 算法
关键设计——Feedback-Agent 不跑固定 RL 过程,而是根据轨迹观察条件性地选择训练算法(非固定 schedule):
| RL 算法 | 触发条件 | 核心机制 |
|---|---|---|
| PPO + GAE | step 级 reward 稠密、训练稳定性是约束(多步工具使用/长代码生成) | 学习 value head 产生 per-token advantage ;clipped surrogate 防策略离开信任域。低方差但昂贵 |
| GRPO | rollout 采样便宜、verifier 在 episode 末触发(分类/短答/单测) | 组内归一化 advantage ,消除 value 网络,减半内存,支持大并行 batch |
| Entropic advantage weighting | reward 直方图严重右偏(正确解稀少但高信号,如难证明/低通过率代码合成) | softmax 重分配梯度质量 ,自适应温度 β 在线调整以保持有效样本量在下限之上,防坍缩到单一轨迹 |
| REINFORCE + KL-to-base | reward 稠密、主要风险是能力回归而非梯度方差(细粒度领域适配) | Monte Carlo 回报 直接作 advantage + 对冻结参考的惩罚 。最简训练循环 |
| Best-of-N 行为克隆 | reward 极稀疏 ,policy gradient 信号数值为零 | phase-zero 冷启动:verifier 分数 top-k rollout 经交叉熵蒸馏进模型,抬升 baseline 通过率使后续 PPO/GRPO 可行 |
| DPO | verifier 能排序但无法绝对打分(软质量标准,ordinal 可靠但 cardinal 不可靠) | 给定胜者 /败者 ,直接最小化 ,无需 reward model |
六、实验结果
三个对比任务跨越法律、系统、生物,均为其他自改进 AI 系统常用 benchmark,以便直接对比。
6.1 评测设置
| 任务 | 领域 | Train/Test | 指标 | 先前 SOTA | Verifier |
|---|---|---|---|---|---|
| LawBench(191 类) | 中文法律 | 5,332 / 913 | top-1 accuracy | 0.450 | 留出测试集 grader |
| AlphaEvolve TriMul | 底层 CUDA | n/a / 固定输入形状 | score=1500/runtime | 1.292 | H100 计时 |
| MAGIC scRNA-seq 去噪 | 单细胞 | n/a / 胰腺 scRNA-seq | mse_norm(越高越好) | 0.24 | MAGIC 参考对真值 |
6.2 消融:SIA-H vs SIA-W+H(回答 RQ1)
| 任务 | Initial | 先前 SOTA | SIA-H(仅 harness) | SIA-W+H(harness+权重) |
|---|---|---|---|---|
| LawBench (top-1 acc) | 13.5% | 45.0% | 50.0% | 70.1% |
| AlphaEvolve TriMul (reward) | 0.105 | 1.292 | 0.120 | 1.475 |
| Denoising (mse_norm) | 0.048 | 0.240 | 0.241 | 0.289 |
SIA-W+H 在每个任务上严格优于 SIA-H,确认 RQ1。增益显著:LawBench +20.1 pp、TriMul 运行时降 91.9%(12,483→1,017 μs)、去噪 +20%。每个杠杆占据不同的改变空间(外部 scaffold vs 内部参数),故互不饱和对方的可用增益。
6.3 逐任务结果
① LawBench(191 类中文刑事罪名分类) — 给定案情事实,从 191 个中文法定罪名中识别正确罪名(随机猜测<1%)。
- Harness 更新:早期建立分类流水线,后续重构为 TF-IDF + LinearSVC 流水线,迭代调 character n-gram 范围和正则 C,准确率稳步升到 50.0%(较初始 +36.5 pp)后 levels off,Feedback-Agent 检测到 reward 停滞转向权重更新。
- Weight 更新:reward 是干净的 outcome-based 标量(罪名对错)、rollout 并行生成便宜 → PPO + GAE,稳定梯度压力提升模型编写正确处理细粒度罪名区分的分类代码能力,准确率推到 70.1%(较 harness-only 再 +20.1 pp)。
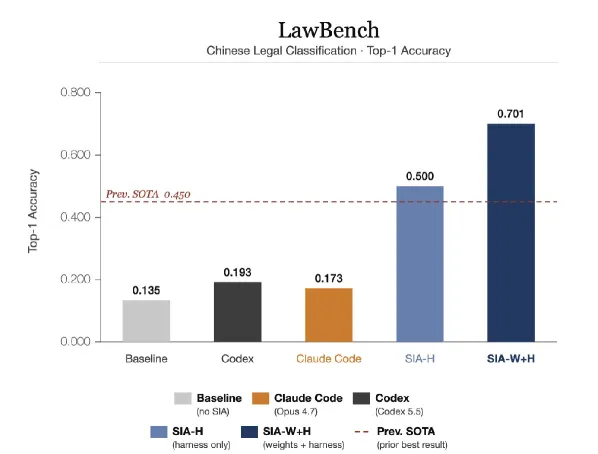
图 4:LawBench 结果。Baseline、SIA-H、SIA-W+H 的 Top-1 准确率。虚线为先前 SOTA。
② AlphaEvolve TriMul(CUDA kernel 优化) — 为 AlphaFold2 Evoformer 核心操作 TriMul 写 H100 自定义 CUDA kernel。该操作内存带宽受限、三角稀疏结构导致 warp divergence 和 cache miss,需 H100 特定知识(tensor core 调度、shared-memory tiling、寄存器压力管理),标准库(cuBLAS/cuSPARSE)不适用。score=1500/runtime。
- Harness 更新:跨迭代逐步构建精炼 CUDA kernel,收敛到最佳运行时 12,483(1.14× 加速),增量 scaffold 改动(内存布局提示、编译 flag、重试逻辑)产小增益后 plateau。
- Weight 更新:kernel 优化 reward 稀疏、outcome-heavy(多数 kernel 编译失败或远非最优)→ Entropic advantage weighting()使即便多数 kernel 差也有生产性梯度流。模型内化 H100 特定设计模式(shared-memory tiling、fp32 寄存器累加、block-size 选择),运行时降到 1,017,最终 14.02× 加速(较 harness-only 峰值降 91.9%)。
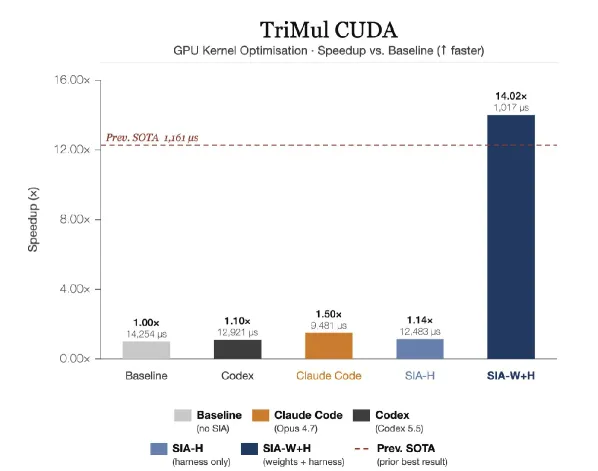
图 5:TriMul CUDA 结果。Baseline、SIA-H、SIA-W+H 相对 baseline 的加速比。虚线为先前 SOTA。
③ MAGIC scRNA-seq 去噪(单细胞 RNA 插补) — scRNA-seq 计数矩阵高度稀疏(技术 dropout 使真非零计数被观测为零)。MAGIC 构建细胞 kNN 图、算 Markov 转移概率、跨图邻居扩散表达值插补。任务:调 MAGIC 耦合超参(邻居数 k、扩散步 t、核带宽 α、预处理)于胰腺 scRNA-seq 数据。指标 mse_norm(越高越好,1.0 完美)。
- Harness 更新:跨迭代扫耦合超参空间,mse_norm 稳定在 0.241 后无改进,转向权重更新。
- Weight 更新:用 GRPO,模型超越纯参数调优。关键:第一个权重更新 checkpoint 引入一个 scaffold-only 循环在所有 harness 迭代中从未生成的结构变换——一个两行后处理步(
np.clip+np.rint)将插补计数四舍五入到非负整数,强制执行一个平凡正确却在任何先前 scaffold 版本中缺失的生物不变量。mse_norm 提升到 0.289(较 harness-only +20%)。
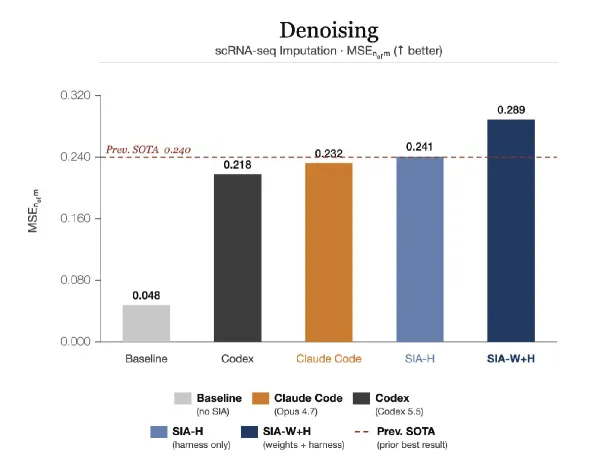
图 6:去噪结果。Baseline、SIA-H、SIA-W+H 的 mse_norm。虚线为先前 SOTA。
七、机制分析(回答 RQ2)
7.1 Harness 迭代改变什么(RQ2a)——外部化改变
Harness 迭代产生外部化改变:新工具、更紧的 parser、搜索过程、重试策略、prompt 结构,模型权重固定。跨三任务观察到 Feedback-Agent 构建日益专门化的脚手架:
- LawBench:结构化答案抽取层 + 对模型 top 候选的 SVC re-ranker;
- TriMul:编译错误 parser(将 CUDA 诊断作结构化上下文反馈)+ 返回中位运行时的计时 harness;
- MAGIC:批量配置驱动 + 组织(参数集, 分数)对的结果解析工具。
所有改变都是软件工程改进;模型 checkpoint 全程不变,增益都来自 scaffold 如何中介模型与任务环境。
7.2 Weight 更新改变什么(RQ2b)——内部化知识
权重更新产生内部化知识:编码进模型参数、任何 scaffold 编辑都触及不到的领域特定模式。不同于 harness 改变(修改模型周围基础设施),权重更新直接修改模型对解的先验:
- LawBench:对 191 类罪名分类体系的梯度压力锐化了模型对相邻类别(盗窃子类、伤害等级、诈骗变体)的消歧,无任何 prompt 侧提示;
- TriMul:权重收敛到 base model 无论 scaffold 质量都从未产生的 H100 特定 kernel 设计模式;
- MAGIC:第一个权重更新 checkpoint 引入 harness 从未提出的结构不变量(np.clip + np.rint),将生物约束直接编码进策略。
核心洞见:harness 塑造 agent 如何搜索;weight 更新改变模型知道什么(“The harness shapes how the agent searches; weight updates change what the model knows.”)。
八、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 双杠杆自改进循环 | Feedback-Agent 同时更新 harness 与权重,打破两大孤岛 | 图 2/3;Table 3 |
| 动态动作选择 | 每步在 harness/weight 更新间动态选择,条件于任务类型和 reward 动态 | §5.1;软标签非刚性阶段 |
| RL 算法自适应选择 | Feedback-Agent 按轨迹观察从 6 种 RL 算法中选择(PPO/GRPO/entropic/REINFORCE/BoN-BC/DPO) | §5.4;三任务分别用 PPO/entropic/GRPO |
| 全轨迹反馈 | ℱ 接收完整执行日志而非聚合指标,诊断具体失败模式 | §3.3 |
| 可学习块摘要式初始化 | Meta-Agent 从任务规范生成初始 scaffold,sample-task 正则化防过拟合 | §5.3 |
| 任务无关性 | 仅需任务规范 + verifier,产出演化 scaffold + RL 适配 LoRA | §1.3 |
九、局限性与未来工作
局限性
- 耦合协同进化 Goodhart:harness 搜索与 RL 权重更新都对同一固定 verifier V 优化,每一遍塑造对方看到的分布——harness 找当前策略易利用的 scaffold,权重训练于随后会改变的 scaffold 收集的数据。该耦合系统的联合不动点是两个互相看不到对方更新历史的优化器间的 Nash 均衡,而非最大化 OOD scaffold 或新策略上 V 的点。标准 Goodhart 分析假设单一优化器;双杠杆设置产生耦合变体,其不动点可能在训练 verifier 上看似强,但对任一组件的扰动都脆弱。
未来工作
- 对动作选择策略的 Meta-RL:当前 Feedback-Agent 用冻结 LLM 先验选择 harness/weight 更新。更原则化的做法是把选择策略本身当作学习对象:跨任务分布跑 SIA,把每个(轨迹, 动作, 结果)三元组当外层 MDP 的 transition,通过 RL 训练选择器——创造真正递归的结构(改进机制本身也自改进),并引出嵌套循环稳定性的非平凡问题。
- 更细粒度交错训练与 harness 切换:当前循环在离散粗粒度轮次间交替。更细 schedule(harness 搜索中途触发权重更新、梯度步后立即恢复 harness 探索)可减少观察 plateau 到行动的滞后,解锁粗交替错过的改进轨迹。
十、参考资源
- arXiv 论文:https://arxiv.org/abs/2605.27276
- 基座模型:openai/gpt-oss-120b(任务 agent)、Claude Sonnet 4.6(Meta/Feedback-Agent)
- 评测 benchmark:LawBench(Fei et al., 2023)、AlphaEvolve TriMul(Novikov et al., 2025)、MAGIC scRNA-seq(van Dijk et al., 2018)
- 相关工作:Darwin Gödel Machine、Meta-Harness、Hyperagents(harness 孤岛);TTRL、Discover、TTT(权重孤岛)