Bernini: Latent Semantic Planning for Video Diffusion
基于 MLLM 语义规划和 DiT 渲染的统一视频生成与编辑框架
Bernini: Latent Semantic Planning for Video Diffusion
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Bernini: Latent Semantic Planning for Video Diffusion |
| 作者 | Bernini Team, Bytedance |
| 机构 | 字节跳动 (Bytedance) |
| 论文 | arXiv:2605.22344 |
| 项目页 | bernini-ai.github.io |
| 发布 | 2026年5月21日 |
| 许可 | CC BY 4.0 |
| 主题 | cs.CV (计算机视觉与模式识别) |
二、核心思想
问题定义
多模态大语言模型 (MLLM) 和扩散模型已经各自发展到相当成熟的阶段:MLLM 擅长对异构多模态输入进行推理并具有强大的语义基础,而扩散模型能够以照片级保真度合成图像和视频。然而,如何将这两个成熟的模型家族有效统一到一个系统中,同时支持理解、生成和编辑,仍然是一个开放性问题。
解决方案概述
Bernini 提出了一种简洁的分工策略:MLLM 负责语义规划,扩散模型负责像素渲染。
核心观察:
- MLLM 天然适合语义推理:解释长指令、基于多个参考图像、形成输出的内部表示
- 扩散生成可分解为语义引导和细节保持:高层内容由紧凑的语义信号决定,细粒度保真度需要密集的像素级特征(如 VAE 特征)
- 语义信号无需高分辨率:少量语义 token 就足以指定整个场景
关键设计: 将语义接口锚定到 MLLM 自身的 ViT embedding 空间。MLLM 已经在这个空间中进行推理和表示视觉内容,因此训练它在 ViT embedding 中规划目标自然地与其预训练表示对齐。
核心性能
- 视频编辑: 在 OpenVE-Bench 上整体得分 4.04(vs VINO 3.18),在 EditVerse 上编辑质量 8.02(新 SOTA)
- 主体到视频: 在 OpenS2V 上总分 62.94(超越 Kling O3 的 59.19),FaceSim 78.20(超越次优 20+ 点)
- 文本到视频: VBench 总分 84.64,与基座模型 Wan2.2-A14B(84.79)基本持平
- 统一框架: 同时支持 T2V、R2V、V2V、RV2V 四种任务
三、技术架构
整体框架图
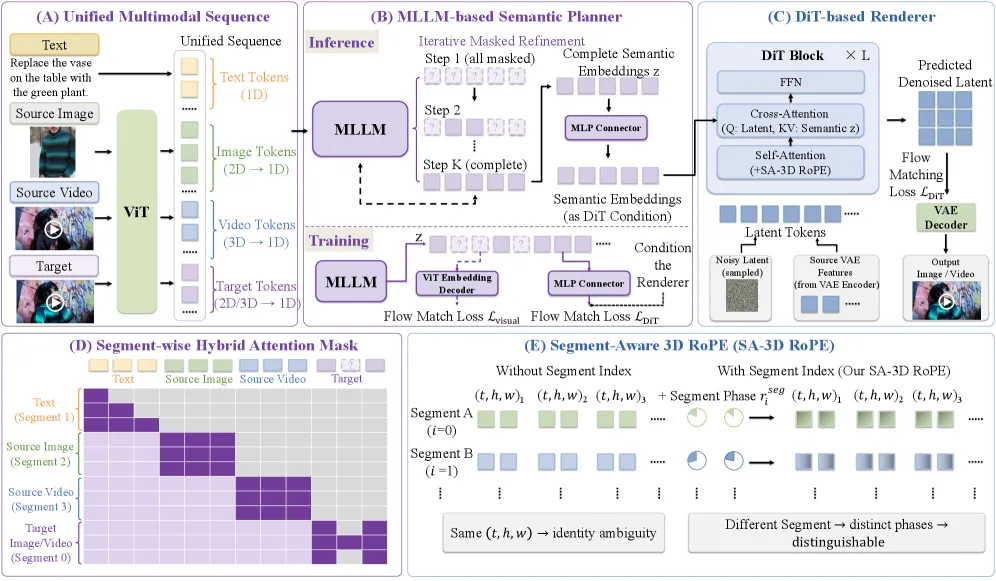
Figure 3: Bernini 总览。(A) 视觉和文本输入序列化为统一 1D 序列。(B) MLLM 规划器从掩码目标预测目标语义 embedding 并条件化渲染器。(C) DiT 渲染器在 VAE latent 空间中进行 flow matching。(D) MLLM 中使用分段混合注意力掩码。(E) SA-3D RoPE 区分不同 segment 的视觉 token。
任务概览
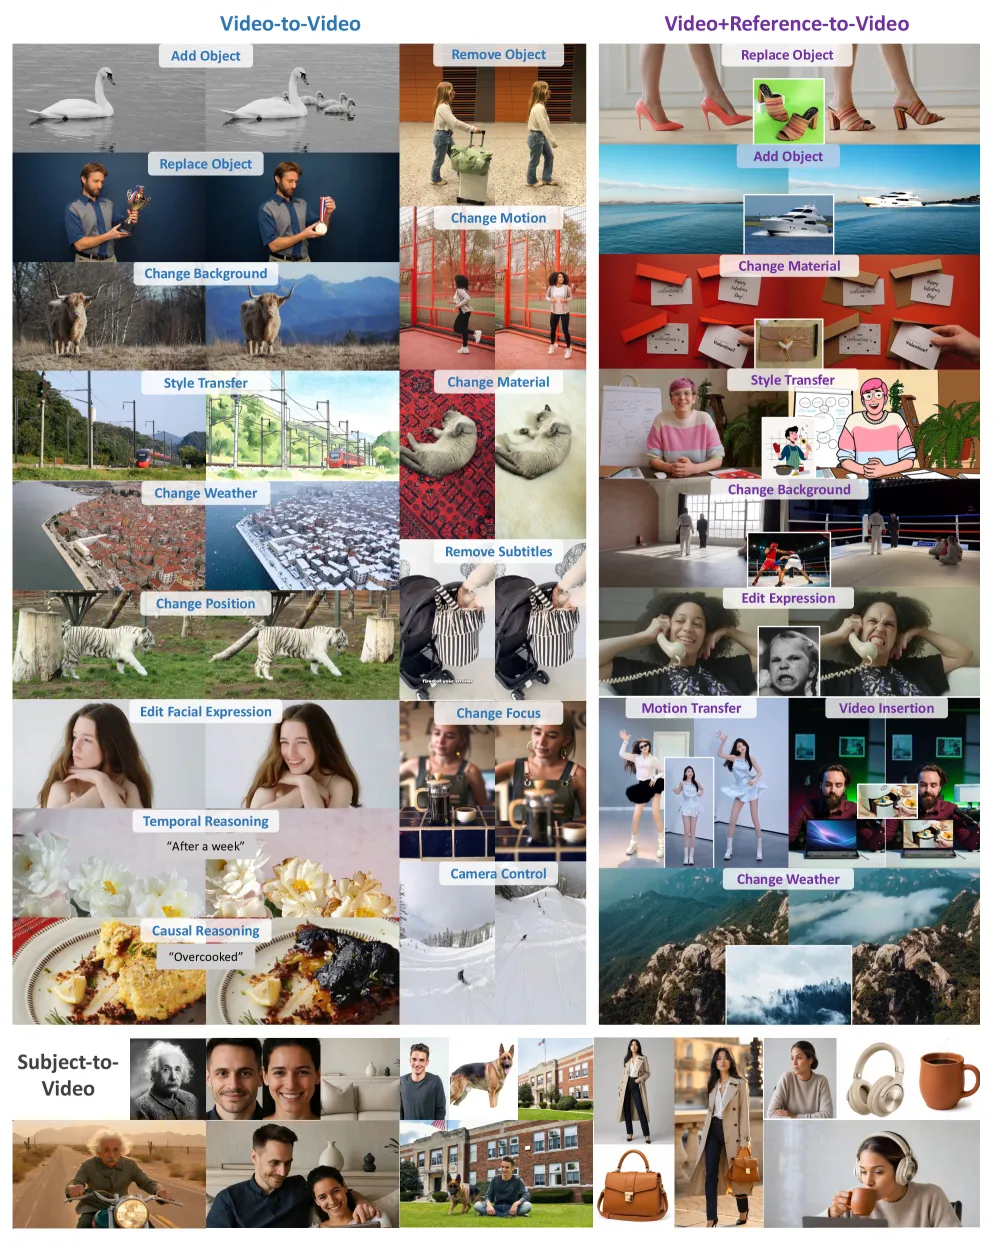
Figure 2: Bernini 在统一框架内支持多种视频生成任务:文本到视频 (T2V)、主体到视频 (R2V)、视频编辑 (V2V)、参考引导视频编辑 (RV2V)。
核心组件
2.1 MLLM-based Planner
统一输入公式: 所有任务实例(T2I、T2V、R2V、V2V、RV2V)被序列化为共享的 token 序列:
\mathbf{z} = \text{MLLM}(\mathbf{t}, \mathbf{v}_1^{src}, \mathbf{v}_2^{src}, \dots, \mathbf{v}_N^{src}, \mathbf{v}^{tgt}) \tag{1}
其中:
- = 输入文本 embedding
- = 第 个源视觉输入的 ViT embedding
- = 源输入数量
- = 目标输出的视觉 embedding(训练时随机掩码,推理时全掩码初始化)
掩码语义规划: 采用掩码生成建模范式。训练时,目标视觉 token 的子集被随机掩码并替换为共享掩码 token。掩码比例从 Beta 分布采样:
r \sim \text{Beta}(\alpha, \beta) \tag{5}
推理时,所有目标视觉 token 初始化为掩码 token,MLLM 通过 步迭代解码逐步填充完整的目标表示。每步的掩码比例调度为:
ViT Embedding Decoder: 由 MLP 和基于 ResNet 的预测头组成,使用 flow-matching 目标在 ViT embedding 空间中训练。
2.2 DiT-based Renderer
DiT 渲染器在 VAE latent 空间中执行扩散,使用 MLLM 的上下文化隐藏状态 作为条件特征,并通过交叉注意力注入。对于编辑任务,额外注入源输入的 VAE 特征以保持细节和一致性。
基座模型: Qwen2.5-VL-7B 作为 MLLM 规划器,Wan2.2-A14B 作为 DiT 渲染器。
2.3 Segment-Aware 3D RoPE (SA-3D RoPE)
当 Bernini 将所有视觉输入和输出拼接为统一序列时,来自不同 segment 的 token 可能共享相同的 坐标,难以区分不同身份。
SA-3D RoPE 为每个视觉 segment 分配索引 (目标 segment ,输入 segment ),并将 segment 索引直接融入旋转位置编码:
\tilde{\mathbf{r}}_{t,h,w,i} = \mathbf{r}_{t,h,w} \odot \mathbf{r}_i^{seg} \tag{2}
其中 表示元素级复数乘法。这在原始时空相位之上引入了 segment 依赖的全局相位调制,允许注意力区分不同 segment 的 token,同时保持 3D RoPE 的原始时空建模属性。
2.4 Chain-of-Thought (CoT) 推理
规划器配备 CoT 机制,在 latent 空间中执行推理后再产生最终 embedding,放大理解对生成的贡献。
训练目标
整体训练目标为三个损失的加权和:
\mathcal{L} = \lambda_{text}\mathcal{L}_{ntp} + \lambda_{visual}\mathcal{L}_{visual} + \lambda_{dit}\mathcal{L}_{dit} \tag{3}
其中:
- = 标准 next-token prediction 损失(保持 MLLM 理解能力)
- = ViT embedding 空间中的 flow-matching 目标
- = VAE latent 空间中的 flow-matching 目标
训练流程
采用三阶段训练流程:
| 阶段 | 优化目标 | 分辨率 | 学习率 | EMA | 数据组成 |
|---|---|---|---|---|---|
| Stage I | MLLM | 256p | 1e-5 | 0.999 | T2I 13%, T2V 19%, I2I 3%, V2V 1%, I2V 1%, IV2V 1%, V.P. 15%, I.P. 21%, Int. 6%, Und. 20% |
| Stage II | DiT | 480p | 1e-5 | 0.9995/0.9999 | T2I 31/20%, T2V 42/30%, I2I 4/40%, V2V 0.4/3.3%, I2V 0.4/3.5%, IV2V 0.3/3.2%, V.P. 11%, I.P. 11% |
| Stage III | All | 480p | 1e-5 | 0.9995/0.999 | T2I 16/12%, T2V 24/18%, I2I 32/24%, V2V 2/2%, I2V 2/2%, IV2V 2/2%, Und. 20%, CoT 20% |
- Stage I: MLLM 预训练,将 MLLM 从纯理解模型转变为语义规划器
- Stage II: DiT 预训练,独立训练渲染器
- Stage III: 轻量级联合训练,对齐语义规划与视觉渲染
数据构建
Bernini 使用大规模多任务语料库训练,包括:
| 数据类型 | 说明 | 规模 |
|---|---|---|
| Video-pair Data | 从 T2V 语料构建的视频对 | 20M 视频对 |
| Image Editing | 多样化图像编辑数据 | - |
| Video-to-Video Editing | 基于传播和运动感知的高质量编辑 | - |
| Ref-image-guided | 参考图像引导的视频生成和编辑 | - |
| Ref-video-guided | 参考视频引导的视频生成 | - |
| Reasoning-augmented | 推理增强的视频数据 | - |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| ViT Embedding 语义接口 | 使用 MLLM 自身的 ViT embedding 空间作为语义桥接 | 预训练表示自然对齐,最小化适配 |
| 掩码语义规划 | 基于掩码生成建模的 MLLM 规划器 | Beta 分布掩码比例,迭代精细化 |
| SA-3D RoPE | Segment-Aware 3D 旋转位置编码 | 相位调制解决多 segment 歧义 |
| CoT 推理 | MLLM 规划器中的链式思维推理 | 潜在空间推理增强理解到生成的转化 |
| 三阶段训练 | 独立预训练 + 轻量联合训练 | 保持各组件预训练优势 |
| 统一框架 | 同一架构支持 T2V/R2V/V2V/RV2V | 无需任务特定架构 |
五、实验结果
Bernini-Bench
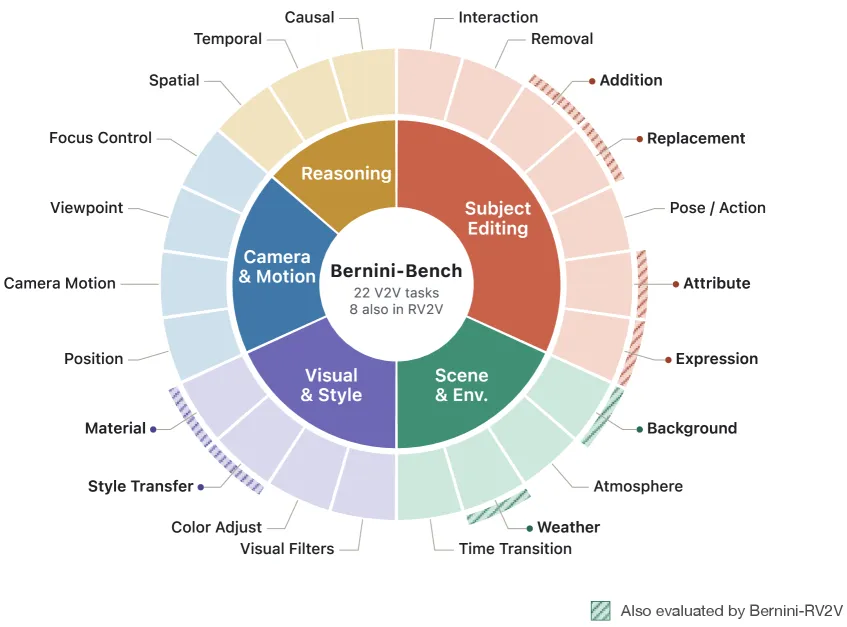
Figure 12: Bernini-Bench 总览。基准涵盖 5 个维度的 22 种细粒度 V2V 编辑任务:主体编辑、场景与环境、视觉与风格、相机与运动、推理。
- 300 个测试用例,涵盖 22 种编辑类别
- 两种输入设置:V2V 和 RV2V
- 评估维度:指令遵循 (IF)、视频一致性 (VC)、参考图像一致性 (IC)、生成质量 (GQ)、总分 (OS)
视频编辑结果
Bernini-Bench 定量结果
| 方法 | V2V OS | V2V IF | V2V VC | V2V GQ | RV2V OS | RV2V IF | RV2V VC | RV2V IC | RV2V GQ |
|---|---|---|---|---|---|---|---|---|---|
| UniVideo | 2.44 | 2.58 | 3.30 | 3.16 | 2.36 | 2.67 | 3.15 | 2.87 | 2.82 |
| VINO | 2.85 | 3.08 | 3.14 | 3.26 | 2.25 | 2.64 | 2.17 | 3.51 | 3.06 |
| Kling O3 | 3.05 | 3.25 | 3.09 | 3.44 | 3.14 | 3.41 | 3.14 | 3.61 | 3.30 |
| Wan2.7 | 3.30 | 3.57 | 3.11 | 3.56 | 3.58 | 3.82 | 3.48 | 3.62 | 3.43 |
| Bernini | 3.49 | 3.66 | 3.51 | 3.49 | 3.50 | 3.75 | 3.51 | 3.54 | 3.31 |
OpenVE-Bench 结果
| 方法 | Overall | Global | Style | Background | Local Change | Local Remove | Local Add | Subtitle | Creative | Camera |
|---|---|---|---|---|---|---|---|---|---|---|
| VINO | 3.18 | 4.34 | 2.54 | 3.73 | 3.22 | 2.77 | 2.61 | 3.29 | 2.81 | - |
| Bernini | 4.04 | 4.45 | 3.31 | 4.85 | 4.16 | 3.43 | 3.57 | 3.91 | 4.67 | - |
EditVerse 结果
| 方法 | Editing Quality | Pick Score | Frame | Video | CLIP | DINO |
|---|---|---|---|---|---|---|
| EditVerse | 7.65 | 20.07 | 26.73 | 23.93 | 98.56 | 98.42 |
| Bernini | 8.02 | 20.26 | 27.37 | 24.62 | 98.55 | 98.37 |
视频编辑排行榜
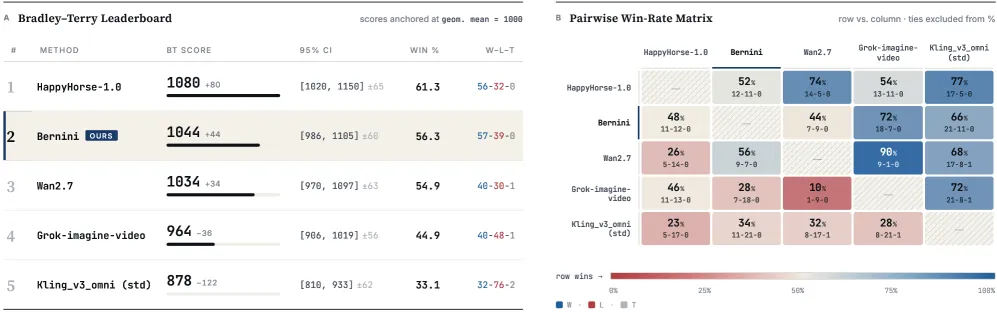
Figure 1: 视频编辑排行榜。开放视频编辑的人类偏好成对评估。(A) 排行榜。(B) 胜率矩阵。Bernini: 480p/24fps; 基线: 720p/24fps。
GSB 胜率
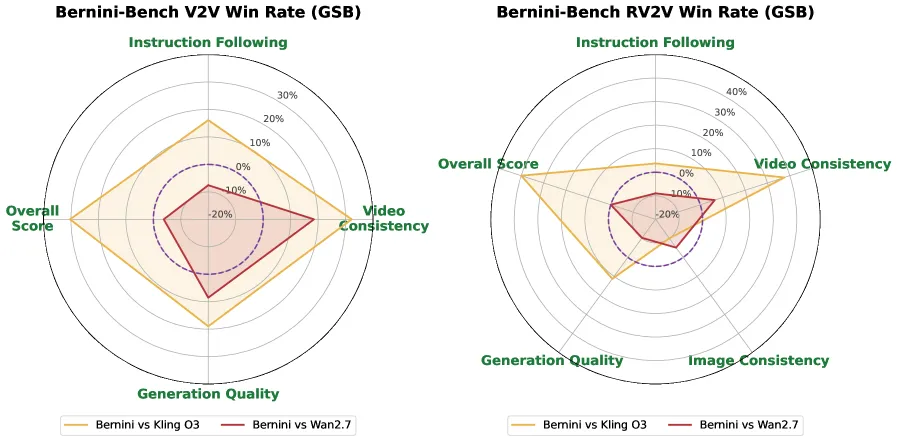
Figure 13: Bernini-Bench 上的 GSB 胜率。Bernini 对比 Kling O3 和 Wan2.7 在 V2V 和 RV2V 上的相对胜率。
主体到视频生成
| 方法 | Total | Aesth. | Motion Smooth. | Motion Ampl. | FaceSim | GmeScore | NexusScore | NaturalScore |
|---|---|---|---|---|---|---|---|---|
| Kling O3 | 59.19 | 48.05 | 92.94 | 24.47 | 57.20 | 66.44 | 45.53 | 70.51 |
| RefAlign-14B | 60.42 | 46.84 | 97.61 | 22.48 | 55.23 | 68.32 | 48.52 | 73.63 |
| Bernini | 62.94 | 44.14 | 93.66 | 23.39 | 78.20 | 65.35 | 46.95 | 70.51 |
关键发现: FaceSim 78.20,超越次优 Kling O3(57.20)超过 20 个绝对点,展示了极强的人脸身份保持能力。
文本到视频生成 (VBench)
| 方法 | Total | Quality | Semantic | Aesthetic | Dynamic degree | Object class | Overall consist. |
|---|---|---|---|---|---|---|---|
| Sora | 84.28 | 85.51 | 79.35 | 63.46 | 79.91 | 93.93 | 26.26 |
| Veo3 | 85.06 | 85.70 | 82.49 | 63.81 | 72.43 | 93.89 | 27.88 |
| Wan2.2-A14B | 84.79 | 85.33 | 82.61 | 67.06 | 69.72 | 96.00 | 27.36 |
| Bernini | 84.64 | 85.18 | 82.49 | 64.68 | 81.11 | 95.41 | 27.83 |
关键发现: Bernini 的 T2V 能力与基座模型 Wan2.2-A14B 基本持平,同时扩展了编辑和参考生成能力。Dynamic degree 达到 81.11(最优)。
推理增强编辑
| 方法 | OS | IF | VC | GQ |
|---|---|---|---|---|
| Baseline | 3.12 | 3.36 | 3.18 | 3.37 |
| + PE (Qwen2.5-VL-7B) | 3.20 | 3.43 | 3.21 | 3.39 |
| + Self-text | 3.33 | 3.55 | 3.31 | 3.44 |
| + PE (GPT-5.4) | 3.49 | 3.66 | 3.51 | 3.49 |
| + PE (GPT-5.4) + Self-visual-text | 3.52 | 3.65 | 3.54 | 3.49 |
关键发现: 丰富的推理上下文持续提升性能。视觉-文本推理比纯文本推理提供互补收益。
消融实验
SA-3D RoPE 消融
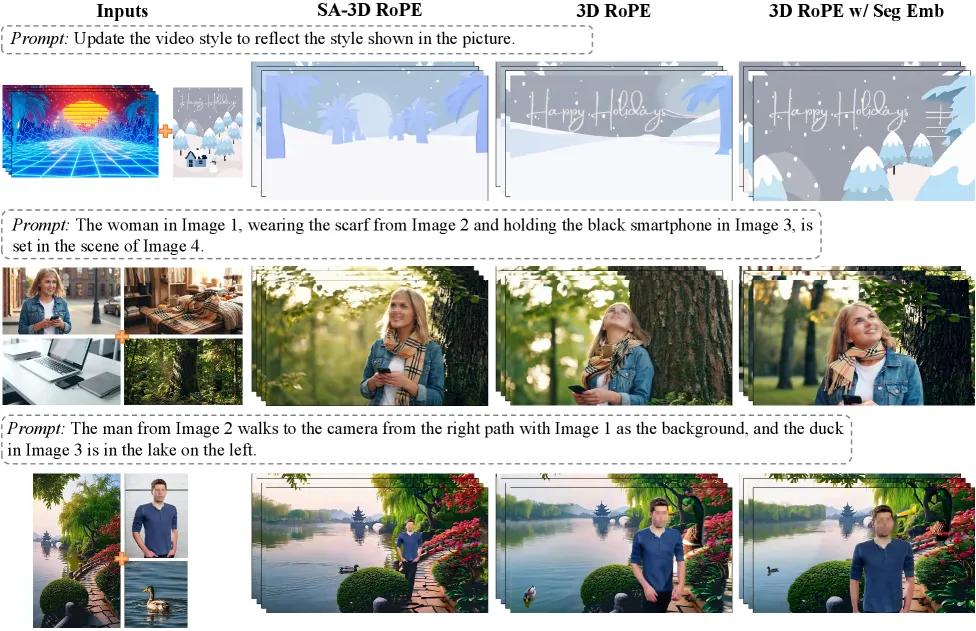
Figure 15: SA-3D RoPE 消融。标准 3D RoPE 和带 segment embedding 的 3D RoPE 在参考引导视频编辑和主体到视频任务上的对比。
关键发现: 加性 segment embedding 在多个视觉 segment 共享相同 坐标时不足以可靠区分角色,导致参考图像的外观细节泄漏到目标的非预期区域。SA-3D RoPE 通过 segment 索引条件化的相位调制将 segment 身份与时空位置解耦。
ViT 语义接口和 MLLM 规划器消融
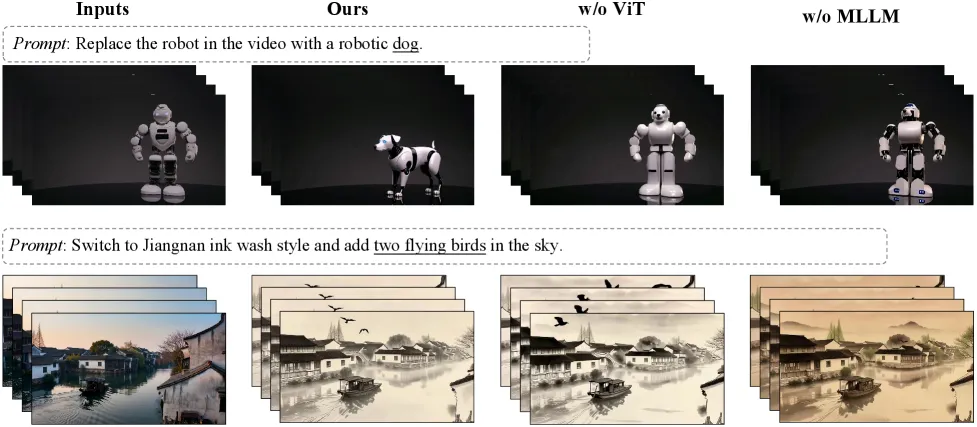
Figure 16: ViT 语义接口和 MLLM 规划器的消融。
关键发现: ViT embedding decoder 和 MLLM 规划器对高质量视频编辑都至关重要。移除 ViT 语义接口导致指令遵循能力减弱;同时移除 ViT 和 MLLM 进一步降低结果质量。
六、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| Qwen2.5-VL | 用作 MLLM 规划器的基座模型 |
| Wan2.2-A14B | 用作 DiT 渲染器的基座模型 |
| VINO | 视频编辑对比方法 |
| Kling O3 | 视频编辑和 R2V 对比方法 |
| Wan2.7 | 视频编辑对比方法 |
| VACE-14B | 视频编辑对比方法 |
| MAR | 掩码自回归范式,启发了掩码语义规划 |
| Flow Matching | 渲染器的去噪方法 |
七、总结
核心贡献
- 统一框架: 提出 Bernini,使用 MLLM 的 ViT embedding 空间作为语义桥接,统一视频生成和编辑
- 数据构建流水线: 设计大规模多任务语料库,涵盖视频/图像对预训练、高质量编辑数据、参考引导生成数据、推理增强数据
- SOTA 性能: 在视频编辑(OpenVE-Bench、EditVerse、FiVE、Bernini-Bench)和主体到视频(OpenS2V)基准上达到 SOTA
- SA-3D RoPE: 提出 Segment-Aware 3D 旋转位置编码解决多 segment 歧义
- CoT 推理: 在 MLLM 规划器中引入链式思维推理
技术影响
- 语义接口设计: 将 MLLM 的 ViT embedding 空间作为语义桥接是一个优雅的设计,避免了离散 token 化的信息损失
- 独立训练 + 轻量联合训练: 保持各组件预训练优势,训练高效
- 理解到生成的迁移: MLLM 的预训练理解能力直接迁移到多样化生成任务
- 统一架构: 无需任务特定架构即可支持 T2V/R2V/V2V/RV2V
局限性
- 依赖基础模型能力:在复杂编辑场景中仍依赖强 LLM 重写器提供足够详细的指令
- 视觉质量:虽然编辑一致性达到 SOTA,但视觉质量仍不如更强的闭源系统(如 Wan2.7)
- 更强大的基础模型实例化可能有助于进一步提升结果
八、参考资源
- 论文: arXiv:2605.22344
- 项目页: bernini-ai.github.io
- 许可: CC BY 4.0