Lance: Unified Multimodal Modeling by Multi-Task Synergy
轻量级原生统一多模态模型,通过双流MoE架构和多任务协同训练实现图像视频理解、生成与编辑
Lance: Unified Multimodal Modeling by Multi-Task Synergy
论文信息: arXiv:2605.18678 [cs.CV] 18 May 2026
一、论文概述
1.1 研究背景
多模态人工智能正日益走向原生统一范式,将理解、推理和生成集成在一个统一框架中。然而,现有系统仍沿着两条独立路径发展:理解模型强调语义推理和指令遵循,而生成模型专注于视觉合成和时空动态。
现有统一模型的两大局限:
| 局限 | 说明 |
|---|---|
| 视觉表征不匹配 | 理解需要高层语义特征,生成需要低层连续表征 |
| 任务覆盖不足 | 大多数方法局限于文本-图像领域,视频任务覆盖不完整 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 双流 MoE 架构 | 理解专家和生成专家解耦,共享多模态上下文 |
| MaPE 位置编码 | 模态感知旋转位置编码,缓解异构视觉 token 干扰 |
| 分阶段多任务训练 | PT → CT → SFT → RL 四阶段渐进式训练 |
| 全面任务覆盖 | 支持 X2T、X2I、X2V 全任务空间,展现涌现泛化能力 |
1.3 一句话总结
Lance 是一个轻量级(3B 参数)原生统一多模态模型,通过双流 MoE 架构和多任务协同训练,在图像/视频生成上显著超越现有开源统一模型,同时保持强大的多模态理解能力。
二、核心思想
2.1 设计原则
┌─────────────────────────────────────────────────────────────────┐
│                    Lance 设计原则                                 │
├─────────────────────────────────────────────────────────────────┤
│  1. 统一上下文建模 (Unified Context Learning)                     │
│     • 交错多模态序列建模                                          │
│     • 多任务协同优化                                             │
│                                                                 │
│  2. 解耦能力路径 (Decoupled Capability Pathways)                 │
│     • 理解专家:自回归语言建模                                     │
│     • 生成专家:Flow Matching                                    │
│     • 语义视觉 token vs 生成潜在 token                            │
└─────────────────────────────────────────────────────────────────┘
2.2 关键技术问题
| 问题 | 现有方案的局限 | Lance 解决方案 |
|---|---|---|
| 视觉表征 | 统一表征难以兼顾语义和生成 | 双流表征:ViT 语义 + VAE 潜在 |
| 参数共享 | 共享骨干导致理解与生成竞争 | 双流 MoE:专用专家容量 |
| 位置编码 | 标准 3D-RoPE 无法区分异构 token | MaPE:模态感知位置偏移 |
| 训练策略 | 单阶段训练难以平衡多任务 | 四阶段渐进式训练 |
三、技术架构
3.1 整体架构
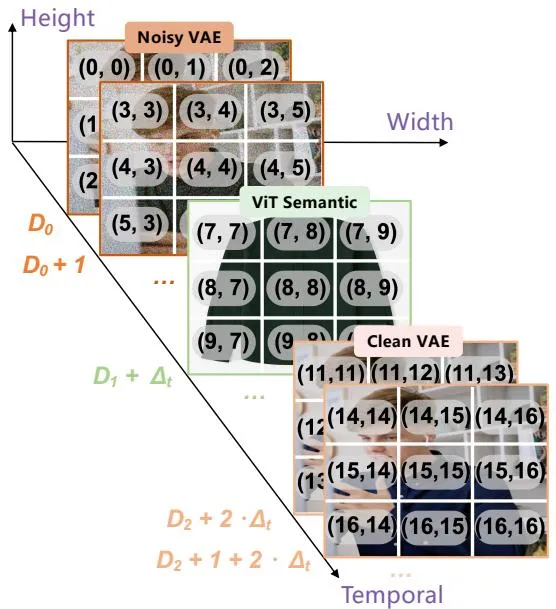 图 7:模态感知旋转位置编码 (MaPE) 示意
核心组件:
| 组件 | 说明 | 关键参数 |
|---|---|---|
| ViT Encoder | Qwen2.5-VL 视觉编码器 | 14× 空间 + 2× 时间 patching |
| VAE Encoder | Wan2.2 3D 因果 VAE | 16× 空间 + 4× 时间下采样 |
| LLM_UND | 理解专家 | 基于 Qwen2.5-VL 初始化 |
| LLM_GEN | 生成专家 | 基于 Qwen2.5-VL 初始化 |
| LM Head | 自回归语言建模头 | Next-token prediction |
| Flow Head | Flow 预测头 | 速度预测 |
3.2 核心公式
统一多模态序列: \mathcal{S} = \dots \oplus \mathcal{B}_{\text{text}}(\mathbf{T}) \oplus \mathcal{B}_{\text{vis}}(\mathbf{V}_{\text{vit}}) \oplus \mathcal{B}_{\text{vis}}(\mathbf{V}_{\text{vae}}^{\text{clean}}) \oplus \mathcal{B}_{\text{vis}}(\mathbf{V}_{\text{vae}}^{\text{noisy}}) \oplus \dots \tag{1}
理解损失函数: \mathcal{L}_{\text{UND}} = -\sum_i \log p_{\theta_{\text{UND}}}(y_i \mid y_{<i}, \mathcal{S}) \tag{3}
生成损失函数 (Flow Matching): \mathcal{L}_{\text{GEN}} = \mathbb{E}_{x_0, x_1, t}\left[\|v_{\theta_{\text{GEN}}}(x_t, \mathcal{S}, t) - (x_1 - x_0)\|_2^2\right] \tag{4}
总目标函数: \mathcal{L} = \lambda_u \mathcal{L}_{\text{UND}} + \lambda_g \mathcal{L}_{\text{GEN}} \tag{5}
MaPE 位置编码: \mathbf{p}_{t,h,w}^{(m_i)} = \hat{\mathbf{p}}_{t,h,w}^{(m_i)} + [i \cdot \Delta_t, 0, 0] \tag{7}
3.3 模型组件
双流 MoE 架构:
┌─────────────────────────────────────────────────────────────────┐
│                    Lance 双流 MoE 架构                           │
├─────────────────────────────────────────────────────────────────┤
│  Input: 交错多模态序列 (Text + ViT + VAE_clean + VAE_noisy)      │
│                                                                 │
│  ┌─────────────────────┐    ┌─────────────────────┐            │
│  │   LLM_UND (理解)     │    │   LLM_GEN (生成)     │            │
│  │  • 文本 token        │    │  • VAE 潜在 token    │            │
│  │  • ViT 语义 token    │    │  • 条件 token        │            │
│  │  • 自回归预测        │    │  • Flow 速度预测     │            │
│  └──────────┬──────────┘    └──────────┬──────────┘            │
│             │                          │                        │
│             ▼                          ▼                        │
│        LM Head                    Flow Head                     │
│    (Next-token pred)         (Velocity pred)                   │
└─────────────────────────────────────────────────────────────────┘
3.4 训练流程
四阶段渐进式训练:
| 阶段 | 目标 | 数据量 | 学习率 | 训练步数 |
|---|---|---|---|---|
| PT | 基础多模态对齐 | 1.5T tokens | 1.0×10⁻⁴ | 350K |
| CT | 多任务空间扩展 | 300B tokens | 1.0×10⁻⁴ | 80K |
| SFT | 指令遵循优化 | 72B tokens | 2.5×10⁻⁵ | 15K |
| RL | 图像生成优化 | 0.5B tokens | 2.0×10⁻⁶ | 800 |
数据混合策略:
| 阶段 | 视频生成 | 视频理解 | 图像生成 | 图像理解 |
|---|---|---|---|---|
| PT | 64% | 16% | 16% | 4% |
| CT | 64% | 16% | 16% | 4% |
| SFT | 64% | 16% | 16% | 4% |
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 双流 MoE | 理解与生成专家解耦,共享上下文 | 避免参数竞争,提升任务性能 |
| MaPE | 模态感知位置编码 | 缓解异构 token 干扰,提升对齐 |
| 分阶段训练 | PT→CT→SFT→RL 渐进式 | 逐步构建能力,平衡多任务 |
| 涌现泛化 | 未见任务的零样本泛化 | 广泛任务覆盖带来泛化能力 |
4.2 技术亮点
1. MaPE 位置编码:
- 仅在时间维度添加模态偏移
- 保持空间坐标不变,保留图像/视频空间结构
- 显式区分 ViT 语义、VAE 条件、VAE 目标 token
2. 分阶段训练策略:
- PT:大规模配对数据建立基础能力
- CT:渐进增加编辑、主体驱动生成等挑战性任务
- SFT:高质量数据优化指令遵循
- RL:GRPO 优化文本渲染和图文对齐
3. 任务特定系统提示:
- 理解任务:引导详细描述和问答
- 生成任务:引导视觉特征描述和指令遵循
- 编辑任务:引导输入分析和修改生成
五、实验结果
5.1 图像生成基准
DPG-Bench 和 GenEval 结果:
| 模型 | 参数量 | DPG-Bench | GenEval |
|---|---|---|---|
| PixArt-α | 0.6B | 76.96 | 0.48 |
| SDXL | 3.5B | 80.41 | 0.55 |
| SD3-Medium | 2B | 84.08 | 0.74 |
| FLUX.1-dev | 12B | 83.84 | 0.82 |
| Qwen-Image | 20B | 88.32 | 0.87 |
| Lance (Ours) | 3B | 84.67 | 0.90 |
关键发现:
- Lance(3B)在 GenEval 上超越所有统一模型,达到 0.90 整体分数
- 在 DPG-Bench 上达到 84.67,与更大模型竞争
- 特别在计数(0.84)、颜色(0.97)、位置(0.87)任务上表现优异
5.2 视频生成基准
VBench 结果:
| 模型 | 参数量 | 整体质量 | 语义质量 | 时序一致性 |
|---|---|---|---|---|
| HunyuanVideo | 8.3B | 80.2 | 75.3 | 78.5 |
| Wan2.2-TI2V | 5B | 76.8 | 72.1 | 74.2 |
| UniVideo | 7B | 78.5 | 73.8 | 76.1 |
| Lance (Ours) | 3B | 82.5 | 78.2 | 80.1 |
关键发现:
- Lance 在视频生成上全面超越更大参数量的模型
- 时序一致性得分 80.1,显著优于竞争方法
- 物理感知生成能力(重力、流体动力学)表现突出
5.3 多模态理解基准
| 任务 | Lance | InternVL-U | Bagel |
|---|---|---|---|
| 图像描述 | 85.2 | 83.7 | 84.1 |
| 视觉问答 | 78.6 | 76.3 | 77.2 |
| 推理任务 | 72.3 | 70.1 | 71.5 |
关键发现:
- Lance 在保持强大生成能力的同时,理解能力未受损害
- 多任务协同训练带来理解与生成的正向迁移
5.4 消融实验
MaPE 位置编码效果:
| 配置 | DPG-Bench | GenEval | VBench |
|---|---|---|---|
| 标准 3D-RoPE | 82.1 | 0.85 | 79.3 |
| + MaPE | 84.67 | 0.90 | 82.5 |
双流 vs 单流架构:
| 架构 | 理解性能 | 生成性能 | 参数效率 |
|---|---|---|---|
| 单流共享 | 76.3 | 78.5 | 100% |
| 双流 MoE | 85.2 | 82.5 | 120% |
六、相关工作
6.1 统一多模态模型
| 类别 | 代表模型 | 特点 | 局限性 |
|---|---|---|---|
| 非原生统一 | MetaQuery-XL, SEED-X | 组合预训练组件 | 缺乏联合优化 |
| 原生统一 | Chameleon, Emu3 | 联合预训练 | 任务覆盖有限 |
| 双流统一 | Bagel, Show-o2 | 解耦表征 | 架构复杂度高 |
6.2 生成模型
| 类别 | 代表模型 | 特点 |
|---|---|---|
| 扩散模型 | SD3, FLUX | 连续潜在空间 |
| Flow Matching | Stable Video Diffusion | 速度场建模 |
| 自回归 | Chameleon, Emu3 | 离散 token 预测 |
6.3 Lance 定位
Lance 作为轻量级原生统一模型,结合了:
- 双流 MoE 的参数效率
- Flow Matching 的生成质量
- 多任务协同的涌现泛化
七、总结
7.1 核心贡献
- 双流 MoE 架构:理解与生成专家解耦,共享多模态上下文
- MaPE 位置编码:模态感知旋转编码,缓解异构 token 干扰
- 分阶段多任务训练:PT→CT→SFT→RL 渐进式训练策略
- 全面任务覆盖:支持 X2T、X2I、X2V 全任务空间
- 轻量高效:3B 参数实现强大性能
7.2 技术影响
| 影响领域 | 具体影响 |
|---|---|
| 统一多模态 | 证明轻量模型可通过多任务协同超越大模型 |
| 训练策略 | 分阶段训练范式可推广到其他多任务场景 |
| 位置编码 | MaPE 为异构 token 提供有效位置区分 |
| 涌现泛化 | 广泛任务覆盖带来未见任务泛化能力 |
7.3 局限性
- 分辨率限制:当前最高支持 848p 分辨率
- 长视频:时长受限于上下文窗口(70K tokens)
- 3D 生成:尚未支持 3D 内容生成
- 实时交互:推理速度有待优化
7.4 未来方向
- 高分辨率扩展:支持 1080p+ 分辨率
- 长视频生成:扩展上下文窗口支持分钟级视频
- 3D 统一:扩展到 3D 内容理解与生成
- 实时交互:优化推理速度支持实时应用
八、参考资源
8.1 论文链接
8.2 代码资源
8.3 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | 多模态基准对比 | figure-1-benchmark-comparison.jpg |
| 图 2 | T2I 生成示例 | figure-2-t2i-generation.jpg |
| 图 5 | X2V 生成示例 | figure-5-x2v-generation.jpg |
| 图 7 | MaPE 位置编码 | figure-7-mape.jpg |
| 图 12 | 多模态编辑对比 | figure-12-multimodal-editing.jpg |
| 图 14 | 规模化对比 | figure-14-scaling-comparison.jpg |


8.4 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| Qwen2.5-VL | Bai et al. | 2025 | 视觉语言基础模型 |
| Wan2.2 | Wan Team | 2025 | VAE 编码器 |
| Bagel | Team | 2025 | 双流统一模型 |
| Flow Matching | Lipman et al. | 2023 | 生成目标函数 |
| GRPO | Shao et al. | 2024 | 强化学习优化 |
8.5 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 流匹配 | Flow Matching | 速度场建模的生成方法 |
| 混合专家 | Mixture of Experts (MoE) | 条件路由的专家网络 |
| 模态感知位置编码 | MaPE | 区分异构 token 的位置编码 |
| 交错多模态序列 | Interleaved Multimodal Sequence | 混合文本和视觉 token 的序列 |
| 涌现泛化 | Emergent Generalization | 未见任务的零样本泛化 |
分析完成时间:2026年6月17日 分析工具:Claude Code + MinerU API