Salt: Self-Consistent Distribution Matching with Cache-Aware Training for Fast Video Generation
面向快速视频生成的自洽分布匹配与缓存感知训练框架
Salt: Self-Consistent Distribution Matching with Cache-Aware Training for Fast Video Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Salt: Self-Consistent Distribution Matching with Cache-Aware Training for Fast Video Generation |
| 作者 | Xingtong Ge, Yi Zhang, Yushi Huang, Dailan He, Xiahong Wang, Bingqi Ma, Guanglu Song, Yu Liu, Jun Zhang |
| 论文 | arXiv:2604.03118 |
| 代码 | GitHub: XingtongGe/Salt |
| 发布 | 2026年4月3日 |
二、核心思想
问题定义
将视频生成模型蒸馏到极低推理预算(如 2-4 NFEs)对实时部署至关重要,但仍然具有挑战性。现有方法存在两个结构性瓶颈:
-
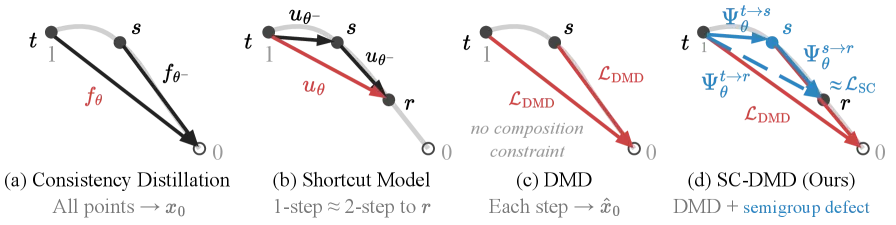
DMD 的组合性缺陷 (Compositionality Deficit):分布匹配蒸馏 (DMD) 的训练信号是纯局部的——每个噪声级别独立监督,不显式约束去噪更新如何在时间步之间组合。这导致多步采样时误差累积,产生过曝和语义退化。
-
自回归生成中的 KV 缓存质量变化:在自回归视频生成中,每个新生成的 chunk 依赖之前 chunk 的 KV 缓存作为条件。缓存质量随推理步数变化(高步数 → 高质量缓存,低步数 → 噪声缓存),导致训练-推理分布不匹配。
解决方案概述
本文提出 Salt 框架,包含两个核心组件:
-
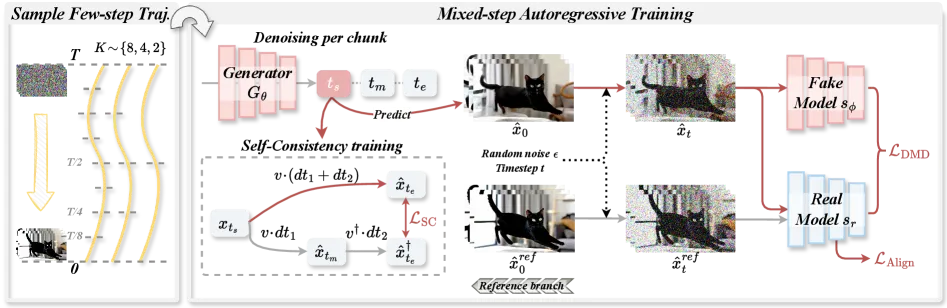
SC-DMD (Self-Consistent Distribution Matching Distillation):在 DMD 基础上增加半群缺陷正则化器 (semigroup-defect regularizer),强制连续去噪更新的端点一致性,解决组合性缺陷。
-
Cache-Condition-Aware Training:通过混合步数 rollout 和缓存条件参考对齐,系统性覆盖训练中遇到的各种缓存质量,提高自回归生成的鲁棒性。
三、技术架构
整体框架图
核心公式
基础:Flow Map 与半群性质
扩散/流匹配模型的概率流 ODE:
诱导的时间步到时间步传输算子(flow map):
精确 ODE flow map 满足半群(组合)律:
DMD 的组合性缺陷
DMD 在采样的噪声级别上进行局部分布匹配监督:
问题:DMD 仅监督当前步的输出分布,不惩罚相邻更新在组合下的交互,导致多步推理时误差累积。
SC-DMD:半群缺陷正则化
给定三元组 其中 ,计算:
- 直接(单步)端点:
- 组合(两步)端点:
自一致性损失:
网格设计:在更细的训练网格 (如 )上训练,采样快捷三元组:
总训练目标:
Cache-Condition-Aware Training
混合步数 Rollout:每次迭代采样 ,用对应调度运行 chunk-wise 自回归 rollout,暴露不同 rollout 保真度产生的 KV 缓存模式。SC-DMD 正则化仅在 时激活(最长组合链)。
缓存条件参考对齐:对低质量缓存条件 () 的输出,向更高质量参考(, )对齐。使用 TRD 风格的关系特征空间:
对齐损失(带 margin 松弛):
完整自回归训练目标:
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 学生速度场 | 几步去噪的参数化速度场 | 与教师模型同架构 |
| DMD 评判器 | 匹配学生/教师分布的分数网络 | 标准 DMD 交替更新 |
| SC 正则化器 | 半群缺陷惩罚,轻量级 | 仅额外一次前向传播 |
| 缓存对齐模块 | TRD 风格特征关系匹配 | margin |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| DMD 组合性缺陷识别 | 首次系统识别 DMD 纯局部训练信号导致多步推理退化 | 实验:增加训练步数(4→8→16)反而降低质量 |
| SC-DMD 半群缺陷正则化 | 用轻量级自一致性损失强制端点一致性组合 | DMD-8: 82.54 → SC-DMD: 83.19 (Total) |
| 混合步数 Rollout | 采样 覆盖不同缓存质量 | 使 SC 正则化在 AR 设置中有效 |
| 缓存条件参考对齐 | 低质量缓存输出向高质量参考对齐 | 2-NFE: 84.63 → 84.80 (Total) |
| 统一框架 | 同时支持非自回归和自回归视频生成 | 在多种骨干网络上一致改进 |
五、实验结果
非自回归少步蒸馏(Wan 2.1 14B I2V,4-NFE)
| 方法 | NFE | I2V Score | Quality | Backg. Consist. | Motion Smooth. | Dynamic Degree | Imaging Quality |
|---|---|---|---|---|---|---|---|
| PCM | 8 | 93.63 | 78.52 | 97.34 | 98.24 | 30.98 | 70.42 |
| DMD | 4 | 93.09 | 78.89 | 92.79 | 97.99 | 58.46 | 70.35 |
| LightX2V | 4 | 93.50 | 80.92 | 95.87 | 97.89 | 60.33 | 71.67 |
| Salt (Ours) | 4 | 93.90 | 80.86 | 95.97 | 98.37 | 52.85 | 72.16 |
| Salt-α | 4 | 93.88 | 81.71 | 95.46 | 98.30 | 68.13 | 72.08 |
5 秒视频生成 VBench(Wan 2.1 1.3B)
| 模型 | 参数 | 分辨率 | NFE | Total | Quality | Semantic |
|---|---|---|---|---|---|---|
| 扩散模型 | ||||||
| rCM | 1.3B | 832×480 | 4 | 82.73 | 83.65 | 79.04 |
| DMD | 1.3B | 832×480 | 4 | 82.78 | 84.39 | 76.36 |
| SC-DMD (Ours) | 1.3B | 832×480 | 4 | 83.19 | 84.42 | 78.30 |
| SC-DMD (Ours) | 1.3B | 832×480 | 2 | 82.85 | 84.06 | 78.01 |
| 自回归模型 | ||||||
| CausVid | 1.3B | 832×480 | 4 | 81.20 | 84.05 | 69.80 |
| Self Forcing | 1.3B | 832×480 | 4 | 84.20 | 84.74 | 82.05 |
| Salt-Self Forcing | 1.3B | 832×480 | 4 | 84.47 | 85.27 | 81.28 |
| LongLive | 1.3B | 832×480 | 4 | 84.40 | 85.12 | 81.53 |
| Salt-LongLive | 1.3B | 832×480 | 4 | 84.93 | 85.41 | 83.00 |
| Causal Forcing | 1.3B | 832×480 | 4 | 84.62 | 85.41 | 81.47 |
| Salt-Causal Forcing | 1.3B | 832×480 | 4 | 85.08 | 85.96 | 81.59 |
30 秒自回归生成 VBench-Long
| 模型 | Total | Quality | Semantic | Subject Consist. | Temp. Flicker. | Motion Smooth. |
|---|---|---|---|---|---|---|
| Causal Forcing 系列 | ||||||
| Causal Forcing | 78.11 | 82.57 | 60.25 | 96.29 | 95.47 | 97.67 |
| Salt-Causal Forcing | 78.28 | 82.15 | 62.77 | 97.16 | 96.95 | 98.32 |
| LongLive 系列 | ||||||
| LongLive | 79.03 | 82.82 | 63.88 | 97.36 | 96.62 | 98.16 |
| Salt-LongLive | 79.27 | 82.90 | 64.74 | 97.28 | 96.92 | 98.29 |
消融实验
SC-DMD 消融(Wan 2.1 1.3B T2V,4 步推理)
| 方法 | Quality | Semantic | Total | Spatial Rel. | Multi-Objects | Object Class | Imaging Q. |
|---|---|---|---|---|---|---|---|
| DMD-8 | 84.05 | 76.50 | 82.54 | 67.13 | 78.98 | 93.47 | 65.46 |
| DMD-4 | 84.39 | 76.36 | 82.78 | 69.49 | 79.37 | 93.23 | 64.73 |
| SC-DMD | 84.42 | 78.30 | 83.19 | 72.32 | 85.72 | 95.16 | 66.40 |
关键发现:单纯增加训练网格密度(DMD-4 → DMD-8)并不能改善少步生成,反而导致质量退化。SC-DMD 通过半群缺陷正则化一致提升所有指标。
自回归训练组件消融(Causal Forcing)
| 方法 | NFE | Quality | Semantic | Total |
|---|---|---|---|---|
| Causal Forcing (baseline) | 4 | 85.41 | 81.47 | 84.62 |
| + naive | 4 | 84.35 | 81.77 | 83.83 |
| + mixed-step + | 4 | 85.91 | 81.48 | 85.02 |
| Salt (full) | 4 | 85.96 | 81.59 | 85.08 |
| + mixed-step + | 2 | 85.62 | 80.65 | 84.63 |
| Salt (full) | 2 | 85.63 | 81.49 | 84.80 |
关键发现:
- 直接在 AR 设置中加 反而损害性能(84.62 → 83.83)
- 混合步数 rollout 是 SC 正则化在 AR 设置中生效的必要条件
- 参考对齐在低预算 (2-NFE) 时更有帮助
六、与现有方法对比
训练轨迹对比
| 方法 | 训练信号类型 | 组合性约束 | 分布匹配 |
|---|---|---|---|
| 一致性蒸馏 | 轨迹级回归 | 隐式(端点一致性) | 无 |
| Shortcut Models | 组合一致性 | 显式(自蒸馏) | 无 |
| Flow Map 蒸馏 | 连续半群律 | 显式(主要目标) | 无 |
| DMD | 局部分布匹配 | 无 | 显式 |
| SC-DMD (Salt) | 分布匹配 + 半群正则 | 显式(正则化器) | 显式 |
DMD 组合性缺陷可视化
跨步数一致性对比
七、相关工作
| 方向 | 代表工作 | 与 Salt 的关系 |
|---|---|---|
| 一致性蒸馏 | LCM, PCM | 轨迹级回归,缺乏分布匹配 |
| DMD 系列 | DMD, DMD2, DMD-X | Salt 的基础,解决其组合性缺陷 |
| Flow Map 蒸馏 | AYF | 连续半群约束,Salt 用作正则化器 |
| Shortcut Models | SD3.5 | 组合一致性自蒸馏,Salt 借鉴思想 |
| 实时视频生成 | Self Forcing, Causal Forcing, LongLive | Salt 的 AR 骨干网络 |
八、总结
核心贡献
- 识别 DMD 组合性缺陷:首次系统证明 DMD 的纯局部训练信号无法约束多步推理的组合一致性
- SC-DMD 框架:用轻量级半群缺陷正则化器(仅一次额外前向传播)解决组合性缺陷
- 缓存条件感知训练:混合步数 rollout + 参考对齐,覆盖自回归生成中的 KV 缓存质量变化
- 统一框架:在非自回归(Wan 2.1)和自回归(Self Forcing, Causal Forcing, LongLive)设置上一致改进
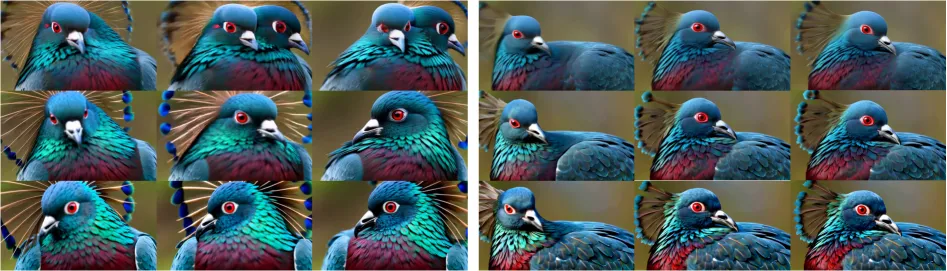
- 跨步数鲁棒性:SC-DMD 在 2/4/8 步推理下均保持一致质量,而非仅优化单一操作点
技术影响
- 为少步视频生成蒸馏提供了新的正则化范式
- 半群缺陷正则化思想可推广到其他序列生成任务
- 缓存条件感知训练对自回归扩散模型有广泛适用性
- 统一的非自回归/自回归框架降低了方法迁移成本
局限性
- 代码尚未发布(承诺将发布)
- SC-DMD 仅在 时激活,对更长组合链的扩展性待验证
- 参考对齐依赖启发式调度,可能需要针对不同任务调优
- 计算开销:SC-DMD 增加一次前向传播,混合步数 rollout 增加训练复杂度
九、参考资源
- 论文: arXiv:2604.03118
- 代码: GitHub: XingtongGe/Salt
- 关键引用:
- DMD (Distribution Matching Distillation)
- Wan 2.1 (骨干视频生成模型)
- Self Forcing / Causal Forcing / LongLive (自回归实时视频生成)
分析日期: 2026-06-05