DIAL: Decoupling Intent and Action via Latent World Modeling
End-to-End VLA with Differentiable Latent Intent Bottleneck
DIAL: Decoupling Intent and Action via Latent World Modeling for End-to-End VLA
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DIAL: Decoupling Intent and Action via Latent World Modeling for End-to-End VLA |
| 作者 | Yi Chen, Yuying Ge, Hui Zhou, Mingyu Ding, Yixiao Ge, Xihui Liu |
| 机构 | XPeng Robotics (小鹏机器人) |
| 论文 | arXiv:2603.29844 |
| 代码 | 项目主页 |
| 发布 | 2026-03-31 (v2: 2026-04-28) |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
现有的端到端 Vision-Language-Action (VLA) 模型将预训练 VLM 主要用作多模态编码器,直接将视觉-语言特征映射到低级动作。这种范式存在三个核心问题:
- VLM 潜力未充分利用:VLM 被当作被动的特征编码器,其高级决策能力被忽视
- 训练不稳定:端到端训练容易导致模型崩溃,退化 VLM 的预训练知识
- 语义表示退化:直接映射会破坏 VLM 丰富的语义表示
解决方案概述
DIAL 提出通过可微分潜在意图瓶颈(differentiable latent intent bottleneck)桥接高级决策和低级运动执行:
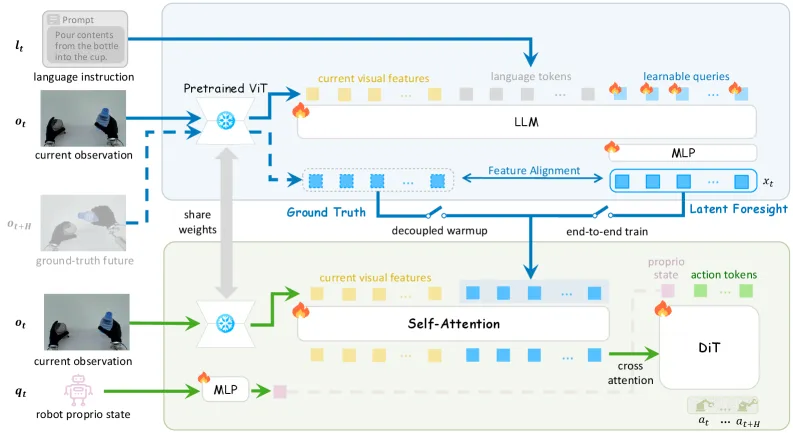
- System-2 (VLM):作为潜在世界模型,在 VLM 原生 ViT 特征空间中合成潜在视觉前瞻(latent visual foresight),显式编码意图
- System-1 (策略):轻量级潜在逆动力学模型,将预测意图与当前观察解码为精确的机器人动作
- 两阶段训练:解耦预热阶段 + 端到端联合优化,确保训练稳定性
三、技术架构
整体框架图
VLA 架构对比
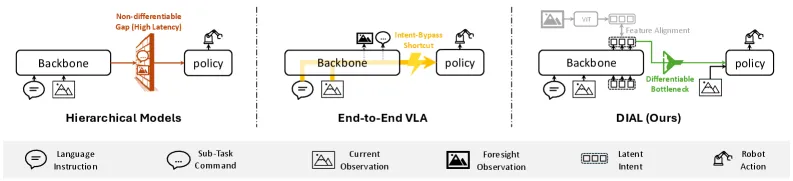
| 架构类型 | 代表方法 | 问题 |
|---|---|---|
| 分层式 | LLM 文本规划 + 下游策略 | 非可微间隙,部署延迟高 |
| 端到端 | 直接特征→动作映射 | 训练崩溃,知识退化 |
| DIAL | 潜在意图瓶颈 + 逆动力学 | 结构化解耦,梯度稳定 |
核心公式
潜在视觉前瞻生成 (System-2):
其中 为语言指令, 为当前视觉观察, 为 个可学习查询。
潜在逆动力学解码 (System-1):
其中 SA 为自注意力, 为 System-1 的可学习查询, 为动作块大小。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| VLM Backbone | Qwen2.5-VL-3B | ViT + LLM |
| System-2 MLP Head | 潜在意图合成 | 输出 ViT 特征维度 |
| System-1 DiT | 潜在逆动力学 | 自注意力 + 流匹配 |
| 可学习查询 | System-2: N=64, System-1: M=128 | 跨系统共享 |
| 视觉分辨率 | 224×224 | 统一输入 |
| 动作块大小 | H=16 (仿真), H=50 (真实) | 预测未来动作 |
两阶段训练
阶段一:解耦预热 (Decoupled Warmup)
- System-2 学习预测潜在未来状态(使用 GT 未来作为监督)
- System-1 在 GT 未来引导下学习运动控制
- 两个系统独立优化,确保稳定初始化
阶段二:端到端联合优化
- System-2 合成的预测前瞻作为 System-1 的输入
- 动作感知梯度以受控方式细化 VLM backbone
- 保持预训练知识的同时提升控制能力
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 潜在意图瓶颈 | 通过可微分潜在空间桥接语义推理和运动控制 | 避免分层式的非可微间隙 |
| 潜在世界建模 | 在 VLM 原生 ViT 特征空间中合成视觉前瞻 | 保持语义一致性,避免跨流形翻译 |
| 潜在逆动力学 | System-1 作为逆动力学模型解码意图→动作 | 结构化瓶颈防止捷径学习 |
| 解耦预热训练 | 两阶段训练确保稳定性和知识保持 | 消除模型崩溃,10x 数据效率 |
| 跨具身学习 | 利用异构人类演示学习物理接地的操作先验 | 零样本泛化到未见物体和配置 |
五、代码实现分析
项目结构
- 项目主页: https://xpeng-robotics.github.io/dial
- VLM Backbone: Qwen2.5-VL-3B (冻结 ViT,微调 LLM)
- System-1: 基于 DiT 的流匹配模型
- 训练框架: PyTorch,两阶段训练流程
关键实现细节
- ViT 编码器保持冻结以维持特征对齐
- 可学习查询在两个系统间共享同一潜在空间
- 人类演示数据通过手腕 EEF 姿态对齐到机器人状态空间
- 动作预测使用流匹配(flow matching)而非扩散
六、实验结果
仿真基准测试 (RoboCasa GR1 Tabletop)
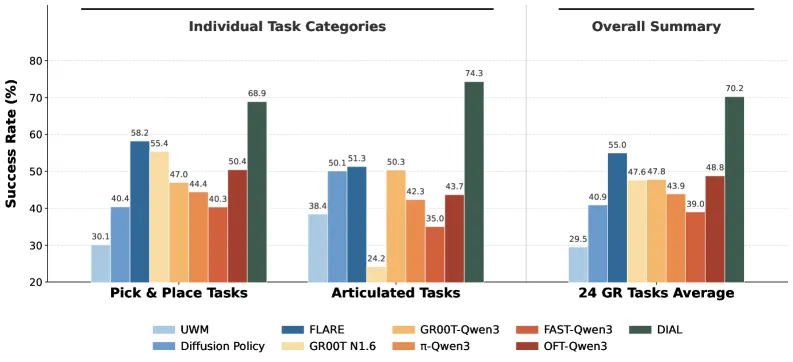
全数据设置 (24,000 轨迹):
| 方法 | 平均成功率 | Pick & Place | Articulated |
|---|---|---|---|
| Diffusion Policy | 32.4% | 28.3% | 40.0% |
| UWM | 38.6% | 34.1% | 48.3% |
| FLARE | 55.0% | 51.7% | 61.7% |
| GR00T-N1.6 | 47.6% | 44.2% | 55.0% |
| DIAL | 70.2% | 68.9% | 74.3% |
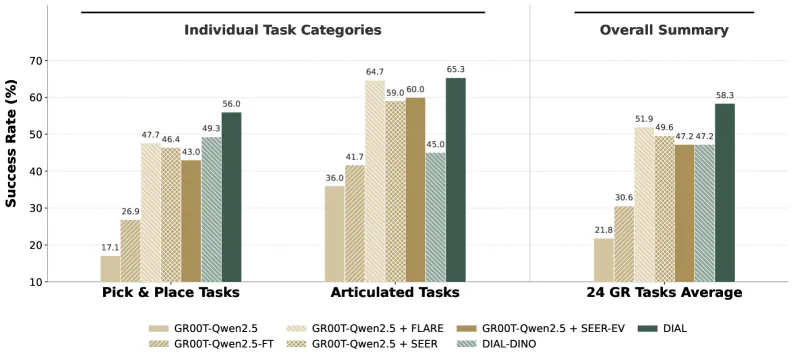
少样本设置 (2,400 轨迹,10x 减少):
| 方法 | 平均成功率 |
|---|---|
| GR00T-Qwen2.5 (frozen) | 21.8% |
| GR00T-Qwen2.5 (-FT) | 30.6% |
| + FLARE | 51.9% |
| + SEER | 49.6% |
| + SEER-EV | 47.2% |
| DIAL-DINO | 47.2% |
| DIAL | 58.3% |
关键发现: DIAL 用 10x 更少的数据(58.3%)超过了 FLARE 用全数据训练的结果(55.0%)。
消融实验
架构设计消融:
- 世界建模目标:+30% 成功率提升(21.8% → 50%+)
- 结构化瓶颈:比松散耦合(SEER/FLARE)高 6-11%
- 特征对齐:DINO 替换导致 11% 性能下降(58.3% → 47.2%)
人类数据影响:
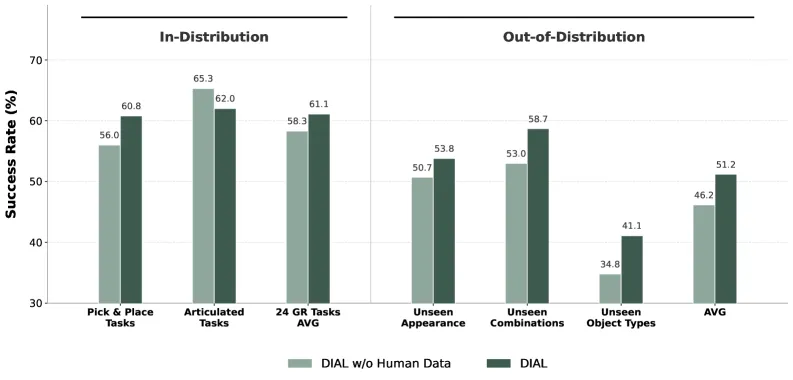
| 设置 | Pick & Place | OOD 平均 |
|---|---|---|
| 仅机器人数据 | 56.0% | 46.2% |
| + 人类数据 | 60.8% | 51.2% |
真实世界实验
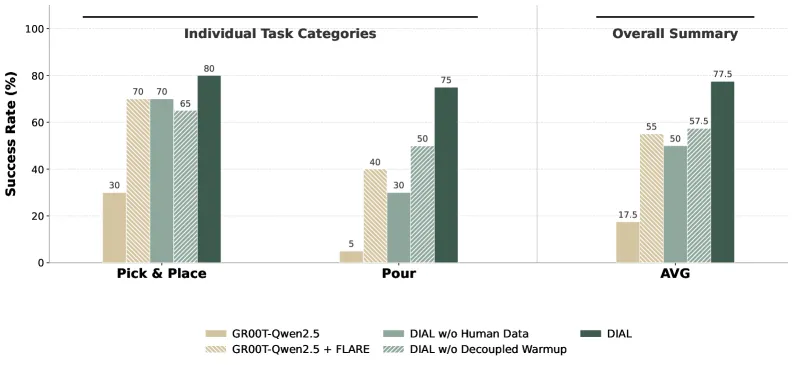
跨具身学习任务 (分布内):
| 方法 | Pick & Place | Pouring | 平均 |
|---|---|---|---|
| GR00T-Qwen2.5 | 50.0% | 50.0% | 50.0% |
| GR00T-Qwen2.5 + FLARE | 62.5% | 55.0% | 58.8% |
| GR00T-Qwen2.5 + SEER | 57.5% | 57.5% | 57.5% |
| DIAL (w/o human) | 75.0% | 70.0% | 72.5% |
| DIAL | 85.0% | 80.0% | 82.5% |
解耦预热的重要性:
- 无预热:分布内 57.5%,OOD 30.0%
- 有预热:分布内 77.5%,OOD 58.3%
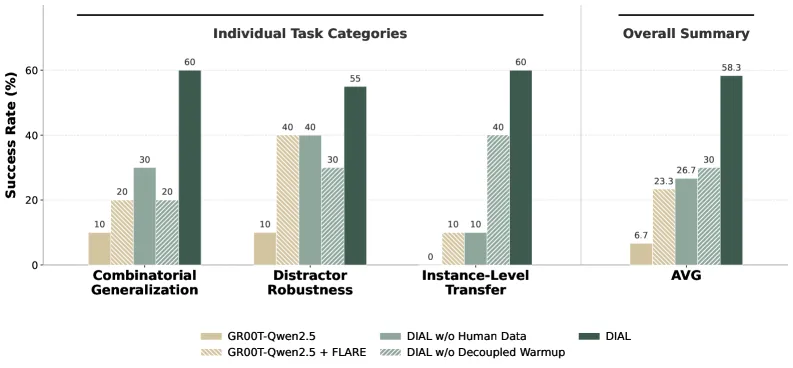
OOD 泛化结果:
| 方法 | 组合泛化 | 干扰物鲁棒 | 实例迁移 | 平均 |
|---|---|---|---|---|
| GR00T-Qwen2.5 + FLARE | 60.0% | 40.0% | 40.0% | 46.7% |
| DIAL (w/o human) | 60.0% | 60.0% | 33.3% | 51.1% |
| DIAL | 80.0% | 80.0% | 60.0% | 73.3% |
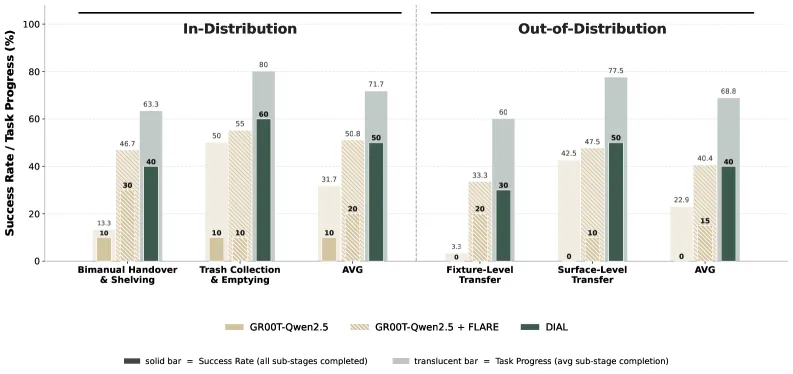
多阶段协调任务:
| 方法 | Handover (分布内) | Sweeping (分布内) | Handover (新货架) | Sweeping (新桌布) |
|---|---|---|---|---|
| GR00T-Qwen2.5 + FLARE | 50.0% | 30.0% | 0.0% | 0.0% |
| GR00T-Qwen2.5 + SEER | 50.0% | 30.0% | 0.0% | 0.0% |
| DIAL | 90.0% | 80.0% | 70.0% | 70.0% |
潜在表示可视化
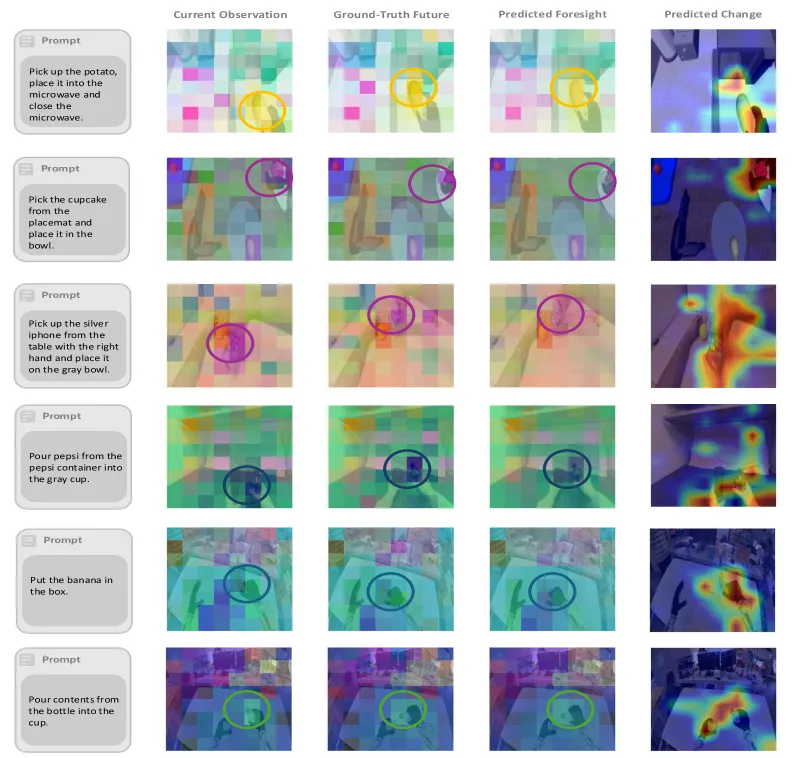
PCA 可视化显示:
- 预测前瞻与 GT 未来在任务相关区域高度对齐
- 预测前瞻与当前观察在预期变化区域显著不同
- 证明 System-2 主动预测有意义的状态转换,而非仅重建当前场景
七、相关工作
分层式 VLA
- LLM/VLM 作为语义规划器生成文本子任务或代码
- 视频扩散模型预测像素级目标图像
- 问题:非可微接口阻碍基础模型获取动作感知动态
端到端 VLA
- 早期方法:将动作作为离散文本 token
- 双系统架构趋势:VLM (System-2) + 轻量级连续动作专家 (System-1)
- 问题:端到端训练导致模型崩溃,VLM 被降级为被动编码器
世界建模
- 视频预训练初始化策略
- SEER:前瞻特征作为动作生成的显式条件
- FLARE:查询 token 对齐中间特征与视觉前瞻
- 问题:大多数方法将前瞻作为辅助任务或简单附加到长上下文序列
八、总结
核心贡献
- 提出 DIAL 框架,通过潜在意图瓶颈实现认知决策与运动执行的结构化解耦
- 设计潜在世界建模(System-2)+ 潜在逆动力学(System-1)的双系统架构
- 引入两阶段训练范式(解耦预热 + 端到端优化),确保训练稳定性
- 在 RoboCasa GR1 仿真基准上建立新 SOTA(70.2%),10x 数据效率
- 在真实世界人形机器人上验证鲁棒性和零样本泛化能力
技术影响
- 潜在意图瓶颈作为通用接口,支持 VLM 和动作专家的独立迭代
- 跨具身学习范式,利用人类演示提升机器人泛化能力
- 为构建通用具身智能体提供可扩展的架构范式
局限性
- System-1 使用较小的 DiT 骨干,复杂任务精度有限
- ViT 编码器保持冻结,可能限制视觉表示学习
- 未来方向:端到端微调 ViT、利用无动作人类视频预训练
九、参考资源
- 论文: arXiv:2603.29844
- 项目主页: https://xpeng-robotics.github.io/dial
- 相关工作:
- FLARE (2025) - 流匹配框架 + 未来潜在对齐
- SEER (2025) - 前瞻特征作为动作生成条件
- GR00T-N1.6 (2026) - 双系统 VLA 架构
- π-VLA (2026) - KV 缓存的逐层 VLM 表示
- EgoDex (2024) - 人类手部操作数据集