Improving Joint Audio-Video Generation with Cross-Modal Context Learning
通过跨模态上下文学习改进联合音视频生成
Improving Joint Audio-Video Generation with Cross-Modal Context Learning
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Improving Joint Audio-Video Generation with Cross-Modal Context Learning |
| 作者 | Bingqi Ma, Linlong Lang, Ming Zhang, Dailan He, Xingtong Ge, Yi Zhang, Guanglu Song, Yu Liu |
| 论文 | arXiv:2603.18600 |
| 代码 | 未公开 |
| 发布 | 2026年3月 |
二、核心思想
问题定义
联合音视频生成(Joint Audio-Video Generation)旨在同时生成时间一致的音频和视频内容。当前主流方法采用双流 Transformer 架构(Dual-Stream Transformer),通过跨模态注意力模块在音频和视频流之间交换信息。然而,现有设计存在三个关键问题:
-
门控机制 (Gating Mechanism) 破坏优化稳定性:二值门控在不同优化目标间切换时,在参数空间中引入分段目标结构,导致梯度方向不稳定,损害收敛过程。
-
跨模态注意力的背景偏差:现有双向跨模态注意力模块中,背景区域的 token 也会被强制参与跨模态交互,引入噪声并降低对齐质量。
-
训练-推理不一致:传统分类器自由引导 (CFG) 在跨模态条件下存在条件冲突问题,特别是视频流对音频流的过强条件引导。
解决方案概述
本文提出 Cross-Modal Context Learning (CCL) 范式,在保留双流 Transformer 架构的基础上,引入以下关键模块:
- TARP (Temporally Aligned RoPE and Partitioning):时间对齐的位置编码和分区机制
- CCA (Cross-Modal Context Attention):包含可学习上下文令牌 (LCT) 和动态上下文路由 (DCR)
- UCG (Unconditional Context Guidance):利用 LCT 作为自然无条件表示的引导策略
三、技术架构
整体框架图
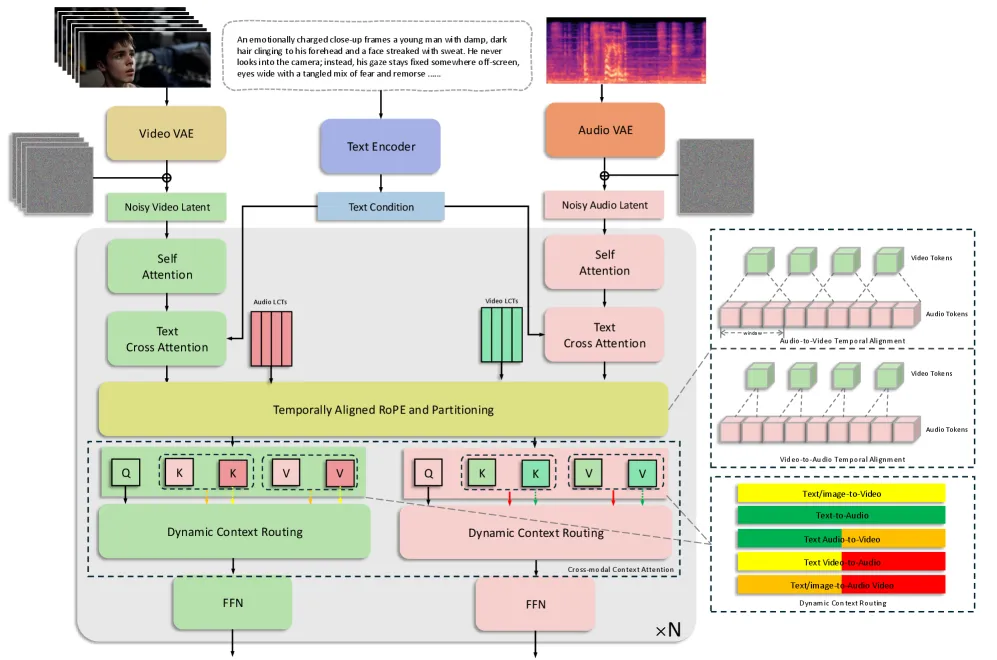
CCL 继承传统双流 Transformer 架构,视频帧通过 3D VAE 压缩到潜在空间,原始音频先转换为 Mel 频谱图再通过音频 VAE 压缩。音频和视频流共享相同层数和整体架构,但音频分支使用更少通道以提高参数效率。
核心公式
门控机制的问题
传统双流 Transformer 块的公式:
其中 为当前模态的潜在表示, 为文本条件, 为另一模态的潜在表示, 为二值门控。
问题:门控状态切换导致参数空间中的分段目标结构,梯度方向不稳定。
TARP: 时间对齐 RoPE 和分区
RoPE 缩放:由于音频 token 数 与视频 token 数 不匹配,对音频的 RoPE 索引进行缩放:
分区机制:每个模态仅需关注另一模态当前时间步附近的局部邻域。设 为每个视频帧对应的音频 token 数,第 个视频帧的窗口中心为:
CCA: 跨模态上下文注意力
可学习上下文令牌 (LCT):
- 音频到视频 CCA:
- 视频到音频 CCA:
LCT 提供来自另一模态的稳定上下文信息,作为背景信息的锚点。LCT 不使用 RoPE(因为其时间不敏感特性)。
动态上下文路由 (DCR):根据任务类型动态调整跨模态交互的强度和方向。
跨注意力计算:
由于 远小于潜在 token 数,额外计算开销可忽略。
UCG: 无条件上下文引导
LCT 在训练后成为自然的无条件表示。两种推理形式:
两步推理(标准 UCG):
三步推理(解耦文本和跨模态引导强度):
多任务训练
在 audio-to-video 和 video-to-audio 训练中,断开参考流的梯度以防止过优化。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 视频流 (Wan2.1-14B) | 视频扩散 Transformer | 14B 参数 |
| 音频流 | 音频扩散 Transformer(与视频同架构但更少通道) | 参数效率优化 |
| 3D VAE | 视频帧压缩到潜在空间 | — |
| 音频 VAE | Mel 频谱图压缩到 1D 潜在表示 | — |
| TARP | 时间对齐 RoPE + 分区机制 | 缩放因子 ,窗口大小 |
| LCT | 可学习上下文令牌 | , |
| DCR | 动态上下文路由 | 任务自适应 |
训练流程
| 阶段 | 学习率 | 步数 | 批大小 |
|---|---|---|---|
| 音频扩散模型预训练 | 160,000 | 3,200 | |
| 联合音视频训练 | 跨模态: , 其他: | 12,000 | 320 |
| 消融实验 | — | 6,000 | 128 |
数据集:百万级音视频对,包括 OpenHumanVid 和内部采集(访谈、短剧、电影),以及学术音频数据集(WavCaps, VGGSound)。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 门控机制问题识别 | 首次系统分析门控机制导致的分段目标结构和梯度不稳定 | 训练损失曲线对比:CCL 收敛更快更稳定 |
| TARP | 时间对齐 RoPE + 分区机制,解决音视频 token 数不匹配 | 消融实验:WER 4.67% → 4.81% (与 LCT/DCR 组合) |
| LCT (可学习上下文令牌) | 提供稳定的跨模态上下文锚点,区分前景/背景 | 注意力可视化:背景 token 更强地关注 LCT |
| DCR (动态上下文路由) | 根据任务类型动态调整跨模态交互 | 消融实验验证各模块贡献 |
| UCG (无条件上下文引导) | 利用 LCT 作为自然无条件表示,消除训练-推理不一致 | 两种推理形式(2步/3步)灵活选择 |
| 多任务训练 | 统一支持 text/image-to-video, text-to-audio, joint AV, audio-to-video, video-to-audio | 梯度断开防止参考流过优化 |
五、实验结果
与现有方法对比(测试集)
| 方法 | 数据量 | CU↑ | PQ↑ | WER↓ | Sync-C↑ (easy) | Sync-D↓ (easy) | Sync-C↑ (hard) | Sync-D↓ (hard) | DeSync↓ (easy) | IB↑ (easy) | DeSync↓ (hard) | IB↑ (hard) |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Ovi | 30.7M | 5.88 | 6.14 | 17.51% | 8.47 | 7.32 | 5.96 | 8.57 | 1.11 | 0.20 | 1.18 | 0.21 |
| LTX-2 | – | 5.12 | 5.35 | 11.04% | 7.67 | 7.90 | 5.47 | 8.93 | 1.18 | 0.19 | 1.20 | 0.21 |
| MOVA | 50M | 6.34 | 7.24 | 8.09% | 7.79 | 7.70 | 5.38 | 8.87 | 1.15 | 0.20 | 1.22 | 0.19 |
| CCL | 4M | 5.71 | 6.42 | 4.62% | 8.45 | 7.48 | 6.12 | 8.25 | 1.11 | 0.23 | 1.19 | 0.22 |
关键发现:
- CCL 仅用 4M 数据(Ovi 的 1/8,MOVA 的 1/12)就大幅超越现有方法
- WER 从 8.09% 降至 4.62%,相对降低 43%
- 唇形同步指标 (Sync-C) 在 easy 和 hard 子集上均最优
- 音视频对齐指标 (DeSync, IB) 表现优异
消融实验
| TARP | LCT/DCR | UCG | SyncCFG | WER↓ | Sync-C↑ | Sync-D↓ | DeSync↓ | IB↑ |
|---|---|---|---|---|---|---|---|---|
| 4.52% | 4.53 | 10.81 | 1.20 | 0.20 | ||||
| ✓ | 4.67% | 5.05 | 10.17 | 1.20 | 0.20 | |||
| ✓ | ✓ | 4.81% | 5.62 | 9.12 | 1.18 | 0.21 | ||
| ✓ | ✓ | ✓ | 4.63% | 6.14 | 8.09 | 1.16 | 0.22 | |
| ✓ | ✓ | ✓ | ✓ | 5.59% | 5.85 | 8.46 | 1.18 | 0.20 |
关键发现:
- 每个模块都对性能有贡献
- TARP + LCT/DCR 组合显著提升 Sync-C(4.53 → 5.62)
- 完整 CCL 达到最佳 WER (4.63%) 和 Sync-D (8.09%)
- 传统 SyncCFG 反而降低 WER 性能(5.59%),验证 UCG 的优越性
训练动态可视化
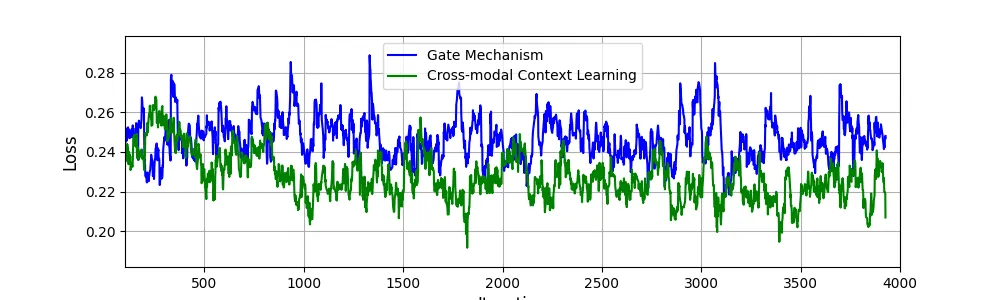
CCL 展现出更快、更稳定的训练损失下降,表明其促进更高效的优化。
注意力图可视化
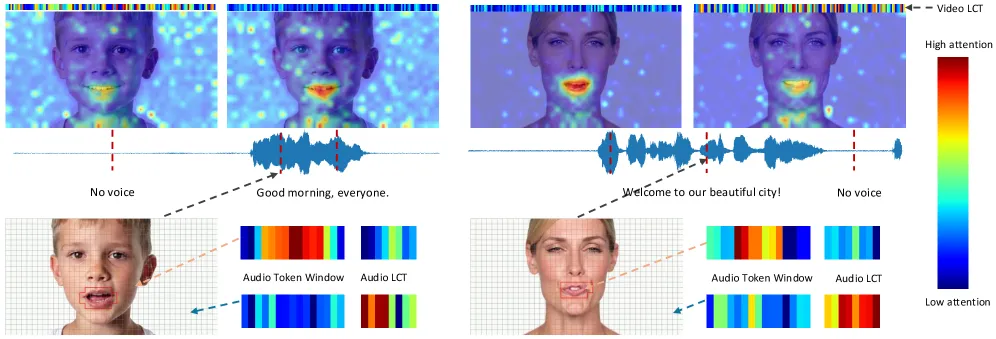
背景 token 在音频和视频模态中都更强烈地关注 LCT,表明 CCL 鼓励模型捕获模态特定的背景模式,形成更清晰的前景/背景分离。
六、能力展示
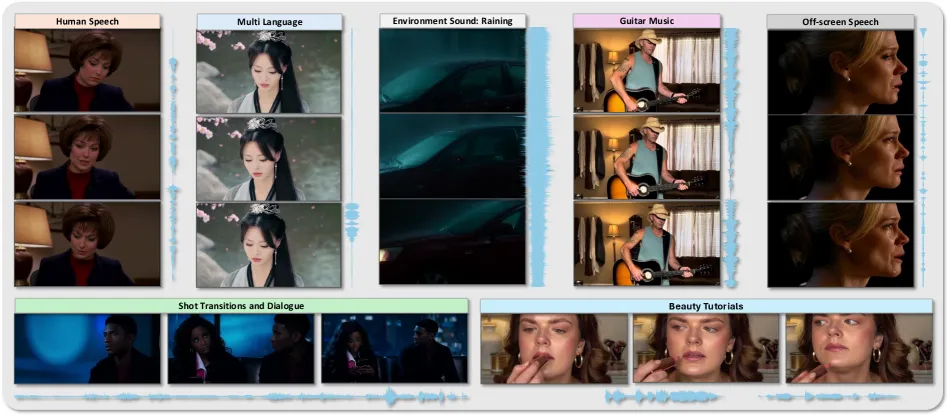
CCL 支持多种生成能力:
- 多语言人声生成
- 环境声合成
- 音乐生成
- 背景语音生成
- 故事板风格内容生成
七、相关工作
| 方向 | 代表工作 | 与 CCL 的关系 |
|---|---|---|
| 视频生成模型 | Wan2.1, Sora2, Kling 3.0, Seedance 2.0 | CCL 的视频流基于 Wan2.1-14B |
| 联合音视频生成 | Ovi, LTX-2, MOVA | CCL 在数据效率和性能上超越 |
| 双流 Transformer | 先前跨模态注意力方法 | CCL 识别并解决门控机制问题 |
| 分类器自由引导 | 传统 CFG, Multi-Modal CFG | CCL 提出 UCG 作为更优替代 |
八、总结
核心贡献
- 系统性问题分析:识别双流 Transformer 中门控机制、跨模态注意力偏差、训练-推理不一致三大问题
- TARP:时间对齐 RoPE 和分区机制,解决音视频 token 数不匹配和时间对齐问题
- CCA 模块:可学习上下文令牌 (LCT) 提供稳定锚点,动态上下文路由 (DCR) 实现任务自适应
- UCG:利用 LCT 作为自然无条件表示,提供 2 步和 3 步两种推理形式
- 数据效率:仅用 4M 数据即大幅超越使用 30-50M 数据的现有方法
- 多任务统一:支持 5 种生成任务(text/image-to-video, text-to-audio, joint AV, audio-to-video, video-to-audio)
技术影响
- 为联合音视频生成提供了新的范式,从门控机制转向上下文学习
- LCT 作为无条件表示的思想可推广到其他多模态生成任务
- 数据效率的提升降低了联合音视频生成的门槛
- 多任务训练框架为统一多模态生成系统提供了参考
局限性
- 代码未公开
- 论文未详细报告各项能力的具体评估指标
- 音频质量 (CU, PQ) 指标略低于 MOVA(数据量更大)
- 未与最新商业系统(Veo3, Sora2 等)进行直接对比
九、参考资源
- 论文: arXiv:2603.18600
- 关键引用:
- Wan2.1 (视频扩散模型骨干)
- Ovi, LTX-2, MOVA (联合音视频生成基线)
- WavCaps, VGGSound (音频数据集)
- OpenHumanVid (音视频数据集)
分析日期: 2026-06-05