AR-CoPO: Align Autoregressive Video Generation with Contrastive Policy Optimization
通过对比策略优化对齐自回归视频生成
AR-CoPO: Align Autoregressive Video Generation with Contrastive Policy Optimization
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | AR-CoPO: Align Autoregressive Video Generation with Contrastive Policy Optimization |
| 作者 | Dailan He, Guanlin Feng, Xingtong Ge, Yi Zhang, Bingqi Ma, Guanglu Song, Yu Liu, Hongsheng Li |
| 论文 | arXiv:2603.17461 |
| 代码 | 未公开 |
| 发布 | 2026年3月 |
二、核心思想
问题定义
流式自回归 (Streaming AR) 视频生成器结合少步蒸馏(如一致性模型)在低延迟部署中展现出巨大潜力。然而,将强化学习从人类反馈 (RLHF) 应用于这类模型面临根本性挑战:
-
SDE-GRPO 与少步生成器的不匹配:现有 GRPO 变体依赖将确定性 ODE 采样转换为随机 SDE 形式来引入马尔可夫决策过程 (MDP)。但少步生成器(一致性模型蒸馏的 ODE)本质上偏离标准流匹配 ODE,难以用 SDE 训练。
-
序列级 RL 的计算成本:在流式 AR 结构中,对整个序列进行 RL 训练需要全序列多分支反向传播,计算成本极高。
-
纯 on-policy 探索的局限:文本对齐 (TA) 等全局语义奖励难以通过局部噪声扰动有效改进。
解决方案概述
本文提出 AR-CoPO (AutoRegressive Contrastive Policy Optimization) 框架:
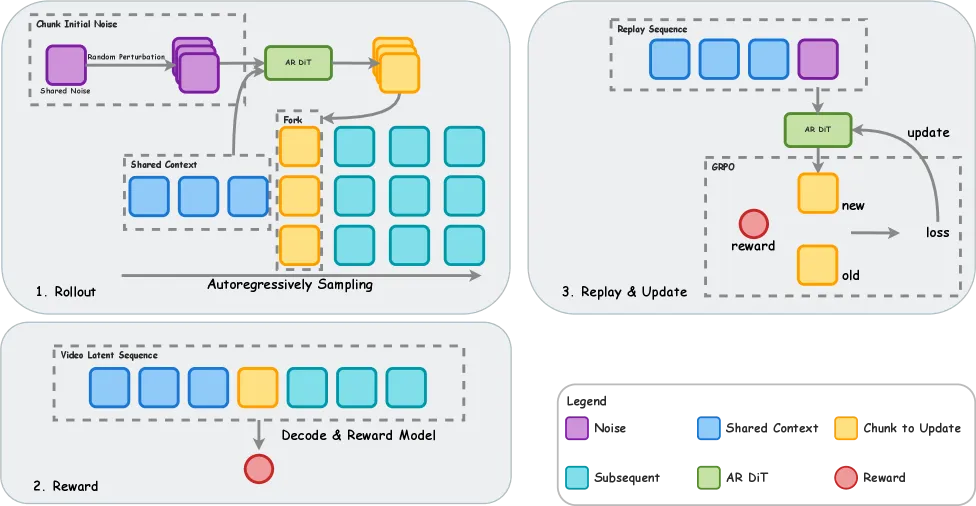
- Chunk-level Alignment via Forking:在随机选择的 pivot chunk 上进行分支,构造邻域候选,将动作空间采样限制在单个 chunk 级别
- CoPO for Consistency Model Alignment:使用距离驱动的对比目标(而非 SDE 探索)进行策略优化
- Semi-On-Policy Alignment:结合 on-policy 探索和 semi-on-policy 利用,通过 LoRA 合并整合两者优势
三、技术架构
整体框架图
核心公式
基础:Neighbor GRPO
Neighbor GRPO 将 SDE 策略优化重新解释为距离驱动的对比学习目标。通过扰动共享初始噪声 构造邻域候选:
其中 控制探索半径。
替代策略分布(基于 anchor 潜在 与候选 的距离):
GRPO 目标(最大化正优势候选的权重):
其中 为组归一化优势。
AR-CoPO: Chunk-level Forking
三阶段训练流程:
-
共享上下文生成:随机采样 pivot chunk 索引 ,模型顺序生成前 个 chunk 建立共享历史上下文
-
动作空间分支:在第 个 chunk,基于共享基础噪声 构造 个扰动邻域噪声 ,每个分支完成 步去噪生成 chunk 潜在
-
Rollout 与序列级奖励:每个分支确定性生成剩余 个 chunk(无进一步扰动),计算序列级奖励
受控噪声共享:在每次训练迭代中,唯一不同分支间的随机性来源是 pivot chunk 的初始噪声 。所有其他噪声序列在所有 分支间共享。
优势:
- 反向传播严格限制在单个 pivot chunk 的 步,避免全序列多分支反向传播的高昂成本
- 奖励差异可直接归因于 pivot chunk 的生成选择,提供稳定的信用分配信号
Semi-On-Policy Alignment
问题:纯 on-policy 探索对文本对齐 (TA) 奖励效果有限——局部噪声扰动产生语义相似的输出,奖励方差小。
解决:补充 semi-on-policy 利用范式:
- 固定所有 rollout 到参考策略 (初始化检查点)
- 预收集大量参考候选的 replay buffer
- 在固定 rollout 上应用对比 AR-CoPO 目标
信任域约束:通过 ratio clipping 防止分布偏移,确保策略对任何单个参考 rollout 的响应有界。
LoRA 合并
On-policy 和 semi-on-policy 目标互补,独立优化:
- On-policy LoRA:探索和奖励改进
- Semi-on-policy LoRA:利用和整体质量
- 推理时合并两个 LoRA 适配器
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 基础模型 | Self-Forcing / Causal-Forcing | 流式 AR 视频生成器 |
| 奖励套件 | VideoAlign | TA (文本对齐) + VQ (视频质量) + MQ (运动质量) |
| 邻域构造 | 初始噪声扰动 | , 个候选 |
| Pivot chunk | 随机选择的分支点 | |
| LoRA 适配器 | On-policy + Semi-on-policy | 推理时合并 |
训练设置
| 参数 | 值 |
|---|---|
| 基础模型 | Self-Forcing |
| 训练数据 | MovieGen Video Bench |
| 奖励模型 | VideoAlign (TA + VQ + MQ) |
| 评估 | VBench + VideoAlign |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Chunk-level Forking | 将动作空间采样限制在单个 chunk,避免全序列多分支反向传播 | 计算成本大幅降低,信用分配更稳定 |
| 受控噪声共享 | 仅 pivot chunk 噪声不同,其他噪声跨分支共享 | 奖励差异可直接归因于 pivot chunk 选择 |
| 对比策略优化 | 距离驱动的对比目标替代 SDE 探索 | 适用于一致性模型等少步生成器 |
| Semi-On-Policy | 结合 on-policy 探索和 semi-on-policy 利用 | 解决纯 on-policy 对 TA 奖励效果有限的问题 |
| LoRA 合并 | 独立训练两个 LoRA 适配器后合并 | 避免探索和利用目标的干扰 |
| Ratio Clipping | 信任域约束防止分布偏移 | 移除 clipping 导致性能快速退化 |
五、实验结果
主要定量对比(Self-Forcing 基础)
| 方法 | VBench Quality | VBench Semantic | VBench Total | VQ | MQ | TA | VideoAlign Overall |
|---|---|---|---|---|---|---|---|
| Self-Forcing | 84.87 | 71.27 | 82.15 | 3.80 | 1.68 | 2.28 | 7.76 |
| Causal-Forcing | 85.27 | 70.35 | 82.28 | 3.97 | 1.43 | 2.40 | 7.79 |
| LongLive | 85.10 | 71.16 | 82.31 | 3.87 | 1.76 | 2.43 | 8.06 |
| Self-Forcing | 84.87 | 71.27 | 82.15 | 3.80 | 1.68 | 2.28 | 7.76 |
| + AR-CoPO (Semi) | 85.15 | 71.68 | 82.45 | 3.70 | 1.60 | 2.30 | 7.61 |
| + AR-CoPO (On-policy) | 84.81 | 70.71 | 81.99 | 4.15 | 2.06 | 2.30 | 8.51 |
| + AR-CoPO (Merged) | 85.07 | 70.55 | 82.17 | 4.00 | 1.86 | 2.36 | 8.22 |
关键发现:
- Semi-on-policy 在 VBench Total 上超越所有基线(82.45 vs LongLive 82.31)
- On-policy 在 VideoAlign 上大幅提升(8.51 vs 基线 7.76),尤其 VQ (+0.35) 和 MQ (+0.38)
- 合并模型在保持 VBench 的同时提升 VideoAlign(7.76 → 8.22)
消融实验
| 方法 | VBench Quality | VBench Semantic | VBench Total | VQ | MQ | TA | VideoAlign Overall |
|---|---|---|---|---|---|---|---|
| Self-Forcing | 84.87 | 71.27 | 82.15 | 3.80 | 1.68 | 2.28 | 7.76 |
| on-policy | 81.66 | 69.68 | 79.26 | 3.53 | 0.25 | 2.63 | 6.42 |
| off-policy | 69.78 | 60.84 | 67.99 | 2.22 | -0.15 | 2.16 | 4.23 |
| semi-on-policy | 85.15 | 71.68 | 82.45 | 3.70 | 1.60 | 2.30 | 7.61 |
关键发现:
- 纯 on-policy 导致 VBench 大幅下降(82.15 → 79.26),尽管 TA 提升
- 纯 off-policy 灾难性退化(67.99),分布偏移严重
- Semi-on-policy 保持 VBench 的同时有效利用参考 rollout
LoRA 合并强度
| Scale | VBench Quality | VBench Semantic | VBench Total | VQ | MQ | TA | VideoAlign Overall |
|---|---|---|---|---|---|---|---|
| 1.0 | 84.90 | 70.38 | 81.99 | 4.13 | 1.86 | 2.34 | 8.33 |
| 0.8 | 85.07 | 70.55 | 82.17 | 4.00 | 1.86 | 2.36 | 8.22 |
| 0.6 | 85.11 | 70.72 | 82.23 | 3.86 | 1.78 | 2.36 | 7.99 |
| 0.4 | 85.14 | 71.44 | 82.40 | 3.76 | 1.62 | 2.34 | 7.72 |
| 0 (Semi) | 85.15 | 71.68 | 82.45 | 3.70 | 1.60 | 2.30 | 7.61 |
关键发现:
- Scale=0.8 在 VBench 和 VideoAlign 间取得最佳平衡
- 增大 scale 提升 VideoAlign 但降低 VBench(质量-对齐权衡)
六、与现有方法对比
| 方法 | 类型 | 适用场景 | 核心机制 |
|---|---|---|---|
| SDE-GRPO 系列 | 策略梯度 | 标准流匹配模型 | SDE 随机探索 |
| DanceGRPO | 策略梯度 | 流匹配模型 | SDE + 舞蹈采样 |
| Neighbor GRPO | 对比学习 | 流匹配模型 | 距离驱动对比 |
| AR-CoPO | 对比学习 | 少步流式 AR 视频生成 | Chunk-level Forking + Semi-on-policy |
七、相关工作
| 方向 | 代表工作 | 与 AR-CoPO 的关系 |
|---|---|---|
| 自回归视频生成 | Self-Forcing, Causal-Forcing, LongLive | AR-CoPO 的基础模型 |
| RLHF/策略优化 | GRPO, DanceGRPO, FlowGRPO | AR-CoPO 的理论基础 |
| Neighbor GRPO | Neighbor GRPO | AR-CoPO 的核心算法来源 |
| 视频对齐 | VideoAlign | AR-CoPO 使用的奖励套件 |
八、总结
核心贡献
- Chunk-level Forking:将 RL 的动作空间采样限制在单个 chunk,大幅降低计算成本并提供稳定信用分配
- 受控噪声共享:确保奖励差异可直接归因于 pivot chunk 的生成选择
- Semi-On-Policy Alignment:结合 on-policy 探索和 semi-on-policy 利用,解决纯 on-policy 对全局语义奖励效果有限的问题
- LoRA 合并:独立训练探索和利用 LoRA 适配器后合并,避免目标干扰
- 一致性模型适配:通过对比目标(而非 SDE)适配少步一致性模型生成器
技术影响
- 为少步流式 AR 视频生成器的 RLHF 提供了首个系统性框架
- Chunk-level forking 思想可推广到其他序列生成任务的 RL 训练
- Semi-on-policy 策略为探索-利用权衡提供了新范式
- LoRA 合并技术为多目标优化提供了实用解决方案
局限性
- 代码未公开
- 仅在 Self-Forcing 上验证,泛化性待进一步验证
- 文本对齐 (TA) 提升有限(2.28 → 2.36),全局语义奖励仍是挑战
- VBench 与 VideoAlign 间存在权衡,难以同时最优
九、参考资源
- 论文: arXiv:2603.17461
- 关键引用:
- Neighbor GRPO (对比策略优化基础)
- Self-Forcing / Causal-Forcing / LongLive (流式 AR 视频生成基线)
- VideoAlign (视频对齐奖励套件)
- MovieGen Video Bench (训练数据)
分析日期: 2026-06-05