DC-DiT: 动态分块的自适应计算与弹性推理扩散 Transformer
DC-DiT 用学习式 encoder-router-decoder 支架替换扩散 Transformer 的固定 patchify,端到端学习内容自适应的动态分块 tokenization,实现跨空间/时间步的自适应计算与单一 checkpoint 弹性推理,FLOPs 降低 36.8%、FID 提升 37.8%。
DC-DiT: Adaptive Compute and Elastic Inference for Visual Generation via Dynamic Chunking
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DC-DiT: Adaptive Compute and Elastic Inference for Visual Generation via Dynamic Chunking |
| 论文 | https://arxiv.org/abs/2603.06351 (v2, 2026-05-07) |
| 发布 | 2026-03-06(v1),2026-05-07(v2) |
| 分类 | cs.CV (Computer Vision and Pattern Recognition) |
摘要
扩散 Transformer (DiT) 依赖静态 patchify tokenization,对平滑背景、细节物体区域、噪声较大的早期时间步、以及后期精修阶段都分配相同的 token 预算。DC-DiT(Dynamic Chunking Diffusion Transformer)用一个学习式的 encoder-router-decoder 支架替换固定 patchification,通过与扩散训练端到端联合学习的分块 (chunking) 机制,自适应地将 2D 输入压缩为更短的 token 序列。
DC-DiT 为可预测区域和噪声时间步分配更少 token,为细节区域和后期精修阶段分配更多 token,无监督地产生有意义的空间分割与时间步自适应压缩调度。此外,router 提供保留 token 的重要性排序,实现弹性推理:单一 checkpoint 可在灵活的计算预算下评估,获得平滑的”质量-计算”折中。DC-DiT 还可从预训练 DiT checkpoint upcycle(升级改造),并与正交的动态计算方法兼容。在 class-conditional ImageNet 上,相比固定 patch 的 DiT 基线,推理 FLOPs 最多降低 36.8%,FID 最多提升 37.8%。
二、核心思想
问题定义
标准 DiT 用固定的 patchify 操作把每张图像在每个去噪步都转成相同的 token 网格,token 数成为架构常量。这导致计算的严重冗余:
- 空间上:均匀背景 patch 与高频物体边界获得同样的 token 预算
- 时间上:噪声极大的早期时间步与细节精修的后期时间步获得同样的 token 预算
现有动态计算方法(剪枝、token 合并、降维、隐状态复用)通常在固定 token 序列已经形成之后才自适应,无法从根本上改变 tokenization。
解决方案概述
DC-DiT 在 backbone 计算之前就介入 token 分配:用 encoder-router-decoder 支架取代固定 patchify,端到端学习数据依赖的 token 压缩。它选出一组紧凑的、信息量大的 token 交给 Transformer 计算,再重建回全分辨率。由于在 backbone 之前处理 token 分配,DC-DiT 与后处理式加速方法(DyDiT、TeaCache)正交兼容。
三、技术架构
整体架构
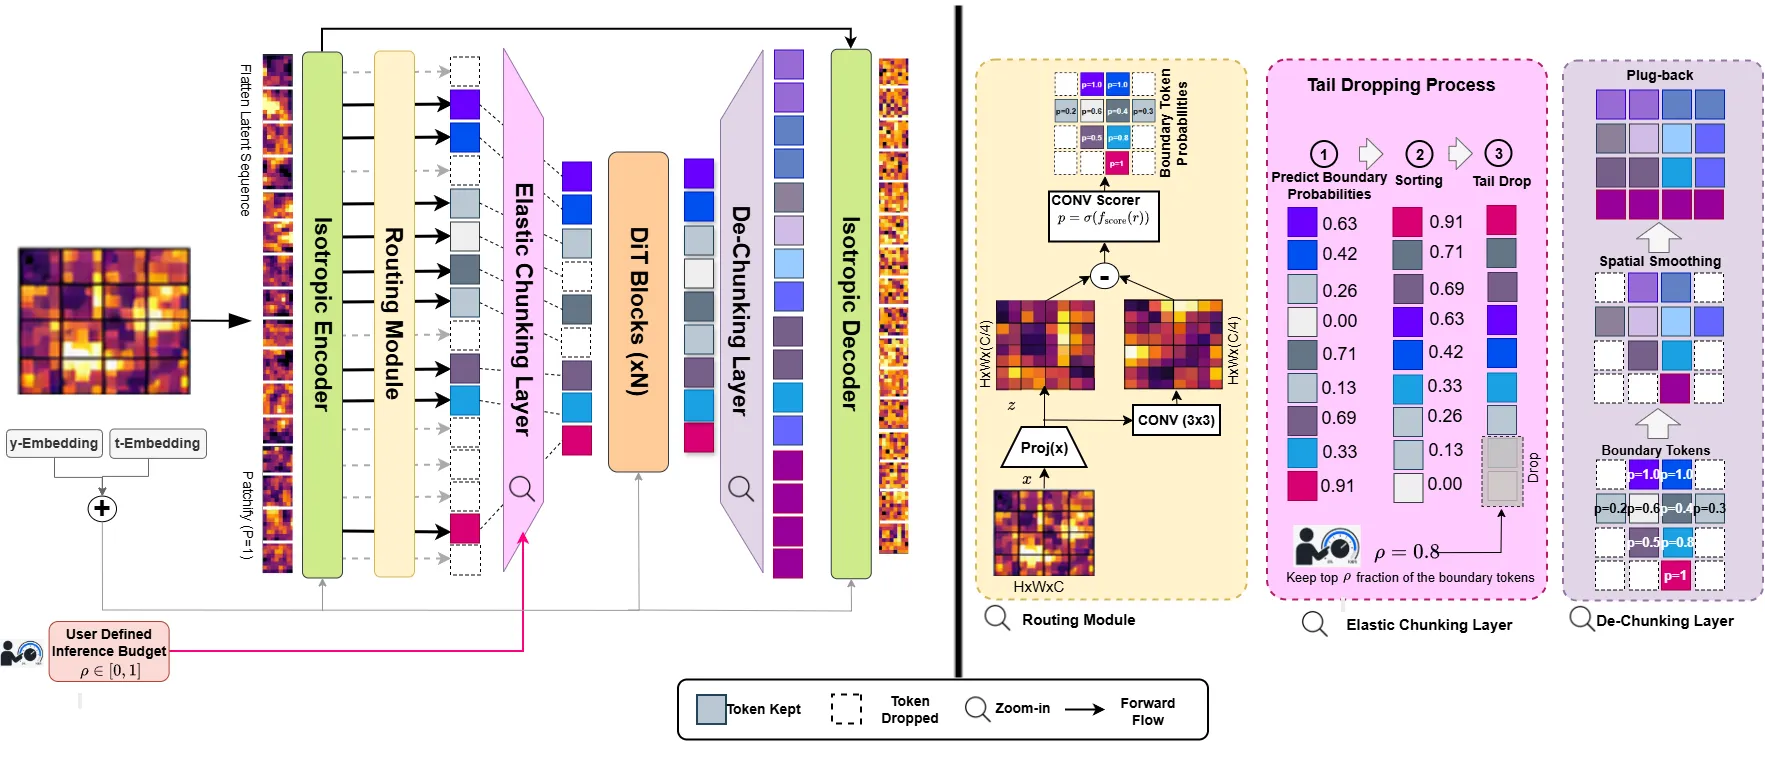
标准 DiT 将输入潜图像 patchify 为不重叠的 patch( 固定)。DC-DiT 则在展平的潜网格上操作(等价于 ),并学习动态地将邻近潜像素分组为内容依赖的视觉 token。
DC-DiT 由 6 个组件构成:
| 组件 | 功能 |
|---|---|
| ① Encoder | 各向同性模块,混合邻近 latent token 的局部上下文,为 router 准备特征 |
| ② Router | 为每个 token 预测 boundary 概率 (难以从邻域预测的 token → 高概率保留) |
| ③ Chunking Layer | 保留 boundary token,丢弃可预测的 non-boundary token,得到更短序列 |
| ④ DiT Blocks | 在缩短序列上计算,使用原始位置嵌入 |
| ⑤ De-chunking Layer | 重建回全分辨率(平滑 + plug-back 映射) |
| ⑥ Decoder | 将 de-chunk 后的特征映射回扩散预测空间 |
Encoder/Decoder 用卷积残差块实例化(保持 token 数不变,仅在 2D 空间网格上混合信息)。
核心机制
1. Router 与 boundary 概率
router 基于局部空间可预测性:encoder 混合邻域信息后,难以从邻域预测的 token 应被保留,局部可预测的 token 可被丢弃、之后由邻近代表重建。为每个 token 预测 boundary 概率 。
2. Elastic Chunking Layer(弹性分块层)
- 通过阈值 生成硬 boundary mask
- 用 Straight-Through Estimator (STE) 保持可微:前向用硬 mask,反向用连续概率 传播梯度
3. 弹性推理:尾部丢弃 (Tail Dropping)
router 的 boundary 概率不仅是二元 keep/drop,还诱导保留 token 从最重要到最不重要的排序。给定自然 boundary 集 和用户指定的尾部丢弃比例 ,丢弃排序尾部的 token,实现单 checkpoint 的灵活计算预算。
4. Lite-CFG
在 Classifier-Free Guidance 中,每个采样步评估条件与无条件两个分支。Lite-CFG 利用弹性预算控制,给条件分支分配保守的尾部丢弃比例(保留大部分 token 预算给携带类别信息的分支),给无条件分支分配更大的丢弃比例,从而节省计算。
5. 批处理与序列打包 (Sequence Packing)
每个样本被 router 选出的 boundary token 数 不同。用序列打包将所有样本的有效 boundary token 沿序列维度拼接,用变长注意力处理,避免 padding 浪费计算。
De-chunking Layer(去分块层)
动机:硬 keep/drop 决策会使 chunk 分配不稳定——router 概率的微小变化可能使 boundary 移动、突然重分配大量位置。训练早期概率常在阈值附近,尤为常见。
空间平滑 (Spatial Smoothing):对每个保留 token (backbone 后表示 ,2D 坐标 ,概率 ),计算邻域平滑表示:
再按目标 token 置信度混合:
高置信 boundary 保留原始特征,低置信 boundary 向空间邻居平滑(借用邻近保留 token 的上下文,降低对单个硬路由决策的敏感性)。
Plug-back 映射:为每个原始网格位置分配其空间最近 boundary(2D 网格欧氏距离)的表示,重建完整 -token 网格。
训练目标与多预算训练
训练目标:与 DiT 相同的扩散目标 + 轻量正则项(借鉴 MoE 的负载均衡机制),鼓励路由模块达到目标平均下采样因子 (目标压缩比,训练超参)。
多预算训练 (Multi-budget Training):若仅在推理时应用尾部丢弃,会造成训练-测试不匹配(内层 DiT 只在 router 自然预算上训练,却在更激进压缩上评估)。因此在多个尾部丢弃设置 上训练:
实践中,warmup 后每次迭代采样一个 ,应用与推理完全相同的尾部丢弃路径。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 学习式动态分块 | encoder-router-decoder 支架替换固定 patchify,端到端学习内容依赖 tokenization | 无监督产生空间分割 |
| 空间可预测性 router | 基于局部可预测性分配 boundary,优于 H-Net 余弦相似度 router | 消融(表 6) |
| 弹性推理(尾部丢弃) | 单 checkpoint 支持灵活计算预算,平滑质量-计算折中 | 图 1、图 5 |
| Lite-CFG | CFG 中条件/无条件分支非对称计算分配 | 节省无条件分支计算 |
| De-chunk 平滑 | 置信度加权平滑提升训练稳定性与 FID | 消融:去掉后 FID 变差 |
| 可 upcycle | 从预训练 DiT / Z-Image 轻量微调升级 | §4.4 DC-Z-Image |
| 正交可组合 | 与 DyDiT、TeaCache 兼容 | §4.5 |
五、实验结果
5.1 实验设置
- 任务:class-conditional ImageNet 256px / 512px 生成,指标 FID-50K
- 扩散:线性噪声调度,训练 1000 步;DDPM 采样 250 步;Stable Diffusion VAE 潜空间;adaLN-Zero 类别条件
- 模型规模:对应 DiT 的 S/B/L/XL 变体,backbone 与 DiT 基线相同,外加 encoder-router-decoder 支架
- 训练:global batch 256,AdamW lr ;DiT 基线 400K 步;DC-DiT 多预算训练,,训练步数按匹配 DiT 训练算力设定(5K 步 warmup 无丢弃)
5.2 主要结果
- DC-DiT 改进了 FID-FLOPs Pareto 前沿:在接近 DiT 计算预算处 FID 更优;更激进的尾部丢弃从同一 checkpoint 暴露出显著更便宜的操作点
- 推理 FLOPs 最多降低 36.8%
- FID 最多提升 37.8%(相比固定 patch DiT 基线)
5.3 学习到的时空压缩
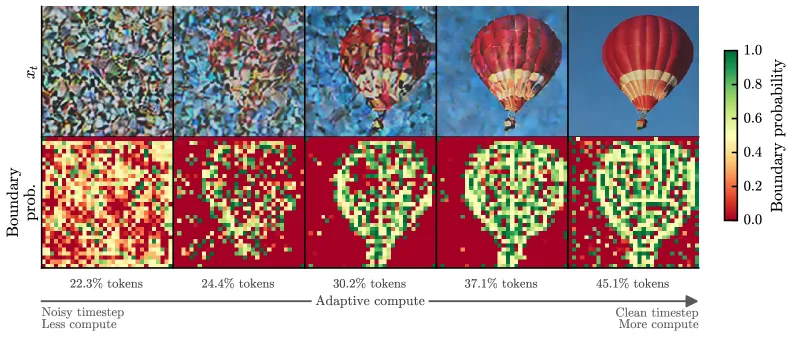
- 空间上:router 对物体边缘、精细纹理、高局部变化区域分配高 boundary 概率;对均匀背景等可预测区域丢弃 token
- 时间上:早期噪声时间步保留更少 token,后期精修阶段保留更多 token
5.4 消融实验
- 多预算训练、空间可预测性 router、de-chunk 平滑均提升生成质量
- 空间可预测性 router 优于 H-Net 余弦相似度 router 的 2D 直接改编
- 去掉 de-chunk 平滑会使 FID 变差
5.5 Upcycling Z-Image → DC-Z-Image
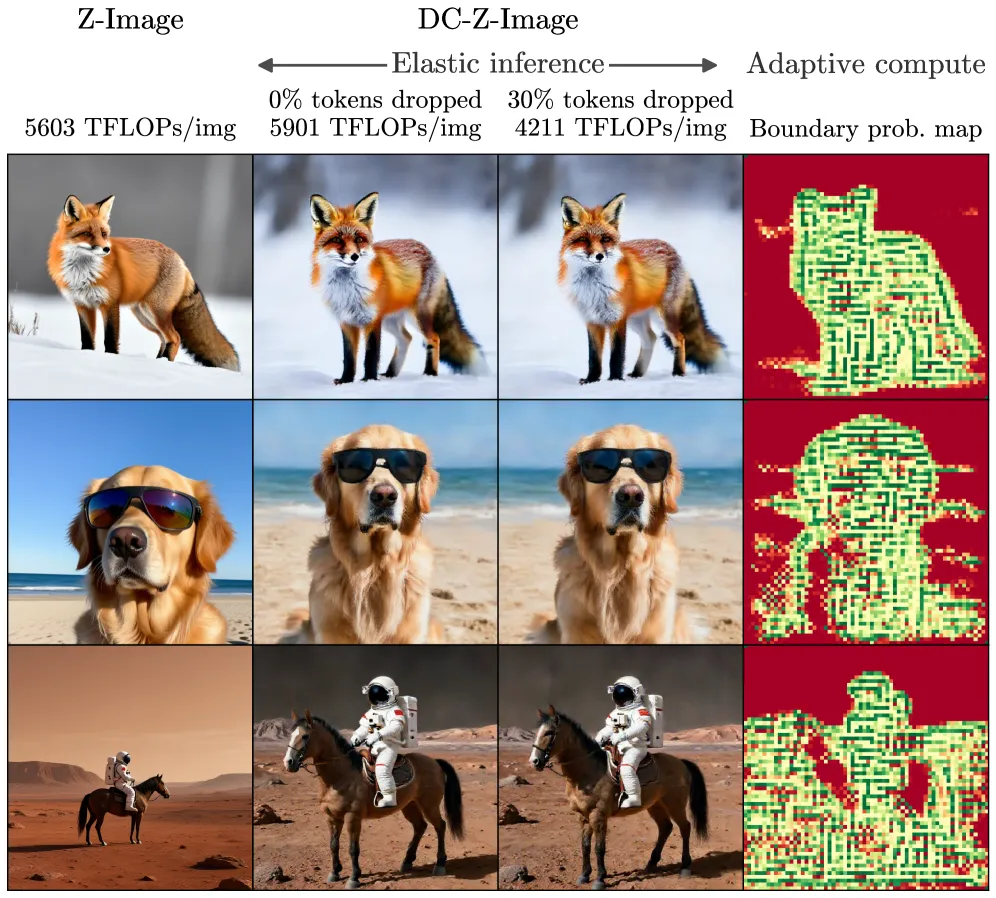
- 对 SOTA 文生图扩散 Transformer Z-Image(flow matching 训练)应用 DC
- 不从头训练,而是替换固定 patchify 为 encoder-router-decoder 支架并轻量适配
- DC-Z-Image 在弹性推理下保留图像质量,验证 DC-DiT 超越 class-conditional 场景
5.6 与其他动态计算方法的可组合性
- DC-DiT 引入内容自适应 patchification,保持 DiT backbone 不变 → 与正交动态执行方法兼容
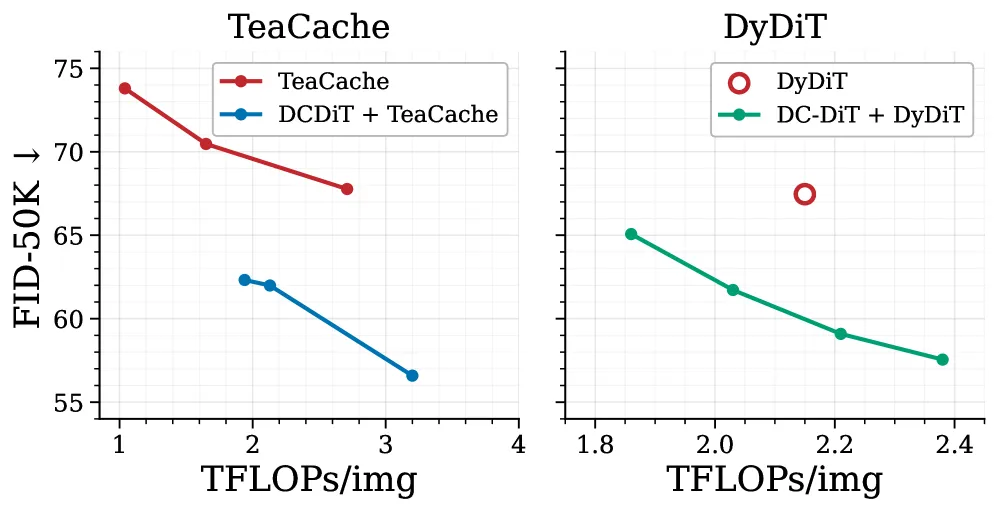
- 与 DyDiT(学习门控调制 backbone 跨时间步计算)和 TeaCache(免训练模型输出复用)组合,验证可组合性
5.7 FLOPs 核算
- 报告 TFLOPs/img:生成一张图的总浮点运算量(含 encoder-router-decoder 支架开销)
- 变长序列打包按每样本实际保留序列长度 核算:pointwise 组件按 缩放;自注意力按打包后实际成本(而非 padding 到最长序列的 ,避免高估)
六、相关工作
- Compute-adaptive DiT:DyDiT(跨时间步自适应隐宽度 + 剪枝空间 token)、D2iT(Dynamic VAE 编码不同区域)
- Content-Adaptive Tokenization:DynamicViT(学习重要性分数渐进剪枝)、APT(按局部内容分配变长 patch)
- DC-DiT 区别:用更短的数据依赖序列替换静态 patch 网格,通过 encoder-router-decoder 支架使 tokenization 可学习
七、总结
核心贡献
- DC-DiT:用自适应 tokenization 替换固定 patchify,端到端学习动态分块
- 无监督时空计算重分配:router 跨空间区域与去噪时间步重分配计算
- 弹性推理 + Lite-CFG:多预算训练把路由信号转为单 checkpoint 灵活计算预算
- 显著改进 Pareto 前沿:FLOPs 降 36.8%、FID 提升 37.8%
- 可 upcycle + 可组合:从预训练 DiT/Z-Image 升级,与 DyDiT/TeaCache 正交兼容
技术影响
- 将”自适应计算”从 backbone 内部/后处理提前到 tokenization 阶段,提供了新的效率维度
- 单 checkpoint 弹性推理对部署友好(无需为不同算力预算训练多个模型)
局限性
- 引入 encoder-router-decoder 支架带来额外 FLOP 开销(虽然被动态压缩收益抵消)
- 主实验集中于 class-conditional ImageNet,文生图仅通过 upcycling 验证
- STE 硬路由在训练早期不稳定,需 de-chunk 平滑与 warmup 缓解
八、参考资源
- arXiv: https://arxiv.org/abs/2603.06351
- 相关方法: DiT、Z-Image、DyDiT、TeaCache、H-Net、DynamicViT、APT
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 1 | 跨空间区域与时间步重分配计算的效果展示 | figure-1-teaser.png |
| Figure 2 | DC-DiT 架构(encoder-router-decoder 支架) | figure-2-architecture.png |
| Figure 3 | 学习到的自适应计算分配可视化 | figure-3-adaptive-compute.png |
| Table 1 | ImageNet 主结果(跨规模/引导/分辨率) | table-1-imagenet-results.png |
| Figure 5 | Upcycle Z-Image 后的弹性推理定性示例 | figure-5-elastic-inference.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer