SkyReels-V4: Multi-modal Video-Audio Generation, Inpainting and Editing model
首个同时支持多模态输入、联合视频-音频生成、统一生成/修复/编辑的视频基础模型,采用双流 MMDiT 架构,支持 1080p 32FPS 15秒电影级视频生成
SkyReels-V4: Multi-modal Video-Audio Generation, Inpainting and Editing model
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SkyReels-V4: Multi-modal Video-Audio Generation, Inpainting and Editing model |
| 作者 | Guibin Chen, Dixuan Lin, Jiangping Yang, Youqiang Zhang, Zhengcong Fei, Debang Li, Sheng Chen, Chaofeng Ao, Nuo Pang, Yiming Wang, Yikun Dou, Zheng Chen, Mingyuan Fan, Tuanhui Li, Mingshan Chang, Hao Zhang, Xiaopeng Sun, Jingtao Xu, Yuqiang Xie, Jiahua Wang, Zhiheng Xu, Weiming Xiong, Yuzhe Jin, Baoxuan Gu, Binjie Mao, Yunjie Yu, Jujie He, Yuhao Feng, Shiwen Tu, Chaojie Wang, Rui Yan, Wei Shen, Jingchen Wu, Peng Zhao, Xuanyue Zhong, Zhuangzhuang Liu, Kaifei Wang, Fuxiang Zhang, Weikai Xu, Wenyan Liu, Binglu Zhang, Yu Shen, Tianhui Xiong, Bin Peng, Liang Zeng, Xuchen Song, Haoxiang Guo, Peiyu Wang, Max W. Y. Lam, Chien-Hung Liu, Yahui Zhou |
| 机构 | Skywork AI |
| 论文 | https://arxiv.org/abs/2602.21818 |
| 代码 | https://github.com/SkyworkAI/SkyReels-V4 |
| 发布 | 2026-02-25 |
| 许可 | 未明确标注 |
二、核心思想
问题定义
视频生成领域面临三大核心挑战:
- 多模态输入碎片化:现有系统无法同时处理文本、图像、视频、掩码和音频参考的任意组合
- 生成/修复/编辑割裂:视频生成、修复(inpainting)和编辑通常需要不同的模型或接口
- 音视频联合生成不足:缺乏同时支持多模态输入、联合音视频生成、统一修复/编辑的完整框架
解决方案概述
SkyReels-V4 是首个同时支持多模态输入、联合视频-音频生成、统一生成/修复/编辑的视频基础模型。核心创新:
- 双流 MMDiT 架构:视频分支和音频分支并行,共享 MLLM 文本编码器
- 通道拼接统一修复:将 I2V、视频扩展、视频编辑统一为掩码修复问题
- 多模态上下文学习:通过 MLLM 指令跟随 + 视觉参考注入实现复杂条件控制
- 效率策略:低分辨率全序列 + 高分辨率关键帧联合生成 + 超分插帧
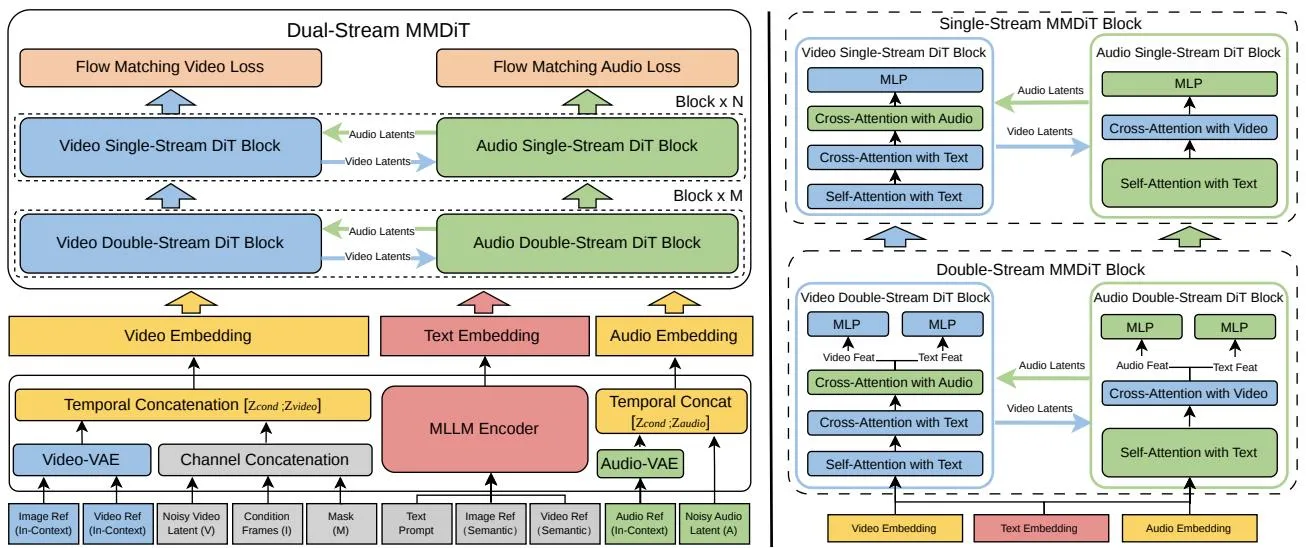
三、技术架构
双流 MMDiT 架构
对称双骨干设计,视频分支和音频分支基于相同的 MMDiT 框架:
混合双流+单流 MMDiT 块:
前 M 层采用双流设计,视频/音频和文本 token 保持独立参数但通过联合自注意力交互:
\mathbf{Q}_v, \mathbf{K}_v, \mathbf{V}_v = \mathrm{QKV}_v(\text{LayerNorm}_v(\mathbf{x}_v)) \tag{1}
\mathbf{Q}_t, \mathbf{K}_t, \mathbf{V}_t = \mathrm{QKV}_t(\text{LayerNorm}_t(\mathbf{x}_t)) \tag{2}
\mathbf{x}_v', \mathbf{x}_t' = \text{Attention}([\mathbf{Q}_v; \mathbf{Q}_t], [\mathbf{K}_v; \mathbf{K}_t], [\mathbf{V}_v; \mathbf{V}_t]) \tag{3}
后 N 层过渡到单流架构,处理拼接的视频/音频和文本 token,最大化计算效率。
强化文本条件(交叉注意力):
\mathbf{x}_v'' = \mathbf{x}_v' + \text{Attention}(\mathbf{Q}=\mathbf{x}_v', \mathbf{K}=\mathbf{x}_t, \mathbf{V}=\mathbf{x}_t) \tag{4}
双向音视频交叉注意力:
\mathbf{a}_i' &= \mathbf{a}_i + \text{CrossAttn}(\mathbf{Q}=\mathbf{a}_i, \mathbf{K}=\mathbf{v}_i, \mathbf{V}=\mathbf{v}_i) \\ \mathbf{v}_i'' &= \mathbf{v}_i' + \text{CrossAttn}(\mathbf{Q}=\mathbf{v}_i', \mathbf{K}=\mathbf{a}_i', \mathbf{V}=\mathbf{a}_i') \end{aligned} \tag{5}$$ **RoPE 时间对齐**:音频 RoPE 频率缩放 $21/218 \approx 0.09633$ 匹配视频时间分辨率。 **Flow Matching 训练目标**: $$\mathcal{L}_{\text{flow}} = \mathbb{E}_{t, \mathbf{z}_v^0, \mathbf{z}_a^0, \boldsymbol{\epsilon}_v, \boldsymbol{\epsilon}_a} \left[ \left\| \mathbf{v}_\theta^v(t, \mathbf{z}_v^t, \mathbf{z}_a^t, \mathbf{c}) - (\mathbf{z}_v^0 - \boldsymbol{\epsilon}_v) \right\|^2 + \left\| \mathbf{v}_\theta^a(t, \mathbf{z}_a^t, \mathbf{z}_v^t, \mathbf{c}) - (\mathbf{z}_a^0 - \boldsymbol{\epsilon}_a) \right\|^2 \right] \tag{6}$$ ### 统一视频修复(通道拼接) 视频 MMDiT 输入由三部分沿通道维度拼接: $$\mathbf{Z}_{\text{input}} = \text{Concat}(\mathbf{V}, \mathbf{I}, \mathbf{M}) \tag{7}$$ - $\mathbf{V}$:噪声视频潜在表示 - $\mathbf{I}$:VAE 编码的条件帧(非条件帧填黑) - $\mathbf{M}$:二进制掩码(1=条件区域,0=生成区域) **统一任务映射**: | 任务 | 掩码配置 | |------|----------| | T2V | $M=0$(所有帧生成) | | I2V | $M_{t=0}=1, M_{t>0}=0$ | | 视频扩展 | $M_{t<k}=1, M_{t>k}=0$ | | 首尾帧插值 | $M_{t=0}=M_{t=T-1}=1$ | | 视频编辑 | 任意时空掩码 | ### 多模态上下文学习 **MLLM 指令跟随**:参考视觉输入与文本提示通过 MLLM 联合处理,提取语义丰富的多模态嵌入。 **视觉参考注入(自注意力)**: $$\mathbf{Z}_{\text{attn}} = [\mathbf{Z}_{\text{cond}}; \mathbf{Z}_{\text{video}}] \tag{8}$$ **偏移 3D RoPE 时间位置消歧**: $$\text{RoPE}_{\text{temporal}}(\mathbf{Z}_{\text{cond},i}) = \text{RoPE}(t = -N_{\text{cond}} + i), \quad \text{RoPE}_{\text{temporal}}(\mathbf{Z}_{\text{video},j}) = \text{RoPE}(t = j) \tag{9}$$ 条件潜在表示获得负时间索引,与生成视频帧区分开。 ### 效率策略  **联合低分辨率/高分辨率关键帧生成**: 1. 基础模型生成低分辨率全序列 + 高分辨率关键帧 2. 上采样器(Refiner)将低分辨率线性插值到目标分辨率 3. 关键帧位置替换为直接预测的高分辨率潜在表示 4. VAE 解码器输出最终视频 **Video Sparse Attention (VSA)**:可训练稀疏注意力,两阶段层次方法(粗粒度聚合 + 细粒度 top-K),减少约 3 倍注意力计算成本。 ### 训练流程 | 任务 | 阶段 | 分辨率 | 数据量 | Epochs | |------|------|--------|--------|--------| | **视频预训练** | | | | | | T2I | Stage 1 | 256px | 3B 图像 | 3 | | T2I+T2V | Stage 2 | 256px, 16fps, 2-10s | 1B 图像/400M 视频 | 3 | | T2I+T2V+Inpaint | Stage 3 | 256px, 16fps, 2-15s | 1B 图像/400M 视频 | 2 | | Mixed Tasks | Stage 4 | 256/480px, 16fps, 2-15s | 100M 图像/100M 视频 | 2 | | Mixed Tasks | Stage 5 | 480/720/1080px, 16fps, 3-15s | 50M 图像/50M 视频 | 2 | | Multi-modal Condition | Stage 6 | 480/720/1080px, 16fps, 3-15s | 20M 图像/50M 视频 | 2 | | **音频预训练** | | | | | | Audio Backbone | Pretrain | 变长,最长15s | 数十万小时 | 3 | | **联合训练** | | | | | | T2V+T2AV+T2A | Joint Pretrain | 720/1080px, 16fps, 5-15s | 50% 视频数据+T2A | 2 | | **SFT** | | | | | | T2AV+Multi-modal | SFT Stage 1 | 720/1080px, 16fps, 5-15s | 5M 视频 | 3 | | T2AV+Multi-modal | SFT Stage 2 | 720/1080px, 16fps, 5-15s | 1M 精选视频 | 3 | ### 数据流水线 **数据收集**: - 真实数据:LAION、Flickr、WebVid-10M、Koala-36M、OpenHumanVid、Emilia、AudioSet、VGGSound + 内部授权数据 - 合成数据:多语言文本生成、多语言语音合成、多模态修复/编辑任务 **数据处理**: - 图像:去重 → 质量过滤 → 概念均衡 - 音频:分类(音效/音乐/语音/歌唱)→ 质量过滤 → VAD → 分段 → Whisper 转录 → Qwen3-Omni 标注 - 视频:智能分割(TransNet+VLM)→ 去重 → 多维过滤 → 概念/运动均衡 → SyncNet 音视频同步 **结构化标注**:使用特殊 token 标记文本(`<text>`)、音效(`<sfx>`)、对话(`<dialogue>`)、歌唱(`<singing>`)、背景音乐(`<bgm>`)。 ## 四、核心创新 | 创新点 | 说明 | 优势 | |--------|------|------| | **双流 MMDiT** | 视频和音频分支并行,共享 MLLM | 音视频深度对齐 | | **通道拼接统一修复** | I2V/扩展/编辑统一为掩码问题 | 单架构多任务 | | **双向音视频交叉注意力** | 全网络深度的同步线索交换 | 精确音视频同步 | | **偏移 3D RoPE** | 条件 token 负时间索引 | 多参考视觉消歧 | | **联合低/高分辨率生成** | 全序列低分辨率 + 关键帧高分辨率 | 高效高分辨率生成 | | **Video Sparse Attention** | 可训练稀疏注意力 | 3 倍注意力加速 | ## 五、代码实现分析 ### 项目结构 ``` SkyReels-V4/ ├── README.md ├── requirements.txt ├── generate_video.py # 统一推理脚本 ├── models/ # 模型权重 ├── configs/ # 配置文件 └── examples/ # 示例数据 ``` ### 模型规格 | 规格 | 值 | |------|-----| | 最大分辨率 | 1080p | | 帧率 | 32 FPS | | 最大时长 | 15 秒 | | 支持任务 | T2V, I2V, V2V, 修复, 编辑, 音频生成 | | 输入模态 | 文本, 图像, 视频, 掩码, 音频 | ## 六、实验结果 ### Artificial Analysis Arena 排行榜 | 赛道 | 排名 | ELO | 对比最优 | |------|------|-----|----------| | T2V with Audio | **#1** | 1129 | 超越 Kling 3.0 (1097) 和 Veo 3.1 (1086) | | T2V without Audio | **#2** | 1236 | 仅次于 Kling 3.0 (1248) | | I2V with Audio | **#4** | 1067 | 与 Veo 3.1 (1068) 接近 | | I2V without Audio | **#7** | 1279 | 与 Kling 3.0 (1288) 接近 | ### SkyReels-VABench 人工评估 | 类别 | Kling 2.6 | Veo 3.1 | Seedance 1.5 | Wan 2.6 | **SkyReels V4** | |------|-----------|---------|--------------|---------|-----------------| | Overall Quality | 3.58 | 3.53 | 3.45 | 3.25 | **3.60** | | Instruction Following | 3.37 | 3.57 | 3.39 | 3.49 | **3.62** | | Audio-Visual Sync | **3.71** | 3.61 | 3.64 | 3.29 | 3.66 | | Visual Quality | **3.80** | 3.74 | 3.72 | 3.35 | 3.77 | | Motion Quality | **3.32** | 3.02 | 2.95 | 3.01 | 3.28 | | Audio Quality | 3.59 | **3.67** | 3.49 | 3.04 | 3.58 | SkyReels V4 在总体质量(3.60)和指令遵循(3.62)上达到最优,音视频同步(3.66)接近 Kling 2.6(3.71)。 ### 多模态修复与编辑能力         ### 多模态参考生成       ## 七、相关工作 ### 视频生成模型 - **商业系统**:Veo 3.1、Sora-2、Kling 3.0、Gen 4.5、Seedance 1.5 - **开源模型**:CogVideoX、HunyuanVideo、WAN 2.1/2.2、SkyReels 系列、LTX ### 音视频联合生成 - **闭源**:Veo 3.1、Sora-2、Kling 3.0 - **开源**:AV-DiT、MMDisCo、Universe-1、Ovi、BridgeDiT、JavisDiT、LTX-2、Apollo ### SkyReels-V4 的差异化 - **首个完整统一**:多模态输入 + 联合音视频生成 + 生成/修复/编辑 - **通道拼接修复**:统一 I2V、扩展、编辑为单一接口 - **双流 MMDiT**:双向音视频交叉注意力 + RoPE 时间对齐 - **效率策略**:联合低/高分辨率生成 + VSA 稀疏注意力 ## 八、总结 ### 核心贡献 1. **双流 MMDiT 架构**:视频和音频分支并行,共享 MLLM 文本编码器,实现音视频深度对齐 2. **统一通道拼接修复**:将 I2V、视频扩展、视频编辑统一为掩码修复问题 3. **效率策略**:联合低分辨率全序列 + 高分辨率关键帧生成 + 超分插帧,实现 1080p 32FPS 15 秒生成 4. **多模态上下文学习**:MLLM 指令跟随 + 偏移 3D RoPE 视觉参考注入 ### 技术影响 - **统一框架范式**:证明单模型可同时处理生成、修复、编辑任务 - **音视频联合生成**:双流 MMDiT + 双向交叉注意力实现精确同步 - **工业级应用**:1080p 32FPS 15 秒,支持多镜头电影级叙事 - **开源生态**:推动社区研究和应用 ### 局限性 1. **计算成本**:1080p 生成需要大量 GPU 资源 2. **模型未开源**:GitHub 仓库尚未公开,代码和模型权重暂不可用 3. **修复任务限制**:音频分支在修复任务中从头生成,可能影响音频连续性 4. **评估局限**:SkyReels-VABench 为内部基准,缺乏标准化对比 5. **长视频挑战**:15 秒上限仍有限制,超长视频需要额外拼接 ## 九、参考资源 ### 论文 - **本文**: https://arxiv.org/abs/2602.21818 - **代码**: https://github.com/SkyworkAI/SkyReels-V4 - **HuggingFace**: https://huggingface.co/Skywork - **ModelScope**: https://modelscope.cn/organization/Skywork ### 相关工作 - **SkyReels-V2**: 无限长度电影生成模型 - **SkyReels-V3**: 统一多模态上下文学习框架 - **SkyReels-Audio**: 全音频条件说话人像 - **SkyReels-A1/A2**: 人像动画和元素组合 - **Wan2.1**: 大规模视频生成模型 - **Video Sparse Attention (VSA)**: 可训练稀疏注意力