Dr. MAS: Stable Reinforcement Learning for Multi-Agent LLM Systems
面向多智能体 LLM 系统的稳定强化学习
Dr. MAS: Stable Reinforcement Learning for Multi-Agent LLM Systems
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Dr. MAS: Stable Reinforcement Learning for Multi-Agent LLM Systems |
| 作者 | Lang Feng, Longtao Zheng, Shuo He, Fuxiang Zhang, Bo An |
| 机构 | Nanyang Technological University, Singapore |
| 论文 | arXiv:2602.08847 |
| 代码 | GitHub - langfengQ/DrMAS |
| 发布 | 2026年2月9日 |
| 主题 | cs.LG, cs.AI |
二、核心思想
问题定义
多智能体 LLM 系统通过角色专业化实现高级推理和工具使用,但可靠的 RL 后训练仍然困难。本文从理论上 pinpoint 了将 group-based RL 扩展到多智能体 LLM 系统时训练不稳定的关键原因。
核心发现: 在 GRPO 风格优化下,全局归一化基线可能偏离不同智能体的奖励分布,最终导致梯度范数不稳定。
解决方案概述
Dr. MAS 是一个简单而稳定的多智能体 LLM 系统 RL 训练方案:
- Agent-wise remedy: 使用每个智能体自己的奖励统计量进行优势归一化
- 校准梯度尺度: 大幅稳定训练,理论上和经验上都有效
- 端到端框架: 支持可扩展编排、灵活的 per-agent LLM 服务和优化配置、共享资源调度
核心性能
| 指标 | 数值 |
|---|---|
| 数学推理提升 | +5.6% avg@16, +4.6% pass@16 |
| 多轮搜索提升 | +15.2% avg@16, +13.1% pass@16 |
| 梯度稳定性 | 大幅消除梯度尖峰 |
| 异构模型 | 保持性能同时降低 31.6% 延迟和 41.8% 成本 |
三、技术架构
问题分析:GRPO 的梯度范数膨胀
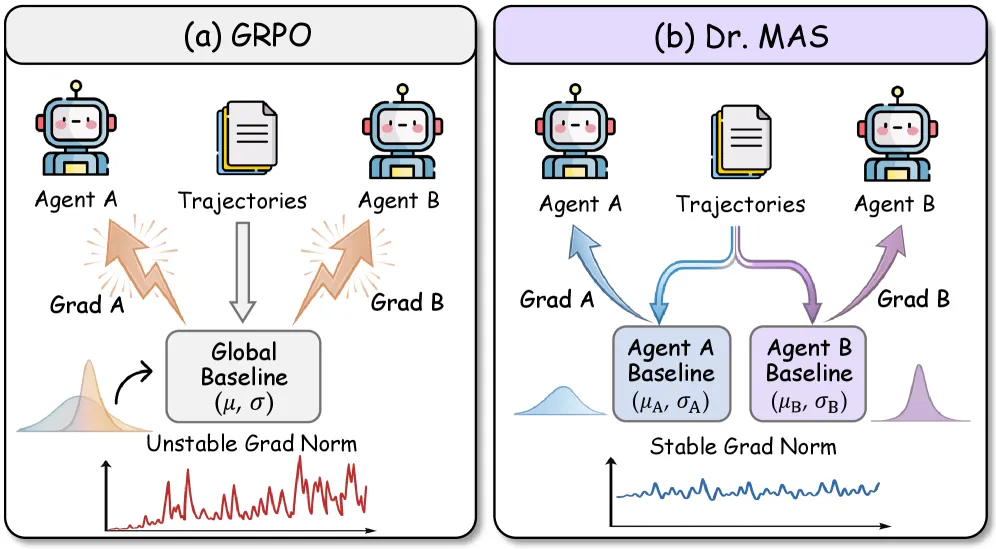
Figure 1: 算法比较。(a) GRPO 全局基线 (μ,σ) 可能导致梯度范数不稳定。(b) Dr. MAS 使用 per-agent 归一化 (μ_k,σ_k) 稳定 MAS 训练。
多智能体 LLM 系统设定
考虑由 个不同 LLM 智能体 组成的协作多智能体 LLM 系统,每个智能体有自己的 LLM 权重 。
轨迹表示为:
其中 为状态, 为文本输出, 为活跃智能体。
GRPO 在多智能体中的问题
全局优势归一化:
智能体 的 RL 目标:
其中 为智能体 的所有输出集合。
梯度范数膨胀的理论分析
引理 4.2: 对于任意智能体 ,per-agent 梯度的二阶矩为:
其中:
- (智能体 的条件均值)
- (智能体 的条件方差)
- 为分数-奖励协方差校正项
命题 4.3 (梯度范数膨胀):
当归一化均值偏差 或归一化方差比 变大时, 的二阶矩至少线性增长。因此,如果存在迭代序列 使得:
Agent-Wise 解决方案
核心思想: 使用每个智能体自己的奖励统计量进行归一化:
其中 和 分别是智能体 活跃时的奖励均值和标准差。
效果: 在 agent-wise 归一化下,每个智能体梯度的二阶矩为:
关键效果:,消除了梯度膨胀的根源。
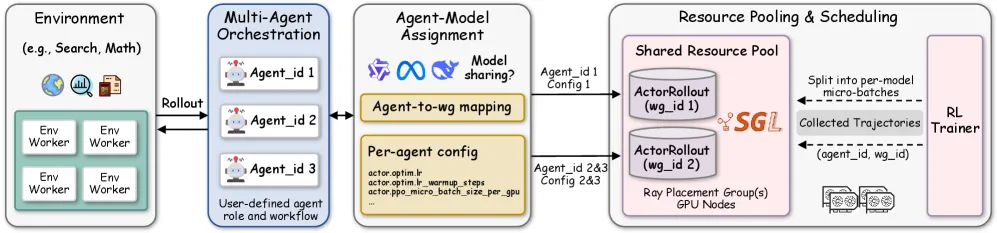
Figure 2: 多智能体 LLM RL 框架概览。多智能体编排器管理分布式 rollout,智能体映射到 LLM worker 组(可选 LLM 共享),共享资源池调度 actor 后端以实现高效推理和 per-model 优化。
框架组件
| 组件 | 说明 |
|---|---|
| 多智能体编排 | 由多智能体轨迹收集器协调,管理分布式交互 |
| 智能体-模型分配 | 将逻辑智能体映射到物理 LLM worker 组 |
| Per-Agent 配置 | 支持智能体特定的训练超参数 |
| 共享资源池 | 解耦逻辑分配与物理资源放置 |
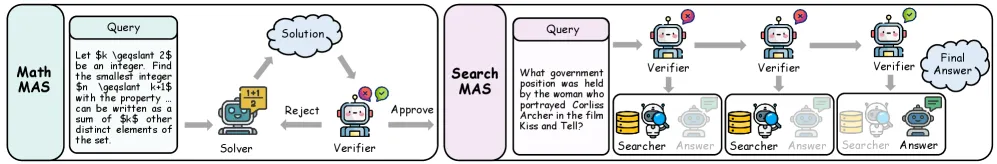
Figure 3: 编排示例。左:数学编排使用两智能体循环(solver + verifier)。右:多轮搜索编排使用层次化三智能体流水线(verifier + search + answer)。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 梯度范数膨胀理论 | 证明全局归一化在多智能体设置中导致梯度不稳定 | 引理 4.2, 命题 4.3 |
| Agent-Wise 归一化 | 使用每个智能体自己的奖励统计量进行优势归一化 | 消除 因子 |
| 端到端框架 | 支持可扩展编排、灵活分配、共享资源池 | 支持 LLM 共享和非共享 |
| 异构模型分配 | 不同智能体使用不同大小的模型 | 保持性能同时降低成本 |
五、实验结果
数学推理
设置: 两智能体架构(solver + verifier),使用 Qwen3-4B/8B
| 模型 | 设置 | 方法 | avg@16 | pass@16 |
|---|---|---|---|---|
| Qwen3-4B | LLM 共享 | GRPO | 56.8 | 70.7 |
| Qwen3-4B | LLM 共享 | Dr. MAS | 59.0 | 73.2 |
| Qwen3-4B | LLM 非共享 | GRPO | 57.5 | 74.4 |
| Qwen3-4B | LLM 非共享 | Dr. MAS | 61.1 | 77.7 |
| Qwen3-8B | LLM 共享 | GRPO | 57.8 | 72.1 |
| Qwen3-8B | LLM 共享 | Dr. MAS | 62.3 | 77.6 |
| Qwen3-8B | LLM 非共享 | GRPO | 58.1 | 72.2 |
| Qwen3-8B | LLM 非共享 | Dr. MAS | 60.7 | 74.2 |
关键发现:
- Dr. MAS 在所有设置下都优于 vanilla GRPO
- 非共享设置下改进更显著(智能体行为分布更异构)
- AIME 基准上改进最大(如 AIME’24: 42.7→54.8)
多轮搜索
设置: 三智能体层次化流水线(verifier + search + answer),使用 Qwen2.5-3B/7B
| 模型 | 设置 | 方法 | avg@16 | pass@16 |
|---|---|---|---|---|
| Qwen2.5-3B | LLM 共享 | GRPO | 34.8 | 52.9 |
| Qwen2.5-3B | LLM 共享 | Dr. MAS | 36.7 | 53.8 |
| Qwen2.5-3B | LLM 非共享 | GRPO | 34.5 | 46.7 |
| Qwen2.5-3B | LLM 非共享 | Dr. MAS | 36.9 | 53.0 |
| Qwen2.5-7B | LLM 共享 | GRPO | 41.5 | 57.0 |
| Qwen2.5-7B | LLM 共享 | Dr. MAS | 42.5 | 57.7 |
| Qwen2.5-7B | LLM 非共享 | GRPO | 28.0 | 40.5 |
| Qwen2.5-7B | LLM 非共享 | Dr. MAS | 43.8 | 58.3 |
关键发现:
- Qwen2.5-7B 非共享设置下,GRPO 严重失败(28.0/40.5),Dr. MAS 恢复到 43.8/58.3
- 错误在工具调用间 snowball,Dr. MAS 有效缓解
梯度范数稳定性
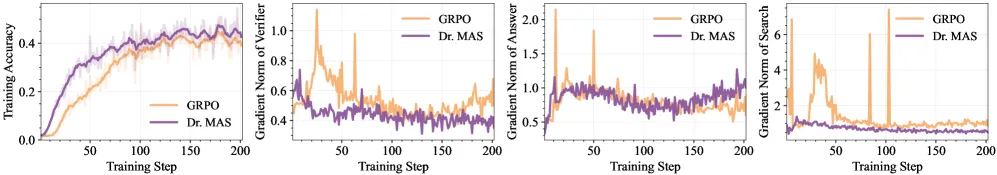
Figure 4: GRPO 和 Dr. MAS 的训练准确率和梯度范数比较。三智能体搜索编排,LLM 非共享(Qwen2.5-3B)。
- GRPO: 频繁、高幅度梯度尖峰,search agent 最严重
- Dr. MAS: 所有三个智能体的梯度范数更平滑、更低
消融实验
设置: Qwen2.5-7B,LLM 非共享,多轮搜索
| 配置 | avg@16 | pass@16 |
|---|---|---|
| (GRPO) | 28.0 | 40.5 |
| 39.1 (+11.1) | 53.5 (+13.0) | |
| 42.9 (+14.9) | 57.6 (+17.1) | |
| (Dr. MAS) | 43.8 (+15.8) | 58.3 (+17.8) |
发现: per-agent 标准差 带来更大提升,因为智能体在优势分布的 spread 上差异更大。
异构模型分配
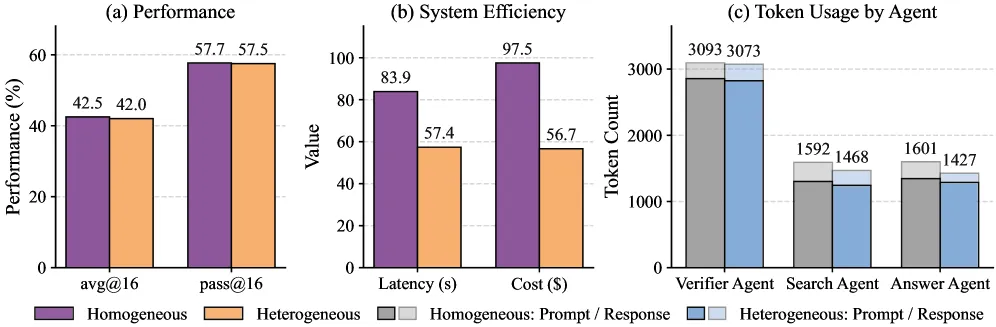
Figure 5: 同质(全 7B)和异构(Verifier 用 7B,Search/Answer 用 3B)模型分配的性能和效率比较。
| 配置 | 性能 | 延迟 | API 成本 |
|---|---|---|---|
| 同质 (全 7B) | 基线 | 基线 | 基线 |
| 异构 (7B+3B) | 几乎相同 | -31.6% | -41.8% |
六、与现有方法对比
| 方面 | GRPO | DAPO | MARSHAL | MARTI | Dr. MAS |
|---|---|---|---|---|---|
| 智能体数量 | 单 | 单 | 双 | 多 | 多 |
| 稳定性保证 | 无 | 部分 | 无 | 无 | 理论保证 |
| 梯度校准 | 全局 | 全局 | 全局 | 全局 | Per-agent |
| 异构模型 | 不支持 | 不支持 | 不支持 | 部分 | 完整支持 |
| LLM 共享 | N/A | N/A | N/A | 支持 | 支持 |
| 数学推理提升 | 基线 | - | - | - | +5.6% |
| 搜索提升 | 基线 | - | - | - | +15.2% |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| GRPO | 基础算法,Dr. MAS 改进其在多智能体中的不稳定性 |
| DAPO | 动态采样策略,Dr. MAS 互补 |
| MARSHAL | 双智能体自对弈,Dr. MAS 支持更多智能体 |
| veRL/ROLL/AReaL | RL 基础设施,Dr. MAS 扩展其多智能体支持 |
| MARTI/PettingLLMs | 多智能体训练接口,Dr. MAS 提供更好的异构支持 |
八、总结
核心贡献
- 梯度范数膨胀理论: 证明全局归一化在多智能体设置中导致梯度不稳定
- Agent-Wise 归一化: 使用每个智能体自己的奖励统计量进行优势归一化
- 端到端框架: 支持可扩展编排、灵活分配、共享资源池
- 异构模型分配: 不同智能体使用不同大小的模型,降低成本
技术影响
- 理论洞见: 揭示了 GRPO 在多智能体设置中的根本缺陷
- 简单有效: 仅需修改优势归一化即可大幅改善训练稳定性
- 实用框架: 支持 LLM 共享和非共享、异构模型分配
- 广泛应用: 数学推理和多轮搜索任务上都有效
局限性
- 未解决跨智能体和跨 turn 的信用分配问题
- 未评估更大规模智能体数量的场景
- 资源分配和异步执行问题仍是开放问题
九、参考资源
- 论文: arXiv:2602.08847
- 代码: GitHub - langfengQ/DrMAS
- 主题: cs.LG, cs.AI
- 页数: 约 20 页, 8 图