Rolling Sink: Bridging Limited-Horizon Training and Open-Ended Testing in Autoregressive Video Diffusion
无训练方法解决自回归视频扩散模型的长视频生成退化问题
Rolling Sink: Bridging Limited-Horizon Training and Open-Ended Testing in Autoregressive Video Diffusion
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Rolling Sink: Bridging Limited-Horizon Training and Open-Ended Testing in Autoregressive Video Diffusion |
| 作者 | Haodong Li, Shaoteng Liu, Zhe Lin, Manmohan Chandraker |
| 机构 | UC San Diego, Adobe Research |
| 论文 | arXiv:2602.07775 |
| 代码 | GitHub |
| 项目页 | rolling-sink.github.io |
| 发布 | 2026年2月8日 (v1), 最新 v6: 2026年5月3日 |
| 许可 | arXiv 非独占分发许可 |
| 主题 | cs.CV (计算机视觉与模式识别) |
二、核心思想
问题定义
自回归 (AR) 视频扩散模型已取得显著性能,但由于训练时长有限,当测试时长超过训练时长时会出现训练-测试差距,导致快速的视觉退化。
关键区分:
- Self Forcing: 研究训练时长内的训练-测试差距
- Rolling Sink: 研究训练时长外的训练-测试差距,即有限训练时长与开放式测试时长之间的差距
解决方案概述
由于开放式测试可以超越任何有限训练窗口,且长视频训练计算成本高昂,本文追求无训练解决方案来弥合这一差距。
Rolling Sink 基于 Self Forcing(仅在 5 秒片段上训练),在测试时有效地将 AR 视频合成扩展到超长时长(例如 5-30 分钟,16 FPS),实现:
- 一致的主体
- 稳定的颜色
- 连贯的结构
- 平滑的运动
动机
Figure 1: Rolling Sink 开放式 AR 视频生成总览。尽管训练时长仅 5 秒,Rolling Sink 有效地将 AR 视频合成扩展到分钟级。
生成长视频(如电影)通常需要多镜头输入,即一系列提示。每个镜头通常对应一个单独的提示,时长从几秒到几分钟甚至几小时不等。例如,Steve McQueen 的《Hunger》以经典的 16.5 分钟对话镜头开始。
虽然大型视频扩散模型(如 Sora、Wan、Kling、Veo、Gen)取得了显著性能,但它们通常同时去噪所有帧,使其不适合开放式设置。相比之下,AR 视频扩散模型在架构上支持开放式视频生成,通过持续预测下一帧(或下一块)并以先前帧为条件。
然而,AR 视频扩散模型通常在有限且固定的时长上训练(如 Self Forcing 中的 5 秒)。当外推到长时长时,尤其是超过训练时长,这些模型通常会遭受快速的视觉退化。
三、技术架构
AR 缓存维护分析
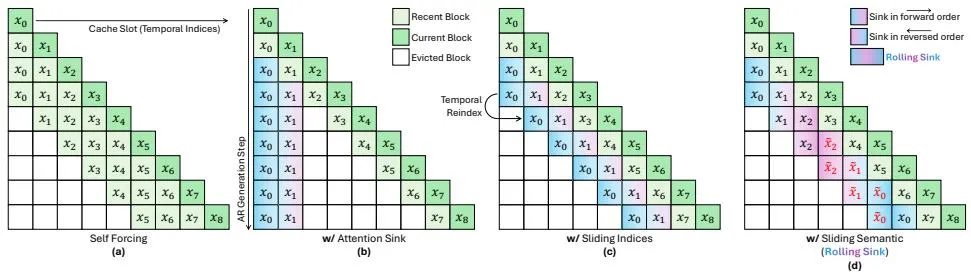
Figure 3: 分析和 Rolling Sink 方法总览。ⓐ Self Forcing 缓存机制,ⓑ Attention Sink,ⓒ 滑动索引,ⓓ 滑动语义(Rolling Sink)
由于提示嵌入在整个 AR 视频合成过程中保持固定,且每个块的初始噪声始终从相同的高斯分布中提取,**上下文(即缓存)**是长时 AR 漂移的主要因素。
为了在开放式测试期间保持无漂移,AR 缓存应与其训练时长内的行为/特征保持一致。这种行为包括:
- 最小漂移: 所有缓存块应无漂移(即无过饱和颜色、无坍塌结构等)
- 索引和语义上的滑动: 缓存块的时间索引从全局轴上的固定长度滑动窗口分配(滑动索引),缓存块的语义内容也作为从持续无尽的全局视频流形上的移动切片更新(滑动语义)
Rolling Sink 方法
(详见 Figure 3 中的四个阶段 ⓐ-ⓓ)
阶段 ⓐ: Self Forcing 缓存机制
总缓存容量 K 严格限制以实现流式效率。
阶段 ⓑ: Attention Sink
将前 S 个块固定为 sink 块,其中时间索引和语义都是静态的。分析不同 sink 比例 (S/K) 的效果。
阶段 ⓒ: 滑动索引 (Sliding Indices)
将时间索引视为全局轴 i ∈ [0, ∞),在每个 AR 步骤 i,在最近和当前块之前,将 sink 块的时间索引作为固定长度(即 S)的滑动窗口在此轴上移动。
阶段 ⓓ: 滑动语义 (Sliding Semantics)
理想情况下,sink 块的语义内容也应沿着无漂移、持续无尽的全局视频流形滑动。由于有限长度训练无法自然实现这一点,我们通过滚动 sink 内容来近似真正的语义滑动(即在每个 AR 步骤,用训练时长内历史的滚动段更新 sink 块的语义内容)。
最终方法: 提出 ⓓ,命名为 Rolling Sink。为清晰起见,设置 K = 3 和 S = 2。
核心公式
缓存容量约束:
其中:
- = 总缓存容量
- = sink 块数量
- = 最近块数量
Sink 比例:
滑动索引: 在每个 AR 步骤 ,sink 块的时间索引设置为:
滑动语义近似: 通过从训练时长内的历史中滚动更新 sink 块的语义内容。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 训练-测试差距分析 | 区分训练时长内和训练时长外的差距 | 系统性消融实验 |
| AR 缓存维护分析 | 分析缓存机制对长视频生成的影响 | Attention Sink、滑动索引、滑动语义 |
| Rolling Sink | 无训练方法实现超长视频生成 | 5-30 分钟视频生成 |
| 滑动索引 | 时间索引的全局滑动窗口 | 减少帧闪烁 |
| 滑动语义近似 | 通过滚动历史近似语义滑动 | 提高一致性 |
五、实验结果
消融实验
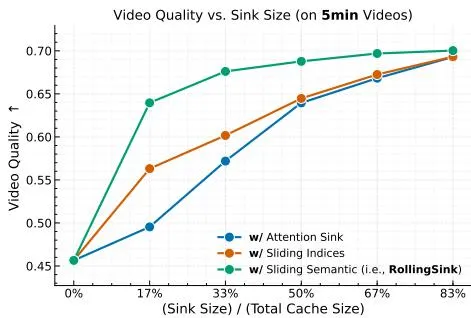
Figure 4: 系统分析过程中的评估结果,视频质量在各步骤中持续改进。视频质量分数是使用 VBench-Long 在所有维度上测试的平均分数。
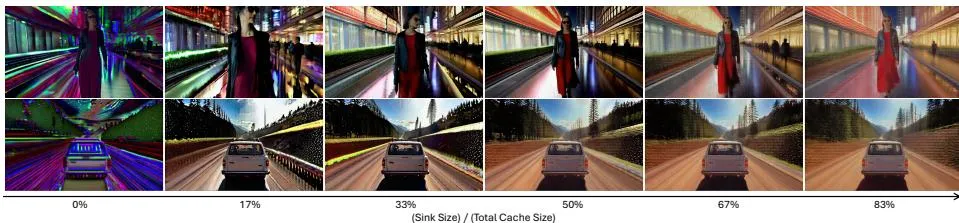
Figure 5: 不同 Sink 大小的视觉对比。较大的 sink 大小稳定了颜色,但仍然存在明显的 AR 漂移(例如帧闪烁)。设置 t = 60s。
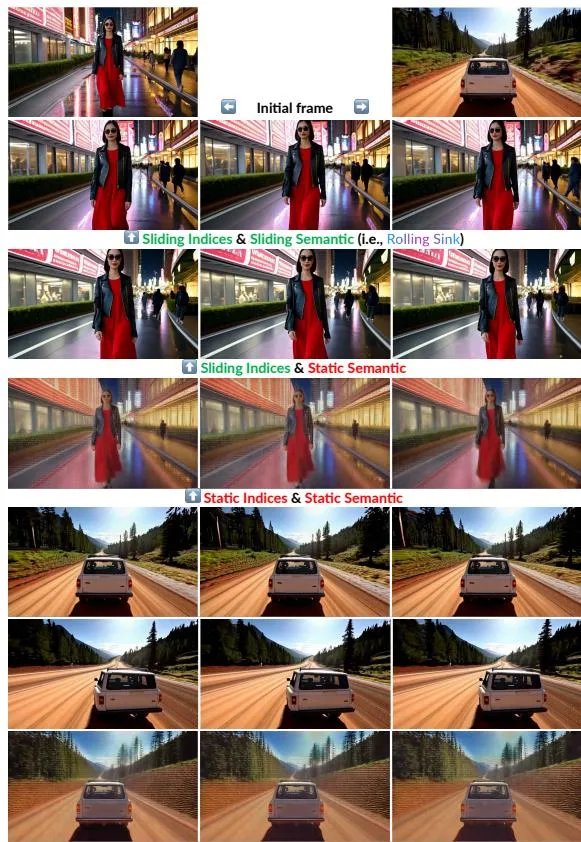
Figure 6: 滑动索引和滑动语义的视觉对比。引入滑动索引减少了 AR 漂移,最明显的是减轻了闪烁。通过滚动 sink 块的语义内容来近似滑动语义进一步减轻了 AR 漂移,表现为一致性的改善。
定量比较
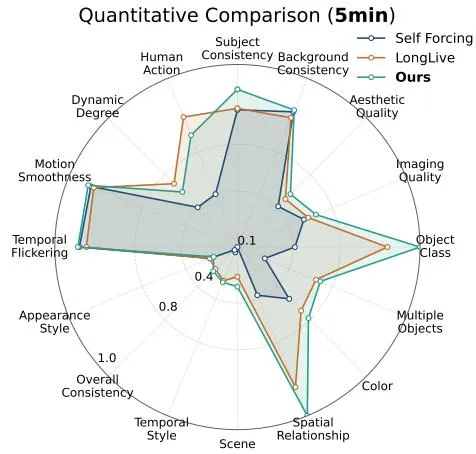
Figure 8: 1 分钟和 5 分钟 AR 视频合成的雷达图对比。Rolling Sink 在大多数 VBench-Long 维度上获得最高分数。
在两种设置中,提出的 Rolling Sink 都取得了最佳平均排名,并在大多数维度上获得最高分数,反映了在远超训练窗口的测试时减少的漂移和改善的视觉质量。
值得注意的是,虽然 Rolling Sink 建立在 Self Forcing 之上且不需要额外训练,但它产生了显著的性能提升。
与现有方法对比
| 方法 | 训练时长 | 测试时长 | 需要额外训练 |
|---|---|---|---|
| Rolling Sink (Ours) | 5s | 5min | 否 |
| Self Forcing | 5s | 1min | 否 |
| LongLive (w/o LoRA) | 5s | 1min | 否 |
| LongLive (w/ LoRA) | 1min | 2min | 是 |
六、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| Self Forcing | 基础方法,研究训练时长内的差距 |
| LongLive | 对比方法,需要 LoRA 微调 |
| Attention Sink | LLM 中的技术,本文引入到视频扩散 |
| Sora/Wan/Kling/Veo/Gen | 大型视频扩散模型,非自回归 |
七、总结
核心贡献
- 训练-测试差距分析: 首次系统分析 AR 视频扩散模型中训练时长内外的差距
- AR 缓存维护分析: 深入分析缓存机制对长视频生成的影响
- Rolling Sink: 无训练方法实现超长视频生成(5-30 分钟)
- 滑动索引和语义: 提出并验证两种关键技术
- 显著性能提升: 在不需要额外训练的情况下大幅超越基线
技术影响
- 无训练解决方案: 为长视频生成提供即插即用的方法
- 计算效率: 避免了昂贵的长视频训练成本
- 架构兼容性: 可应用于任何 AR 视频扩散模型
- 实际应用: 支持电影级长视频生成
局限性
- 基于 Self Forcing,受限于其基础模型能力
- 滑动语义是近似方法,可能存在信息损失
- 超长视频(>30 分钟)的性能有待进一步验证
八、参考资源
- 论文: arXiv:2602.07775
- 代码: GitHub - Rolling-Sink/Rolling-Sink
- 项目页: rolling-sink.github.io
- Demo: Hugging Face Spaces
- 视频展示: YouTube 5-30 分钟视频
- 许可: arXiv 非独占分发许可