Causal Forcing: Autoregressive Diffusion Distillation Done Right for High-Quality Real-Time Interactive Video Generation
面向高质量实时交互式视频生成的自回归扩散蒸馏正确方法
Causal Forcing: Autoregressive Diffusion Distillation Done Right for High-Quality Real-Time Interactive Video Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Causal Forcing: Autoregressive Diffusion Distillation Done Right for High-Quality Real-Time Interactive Video Generation |
| 作者 | Hongzhou Zhu, Min Zhao, Guande He, Hang Su, Chongxuan Li, Jun Zhu |
| 论文 | arXiv:2602.02214 |
| 代码 | 未公开 |
| 发布 | 2026年2月 |
二、核心思想
问题定义
自回归视频扩散模型的少步蒸馏是实现交互式视频生成的关键。当前 SOTA 方法 Self Forcing 采用两阶段流水线:先用 ODE 蒸馏将双向教师模型转换为自回归学生,再用 DMD 进一步提升。然而,Self Forcing 在视觉质量、动态程度和指令遵循方面仍显著落后于标准 DMD(蒸馏双向学生)。
核心问题:现有方法的性能退化源于未能正确解决架构差距 (architectural gap)——将双向全注意力模型转换为仅依赖过去上下文的因果注意力架构。
关键理论分析
帧级注入性 (Frame-level Injectivity) 原则:
ODE 蒸馏要求配对数据满足注入性——在任意时间步,每个噪声样本对应唯一的干净样本。
- 标准 ODE 蒸馏(双向→双向):视频级注入性自然成立
- Self Forcing 的 ODE 蒸馏(双向→自回归):帧级注入性被违反——同一个噪声帧 可能对应不同的干净帧 (取决于不同视频中的上下文)
违反注入性导致学生退化为条件期望:,表现为模糊。
解决方案概述
Causal Forcing 三阶段方法:
- 教师强制自回归扩散训练:用教师强制 (Teacher Forcing) 训练原生自回归扩散模型作为教师
- 因果 ODE 蒸馏:用自回归教师采样 PF-ODE 轨迹,训练自回归学生(帧级注入性满足)
- 非对称 DMD:用因果 ODE 蒸馏的模型初始化学生,进行最终蒸馏
三、技术架构
核心公式
问题分析:Self Forcing 的缺陷
Self Forcing 的 ODE 蒸馏目标:
其中 在双向教师的同一 PF-ODE 轨迹上。
缺陷:双向教师的映射 是视频级注入的,但帧级映射 不是注入的——同一噪声帧在不同视频上下文中对应不同干净帧。
命题 3.2:自回归扩散强制 (Diffusion Forcing) 训练的模型不遵循以因果前缀为条件的数据分布:
Causal Forcing 三阶段
阶段 1:教师强制自回归扩散训练
用教师强制 (TF) 训练自回归扩散模型——条件于干净的前序帧 ,而非噪声帧 (扩散强制 DF)。
TF 消除训练-推理分布不匹配,DF 则导致视频崩溃。
阶段 2:因果 ODE 蒸馏
用阶段 1 的自回归教师采样因果 PF-ODE 轨迹,训练自回归学生:
其中 在自回归教师的 PF-ODE 轨迹上。帧级注入性满足。
阶段 3:非对称 DMD
用因果 ODE 蒸馏的模型初始化自回归学生,双向基础模型作为教师,进行 DMD 蒸馏。
扩展:因果一致性模型 (Causal CD)
用原生自回归扩散模型作为教师,训练因果一致性模型:
其中 通过自回归教师的 ODE 求解得到。
训练流程
| 阶段 | 方法 | 步数 | 数据 |
|---|---|---|---|
| 1. AR 扩散训练 | 教师强制 | 2K | 3K 合成数据 |
| 2. 因果 ODE 蒸馏 | 自回归教师 | 1K | 3K 因果 ODE 轨迹 |
| 3. 非对称 DMD | 双向教师 | 750 | VidProM |
基础模型:Wan2.1-T2V-1.3B,生成 81 帧,分辨率 832×480
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 帧级注入性原则 | 识别 ODE 蒸馏的关键要求——帧级注入性 | 命题证明违反注入性导致退化为条件期望(模糊) |
| Self Forcing 缺陷分析 | 证明 Self Forcing 的 ODE 蒸馏违反帧级注入性 | 理论分析 + 控制实验验证 |
| 扩散强制 vs 教师强制 | 证明扩散强制导致训练-推理分布不匹配 | 命题证明 + 实验对比(DF 视频崩溃) |
| 因果 ODE 蒸馏 | 用自回归教师替代双向教师进行 ODE 蒸馏 | 帧级注入性满足,性能大幅提升 |
| 因果一致性蒸馏 | 首个因果 CD 框架,超越非对称 CD | 定性对比:非对称 CD 模糊 + 伪影 |
| 三阶段 Causal Forcing | TF→因果 ODE→DMD 的系统化流水线 | 全指标超越所有基线 |
五、实验结果
主要定量对比
| 模型 | 吞吐量↑ | 延迟↓ | Total↑ | Quality↑ | Semantic↑ | Dynamic↑ | Vision↑ | Instruct↑ | Rating↓ |
|---|---|---|---|---|---|---|---|---|---|
| 双向视频扩散模型 | |||||||||
| LTX-1.9B | 8.98 | 13.5 | 79.83 | 81.88 | 71.62 | 46 | – | – | – |
| Wan2.1-1.3B | 0.78 | 103 | 83.37 | 84.30 | 79.65 | 61 | 5.275 | 42 | 2.29 |
| 自回归视频扩散模型 | |||||||||
| NOVA | 0.88 | 4.1 | 80.31 | 80.66 | 78.92 | 46 | – | – | – |
| Pyramid Flow | 6.70 | 2.5 | 80.75 | 83.41 | 70.11 | 16 | 4.055 | – | – |
| SkyReels-V2-1.3B | 0.49 | 112 | 81.97 | 83.96 | 74.01 | 37 | 3.584 | 32 | 6.57 |
| MAGI-1-4.5B | 0.19 | 282 | 78.88 | 81.67 | 67.72 | 42 | 0.773 | 8 | 6.44 |
| 蒸馏自回归视频模型 | |||||||||
| CausVid | 17.0 | 0.69 | 81.33 | 83.98 | 70.72 | 62 | 5.741 | 12 | 4.27 |
| Self Forcing | 17.0 | 0.69 | 83.74 | 84.48 | 80.77 | 57 | 5.820 | 48 | 2.87 |
| Causal Forcing (Ours) | 17.0 | 0.69 | 84.04 | 84.59 | 81.84 | 68 | 6.326 | 56 | 1.64 |
关键发现:
- 在相同吞吐量 (17.0) 和延迟 (0.69s) 下,Causal Forcing 全指标超越 Self Forcing
- Dynamic Degree: 57 → 68 (+11),显著提升动态性
- VisionReward: 5.820 → 6.326 (+0.506),视觉质量大幅提升
- Instruction Following: 48 → 56 (+8),指令遵循能力增强
- User Rating: 2.87 → 1.64,用户偏好显著(越低越好)
- 甚至超越双向基础模型 Wan2.1-1.3B 的 Dynamic Degree (61→68)
消融实验
| 方法 | Total↑ | Quality↑ | Semantic↑ | Dynamic↑ | Vision↑ | Instruct↑ |
|---|---|---|---|---|---|---|
| AR 扩散训练 | ||||||
| Diffusion Forcing | 81.76 | 82.52 | 78.71 | 60 | 1.583 | 30 |
| Teacher Forcing | 82.12 | 82.73 | 79.67 | 50 | 3.343 | 32 |
| Chunk-wise 蒸馏 | ||||||
| Self Forcing’s ODE + DMD | 82.00 | 82.18 | 81.29 | 24 | 3.330 | 38 |
| Causal ODE + DMD | 84.04 | 84.59 | 81.84 | 68 | 6.326 | 56 |
| Frame-wise 蒸馏 | ||||||
| Self Forcing’s ODE + DMD | 81.83 | 82.66 | 78.50 | 2 | 1.951 | – |
| Causal ODE + DMD | 83.75 | 84.35 | 81.37 | 64 | 6.204 | 42 |
| 一致性蒸馏 | ||||||
| Asymmetric CD | 79.07 | 79.99 | 75.37 | 59 | – | – |
| Causal CD | 81.48 | 82.13 | 78.88 | 51 | 1.798 | 18 |
关键发现:
- 因果 ODE vs Self Forcing’s ODE:Dynamic 24→68,VisionReward 3.330→6.326,差距巨大
- TF vs DF:DF 的 VisionReward 远低于 TF (1.583 vs 3.343),验证理论分析
- Causal CD vs Asymmetric CD:Quality 79.99→82.13,大幅超越
六、关键可视化
Self Forcing vs Causal Forcing
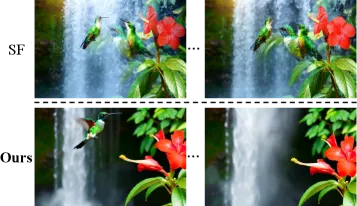
Self Forcing 的 DMD 展示较弱的动态性和伪影,而 Causal Forcing 产生更高的动态性和更好的视觉质量。
教师强制 vs 扩散强制
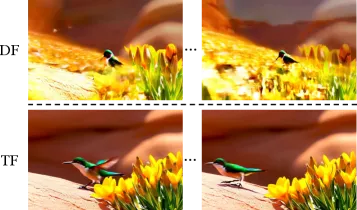
与常见认知相反,扩散强制 (DF) 由于训练-推理差距导致视频崩溃,而教师强制 (TF) 产生正确结果。
定性对比
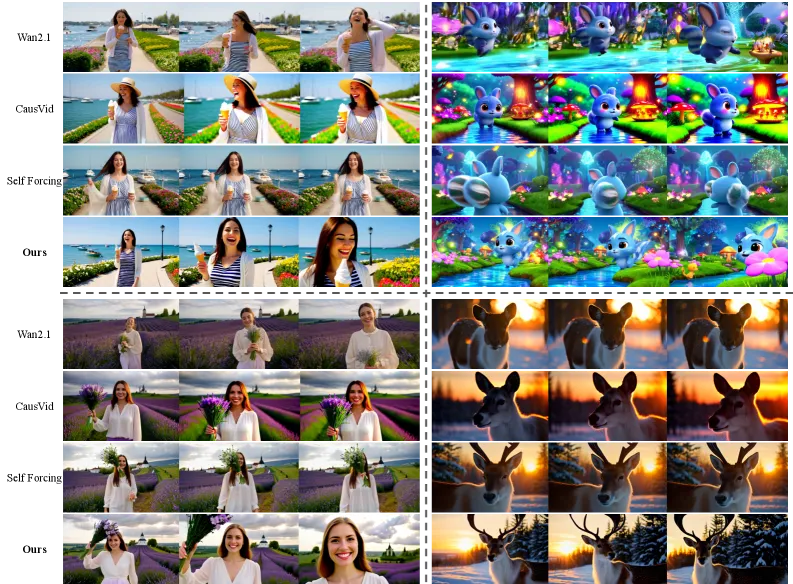
Causal Forcing 在动态程度和视觉质量上大幅超越现有蒸馏方法。
因果 CD vs 非对称 CD
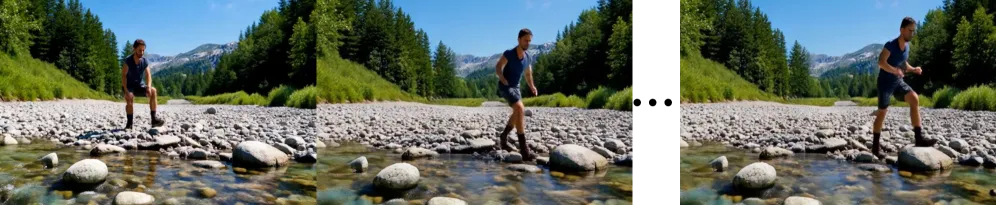
非对称 CD 出现严重模糊和伪影,而因果 CD 产生清晰结果。
七、相关工作
| 方向 | 代表工作 | 与 Causal Forcing 的关系 |
|---|---|---|
| 双向视频扩散 | Wan2.1, LTX, HunyuanVideo | 基础模型 |
| AR 视频扩散 | NOVA, Pyramid Flow, SkyReels-V2, MAGI-1 | 非蒸馏 AR 模型 |
| AR 蒸馏 | CausVid, Self Forcing | Causal Forcing 的基线和分析对象 |
| 一致性蒸馏 | LCM, CT | Causal CD 的理论基础 |
| DMD | DMD, DMD2 | Causal Forcing 的阶段 3 |
八、总结
核心贡献
- 帧级注入性原则:识别 ODE 蒸馏的关键理论要求,证明 Self Forcing 违反此要求
- 扩散强制 vs 教师强制:理论证明扩散强制导致训练-推理分布不匹配,教师强制更优
- 因果 ODE 蒸馏:用自回归教师替代双向教师,满足帧级注入性
- 因果一致性蒸馏:首个因果 CD 框架,超越非对称 CD
- Causal Forcing 三阶段方法:TF→因果 ODE→DMD,全指标 SOTA
- 显著性能提升:Dynamic Degree +11,VisionReward +0.5,Instruction Following +8
技术影响
- 为自回归视频扩散蒸馏提供了正确的理论框架
- 帧级注入性原则可推广到其他非对称蒸馏场景
- 教师强制 vs 扩散强制的分析对 AR 扩散训练有广泛指导意义
- Causal Forcing 为交互式视频生成设立了新 SOTA
局限性
- 代码未公开
- 仅在 Wan2.1-1.3B 上验证,泛化性待进一步验证
- 三阶段流水线相对复杂
- 依赖合成数据和预训练双向模型
九、参考资源
- 论文: arXiv:2602.02214
- 关键引用:
- Self Forcing (Huang et al., 2025a) — Causal Forcing 的主要基线和分析对象
- CausVid (Yin et al., 2025) — 早期 AR 蒸馏方法
- Wan2.1 (Wan et al., 2025) — 基础双向视频扩散模型
- DMD (Yin et al., 2024) — 分布匹配蒸馏
- VidProM (Wang and Yang, 2024) — DMD 训练数据
分析日期: 2026-06-05