FSVideo: Fast Speed Video Diffusion Model in a Highly-Compressed Latent Space
ByteDance's FSVideo achieves 42.3x speedup over Wan2.1 via 64×64×4 compression autoencoder, layer memory self-attention DIT, and few-step latent upsampler
FSVideo: Fast Speed Video Diffusion Model in a Highly-Compressed Latent Space
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FSVideo: Fast Speed Video Diffusion Model in a Highly-Compressed Latent Space |
| 作者 | FSVideo Team (Xinwei Huang, Minxuan Lin, Yaojie Shen, Xiao Yang*, Yuxin Zhang et al.) |
| 机构 | Intelligent Creation, ByteDance |
| 论文 | https://arxiv.org/abs/2602.02092 |
| 项目页 | https://kingofprank.github.io/fsvideo/ |
| 发布 | arXiv:2602.02092v1 [cs.CV], Feb 2, 2026 |
二、核心思想
问题定义
视频生成模型(如 Sora 2, Veo 3, Kling, Wan, SeedDance)虽然展示了令人印象深刻的生成能力,但高昂的推理成本导致漫长的等待时间和 GPU 成本,限制了其面向更广泛用户群体的扩展。现有加速方法分为两类:
- 训练-free 方法:高效求解器、缓存方法、低分辨率采样、稀疏注意力——加速效果有限且可能降低质量
- 基于训练的加速方法:减小模型尺寸或替换注意力操作——通常因容量减少而损失生成质量;步骤蒸馏虽可获得更大加速,但在实际使用中(4-8步推理),由于潜空间 ODE/SDE 路径的高估计误差,质量会急剧下降
解决方案概述
FSVideo 的核心思想是减少每次模型前向传播的计算量,而非减少步数或模型大小。通过三个关键组件实现:
- 高压缩视频自编码器 (FSAE):64×64×4 时空下采样率(总压缩比 1:384),将 token 数量大幅减少
- 带层记忆机制的 DIT:层间动态路由器增强信息流和上下文复用
- 多分辨率生成策略:轻量级 few-step DIT upscaler 提升视频保真度
最终模型包含一个 14B 参数 base DIT 和一个 14B 参数 upsampler,相比 Wan2.1-I2V-14B-720P 快 42.3 倍。
三、技术架构
整体框架图
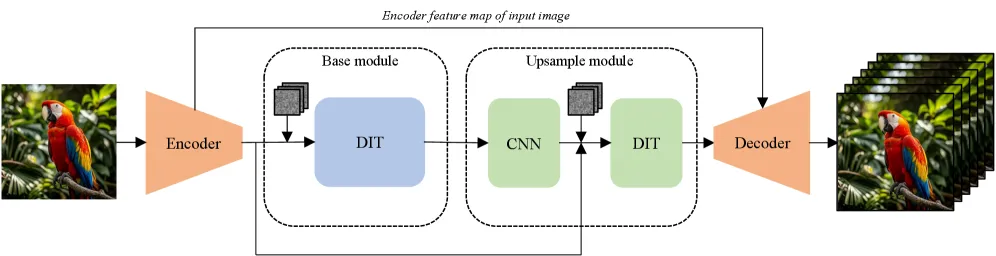
FSVideo I2V Pipeline:

输入图像 → FSAE Encoder → VAE Latent (64×64×4压缩)
                              ↓
                    Base DIT (14B, 60 NFE)
                    + Layer Memory Self-Attention
                              ↓
                    低分辨率 latent (512p)
                              ↓
              ┌───────────────┴───────────────┐
              ↓                               ↓
    Latent CNN Upsampler              输入图像 latent
    (Pixel Shuffle + 16 ResBlocks)        ↓
              ↓                   Upsampler DIT (14B, 8 NFE)
            高分辨率 latent ←───────+───────条件输入
              ↓
    FSAE Decoder (with cross-attn)
              ↓
          输出视频 (1024p)
核心公式
1. 总压缩率定义
其中 为空间压缩比, 为时间压缩比( 为因果卷积时为 1), 为潜在通道数。
FSAE:
2. 视频 VF Loss(对齐潜在空间语义)
特征对齐:
- 通过可学习线性层 映射 的通道到
- 空间插值 匹配
- 对 在时间维度做 kernel=4 的平均池化
Video Marginal Cosine Similarity Loss:
Video Marginal Distance Matrix Similarity Loss:
总损失:
其中 。
3. Layer Memory Self-Attention
动态路由器权重:
聚合特征:
注意力计算:
Query 仍来自前一层的输出,Keys 和 Values 通过层自适应聚合得到。
4. Flow Matching 与 Deviation-Based Latent Estimation
在 flow matching 中:
预测的低分辨率干净潜变量:
故意扰动的潜变量(确保 refiner 不会过拟合输入):
当 时, 接近 (base DIT 高噪声水平预测);当 时,误差被 放大,确保 refiner 始终有修复空间。
5. Latent Upsampler Loss
其中 从 0.1 逐渐增加到 1.0。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| FSAE-Standard | 64×64×4 压缩视频自编码器,128 通道 | 编码器: 3 conv + 4 trans blocks; 解码器: 4 trans + 3 conv blocks |
| FSAE-Lite | 轻量化版本,减少最后两 block 通道数 | 内存减少 1.75-2×,推理更快 |
| Base DIT | 14B 参数扩散 Transformer | 基于 Wan2.1-14B-I2V,Layer Memory + Dynamic Router |
| Latent CNN Upsampler | 投影层 + Pixel Shuffle + 16 ResBlocks | 将 latent 分辨率提升 2× |
| Refiner DIT | 14B 参数高分辨率细化器 | 8 NFE (CFG distillation + step distillation + SiDA) |
训练流程
FSAE 训练(三阶段)
| 阶段 | 分辨率 | 数据 | 损失函数 | 迭代次数 |
|---|---|---|---|---|
| Stage 1 | 256×256 | 图像 + 17帧视频 | L1 + LPIPS | ~200K |
| Stage 2 | 512×512 | 图像 + 61帧视频 | L1 + LPIPS + GAN | ~200K |
| Stage 3 | 1024×1024 / 121帧 | 混合分辨率 | L1 + LPIPS + GAN + Video VF | ~200K |
Stage 3 使用三种显存优化技巧:
- 混合分辨率训练:同时训练低分辨率长视频(256×256×171)和高分辨率短视频(704×704×9)
- 3D patch 提取:从解码器倒数第三 block 随机提取小 3D patch 进行 loss 计算
- LPIPS 时间切片:减少峰值内存
DIT 训练
预训练三阶段(Flow Matching + Pseudo-Huber Loss):
- Stage 1: 256×256 图像(文本-视觉对齐)
- Stage 2: 256×256 视频(运动 + 低分辨率外观)
- Stage 3: 512×512 视频(目标分辨率) 训练步数比例 ≈ 1:2:2
后训练:
- SFT: 300K 高质量样本(美学分数 + 运动幅度过滤)
- RL: ReFL 框架 + VideoAlign + MPS reward model
- 多轮 DIT 与 VideoAlign RM 微调
- Domain adaptation: 用多模型生成视频构建候选池进行 RM 微调
- First-frame conditioning: 将首帧作为额外条件输入 Reward Model
Refiner 训练:
- 继承 Base DIT 参数初始化
- 1024×1024 高分辨率视频数据
- CFG distillation → Progressive distillation to 32 steps → SiDA to 8 steps
- RL: MixGRPO sliding window strategy + fine-tuned VideoAlign RM
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 64×64×4 高压缩自编码器 | 总压缩比 1:384,128 通道,竞争性的重建质量 | Table 2: SSIM 0.806 (Inter-4K), FVD 256.62 优于 LTX-Video |
| Video VF Loss | 首个视频领域的视觉基础模型对齐损失 | Table 1: 内在维度最低 [24.44, 29.60, …] vs 无正则化 [87.83, …] |
| Layer Memory Self-Attention | 跨层动态路由器实现可微分深度记忆 | Figure 7: 从头训练损失更低更快收敛;微调 1000 步提升 4.7% |
| Deviation-Based Latent Estimation | 故意引入扰动确保 refiner 学会修复而非复制 | Section 2.4.2: 防止 overfit 低分辨率输入的关键设计 |
| Dynamic Masking Scheme | 基于上采样误差的动态掩码替代二元掩码 | 解决 video-to-video 场景下真实/生成 latent 区分困难 |
| Few-step Refiner (8 NFE) | CFG distillation + step distillation + SiDA | 推理时间减少 87%,保持高质量 |
五、代码实现分析
训练框架:PyTorch 2 + Fully Sharded Data Parallel (FSDP) + Gradient Checkpointing + Context Parallelization
优化器:AdamW, betas=[0.9, 0.95]
关键实现细节:
- Patchify kernel size 为 (1,1,1),因 VAE 已完成重度压缩
- 序列长度
- 注意力仅在高度和宽度维度操作(不敏感于时间维度变化)
- 所有归一化改为 pixel norm
- 解码器使用 group-causal convolution(group size 1, 2, 4)
六、实验结果
自编码器重建质量
Table 2: 与其他 SOTA 自编码器对比
| 方法 | 压缩比 | Inter-4K SSIM↑ | Inter-4K FVD↓ | WebVid-10M SSIM↑ | WebVid-10M FVD↓ |
|---|---|---|---|---|---|
| FSAE-Standard | 1:384 | 0.806 | 256.62 | 0.872 | 203.19 |
| FSAE-Lite | 1:384 | 0.788 | 342.66 | 0.861 | 240.03 |
| LTX-Video | 1:192 | 0.787 | 370.86 | 0.868 | 232.02 |
| Cosmos-CV | 1:384 | 0.724 | 704.08 | 0.786 | 518.86 |
FSAE-Standard 在相同压缩比(1:384)下显著优于 Cosmos-CV,且在 SSIM 和 FVD 上均优于 LTX-Video(仅 1:192 压缩)。
视频生成质量
Table 3: VBench 720×1280 I2V 评测
| 方法 | 参数量 | Total Score↑ | I2V Score↑ | Quality Score↑ |
|---|---|---|---|---|
| Step-Video-TI2V | 30B | 88.36% | 95.50% | 81.22% |
| DC-VideoGen-Wan-2.1-14B | 14B | 87.73% | 94.08% | 81.39% |
| FSVideo | 14+14B | 88.12% | 95.39% | 80.85% |
| HunyuanVideo-I2V | 13B | 86.82% | 95.10% | 78.54% |
| Wan2.1-I2V-14B-720P | 14B | 86.86% | 92.90% | 80.82% |
FSVideo 在基于 Wan 2.1 DIT 的模型中获得最高总分,仅略低于 Step-Video-TI2V(参数量是其 2 倍以上)。
Figure 10: GSB (Good/Same/Bad) 人类评估
- 大幅优于 HunyuanVideo 和 LTX-Video
- 与 Wan 2.1 14B 相当
- 不及 Wan 2.2 14B(但 FSVideo 训练数据有限且欠训练)
推理速度
Table 4: H100 GPU 推理速度对比(5秒 720×1280 24fps)
| 配置 | Wan2.1-I2V-14B | FSVideo | 加速比 |
|---|---|---|---|
| 1×H100 (offloading) | OOM | 76.6s | — |
| 2×H100 (FSDP) | 822.1s | 19.4s | 42.3× |
| 1×H100 (无内存限制, FP8估计) | 1607.5s* | 27.4s | 58.7× |
*注:Wan 使用 60 NFE,FSVideo 使用 68 NFE(60 base + 8 refiner),加速比已考虑此差异。
七、相关工作
| 工作 | 关系 |
|---|---|
| Wan2.1-14B-I2V | Base DIT 架构基准,FSVideo 在其基础上添加 Layer Memory |
| LTX-Video | 32×32×8 压缩 VAE(1:192),FSAE 在更高压缩比下超越其重建质量 |
| DC-AE | 32×32 空间压缩的图像 VAE,FSAE 的基础起点 |
| Reducio-VAE | 使用额外 2D VAE 编码 mid-frame feature,FSAE 直接复用编码器 |
| LIMe | 语言模型中的层记忆机制,启发 FSVideo 的 inter-layer dynamic router |
| U-DIT | U-net 风格 DIT + skip connections,FSVideo 探索通用 DIT 适用方案 |
| VA-VAE | 图像领域的视觉基础模型对齐,FSVideo 扩展到视频领域 |
八、总结
核心贡献
- FSAE:64×64×4 高压缩视频自编码器(1:384 总压缩比),128 通道,竞争性重建质量,支持 1024×1024×121 高分辨率视频
- Video VF Loss:首个视频领域视觉基础模型对齐损失,降低潜在空间内在维度,提升生成能力
- Layer Memory Self-Attention:跨层动态路由器实现可微分深度记忆,加速收敛并提升最终损失
- Latent Upsampler + Refiner:CNN latent upscaler + few-step DIT refiner 的多分辨率生成策略,8 NFE 完成高分辨率细化
- 42.3× 推理加速:相比 Wan2.1-14B,在相似参数量下实现数量级加速
技术影响
- 证明了减少 token 数量而非减少步数是视频生成加速的有效方向
- 高压缩 VAE(1:384)在保持生成质量的同时大幅降低计算需求
- Layer Memory 机制为 DIT 架构提供了新的信息流设计范式
局限性
- 仅支持 I2V:专注 image-to-video 而非 text-to-video,受限于训练数据和资源约束
- 双模型部署:两个 14B 模型需要较高 GPU 内存(单卡需 offloading)
- 欠训练状态:作者承认在有限数据和计算下欠训练,性能有望进一步提升
- FSAE-Lite 重建质量下降:Lite 版本 SSIM 和 FVD 较 Standard 有明显退化
九、参考资源
- arXiv: https://arxiv.org/abs/2602.02092
- Project Page: https://kingofprank.github.io/fsvideo/
- Wan2.1: https://github.com/Wan-Video/Wan2.1
- LTX-Video: https://github.com/Lightricks/LTX-Video
- DC-AE: Chen et al., “Deep Compression Autoencoder for Image Generation”
- VBench: https://github.com/Vchitect/VBench