SkyReels-V3 Technique Report
统一多模态上下文学习框架,单架构支持参考图像到视频、视频到视频扩展和音频引导视频生成三大核心范式
SkyReels-V3 Technique Report
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SkyReels-V3 Technique Report |
| 作者 | Debang Li, Zhengcong Fei, Tuanhui Li, Yikun Dou, Zheng Chen, Jiangping Yang, Mingyuan Fan, Jingtao Xu, Jiahua Wang, Baoxuan Gu, Mingshan Chang, Wenjing Cai, Yuqiang Xie, Binjie Mao, Youqiang Zhang, Nuo Pang, Hao Zhang, Yuzhe Jin, Zhiheng Xu, Dixuan Lin, Guibin Chen, Yahui Zhou |
| 机构 | Skywork AI |
| 论文 | https://arxiv.org/abs/2601.17323 |
| 代码 | https://github.com/SkyworkAI/SkyReels-V3 |
| 发布 | 2026-01-24 |
| 许可 | 未明确标注 |
二、核心思想
问题定义
视频生成作为构建世界模型的基石,面临多模态上下文推理的核心挑战。现有视频生成模型通常针对单一任务设计(如文本到视频、图像到视频),难以在同一架构内灵活支持多种生成范式,限制了模型的通用性和实用性。
解决方案概述
SkyReels-V3 是一个统一的多模态条件视频生成框架,基于扩散 Transformer 和多模态上下文学习范式,单架构支持三大核心生成能力:
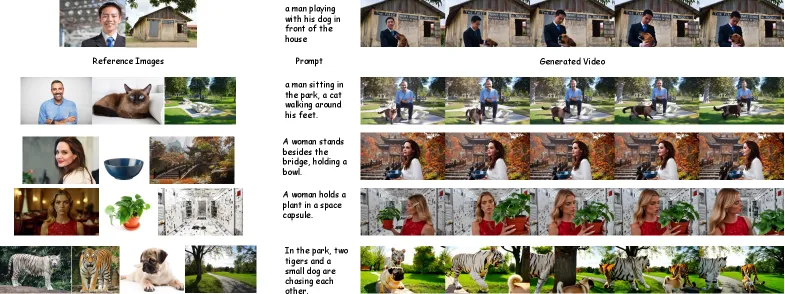
- 参考图像到视频(Reference-to-Video):从 1-4 张参考图像生成高保真视频,保持主体身份、空间构图和叙事连续性
- 视频扩展(Video Extension):支持单镜头延续和智能多镜头切换(5 种专业电影转场模式)
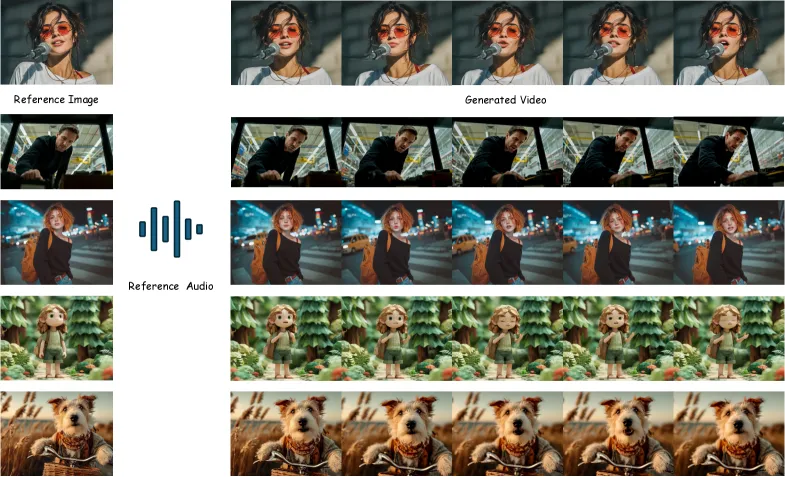
- 音频引导视频生成(Talking Avatar):分钟级音频条件视频生成,精确唇部同步
三、技术架构
整体框架
SkyReels-V3 基于 SkyReels-V2 的扩散 Transformer 骨干,通过以下核心设计实现统一多模态控制:
核心组件:
- 视频 VAE:因果 3D VAE 联合压缩时间轴和空间轴
- UMT5 文本编码器:生成语义嵌入
- 多参考图像编码:最多支持 4 张参考图像,通过 VAE 编码后与视频潜在表示拼接
- 音频条件注入:Whisper 编码 + 1D RoPE + 交叉注意力
参考图像到视频(Reference-to-Video)
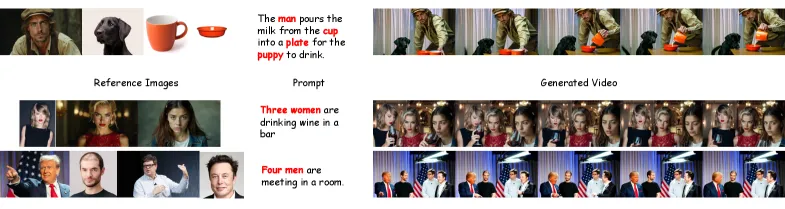
参考保持数据构建:
- 视频数据过滤:从大规模内部数据集中筛选高视觉质量和显著动态运动的片段
- 跨帧配对策略:从连续视频序列中选择参考帧,确保时间多样性同时保持语义一致性
- 图像编辑处理:使用图像编辑模型提取主体区域并执行背景补全
- 语义重写:构建避免简单帧复制的训练对,减少”复制粘贴”伪影
- 多级过滤:移除编辑模型生成的失真和不一致参考图像
多参考条件注入:
- 每张参考图像通过视频 VAE 编码
- 潜在表示与视频潜在表示沿通道维度拼接
- 支持最多 4 张参考图像,实现灵活场景构图
- 无需显式手动构图即可生成复杂多主体、多元素视频
训练策略:
- 图像-视频混合训练:联合利用大规模图像和视频数据集,增强静态外观和动态运动模式的泛化能力
- 多分辨率联合训练:提升不同空间尺度和宽高比的鲁棒性,原生支持多种输出配置
视频扩展(Video Extension)
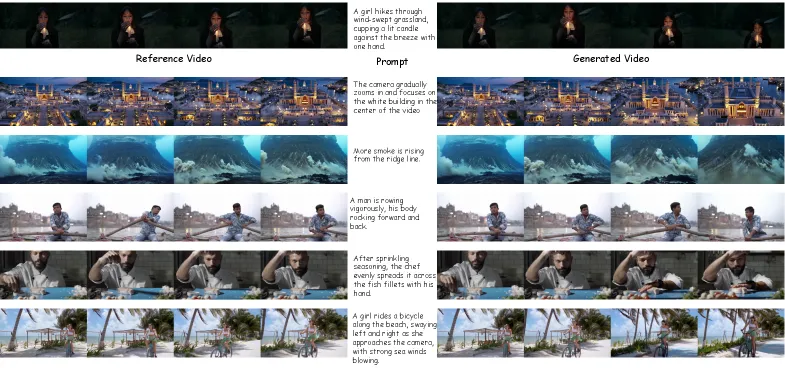
双扩展模式:
| 模式 | 说明 | 时长 |
|---|---|---|
| 单镜头扩展 | 连续延伸单个镜头 | 5-30 秒 |
| 镜头切换扩展 | 5 种预定义转场类型 | 灵活 |
镜头切换类型:
| 类型 | 图片 | 说明 |
|---|---|---|
| Cut In | 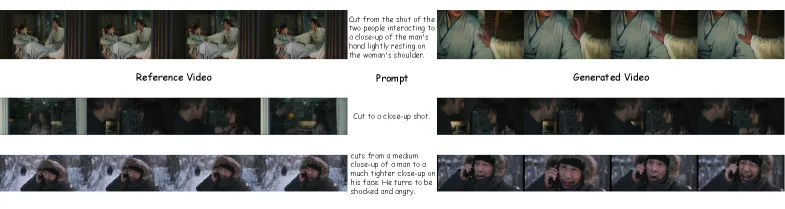 | 切入 |
| Cut Out | 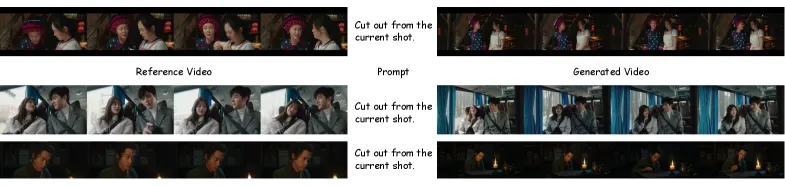 | 切出 |
| Multi Angle | 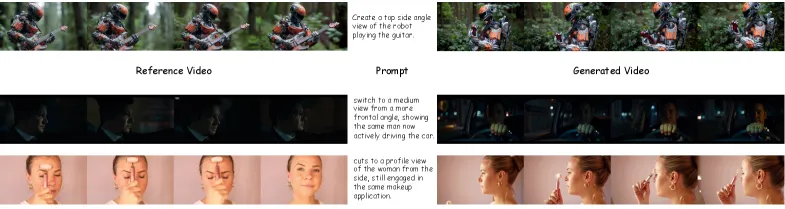 | 多角度 |
| Shot/Reverse Shot | 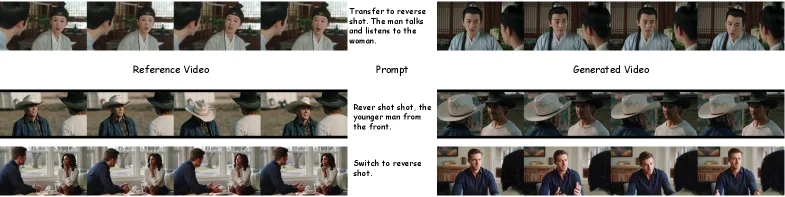 | 正反打 |
| Cut Away | 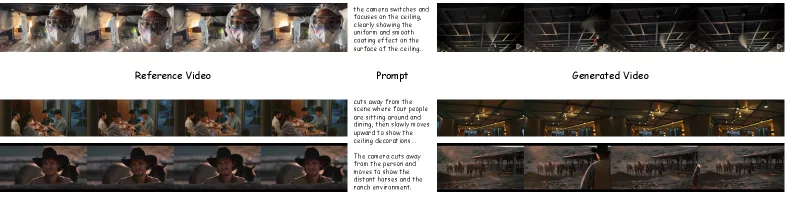 | 切离 |
关键技术:
- 镜头切换检测器:分析长视频,识别镜头转场并分类类型
- 统一多段位置编码:结合分层数据训练,实现准确运动建模和平滑过渡
- 鲁棒时空建模:处理快速运动、多主体交互和突变场景切换
输出规格:
- 分辨率:720p
- 宽高比:1:1, 3:4, 4:3, 16:9, 9:16
- 帧率:24 fps
音频引导视频生成(Talking Avatar)
核心能力:
| 能力 | 说明 |
|---|---|
| 高保真视觉合成 | 720p 24fps,精细面部细节 |
| 精确唇部同步 | 音素级音频动态对齐 |
| 多风格角色泛化 | 真实人物、卡通、动物、风格化角色 |
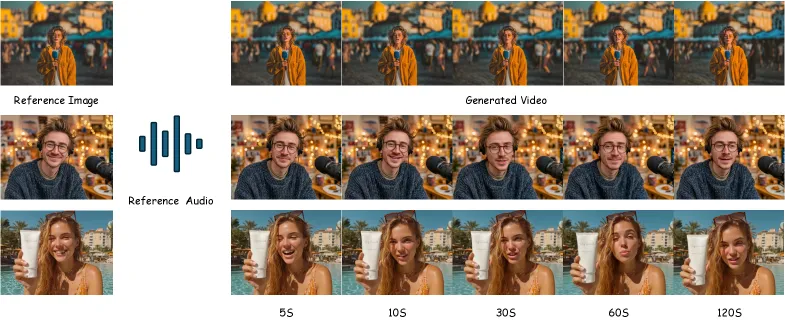
| 长视频连贯生成 | 分钟级视频合成 |
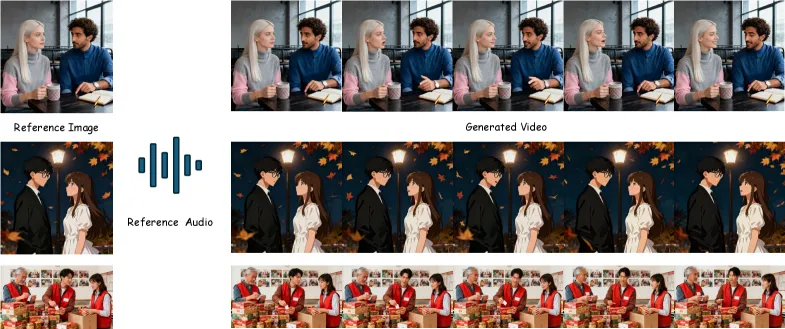
| 多角色场景支持 | 多头像对话、采访等复杂场景 |
技术要点:
- 音频-视觉对齐策略:区域掩码显式建模语音单元与面部运动的对应关系
- 关键帧约束生成框架:先建立结构关键内容,再生成帧间平滑过渡
- 混合推理策略:前 N 步使用完整视频输入保持结构一致性,后续切换到图像输入细化唇部同步
广告与产品展示
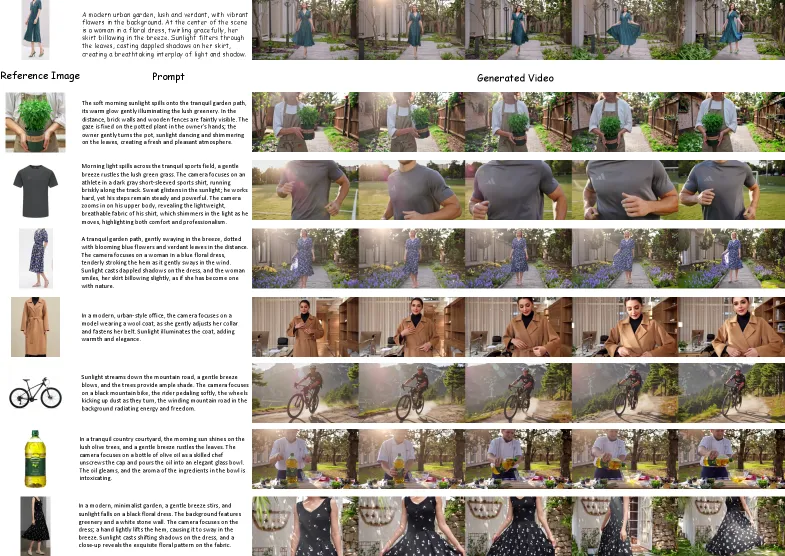
SkyReels-V3 可从单张图片生成广告和产品展示视频。
直播电商
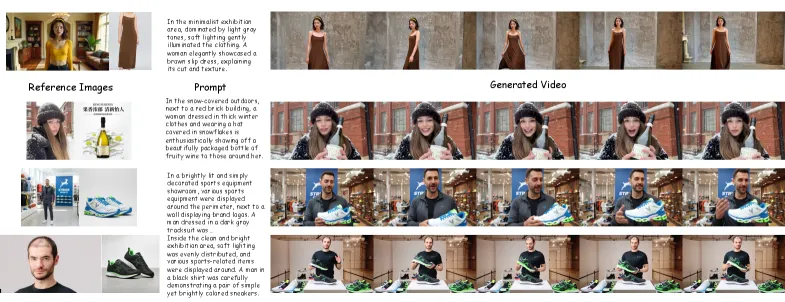
支持多样化直播主播和场景的即时视频创建。
四、核心创新
| 创新点 | 说明 | 优势 |
|---|---|---|
| 统一多模态架构 | 单模型支持 Ref2V、V2V、Talking Avatar | 灵活多任务能力 |
| 多参考条件注入 | 最多 4 张参考图像,VAE 编码拼接 | 复杂场景构图 |
| 跨帧配对数据构建 | 避免简单帧复制,减少伪影 | 更高质量训练数据 |
| 镜头切换检测器 | 5 种专业转场类型自动检测 | 智能视频扩展 |
| 关键帧约束生成 | 先关键帧后平滑过渡 | 长视频时间稳定性 |
| 图像-视频混合训练 | 联合静态和动态数据 | 更强泛化能力 |
| 多分辨率联合训练 | 多种宽高比原生支持 | 灵活输出配置 |
五、代码实现分析
项目结构
SkyReels-V3/
├── README.md
├── requirements.txt
├── generate_video.py          # 统一推理脚本
├── models/                    # 模型权重
├── configs/                   # 配置文件
└── examples/                  # 示例数据
模型系列
| 模型类型 | 变体 | 链接 |
|---|---|---|
| Reference-to-Video | 14B-720P | HuggingFace / ModelScope |
| Video Extension | 14B-720P | HuggingFace / ModelScope |
| Talking Avatar | 19B-720P | HuggingFace / ModelScope |
推理示例
单 GPU 推理:
python3 generate_video.py --task_type reference_to_video \
  --ref_imgs "img1.png,img2.png" \
  --prompt "描述文本" \
  --duration 5 --offload
多 GPU 推理(xDiT USP):
torchrun --nproc_per_node=4 generate_video.py \
  --task_type reference_to_video \
  --ref_imgs "img1.png,img2.png" \
  --prompt "描述文本" \
--duration 5 --offload --use_usp任务类型:
reference_to_video:参考图像到视频single_shot_extension:单镜头视频扩展shot_switching_extension:镜头切换视频扩展talking_avatar:音频引导视频生成
六、实验结果
参考图像到视频基准测试
| 模型 | Reference Consistency ↑ | Instruction Following ↑ | Visual Quality ↑ |
|---|---|---|---|
| Vidu Q2 | 0.5961 | 27.84 | 0.7877 |
| Kling 1.6 | 0.6630 | 29.23 | 0.8034 |
| PixVerse V5 | 0.6542 | 29.34 | 0.7976 |
| SkyReels-V3 | 0.6698 | 27.22 | 0.8119 |
测试集:200 对数据,涵盖影视、电商、广告等场景。
SkyReels-V3 在参考一致性(0.6698)和视觉质量(0.8119)上达到最优。
Talking Avatar 基准测试
| 模型 | Audio-Visual Sync ↑ | Visual Quality ↑ | Character Consistency ↑ |
|---|---|---|---|
| OmniHuman 1.5 | 8.25 | 4.60 | 0.81 |
| KlingAvatar | 8.01 | 4.55 | 0.78 |
| HunyuanAvatar | 6.72 | 4.50 | 0.74 |
| SkyReels-V3 | 8.18 | 4.60 | 0.80 |
SkyReels-V3 与闭源模型 OmniHuman 1.5 具有可比性,视觉质量达到同等水平。
定性结果
参考图像到视频:
- Figure 1-4:展示多主体交互、多样化场景、直播电商、广告产品展示
- 模型在多种场景下展现强泛化能力
视频扩展:
- Figure 5:单镜头 5-30 秒扩展
- Figure 6-10:5 种专业镜头切换模式(Cut In/Out、Multi Angle、Shot/Reverse Shot、Cut Away)
音频引导视频生成:
- Figure 11:多目标和多风格泛化(非人类主体、不同风格)
- Figure 12:多人对话场景,说话/空闲状态切换
- Figure 13:分钟级视频生成,一致视觉效果和精确音频对齐
七、相关工作
视频生成模型
- SkyReels-V2:无限长度电影生成模型(本文基础)
- Wan2.1:开源大规模视频生成模型
- HunyuanVideo:高质量视频生成
- CogVideoX:专家 Transformer 视频生成
- Seedance 1.5 Pro:原生音视频联合生成
闭源商业系统
- Veo (Google):高质量视频生成
- Sora (OpenAI):视频生成世界模型
- Kling (快手):商业视频生成系统
Talking Avatar 方法
- OmniHuman 1.5:高质量说话人像生成
- KlingAvatar:音频驱动视频生成
- HunyuanAvatar:音频条件视频生成
- SkyReels-Audio:全音频条件说话人像框架
八、总结
核心贡献
- 统一多模态架构:单模型支持参考图像到视频、视频扩展和音频引导视频生成三大范式
- 多参考条件注入:最多 4 张参考图像的灵活场景构图
- 专业镜头切换:5 种电影转场模式的智能检测和生成
- 分钟级音频同步:精确唇部同步和长时间一致性
- 全面开源:代码和模型权重完全开放
技术影响
- 统一框架范式:证明单模型可有效处理多种视频生成任务
- 多模态上下文学习:视觉、音频、文本的灵活组合控制
- 专业视频制作:镜头切换、叙事连贯性支持专业级应用
- 开源生态:推动社区研究和应用
局限性
- 技术报告简短:缺少详细的架构描述、训练细节和消融实验
- 评估有限:仅报告了少量基准测试结果,缺乏全面对比
- 模型规模大:14B/19B 参数需要大量计算资源
- 任务分离:三种能力使用不同模型变体,非真正统一推理
- 长视频挑战:分钟级生成仍可能存在质量下降
九、参考资源
论文
- 本文: https://arxiv.org/abs/2601.17323
- 代码: https://github.com/SkyworkAI/SkyReels-V3
- HuggingFace: https://huggingface.co/Skywork
- ModelScope: https://modelscope.cn/organization/Skywork
相关工作
- SkyReels-V2: 无限长度电影生成模型
- SkyReels-Audio: 全音频条件说话人像框架
- SkyReels-A1: 人像图像动画
- SkyReels-A2: 元素组合视频生成
- Wan2.1: 大规模视频生成模型
模型
- Reference-to-Video 14B-720P
- Video Extension 14B-720P
- Talking Avatar 19B-720P