Wan-Move: Motion-controllable Video Generation via Latent Trajectory Guidance
通过潜在轨迹引导实现运动可控的视频生成
Wan-Move: Motion-controllable Video Generation via Latent Trajectory Guidance
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Wan-Move: Motion-controllable Video Generation via Latent Trajectory Guidance |
| 作者 | Ruihang Chu, Yefei He, Zhekai Chen, Shiwei Zhang, Xiaogang Xu, Bin Xia, Dingdong Wang, Hongwei Yi, Xihui Liu, Hengshuang Zhao, Yu Liu, Yingya Zhang, Yujiu Yang |
| 机构 | Tongyi Lab (Alibaba), Tsinghua University, HKU, CUHK |
| 论文 | arXiv:2512.08765 |
| 代码 | GitHub - ali-vilab/Wan-Move |
| 发布 | 2025年12月9日 |
| 主题 | cs.CV |
二、核心思想
问题定义
运动控制是视频生成的核心,但现有方法存在两个关键限制:
- 表示粒度粗糙: 边界框和分割掩码无法控制局部运动;光流需要额外模型估计,累积误差;点轨迹缺乏空间上下文
- 集成方式复杂: 现有方法引入额外运动编码器和融合模块(如 ControlNet),信号在处理过程中退化,且难以大规模微调
核心观察
I2V 生成旨在动画第一帧,运动轨迹指定物体在后续帧的位置。由于 VAE 的平移等变性,轨迹位置的潜在特征应与第一帧高度相似。
解决方案概述
Wan-Move 提出简单可扩展的运动控制框架:
- 潜在轨迹引导: 将点轨迹从像素空间映射到潜在空间
- 潜在特征复制: 沿轨迹复制第一帧特征到后续帧
- 无额外模块: 直接编辑图像条件特征,无需运动编码器
- 可扩展微调: 基于 Wan-I2V-14B,轻松大规模微调
核心性能
| 指标 | 数值 |
|---|---|
| 视频质量 | 832×480p, 5 秒 |
| MoveBench FID | 12.2 (vs Tora 22.5, MagicMotion 17.5) |
| MoveBench EPE | 2.6 (vs Tora 3.3, MagicMotion 3.2) |
| 人类评估 | 与 Kling 1.5 Pro 竞争性表现 |
| 推理开销 | 仅增加 3 秒 (vs ControlNet +225 秒) |
三、技术架构
整体框架
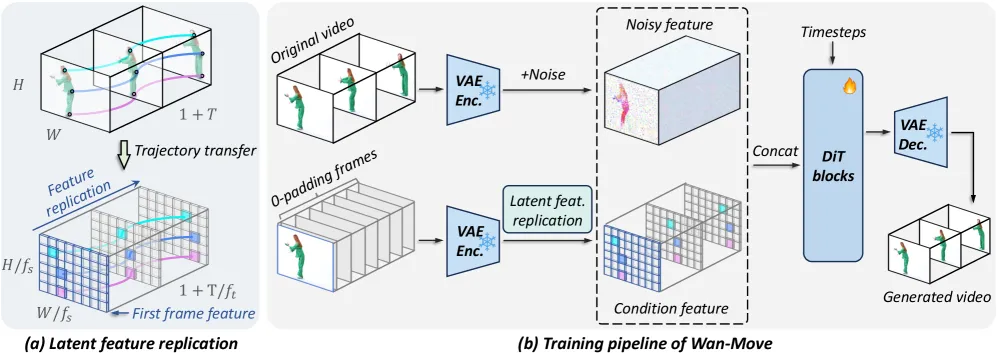
Figure 2: (a) 为注入运动引导,将点轨迹从视频转移到潜在空间,然后沿每条潜在轨迹将第一帧特征复制到后续零填充帧。(b) Wan-Move 基于现有 I2V 生成模型训练,通过高效的潜在特征复制步骤更新条件特征。
核心公式
条件特征构建
I2V 模型通过连接潜在噪声 和第一帧条件特征 沿通道维度:
z_{\text{image}} = \mathcal{E}(\text{concat}[\mathbf{I}, \mathbf{0}_{T \times H \times W \times 3}]) \in \mathbb{R}^{(1+Tf_t) \times \frac{H}{f_s} \times \frac{W}{f_s} \times C} \tag{1}
潜在轨迹映射
将像素空间轨迹 映射到潜在空间:
\tilde{\mathbf{p}}[n] = \begin{cases} \frac{\mathbf{p}[n]}{f_s} & \text{if } n = 0 \\ \frac{\sum_{i=(n-1) \cdot f_t + 1}^{n \cdot f_t} \mathbf{p}[i]}{f_t \cdot f_s} & 1 \leq n \leq \frac{T}{f_t} \end{cases} \tag{2}
第一帧轨迹位置通过空间映射获得,后续帧对每 帧取平均。
潜在特征复制
提取第一帧在初始轨迹点 的潜在特征,沿轨迹复制到后续帧:
z_{\text{image}}[n, \tilde{\mathbf{p}}[n, 0], \tilde{\mathbf{p}}[n, 1], :] = z_{\text{image}}[0, \tilde{\mathbf{p}}[0, 0], \tilde{\mathbf{p}}[0, 1], :] \tag{3}
for
关键: 利用潜在特征的平移等变性,无需额外运动编码器。
训练损失
基于 Flow Matching 的向量场预测:
\mathcal{L}_{\text{FM}}(\theta) = \mathbb{E}_{t, x_t, c}[\|v_\theta(x_t, t, c) - v_t(x_t)\|_2] \tag{4}
其中 是生成条件的联合。
推理引导
\tilde{v}_\theta(x_t, t, z_{\text{image}}, z_{\text{global}}, z_{\text{text}}) = v_{\text{uncond}} + w(v_{\text{cond}} - v_{\text{uncond}}) \tag{5}
引导尺度 。
训练数据
- 数据规模: 200 万高质量 720p 视频
- 来源: Panda70M, Pixabay, Pexels, YouTube
- 两阶段过滤:
- 专家评分模型评估视觉质量
- SigLIP 特征余弦相似度过滤时间一致性
- 轨迹提取: CoTracker 跟踪 32×32 稠密网格点
- 训练采样: 5% 概率无轨迹 (),95% 概率 均匀采样 1-200
MoveBench 基准
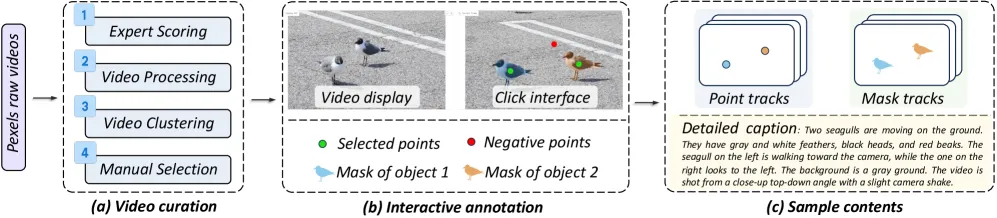
Figure 3: MoveBench 构建流程,获取高质量样本和丰富标注。
| 特性 | MoveBench | MagicBench | DAVIS |
|---|---|---|---|
| 视频数量 | 1018 | 600 | 90 |
| 时长 | 5 秒 | 短 | 短 |
| 内容类别 | 54 | 有限 | 有限 |
| 标注类型 | 点轨迹 + 掩码 | 自动标签 | 稀疏标注 |
| 标注质量 | 人工 + SAM | 自动 | 人工 |
标注流程: 人工点击 → SAM 生成初始掩码 → 负点修正 → 精确标注
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 潜在轨迹引导 | 像素轨迹映射到潜在空间,利用平移等变性 | EPE 2.6 vs 像素复制 3.7 |
| 潜在特征复制 | 复制第一帧特征到轨迹位置,保留丰富上下文 | PSNR 17.8 vs 随机嵌入 16.1 |
| 无额外模块 | 直接编辑条件特征,无需运动编码器 | 推理仅增加 3 秒 (vs ControlNet +225 秒) |
| 可扩展微调 | 基于 Wan-I2V-14B,轻松大规模训练 | 200 万视频训练 |
| MoveBench | 综合基准:1018 视频,54 类,精确标注 | 人工 + SAM 混合标注 |
五、实验结果
测试配置
| 配置 | 值 |
|---|---|
| 基础模型 | Wan-I2V-14B |
| 训练数据 | 200 万视频 |
| 分辨率 | 832×480p |
| 时长 | 5 秒 |
| 引导尺度 | 5.0 |
| 评估指标 | FID↓, FVD↓, PSNR↑, SSIM↑, EPE↓ |
单物体运动控制 (MoveBench)
| 方法 | FID↓ | FVD↓ | PSNR↑ | SSIM↑ | EPE↓ |
|---|---|---|---|---|---|
| ImageConductor | 34.5 | 424.0 | 13.4 | 0.49 | 15.6 |
| LeviTor | 18.1 | 98.8 | 15.6 | 0.54 | 3.4 |
| Tora | 22.5 | 100.4 | 15.7 | 0.55 | 3.3 |
| MagicMotion | 17.5 | 96.7 | 14.9 | 0.56 | 3.2 |
| Wan-Move | 12.2 | 83.5 | 17.8 | 0.64 | 2.6 |
关键发现:
- FID 12.2 vs Tora 22.5 (46% 改善)
- EPE 2.6 vs Tora 3.3 (21% 改善)
- PSNR 17.8 vs 最佳基线 15.7 (13% 改善)
DAVIS 数据集
| 方法 | FID↓ | FVD↓ | PSNR↑ | SSIM↑ | EPE↓ |
|---|---|---|---|---|---|
| ImageConductor | 54.2 | 513.6 | 11.6 | 0.47 | 14.8 |
| LeviTor | 22.0 | 115.4 | 13.3 | 0.51 | 3.7 |
| Tora | 25.9 | 129.2 | 13.7 | 0.49 | 3.5 |
| MagicMotion | 24.2 | 113.4 | 12.8 | 0.53 | 3.5 |
| Wan-Move | 14.7 | 94.3 | 16.5 | 0.61 | 2.5 |
多物体运动控制
| 方法 | FID↓ | FVD↓ | PSNR↑ | SSIM↑ | EPE↓ |
|---|---|---|---|---|---|
| ImageConductor | 77.5 | 764.5 | 13.9 | 0.51 | 9.8 |
| Tora | 53.2 | 350.0 | 14.5 | 0.54 | 3.5 |
| Wan-Move | 28.8 | 226.3 | 16.7 | 0.62 | 2.2 |
人类评估 (2AFC)
| 对比方法 | 运动准确率 | 运动质量 | 视觉质量 |
|---|---|---|---|
| vs LeviTor | 98.2% | 98.0% | 98.8% |
| vs Tora | 96.2% | 93.8% | 98.4% |
| vs MagicMotion | 89.4% | 96.4% | 98.2% |
| vs Kling 1.5 Pro | 47.8% | 53.4% | 50.2% |
关键发现: 与商业模型 Kling 1.5 Pro 竞争性表现,运动质量略优。
消融实验
运动引导策略
| 策略 | FID↓ | FVD↓ | PSNR↑ | SSIM↑ | EPE↓ |
|---|---|---|---|---|---|
| 像素复制 | 17.3 | 91.0 | 15.3 | 0.56 | 3.7 |
| 随机轨迹嵌入 | 15.4 | 89.2 | 16.1 | 0.59 | 2.7 |
| 潜在特征复制 | 12.2 | 83.5 | 17.8 | 0.64 | 2.6 |
关键发现: 潜在特征复制利用第一帧丰富上下文,显著优于其他策略。
条件融合策略
| 策略 | FID↓ | FVD↓ | EPE↓ | 延迟 (秒) |
|---|---|---|---|---|
| ControlNet | 12.4 | 84.6 | 2.5 | 987 (+225) |
| 连接 (Ours) | 12.2 | 83.5 | 2.6 | 765 (+3) |
关键发现: 简单连接性能媲美 ControlNet,但推理仅增加 3 秒 (vs +225 秒)。
训练轨迹数量
| 数量 | FID↓ | FVD↓ | PSNR↑ | SSIM↑ | EPE↓ |
|---|---|---|---|---|---|
| N=10 | 12.8 | 86.6 | 17.6 | 0.62 | 3.3 |
| N=100 | 12.9 | 84.7 | 17.7 | 0.65 | 2.7 |
| N=200 | 12.2 | 83.5 | 17.8 | 0.64 | 2.6 |
| N=500 | 13.3 | 83.9 | 17.6 | 0.63 | 3.0 |
推理轨迹数量
| 数量 | FID↓ | FVD↓ | PSNR↑ | SSIM↑ | EPE↓ |
|---|---|---|---|---|---|
| N=0 (无轨迹) | 12.8 | 87.9 | 17.9 | 0.64 | 12.4 |
| N=1 | 12.2 | 83.5 | 17.8 | 0.64 | 2.6 |
| N=16 | 10.6 | 78.3 | 18.2 | 0.67 | 2.2 |
| N=512 | 7.7 | 51.0 | 20.3 | 0.75 | 1.5 |
| N=1024 | 6.2 | 45.2 | 21.9 | 0.79 | 1.1 |
关键发现: 更多轨迹 → 更好性能。无轨迹时保持 I2V 质量 (EPE 12.4 因无引导)。
骨干和数据规模
| 方法 | 骨干 | 数据规模 | FID↓ | EPE↓ |
|---|---|---|---|---|
| MagicMotion | CogVideoX-5B | 23K | 17.5 | 3.2 |
| Wan-Move-Cog-23K | CogVideoX-5B | 23K | 16.0 | 2.8 |
| Tora | CogVideoX-5B | 630K | 22.5 | 3.3 |
| Wan-Move-Cog-630K | CogVideoX-5B | 630K | 14.1 | 2.8 |
| Wan-Move | Wan2.1-I2V-14B | 2000K | 12.2 | 2.6 |
大运动和分布外场景
| 子集 | 方法 | FID↓ | FVD↓ | EPE↓ |
|---|---|---|---|---|
| Large | Tora | 29.1 | 126.3 | 4.3 |
| MagicMotion | 24.6 | 119.3 | 4.1 | |
| Wan-Move | 14.5 | 86.6 | 3.0 | |
| OOD | Tora | 28.9 | 120.2 | 4.0 |
| MagicMotion | 23.5 | 115.7 | 3.9 | |
| Wan-Move | 13.5 | 86.0 | 2.8 |
关键发现: 挑战性场景下差距进一步扩大,Wan-Move 鲁棒性强。
六、应用示例
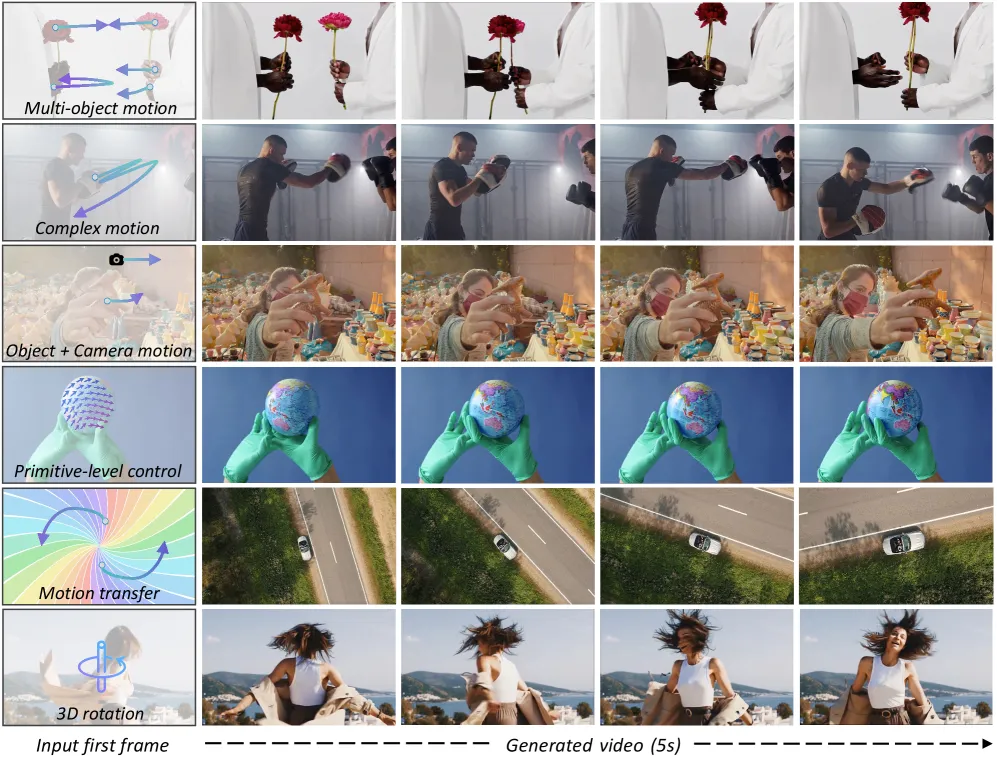
Figure 1: Wan-Move 支持多样化运动控制应用(832×480p, 5 秒):
| 应用 | 说明 |
|---|---|
| 物体控制 | 单/多点轨迹控制物体运动 |
| 相机控制 | 拖拽背景元素或基于相机位姿轨迹 |
| 原语控制 | 旋转虚拟球体生成投影 2D 轨迹 |
| 运动迁移 | 从一个视频提取轨迹应用到另一个图像 |
| 3D 旋转 | 基于深度估计位置,应用旋转后投影到 2D |
七、与现有方法对比
| 方面 | ImageConductor | LeviTor/Tora/MagicMotion | Wan-Move |
|---|---|---|---|
| 运动表示 | 像素级轨迹 | 控制信号 (各异) | 潜在轨迹 |
| 编码方式 | 直接像素注入 | ControlNet/adaLN | 无额外模块 |
| 上下文 | 单像素,无上下文 | 有限 | 第一帧丰富特征 |
| 推理开销 | 低 | +225 秒 (ControlNet) | +3 秒 |
| 可扩展性 | 差 | 中等 | 好 |
| EPE | 15.6 | 3.2-3.4 | 2.6 |
八、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| Motion Prompting | 最相关,使用点轨迹但像素空间随机嵌入 + ControlNet |
| Tora | 轻量 adaLN 集成,EPE 3.3 |
| MagicMotion | 稀疏掩码/边界框引导,ControlNet |
| LeviTor | 控制信号 + ControlNet |
| Kling 1.5 Pro | 商业 Motion Brush,Wan-Move 与之竞争 |
九、总结
核心贡献
- 潜在轨迹引导: 将点轨迹映射到潜在空间,利用平移等变性注入运动信息
- 无额外模块: 直接编辑条件特征,无需运动编码器或 ControlNet
- 可扩展微调: 基于 Wan-I2V-14B,200 万视频训练
- MoveBench: 1018 视频,54 类,人工 + SAM 精确标注
- 商业级质量: 与 Kling 1.5 Pro 竞争性表现
技术影响
- 简单有效: 无需复杂架构修改,仅编辑条件特征
- 可扩展性: 轻松大规模微调,训练数据越多越好
- 运动控制新范式: 潜在空间操作替代像素空间编码
- 开源: 代码、模型、基准全部开源
局限性
- 长时间遮挡可能导致运动控制丢失
- 点轨迹依赖 CoTracker,遮挡时不可靠
- 生成 5 秒视频,更长视频需扩展
- 双用途风险:可控视频生成可能被滥用
十、参考资源
- 论文: arXiv:2512.08765
- 代码: GitHub - ali-vilab/Wan-Move
- 主题: cs.CV
- 页数: 约 20 页, 9 图