HunyuanVideo 1.5 Technical Report
腾讯轻量级开源视频生成模型,仅83亿参数即达SOTA视觉质量,支持SSTA稀疏注意力加速、视频超分到1080p、消费级GPU推理
HunyuanVideo 1.5 Technical Report
一、论文概述 (Overview)
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 标题 | HunyuanVideo 1.5 Technical Report |
| arXiv ID | 2511.18870 |
| 作者 | Bing Wu, Chang Zou, Changlin Li, Duojun Huang, Fang Yang, Weijie Kong, Qi Tian, Songtao Liu, Zuozhuo Dai, Bo Peng 等 |
| 机构 | 腾讯混元基础模型团队 (Tencent Hunyuan Foundation Model Team) |
| 论文 | https://arxiv.org/abs/2511.18870 |
| 代码 | https://github.com/Tencent-Hunyuan/HunyuanVideo-1.5 |
| 发布日期 | 2025-11-25 |
1.2 摘要
本文介绍 HunyuanVideo 1.5——一款轻量级 yet 强大的开源视频生成模型,仅需 83亿参数 即实现了最先进的视觉质量和运动连贯性,可在消费级 GPU 上进行高效推理。这一成就建立在以下几个关键组件之上:细致的数据策展、采用选择性滑动瓦片注意力(SSTA)的先进 DiT 架构、通过字形感知文本编码增强的双语理解能力、渐进式预训练和后训练策略,以及高效的视频超分辨率网络。
1.3 核心贡献
- 轻量级高性能架构: 8.3B 参数 DiT + 3D Causal VAE(空间压缩 16×,时间压缩 4×),性能匹敌闭源 SOTA 模型
- SSTA 稀疏注意力: 动态剪枝冗余时空 token,无需额外训练即可无缝集成,720p 10秒视频推理加速 1.87×
- 视频超分增强: 高效的少步超分辨率网络,将 480p/720p 输出上采样至 1080p
- 双语理解增强: Qwen2.5-VL + Glyph-ByT5 双通道文本编码器,支持中英双语精确理解和文字渲染
- 端到端训练优化: Muon 优化器加速收敛,多阶段渐进式训练策略
- 统一图文生成: 联合训练 T2I、T2V、I2V 三种任务,支持多分辨率(480p-720p)和多时长(2-10秒)
二、核心思想 (Core Ideas)
2.1 问题定义
当前视频生成模型面临的核心矛盾:
- 闭源模型(Kling 2.5、Veo 3.1、Sora 2)性能领先但不可访问
- 开源模型 Wan2.2 采用 MoE 架构(27B 总参/14B 激活),计算效率低;其 5B 轻量版在运动稳定性和美学质量上仍有不足
- 缺乏在高质量输出与高效推理之间取得平衡的开源模型
2.2 解决方案概述
HunyuanVideo 1.5 采用两阶段管线实现高保真视频合成:
- 第一阶段: 统一 DiT 模型(8.3B 参数),支持 T2V 和 I2V 生成,输出 480p-720p、5-10秒视频
- 第二阶段: 专用视频超分辨率网络,将输出上采样至 1080p
三、技术架构 (Technical Architecture)
3.1 整体架构
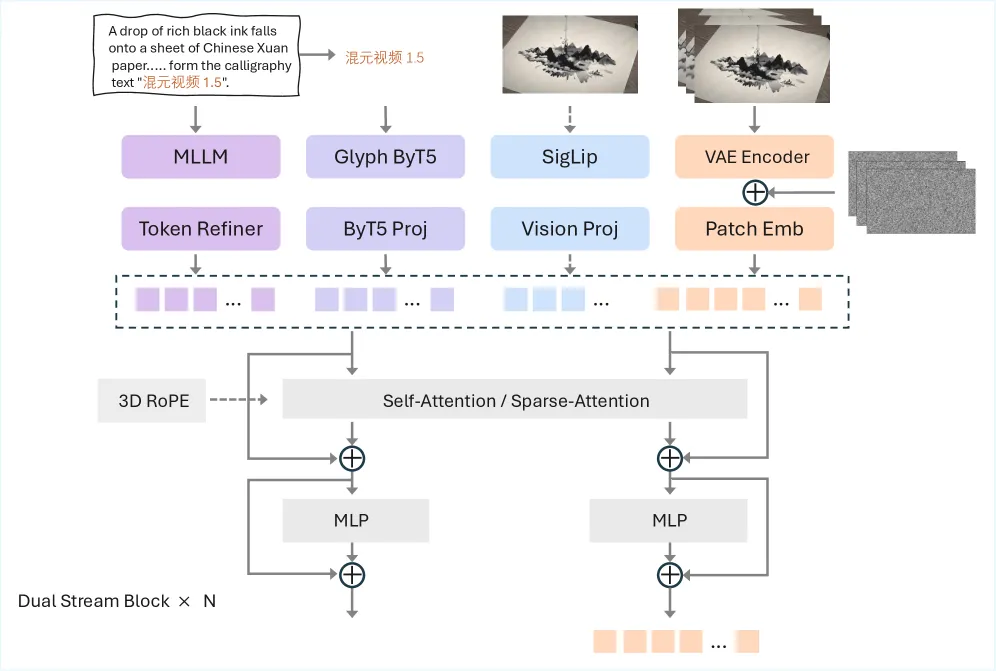
HunyuanVideo 1.5 是一个两阶段级联视频超分辨率模型:
| 组件 | 说明 | 参数 |
|---|---|---|
| Unified DiT | 多任务学习(T2I + T2V + I2V) | 8.3B |
| 3D Causal VAE | 联合图像-视频编码 | 空间 16×,时间 4×,潜在通道 32 |
| Video SR Network | 少步超分辨率网络 | 基于预训练 T2V 初始化 |
模型配置:
| 组件 | 参数 |
|---|---|
| 模型维度 | 2048 |
| FFN 维度 | 8192 |
| 注意力头数 | 16 |
| Head 维度 | 128 |
| Dual-stream Block 数 | 54 |
3.2 双流/单流 DiT 架构
模型支持双流和单流两种模式:
- 双流: 图像/视频 latents 和文本特征分别通过独立的 Transformer block 处理,然后交叉注意力交互
- 单流: 所有 token 拼接在一起统一处理
3.3 核心创新:SSTA 稀疏注意力
问题: 标准自注意力的计算复杂度随序列长度呈二次方增长,对基于 Transformer 的视频生成模型构成显著的效率瓶颈。
SSTA (Selective and Sliding Tile Attention):
- 结合静态局部窗口先验和动态全局自适应选择的优点
- 无参数设计,可在任何训练阶段无缝集成
- 动态剪枝冗余时空 token,显著降低长视频序列的计算开销
- 相比 FlashAttention-3,720p 10秒视频推理加速 1.87×
3.4 文本编码器:双语理解增强
采用双通道文本编码器:
- Qwen2.5-VL: 视觉-语言多模态编码器,深入理解场景描述、角色动作和特定要求
- Glyph-ByT5: 多语言字形编码器,强化模型在各种语言中准确渲染文字的能力
这种协同设计使模型能够从高层语义表示和细粒度语言特定特征中学习,实现更全面、更鲁棒的文本理解能力。
3.5 视频超分辨率网络
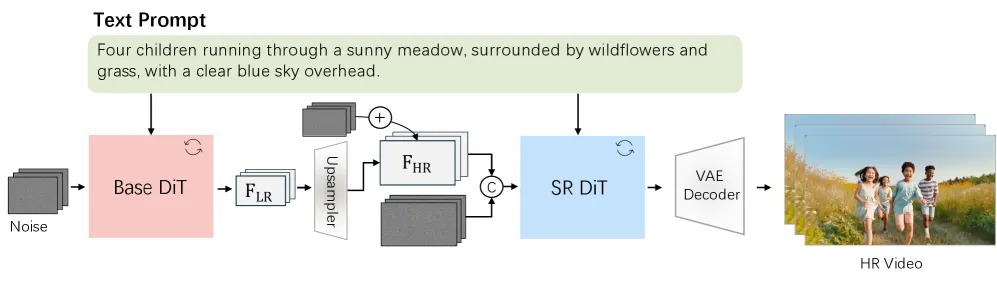
- 以预训练 T2V 模型的权重初始化
- 数据集:100万高质量视频片段(1K-4K 分辨率,3-10秒,24fps)+ 高分辨率图像
- 将 DiT 输出的 480p/720p 视频上采样至 1080p,显著提升最终视觉保真度
四、核心创新 (Key Innovations)
| 创新点 | 说明 | 效果 |
|---|---|---|
| SSTA 稀疏注意力 | 动态剪枝冗余时空 token,无参数设计 | 720p 10秒视频推理加速 1.87× |
| 8.3B 轻量架构 | DiT + 3D Causal VAE(16×4× 压缩) | 消费级 GPU 可运行 |
| 视频超分网络 | 少步上采样至 1080p | 显著提升视觉保真度 |
| 双通道文本编码器 | Qwen2.5-VL + Glyph-ByT5 | 中英双语精确理解 + 文字渲染 |
| Muon 优化器 | 端到端训练优化 | 显著加速收敛 |
| 两阶段级联 | DiT 生成 → SR 超分 | 兼顾效率与质量 |
五、训练流程 (Training Pipeline)
5.1 数据准备
图像数据: 从 100 亿+ 图像中筛选 50 亿用于预训练,10 亿用于后续阶段。
视频数据:
- 原始数据:1000 万小时原始视频
- 三段式过滤管道:
- 基本过滤:去除填充边框、拼接伪影、网格布局、静态/低运动场景
- 视觉质量过滤:锐度、细节保留、噪声&伪影、动态范围
- 美学过滤:基于美学评分算子
- 最终:约 8 亿高质量视频片段
Caption 生成:
- Image Captioner: 基于 HunyuanImage-3.0 方法
- Video Captioner: 基于 HunyuanVideo-Captioner 模型
- 支持中英双语描述
5.2 预训练七阶段
| 阶段 | 类型 | 训练分辨率 | 数据量 | 任务 |
|---|---|---|---|---|
| I | Pretrain | 256p | 50亿图像 | T2I |
| II | Pretrain | 512p | 10亿图像 | T2I |
| III | Pretrain | 256p, 16fps, 2-10s | 8亿 | T2V/I2V/T2I (1:6:3) |
| IV | Pretrain | 480p, 16fps, 2-10s | 2亿 | T2V/I2V/T2I |
| V | Pretrain | 720p, 16fps, 2-10s | 1亿 | T2V/I2V/T2I |
| VI | Pretrain | 720p, 24fps, 2-10s | 1亿 | T2V/I2V/T2I |
| VII | CT | 480p/720p, 24fps, 2-10s | 100万 | T2V |
| VIII | CT | 480p/720p, 24fps, 2-10s | 100万 | I2V |
渐进式策略: 从 256p 16fps 逐步扩展到 720p 24fps,确保稳定收敛。
Flow Matching shift 调度: 针对视频 token 长度变化对 flow matching 训练的敏感性,设计了逐阶段的 shift 调度策略。
5.3 后训练 (Post-training)
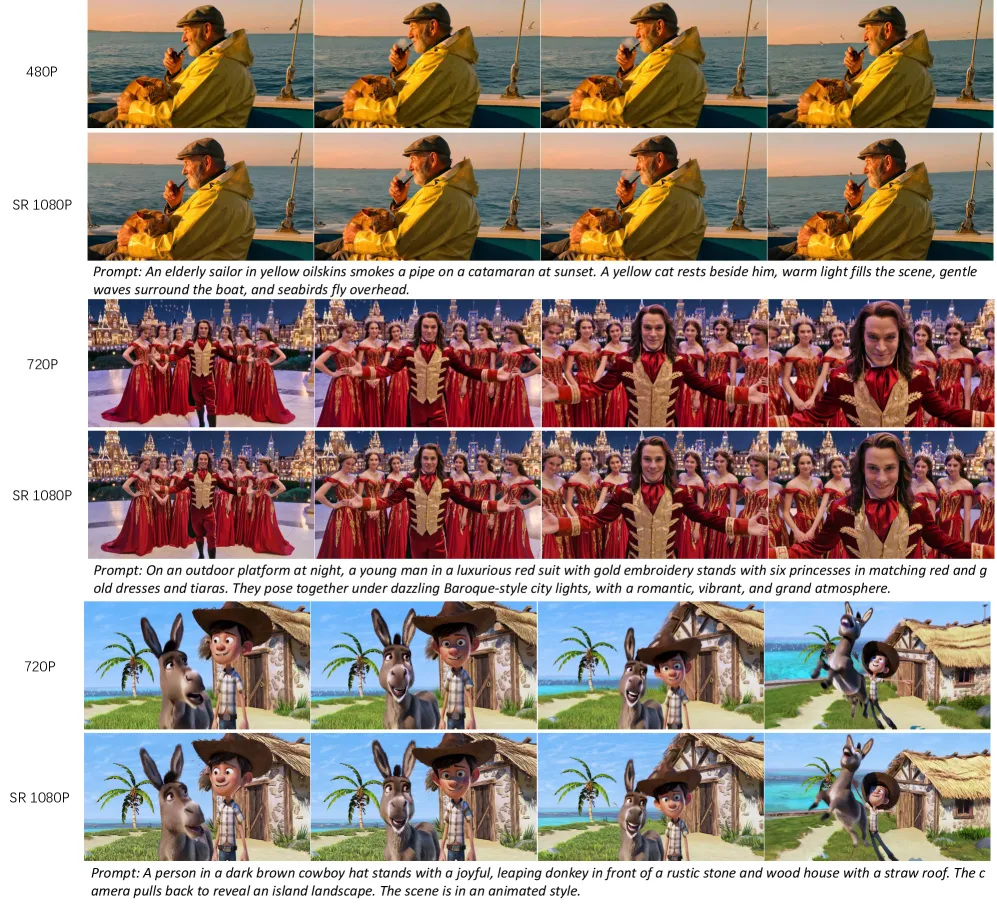
Continued Training (CT):
- T2V: 优先选择高动态运动片段
- I2V: 引入指令式 caption,专注于描述相对于首帧的运动和变换
- 两个任务从同一最优预训练 checkpoint 初始化
Supervised Fine-Tuning (SFT):
- 严格根据美学吸引力、清晰度和运动平滑度筛选片段
RLHF (人类反馈强化学习):
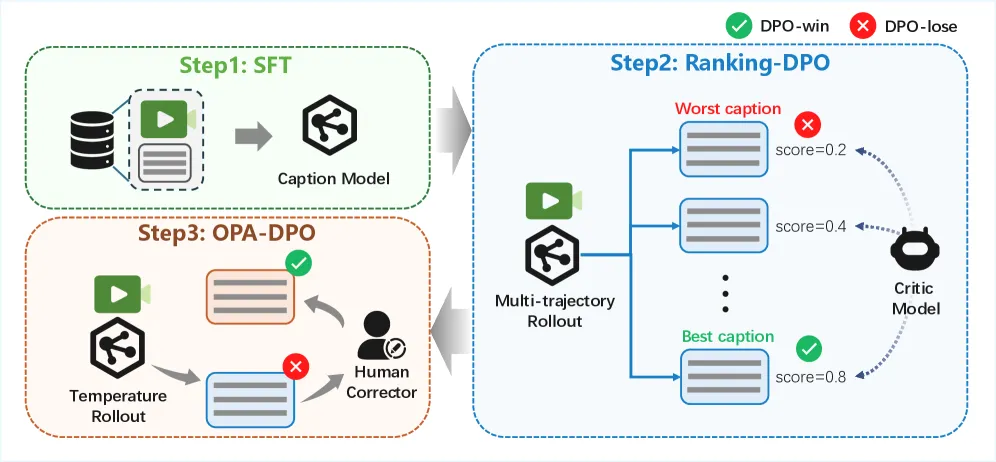
- I2V: 在线 RL + MixGRPO 混合求解器 + VLM 奖励模型(文本对齐、图像对齐、视觉质量、运动动力学四维评估)
- T2V: 离线 DPO(10K 提示集,人工 GSB 标注)→ 在线 RL 优化
六、实验结果 (Experimental Results)
6.1 T2V 模型评分对比
| 维度 | HY1.5 720p | Wan2.2 | Kling 2.1 Master | Seedance Pro | Veo3 |
|---|---|---|---|---|---|
| 指令跟随 | 61.57 | 44.07 | 50.03 | 53.19 | 73.77 |
| 美学质量 | 63.30 | 65.98 | 68.00 | 68.22 | 67.98 |
| 视觉质量 | 57.35 | 56.37 | 59.68 | 60.20 | 58.64 |
| 结构稳定性 | 79.75 | 73.75 | 66.74 | 68.69 | 75.62 |
| 运动效果 | 57.67 | 53.08 | 58.59 | 55.17 | 60.81 |
HY1.5 在指令跟随和结构稳定性上显著领先,运动效果接近 Veo3。
6.2 I2V 模型评分对比
| 维度 | HY1.5 480pSR | HY1.5 720p | Wan2.2 | Kling 2.1 Master | Seedance Pro | Veo3 |
|---|---|---|---|---|---|---|
| 指令跟随 | 63.11 | 63.05 | 56.19 | 68.43 | 62.90 | 67.86 |
| 图像一致性 | 68.82 | 72.07 | 73.53 | 64.09 | 73.06 | 72.19 |
| 视觉质量 | 59.87 | 60.33 | 58.31 | 59.28 | 58.95 | 59.29 |
| 结构稳定性 | 70.13 | 66.67 | 69.03 | 59.71 | 68.01 | 69.25 |
| 运动效果 | 57.60 | 58.62 | 57.41 | 57.36 | 60.47 | 60.91 |
使用超分辨率后(480pSR),HY1.5 在结构稳定性和运动效果上表现最佳。
6.3 GSB 胜率对比(T2V)
| 对比模型 | HY 更好 | 对方更好 | HY 胜率 |
|---|---|---|---|
| Wan2.2 | 34.90% | 17.78% | +17.12% |
| Kling 2.1 Master | 31.55% | 18.95% | +12.6% |
| Seedance Pro | 31.67% | 20.65% | +11.02% |
| Veo3 | 24.64% | 34.96% | -10.32% |
HY1.5 在对抗所有国产开源/闭源模型时胜率均为正,仅对 Veo3 处于劣势。
6.4 推理速度(无工程加速)
| 任务 | 分辨率 | 总帧数 | SSTA | 每步耗时 (s) |
|---|---|---|---|---|
| T2V | 480p | 121 | ✗ | 0.91 |
| T2V | 480p | 241 | ✗ | 1.70 |
| T2V | 720p | 121 | ✗ | 2.01 |
| T2V | 720p | 121 | ✓ | 1.56 |
| T2V | 720p | 241 | ✗ | 5.51 |
| T2V | 720p | 241 | ✓ | 2.95 |
SSTA 对长序列(241帧)加速效果尤为显著,720p 241帧从 5.51s 降至 2.95s。
6.5 推理速度(含工程加速)
| 任务 | 分辨率 | 总帧数 | SSTA | 总耗时 (s) | 每步平均 (s) |
|---|---|---|---|---|---|
| T2V | 480p | 121 | ✗ | 13.90 | 0.28 |
| T2V | 480p | 241 | ✗ | 27.08 | 0.54 |
| T2V | 720p | 121 | ✗ | 30.68 | 0.61 |
| T2V | 720p | 121 | ✓ | 18.83 | 0.38 |
| T2V | 720p | 241 | ✗ | 81.90 | 1.64 |
| T2V | 720p | 241 | ✓ | 45.85 | 0.92 |
工程加速技术:SageAttention、torch.compile 编译、特征缓存机制、CFG蒸馏。
6.6 GPU 显存需求
| 任务 | 分辨率 | 总帧数 | 显存 (GB) |
|---|---|---|---|
| T2V | 480p | 121 | 18.5 |
| T2V | 480p | 241 | 22.1 |
| T2V | 720p | 121 | 24.8 |
| T2V | 720p | 241 | 35.2 |
七、相关工作 (Related Work)
闭源视频生成模型
Kling 2.5、Veo 3.1、Sora 2 代表了当前视频生成的最高水平,但不可公开访问。
开源视频生成模型
- HunyuanVideo (2412.03603): 13B 参数的前代版本
- Wan2.2: MoE 架构(27B/14B),5B 轻量版性能有局限
- StepVideo: 大型视频基础模型
- OpenSora / CogVideoX: 开源视频生成探索
注意力优化
FlashAttention-3、SageAttention 等加速了 Transformer 推理,SSTA 在此基础上进一步针对视频时空冗余进行了优化。
八、总结 (Conclusion)
8.1 核心贡献
- 轻量级 SOTA 开源视频模型: 仅 8.3B 参数即达到开源视频生成新标杆
- SSTA 稀疏注意力: 无参数设计的动态稀疏注意力机制,显著加速长序列推理
- 两阶段级联架构: DiT 生成 + 视频超分,兼顾效率与 1080p 高保真输出
- 双语理解增强: Qwen2.5-VL + Glyph-ByT5 双通道编码器
- 端到端训练优化: Muon 优化器 + 多阶段渐进式训练 + RLHF 人类偏好对齐
8.2 技术影响
- 弥合了开源与闭源视频生成模型之间的性能差距
- 8.3B 参数规模使得消费级 GPU 即可运行,降低了视频生成的门槛
- SSTA 提供了一种通用的注意力优化思路,可集成到任意 DiT 架构
8.3 局限性
- 对抗 Veo3 时 GSB 胜率为负(-10.32%),在美学质量和运动效果上仍有提升空间
- 模型规模虽小于 Wan2.2 MoE,但相比 5B 级别模型仍偏大
- 视频超分网络增加了推理管线复杂度
九、参考资源 (References)
关键参考文献
| 编号 | 论文/模型 | 关键贡献 |
|---|---|---|
| [4] | HunyuanVideo | 13B 参数视频生成基础模型 |
| [6] | Wan2.2 | MoE 架构视频生成模型 |
| [7] | FlashAttention-3 | 快速准确的注意力后端 |
| [8] | Muon Optimizer | 加速收敛的优化器 |
| [13] | Qwen2.5-VL | 视觉-语言多模态编码器 |
| [14] | Glyph-ByT5 | 多语言字形编码器 |
| [19] | MixGRPO | 混合 ODE-SDE 求解器 |
| [20] | DPO | 直接偏好优化 |
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 1 | 模型后训练管线 | figure-1-post-training-pipeline.png |
| Figure 2 | 统一 DiT 架构 | figure-2-dit-architecture.png |
| Figure 3 | 级联视频超分辨率管线 | figure-3-video-super-resolution.png |
| Figure 4 | 后训练各阶段可视化 | figure-4-post-training-visualization.png + figure-4-ct-sft-rlhf.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer