OmniSparse: Training-Aware Fine-Grained Sparse Attention for Long-Video MLLMs
OmniSparse提出训练感知的细粒度稀疏注意力机制,优化长视频多模态大语言模型的推理效率。
OmniSparse: 长视频多模态大语言模型的训练感知细粒度稀疏注意力
一、论文概述
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 标题 | OmniSparse: Training-Aware Fine-Grained Sparse Attention for Long-Video MLLMs |
| 作者 | Feng Chen, Yefei He, Shaoxuan He, Yuanyu He, Jing Liu, Lequan Lin, Akide Liu, Zhaoyang Li, Jiyuan Zhang, Zhenbang Sun, Bohan Zhuang, Qi Wu |
| 机构 | (多机构合作) |
| 提交日期 | 2025年11月15日 |
| arXiv ID | 2511.12201 |
| 领域 | 多模态大语言模型、高效注意力机制、长视频理解 |
1.2 摘要
现有稀疏注意力方法主要针对推理时加速,通过在预定义稀疏模式下选择关键 token 来实现。然而,这些方法往往无法弥合训练与推理之间的差距,并且缺乏在查询(queries)、键值对(KVs)和注意力头(heads)等多个维度上进行细粒度 token 选择的能力,导致性能次优且加速收益有限。
本文提出了 OmniSparse——一种面向长视频多模态大语言模型(MLLMs)的训练感知细粒度稀疏注意力框架,在训练和推理阶段均采用动态 token 预算分配策略。OmniSparse 包含三个自适应且互补的机制:
- 查询选择(Query Selection):通过惰性-活跃分类(lazy-active classification)保留捕获广泛语义相似性的活跃查询,丢弃大部分仅关注有限局部上下文且功能冗余度高的惰性查询
- 键值选择(KV Selection):采用头级动态预算分配,基于最平坦的注意力头确定共享预算,确保注意力召回率
- KV 缓存瘦身(KV Cache Slimming):根据头级解码查询模式选择性获取视觉 KV 缓存,减少头级冗余
实验结果表明,OmniSparse 在匹配全注意力性能的同时,实现了 prefill 阶段 2.7 倍加速和解码阶段 2.4 倍内存减少。
二、核心思想
2.1 问题动机
长视频多模态大语言模型面临的核心挑战是注意力机制的二次方计算复杂度。现有方法存在两个关键问题:
- 训练-推理差距(Training-Inference Gap):现有方法仅在推理时使用稀疏注意力,而训练时使用全注意力,这种不一致导致注意力模式的差异,最终降低泛化能力和性能
- 粗粒度 token 选择:现有方法通常仅关注查询、键值对、注意力头中的一个或两个维度,限制了计算节省和模型效率的潜力
2.2 核心观察
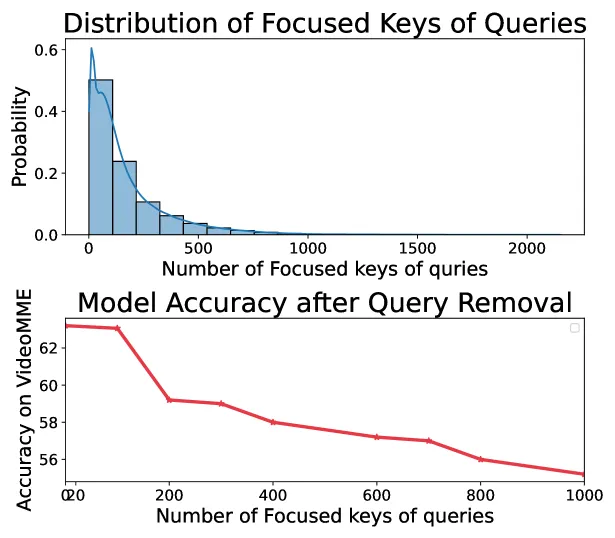
论文基于三个关键观察提出解决方案:
| 观察 | 内容 | 启示 |
|---|---|---|
| 查询稀疏性 | 大多数查询仅关注不到 100 个 token(约 2,600 中的 3%) | 可安全移除”惰性”查询 |
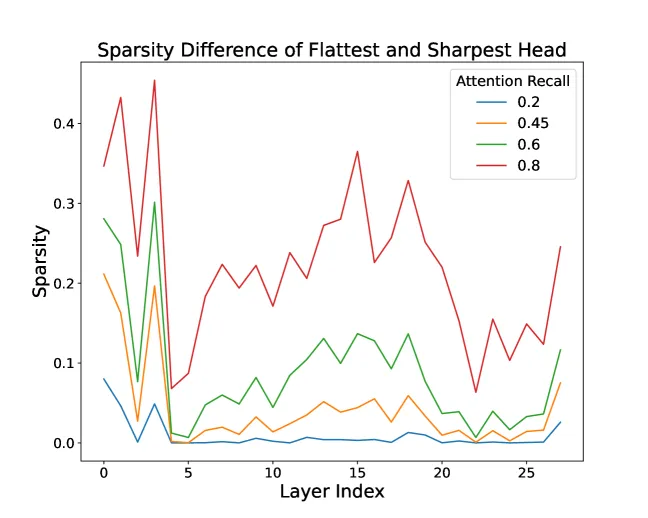
| 头间异质性 | 不同注意力头的稀疏度差异显著 | 需要头级动态预算分配 |
| 头间 token 关注差异 | 不同头关注不同的 KV 对 | 需要头级 KV 选择 |
2.3 设计理念
OmniSparse 的核心设计理念是训练-推理一致性:在训练和推理阶段均应用相同的稀疏注意力机制,避免模式不匹配。通过 Top-p 逐 token 稀疏化策略,在查询、键值对和注意力头三个维度上实现细粒度稀疏。
三、技术架构
3.1 整体架构
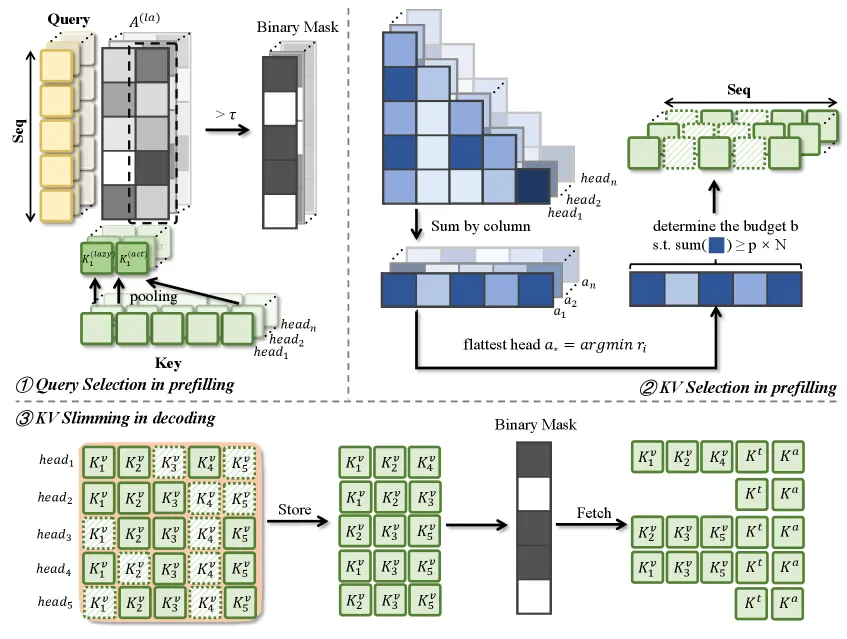
OmniSparse 由三个组件构成:
输入序列 X = [X_v, X_t]
    ├── X_v: 视觉 tokens (N_v × d)
    └── X_t: 语言 tokens (N_t × d)

┌─────────────────────────────────────────────────┐
│                  OmniSparse 框架                   │
│                                                   │
│  ┌─────────────┐  ┌─────────────┐  ┌───────────┐ │
│  │  查询选择    │  │  KV 选择    │  │ KV 缓存   │ │
│  │ (Prefill)   │  │  (Prefill)  │  │ 瘦身      │ │
│  │             │  │             │  │ (Decoding) │ │
│  └──────┬──────┘  └──────┬──────┘  └─────┬─────┘ │
│         │                │               │       │
│         ▼                ▼               ▼       │
│  惰性-活跃分类    头级动态预算      选择性获取    │
│  移除冗余查询    确定 KV 预算      视觉 KV 缓存  │
└─────────────────────────────────────────────────┘
3.2 查询选择:惰性-活跃二分类
核心思想:将查询模式建模为惰性-活跃二分类问题。
具体方法:
- 对于每个注意力头 ,将注意力汇聚点(attention sink,第一个 token)对应的键 作为惰性参考
- 通过对所有视觉键进行平均池化,得到活跃参考键
- 构建紧凑的探测键矩阵,计算二分类 logits:
- 如果查询对活跃类别的注意力分数超过阈值 ,则被分类为活跃查询
- 保留第一个注意力头的所有查询作为活跃查询,以维持信息完整性
活跃查询掩码:
3.3 KV 选择:头级动态预算分配
核心思想:基于最平坦注意力头确定统一 token 预算,确保所有头的注意力召回率。
具体方法:
-
计算累积注意力分数:对每个头 ,计算每个键 的累积注意力分数
-
识别最平坦头:通过计算 的峰度(kurtosis) 评估注意力稀疏度, 最小的头即为最平坦头
-
确定共享预算 :
其中 是查询数量, 是控制保留注意力比例的阈值。
- 构建键掩码:
由于键和值对天然耦合,设置 。
设计优势:
- 在预定义全局 Top-k 策略(高效但固定)和逐头动态分配(自适应但计算慢)之间取得平衡
- 通过峰度识别最平坦头,避免逐头计算预算的开销
- 支持 GPU 批处理的高效实现
3.4 KV 缓存瘦身:头级冗余消除
核心思想:在解码阶段,根据查询分类选择性获取视觉 KV 缓存。
具体方法:
- 使用方程 (3) 探测解码查询模式,识别惰性解码查询
- 构建解码查询掩码
- 仅对活跃查询对应的头获取视觉 KV 缓存,跳过惰性查询对应的头
解码注意力计算:
注意:惰性解码查询对应的头不会被完全剪枝,因为它们仍然会关注文本 token 和已解码答案的 KV 缓存。
3.5 块状探测与稀疏 Flash Attention 内核
- 采用块状探测策略(block size = 256),通过在序列维度上对查询和键进行池化来近似全注意力
- 使用定制的块状稀疏 Flash-Attention 内核进行高效注意力处理
- 为避免为选中的查询定制探测注意力掩码的开销,对所有查询应用池化
四、核心创新
4.1 创新点总结
| 创新点 | 描述 | 优势 |
|---|---|---|
| 训练感知稀疏注意力 | 训练和推理阶段均应用相同稀疏注意力 | 消除训练-推理差距 |
| 惰性-活跃查询分类 | 基于注意力汇聚点和视觉键池化的二分类 | 移除冗余查询,减少计算 |
| 头级动态预算分配 | 基于最平坦头的峰度确定统一预算 | 平衡效率与注意力召回率 |
| KV 缓存瘦身 | 根据解码查询模式选择性获取 KV 缓存 | 减少解码阶段内存访问 |
| 多维度稀疏化 | 同时在查询、KV、头三个维度进行稀疏化 | 细粒度 token 选择 |
4.2 与现有方法的对比
| 方法 | 训练感知 | 查询选择 | KV 选择 | 头级适配 | 解码优化 |
|---|---|---|---|---|---|
| FastV | 否 | 否 | Top-k | 否 | 否 |
| MInference | 否 | 否 | 模式搜索 | 是 | 否 |
| ZipVL | 否 | 否 | Top-p | 否 | 是 |
| MOBA | 是 | 否 | 块级 | 否 | 否 |
| OmniSparse | 是 | 是 | 头级动态 | 是 | 是 |
4.3 关键技术细节
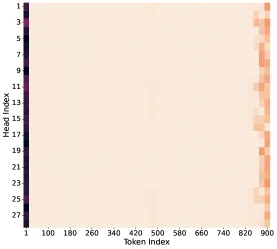
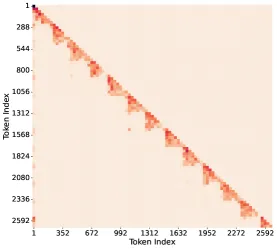
查询冗余性分析(如图 3 所示):
- 不同注意力头的查询关注相似的 token
- 空间相邻位置的查询功能重叠
- 时间相邻位置的查询功能重叠
- 这种冗余性使得查询选择成为可能
最平坦头策略的优势:
- 最平坦头需要最大的 token 预算以保持注意力召回率
- 使用该预算作为统一基准,确保所有头的召回率不低于阈值
- 过度选择(over-selection)在可接受范围内
五、实验结果
5.1 实验设置
| 配置项 | 详情 |
|---|---|
| 基础模型 | LLaVA-Video (Qwen2.5-7b-Instruct 作为 LLM 骨干) |
| 视觉编码器 | SigLip-400M |
| 适配器 | 2 层 MLP,每帧编码为 256 个 token |
| 训练数据 | Long-VITA 训练数据 |
| 上下文长度 | 256k 和 1M tokens |
| 训练硬件 | 256 块 H100 GPU |
| 超参数 | τ=0.08, p=0.82(训练和推理) |
5.2 训练感知稀疏注意力对比(Table 1)
| 模型 | 推理方法 | Atten FLOPs 减少 | KV Cache 减少 | ActNet-QA | VideoDC | Next-QA | VideoMME |
|---|---|---|---|---|---|---|---|
| baseline-256k | Full | 0% | 0% | 57.4 | 3.72 | 79.0 | 63.6 |
| baseline-256k | FastV | 71.7% | 46.4% | 55.8 | 3.68 | 78.4 | 63.3 |
| baseline-256k | MInference | 35.3% | 0% | 56.3 | 3.70 | 78.3 | 63.5 |
| baseline-256k | ZipVL | 63.5% | 40.2% | 56.9 | 3.69 | 78.3 | 63.5 |
| baseline-256k | OmniSparse | 72.6% | 53.4% | 57.4 | 3.71 | 79.1 | 63.5 |
| MOBA-256k | MOBA | 84% | 0% | 55.4 | 3.62 | 78.8 | 63.4 |
| OmniSparse-256k | OmniSparse | 85.7% | 66.8% | 57.6 | 3.72 | 78.9 | 63.9 |
| OmniSparse-1M | OmniSparse | 86.1% | 67.1% | 58.2 | 3.74 | 79.5 | 64.0 |
关键发现:
- OmniSparse 在匹配全注意力性能的同时,实现了 85.7% 的 FLOPs 减少和 66.8% 的 KV 缓存减少
- 相比 MOBA,OmniSparse 在 ActivityNet-QA 上提升 2.2%
- 训练感知一致性带来额外 13.1% 的 FLOPs 减少和 13.4% 的内存减少
5.3 训练无关稀疏注意力对比(Table 2)
| 模型 | 方法 | Atten FLOPs 减少 | KV Cache 减少 | ActNet-QA | VideoDC | Next-QA | VideoMME | 平均 |
|---|---|---|---|---|---|---|---|---|
| LongVA-7b | Full | 0% | 0% | 50.5 | 3.14 | 67.5 | 52.9 | 50.6 |
| LongVA-7b | FastV | 71.7% | 46.4% | 49.7 | 3.06 | 66.9 | 52.0 | 49.8 |
| LongVA-7b | OmniSparse | 82.2% | 64.9% | 50.4 | 3.13 | 68.1 | 52.9 | 50.7 |
| LLaVA-Video-7b | Full | 0% | 0% | 59.6 | 3.66 | 81.2 | 64.7 | 60.5 |
| LLaVA-Video-7b | FastV | 71.7% | 46.4% | 59.2 | 3.60 | 80.2 | 64.1 | 59.9 |
| LLaVA-Video-7b | OmniSparse | 75.9% | 63.7% | 60.4 | 3.65 | 81.3 | 64.7 | 60.8 |
| LongVILA-7b | Full | 0% | 0% | 59.5 | 2.76 | 80.7 | 60.1 | 56.9 |
| LongVILA-7b | FastV | 71.7% | 46.4% | 59.1 | 2.72 | 80.1 | 57.8 | 56.1 |
| LongVILA-7b | OmniSparse | 82.3% | 68.4% | 59.6 | 2.78 | 80.7 | 60.0 | 57.0 |
5.4 解码速度对比(Table 3)
| 方法 | TTFT (秒) | 吞吐量 (tokens/s) |
|---|---|---|
| FastV | 13.6 | 8.5 |
| MInference | 12.9 | 4.3 |
| ZipVL | 13.3 | 8.4 |
| VisionZip | 11.6 | 9.7 |
| OmniSparse | 10.1 | 11.1 |
上下文长度 64k,批大小 1,Nvidia H100 GPU。
5.5 不同输入长度的延迟和吞吐量(Table 4)
| 输入长度 | 方法 | TTFT (秒) | 吞吐量 (tokens/s) |
|---|---|---|---|
| 16k | FlashAttention | 3.52 | 15.50 |
| 16k | OmniSparse | 3.02 | 40.61 |
| 32k | FlashAttention | 6.40 | OOM |
| 32k | OmniSparse | 5.37 | 16.32 |
| 64k | FlashAttention | 15.45 | OOM |
| 64k | OmniSparse | 10.06 | 11.10 |
| 128k | FlashAttention | 44.82 | OOM |
| 128k | OmniSparse | 20.05 | OOM |
关键发现:
- OmniSparse 实现 2.7 倍 prefill 加速
- 实现 2.4 倍解码内存减少
- 在 64k 长度下 FlashAttention OOM,而 OmniSparse 仍可运行
5.6 消融实验(Table 5)
稀疏注意力消融:
| 稀疏注意力 | 查询选择 | KV 选择 | Token 比例 | Attn FLOPs 减少 | VideoMME |
|---|---|---|---|---|---|
| 100% | - | - | 100% | 0% | 64.7 |
| ✓ | ✓ | - | 72.8% | 54.4% | 64.7 |
| ✓ | - | ✓ | 74.2% | 51.5% | 64.7 |
| ✓ | ✓ | ✓ | 47.1% | 77.9% | 64.7 |
KV 缓存压缩消融:
| KV 缓存压缩 | KV 选择 | KV 剪枝 | KV 重组 | KV Cache 减少 | VideoMME |
|---|---|---|---|---|---|
| - | - | - | - | 0% | 64.7 |
| ✓ | ✓ | - | - | 15.5% | 64.7 |
| ✓ | - | ✓ | - | 29.7% | 64.7 |
| ✓ | - | - | ✓ | 51.5% | 64.7 |
| ✓ | ✓ | ✓ | ✓ | 64.1% | 64.7 |
关键发现:
- 查询选择和 KV 选择具有互补性,组合使用可实现 77.9% 的 FLOPs 减少
- KV 缓存压缩技术组合可实现 64.1% 的内存减少
- 保留第一个注意力头可避免过度剪枝,仅损失 3% 的额外 FLOPs 减少但带来 0.4% 的准确率提升
- 过度选择冗余随注意力召回率增加而增加,p=0.82 是性能与效率的平衡点
六、相关工作
6.1 训练无关稀疏注意力
| 方法 | 核心思想 | 局限性 |
|---|---|---|
| FastV | 第 2 层后选择关键 token,减少 1/4 QKV 计算 | 训练-推理差距 |
| FlexPrefill | 动态搜索每个头的预定义模式 | 训练-推理差距 |
| MInference | 模态感知动态稀疏注意力,加速 prefill | 训练-推理差距 |
| VisionZip | 选择关键视觉 token,合并上下文 token | 训练-推理差距 |
| AIM | 基于嵌入相似度逐步剪枝和合并冗余 token | 训练-推理差距 |
6.2 长视频多模态大语言模型
| 方法类别 | 代表方法 | 核心思路 |
|---|---|---|
| 上下文压缩 | LongVLM, MaxInfo | 分层合并/选择关键帧 |
| 扩展上下文长度 | LongVA, LongVITA, LongVILA | 利用/训练长上下文能力 |
6.3 训练感知稀疏注意力
| 方法 | 核心思想 | 与 OmniSparse 的区别 |
|---|---|---|
| MOBA | 块级注意力选择 | 无查询选择,无头级适配,无解码优化 |
| SeerAttention | 学习内在稀疏注意力 | 未针对多模态/长视频优化 |
| Native Sparse Attention | 硬件对齐的可训练稀疏注意力 | 未涉及多维度稀疏化 |
七、总结
7.1 主要贡献
- 提出 OmniSparse:一种训练感知的细粒度稀疏注意力框架,在查询、键值对和注意力头三个维度上减少冗余计算
- 多维度稀疏化:动态适应头级多样性以实现高效 prefill,通过跳过惰性解码查询的视觉 KV 获取进一步减少解码阶段内存开销
- 显著性能提升:在匹配全注意力性能的同时,实现 2.7 倍 prefill 加速和 2.4 倍解码内存减少
7.2 局限性与未来工作
- 阈值敏感性:惰性-活跃查询分类的阈值可能因层而异,影响计算效率和模型性能的平衡
- 未来方向:进一步研究注意力层在视频感知和理解中的作用
7.3 技术亮点
| 特性 | 描述 |
|---|---|
| 训练-推理一致性 | 训练和推理阶段应用相同稀疏注意力 |
| 多维度稀疏化 | 查询、KV、头三个维度的细粒度选择 |
| 动态预算分配 | 基于峰度的头级自适应预算 |
| 双阶段优化 | Prefill 加速 + 解码内存优化 |
| 高效实现 | 块状探测 + 定制稀疏 Flash-Attention 内核 |
八、参考资源
8.1 论文链接
| 资源 | 链接 |
|---|---|
| arXiv 论文 | https://arxiv.org/abs/2511.12201 |
| PDF 下载 | https://arxiv.org/pdf/2511.12201 |
| HTML 版本 | https://arxiv.org/html/2511.12201v1 |
8.2 关键数据集
| 数据集 | 用途 | 链接 |
|---|---|---|
| ActivityNet-QA | 视频问答 | https://arxiv.org/abs/1906.06147 |
| VideoMME | 多模态视频评估 | https://arxiv.org/abs/2405.21075 |
| NExT-QA | 时序问答 | https://arxiv.org/abs/2105.08276 |
| VideoDC | 视频详细描述 | https://huggingface.co/datasets/lmms-lab/VideoDetailCaption |
| EgoSchema | 长视频理解 | https://arxiv.org/abs/2308.09126 |
| LongVideoBench | 长上下文视频理解 | https://arxiv.org/abs/2407.15754 |
8.3 相关模型和工具
| 模型/工具 | 描述 | 链接 |
|---|---|---|
| LLaVA-Video | 视频指令调优模型 | https://arxiv.org/abs/2410.02713 |
| LongVA | 长上下文视觉语言模型 | https://arxiv.org/abs/2406.16852 |
| LongVILA | 长上下文视觉语言模型 | https://arxiv.org/abs/2408.10188 |
| Qwen2.5-7b-Instruct | LLM 骨干 | https://arxiv.org/abs/2412.15115 |
| SigLip-400M | 视觉编码器 | https://arxiv.org/abs/2303.15343 |
| FlashAttention-2 | 高效注意力实现 | https://arxiv.org/abs/2307.08691 |
8.4 关键参考文献
- Vaswani et al. (2017). “Attention is All You Need.” NeurIPS.
- Chen et al. (2024a). “An Image is Worth 1/2 Tokens After Layer 2.” ECCV.
- Li et al. (2025b). “MMInference: Accelerating Pre-filling for Long-Context VLMs.”
- He et al. (2024). “ZipVL: Efficient Large Vision-Language Models with Dynamic Token Sparsification.”
- Lu et al. (2025). “MoBA: Mixture of Block Attention for Long-Context LLMs.”
- Gao et al. (2024). “SeerAttention: Learning Intrinsic Sparse Attention in Your LLMs.”
- Yuan et al. (2025). “Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention.”
- Lin et al. (2025). “Twilight: Adaptive Attention Sparsity with Hierarchical Top-p Pruning.”
- Xiao et al. (2023). “Efficient Streaming Language Models with Attention Sinks.”
- Dao (2024). “FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning.” ICLR.
分析日期:2025-05-30 论文版本:v2 (2025-11-18)