StreamDiffusionV2: A Streaming System for Dynamic and Interactive Video Generation
实时直播视频生成的流式系统
StreamDiffusionV2: A Streaming System for Dynamic and Interactive Video Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | StreamDiffusionV2: A Streaming System for Dynamic and Interactive Video Generation |
| 作者 | Tianrui Feng, Zhi Li, Shuo Yang, Haocheng Xi, Muyang Li, Xiuyu Li, Lvmin Zhang, Keting Yang, Kelly Peng, Song Han, Maneesh Agrawala, Kurt Keutzer, Akio Kodaira, Chenfeng Xu |
| 论文 | arXiv:2511.07399 |
| 代码 | 未公开 |
| 发布 | 2025年11月10日(v2: 2026年2月22日) |
二、核心思想
问题定义
生成式模型正在重塑直播行业,但将视频扩散模型应用于实时直播面临四大挑战:
挑战 1:固定输入无法满足实时 SLO
- 直播要求首帧延迟最小化,每帧必须在截止时间内交付
- 固定批量大小无法适应动态的实时约束
挑战 2:长时生成的漂移累积
- 逐帧生成会导致误差累积,长时间后质量退化
- 需要周期性重置机制来维持一致性
挑战 3:运动无关导致质量退化
- 固定的噪声调度忽略了视频中的运动信息
- 快速运动区域需要更多去噪步骤,慢速区域则不需要
挑战 4:逐帧延迟约束下的 GPU 扩展性差
- 现有并行策略(序列并行)在逐帧延迟约束下扩展性差
- 通信开销成为瓶颈
解决方案概述
本文提出 StreamDiffusionV2,一个训练无关的实时直播视频生成系统:
- SLO 感知批调度器:动态调整流批量大小,满足逐帧截止时间
- Sink Token 引导的滚动 KV 缓存:周期性重置时间锚点,抑制长时漂移
- 运动感知噪声控制器:根据运动幅度自适应调整去噪轨迹
- 可扩展流水线编排:跨去噪步骤和网络层并行化,实现近线性 FPS 扩展
关键创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| SLO 感知批调度 | 动态调整流批量大小 | 满足逐帧截止时间,最大化 GPU 利用率 |
| Sink Token + 滚动 KV 缓存 | 周期性重置时间锚点 | 抑制长时漂移,维持视觉一致性 |
| 运动感知噪声调度 | L2 运动估计 → 自适应噪声率 | 快速运动区域更多去噪,慢速区域更少 |
| 流水线编排 | 跨去噪步骤和网络层并行化 | 近线性 FPS 扩展,低通信开销 |
| Stream Batch | 流式批处理技术 | 提升流水线效率 |
| DiT 块调度器 | 动态负载均衡 | 异构 GPU 环境下的高效调度 |
三、技术架构
整体框架图
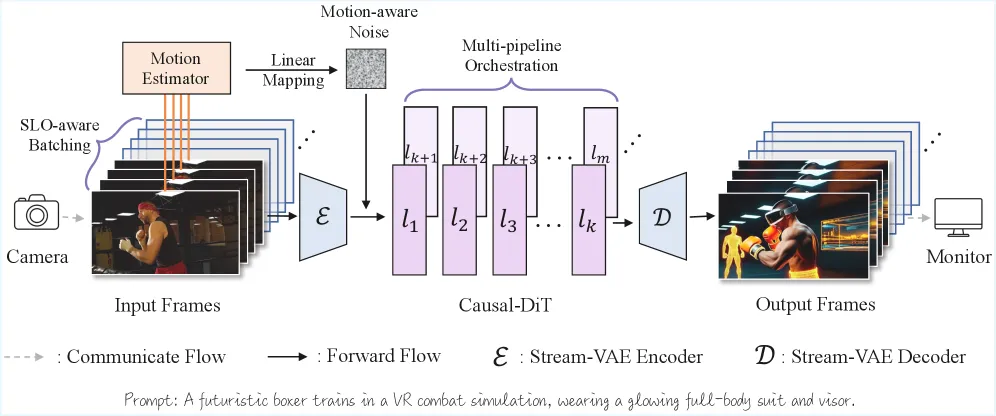
核心组件
SLO 感知批调度器
动态调整流批量大小以满足逐帧截止时间:
- 输入:目标 FPS、当前延迟、GPU 利用率
- 输出:最优流批量大小
- 约束:首帧延迟 < 0.5s,每帧延迟 < 1/FPS
Sink Token 引导的滚动 KV 缓存
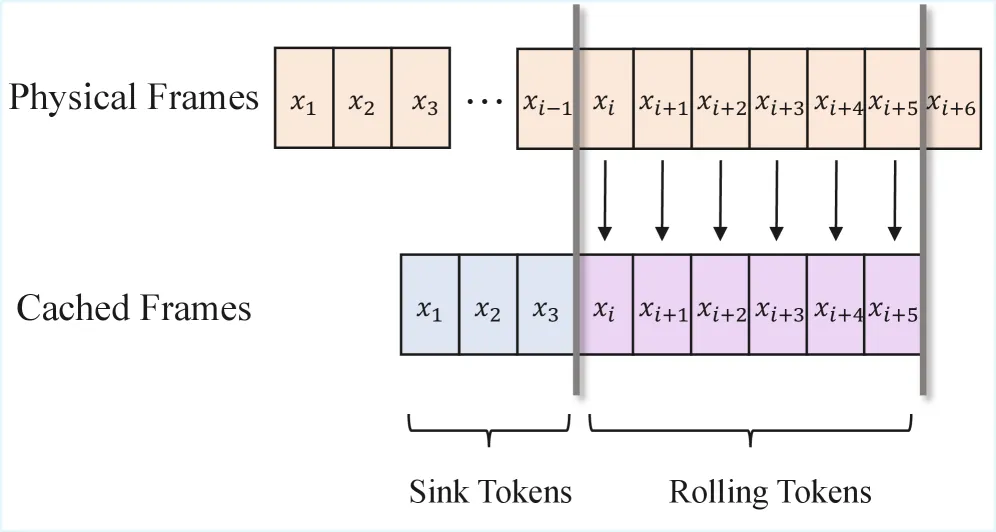
- Sink Token:初始帧的 KV 状态作为全局锚点
- 滚动 KV 缓存:固定大小的滑动窗口,周期性更新
- RoPE 刷新:周期性重置位置编码偏移
运动感知噪声控制器
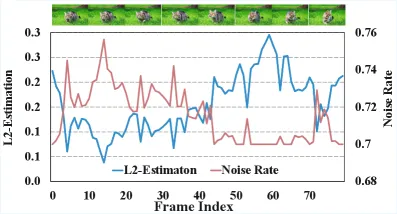
- L2 运动估计:计算相邻帧的运动幅度
- 自适应噪声率:快速运动 → 更高噪声率 → 更多去噪步骤
- 慢速运动 → 更低噪声率 → 更少去噪步骤
流水线编排架构
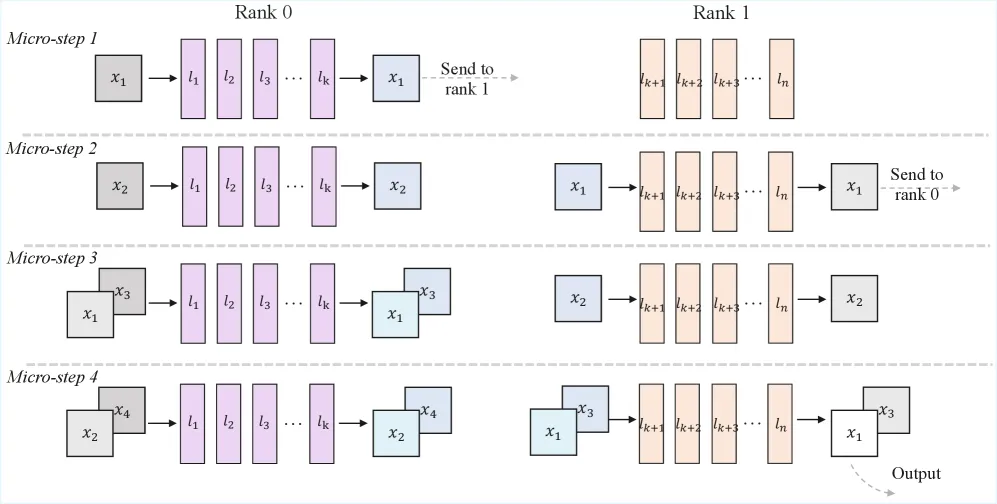
- DiT 块分布在多个设备上进行流水线并行
- 计算和通信分离到两个并发流
- 内核与 P2P 传输重叠,最小化流水线气泡
硬件趋势分析
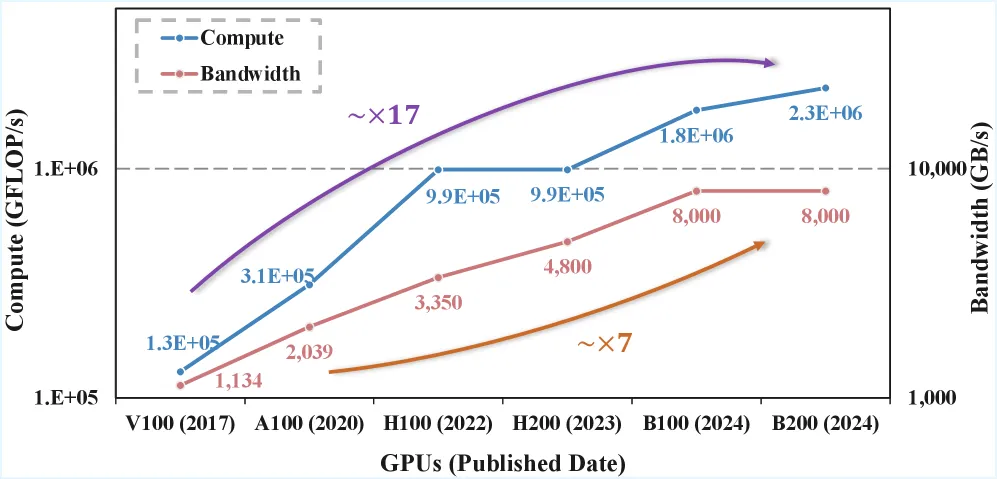
关键洞察:
- 从 V100 到 GB100,峰值计算增长 83×,但 HBM 带宽仅增长 7×
- 流式推理工作负载越来越受内存带宽限制
- 流水线编排比序列并行更适合内存受限场景
四、核心能力
实时直播视频生成
| 配置 | 首帧延迟 (TTFF) | FPS | 模型大小 |
|---|---|---|---|
| 1.3B, 4×H100 | <0.5s | 64.52 | 1.3B |
| 14B, 4×H100 | <0.5s | 58.28 | 14B |
- 无需 TensorRT 或量化
- 支持异构 GPU 环境(H100 NVLink + 4090 PCIe)
- 灵活去噪步数(1-4 步)
支持的应用场景
- 实时 AI 直播:风格化视频流实时生成
- 交互式视频创作:用户实时控制视频内容
- 企业级直播平台:大规模多 GPU 部署
五、实验结果
延迟和抖动对比(H100 工作站)
| 方法 | 指标 | Mean | P50 | P90 | P95 | P99 | Miss Rate (1s) |
|---|---|---|---|---|---|---|---|
| StreamDiffusionV2 | Tail Latency | 357ms | 361ms | 484ms | 497ms | 585ms | 0.2% |
| StreamDiffusionV2 | Jitter | 21ms | 13ms | 45ms | 61ms | 132ms | – |
| CausVid | Tail Latency | 1760ms | 1672ms | 2958ms | 3304ms | 3896ms | 99.9% |
| CausVid | Jitter | 235ms | 164ms | 498ms | 599ms | 1310ms | – |
关键发现:
- 尾延迟:357ms vs 1760ms(降低 80%)
- 抖动:21ms vs 235ms(降低 91%)
- SLO Miss Rate:0.2% vs 99.9%
端到端延迟分布
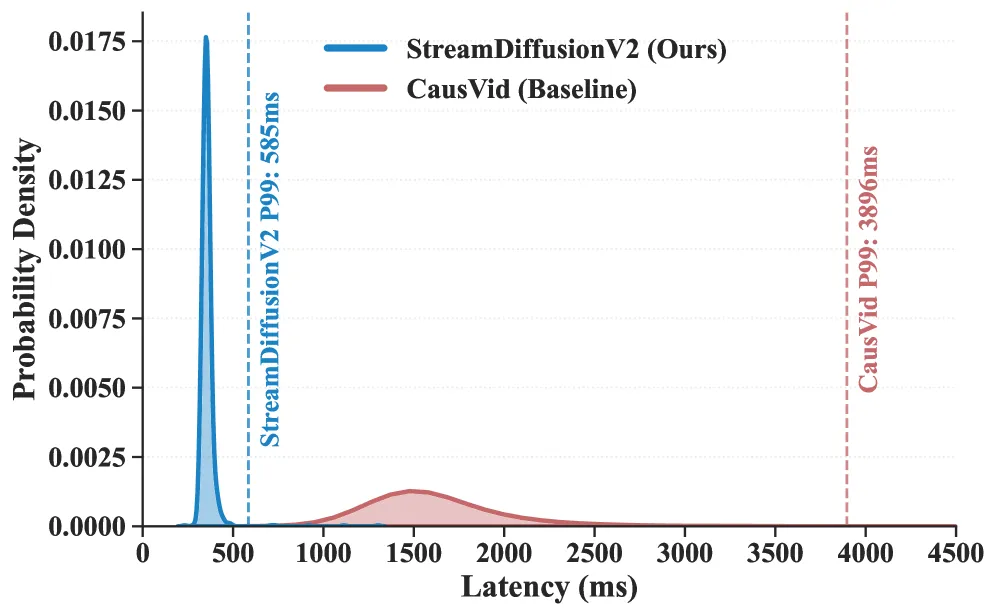
StreamDiffusionV2 的延迟分布高度集中,而 CausVid 分布分散且延迟高。
首帧延迟 (TTFF)
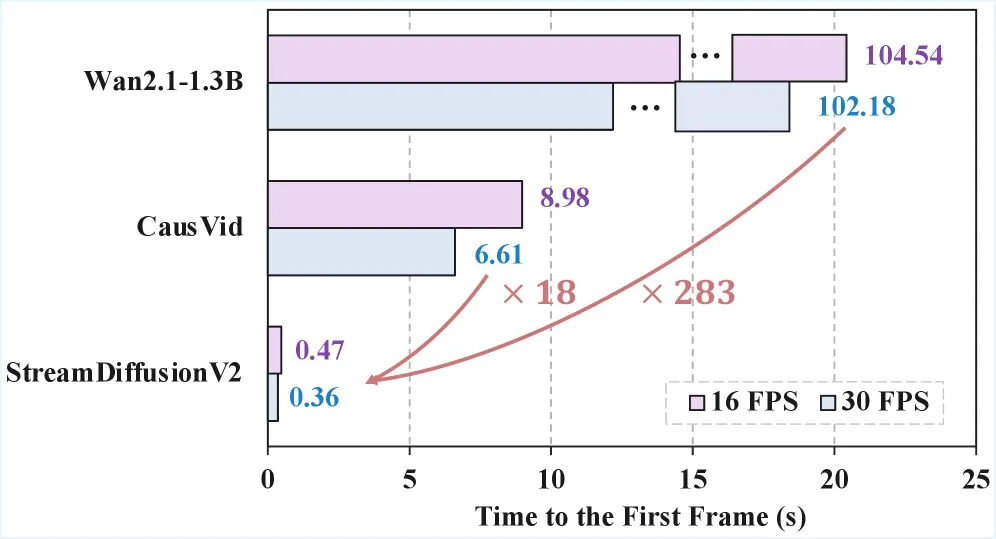
- StreamDiffusionV2 (2-step): ~0.35s
- CausVid (2-step): ~0.8s
- Wan2.1 (50-step): ~25s
- Self-Forcing (4-step): ~1.2s
吞吐量结果
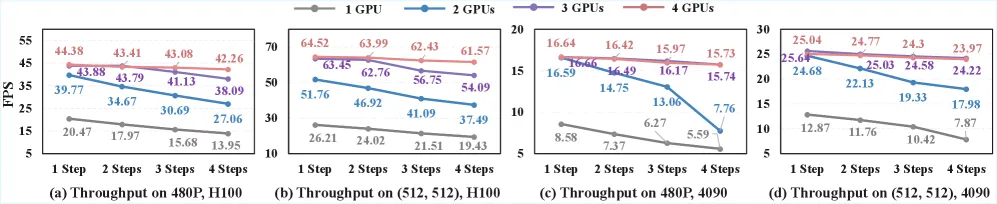
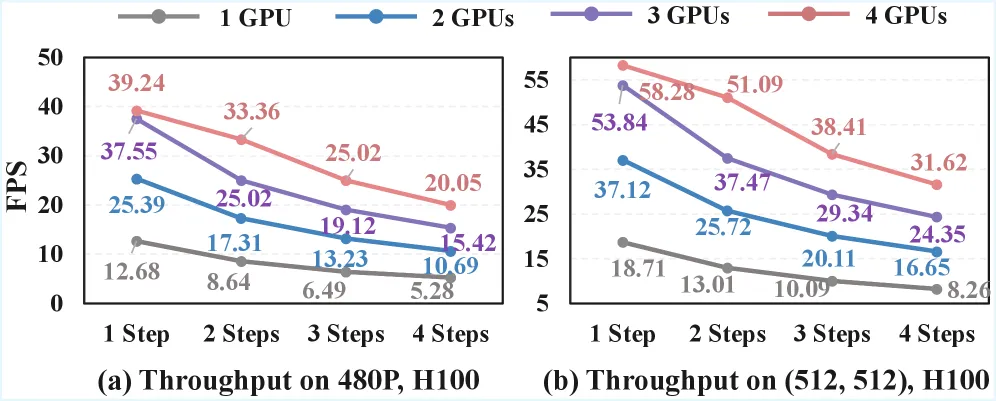
1.3B 模型(4×H100):
- 480p, 2-step: ~65 FPS
- 720p, 2-step: ~35 FPS
14B 模型(4×H100):
- 480p, 2-step: ~58 FPS
- 720p, 2-step: ~30 FPS
吞吐量对比
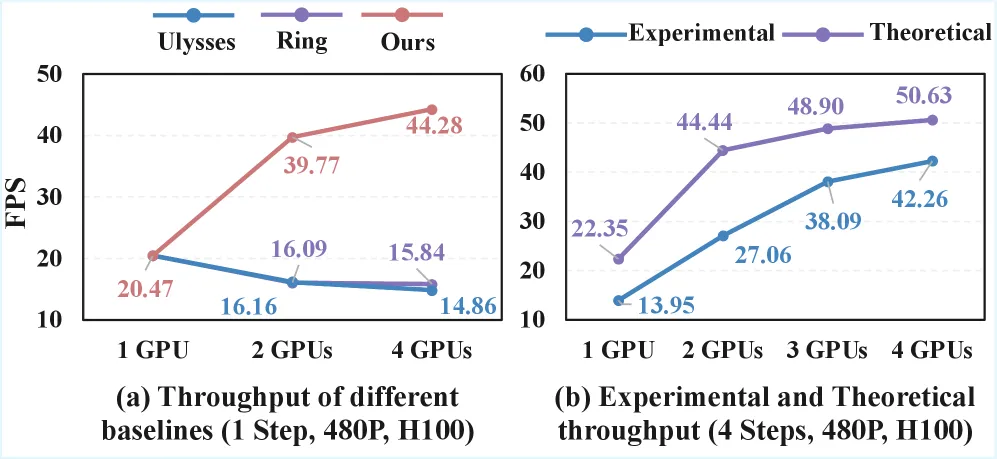
StreamDiffusionV2 在所有配置下均优于基线方法。
生成质量对比
| 方法 | Text-Image CLIP ↑ | Temporal CLIP ↑ | Warp Error ↓ |
|---|---|---|---|
| StreamDiffusion | 26.48 | 95.24 | 117.01 |
| StreamV2V | – | 96.58 | 102.99 |
| CausVid | 27.69 | 98.48 | 78.71 |
| StreamDiffusionV2 | 29.29 | 98.51 | 73.31 |
关键发现:
- Text-Image CLIP: 29.29(最高),比 CausVid 的 27.69 提升 5.8%
- Temporal CLIP: 98.51(最高),时间一致性最好
- Warp Error: 73.31(最低),比 CausVid 的 78.71 降低 6.9%
消融实验
| Sink Token | Dynamic Noising | CLIP Score ↑ | Warp Error ↓ |
|---|---|---|---|
| × | × | 98.38 | 79.51 |
| × | ✓ | 98.36 | 75.71 |
| ✓ | × | 98.47 | 73.64 |
| ✓ | ✓ | 98.51 | 73.13 |
消融发现:
- Sink Token:Warp Error 从 79.51 降至 73.64(-7.4%),对一致性贡献最大
- Dynamic Noising:Warp Error 从 79.51 降至 75.71(-4.8%)
- 两者结合:Warp Error 73.13,效果最好
定性对比
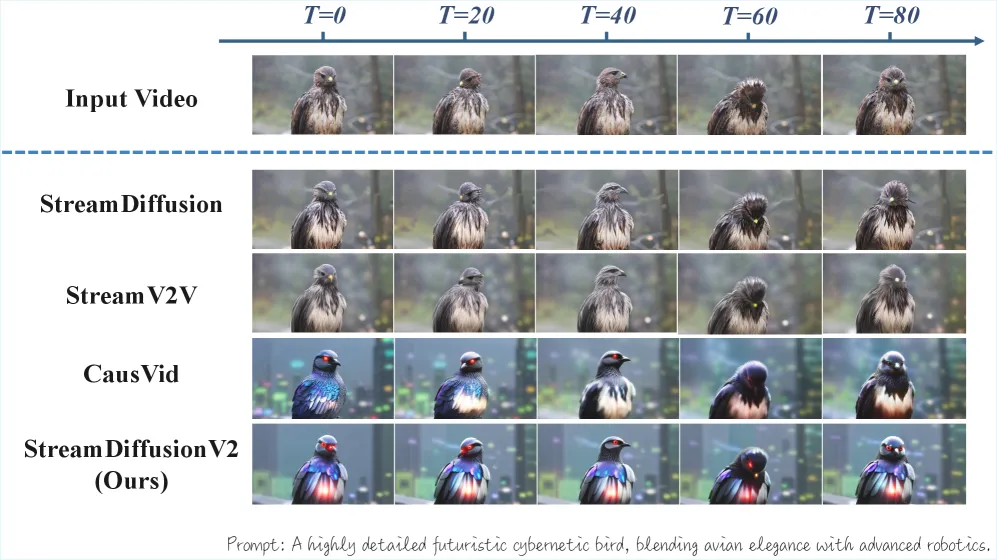
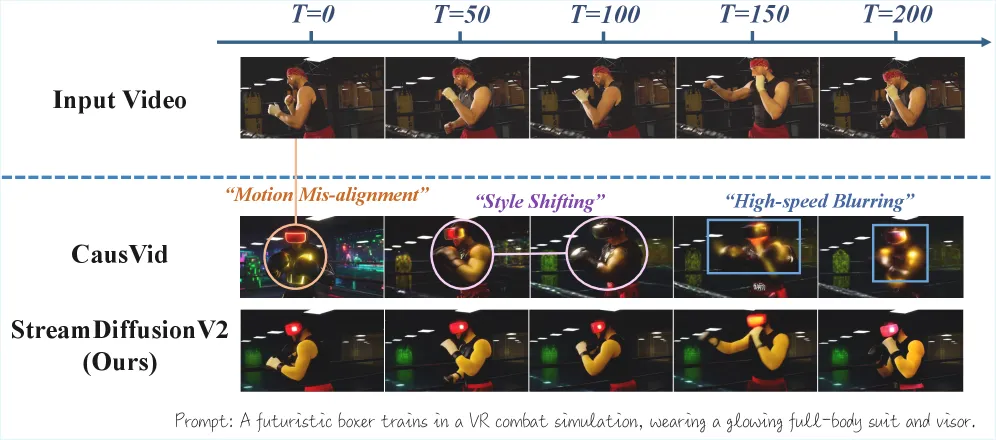
流水线调度效果
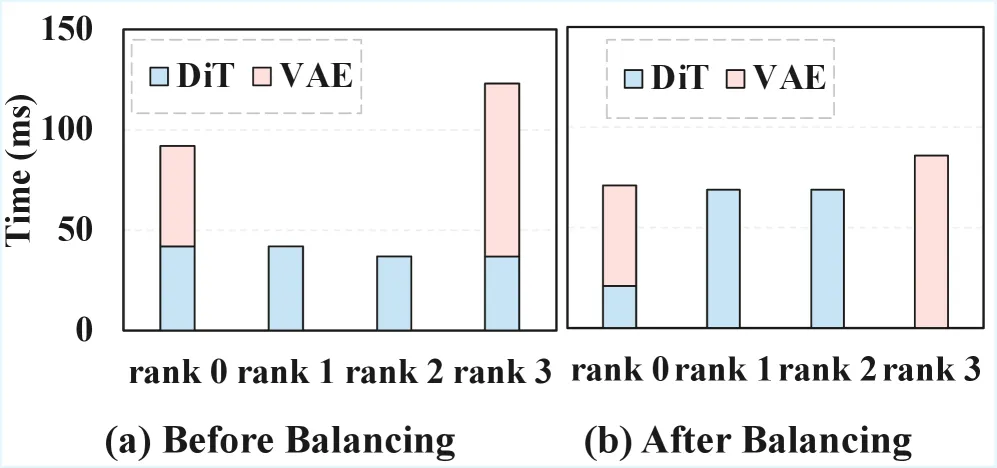
负载均衡后,各设备耗时趋于一致,效率提升显著。
序列并行 vs 流水线编排
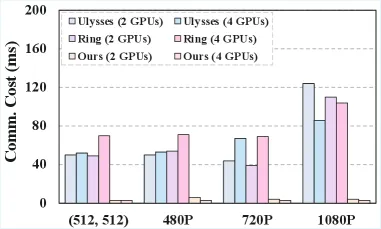
流水线编排的通信开销远低于序列并行。
Stream Batch 效果
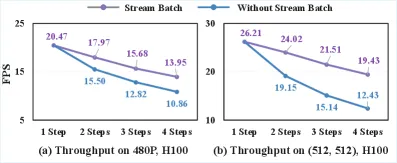
Stream Batch 显著提升流水线效率。
六、实现细节
| 配置 | 值 |
|---|---|
| 模型 | Wan 2.1 (1.3B), Wan 2.2 (14B) |
| 硬件 | 4× NVIDIA H100 SXM (NVLink), 4× RTX 4090 (PCIe) |
| 分辨率 | 480p (832×480), 720p |
| 去噪步数 | 1-4 步(灵活) |
| 首帧延迟 | <0.5s |
| 1.3B FPS | 64.52 (4×H100) |
| 14B FPS | 58.28 (4×H100) |
| SLO Miss Rate | 0.2% |
| Jitter | 21ms (mean) |
| 训练 | 训练无关(training-free) |
REPA 微调(可选)
使用 REPA (Representation Alignment) 策略增强视频质量:
七、与现有方法对比
| 方法 | 类型 | FPS | TTFF | 抖动 | SLO Miss | 训练 |
|---|---|---|---|---|---|---|
| StreamDiffusion | 图像扩散 | 高 | 低 | 中 | 低 | 无需 |
| CausVid | 因果蒸馏 | 17 | 0.78s | 235ms | 99.9% | 需要 |
| Self Forcing | 因果蒸馏 | 17 | 0.78s | 中 | 中 | 需要 |
| Rolling Forcing | 因果蒸馏 | 16 | 0.76s | 低 | 低 | 需要 |
| LongLive | 因果 AR | 21 | – | 低 | 低 | 需要 |
| MotionStream | 因果蒸馏 | 29 | 0.39s | 低 | 低 | 需要 |
| StreamDiffusionV2 | 流水线系统 | 65 | 0.35s | 21ms | 0.2% | 无需 |
独特优势:
- 最高 FPS:64.52 FPS(1.3B)/ 58.28 FPS(14B),比 CausVid 快 3.8×
- 最低抖动:21ms,比 CausVid 低 91%
- 训练无关:无需微调或蒸馏
- 可扩展:近线性 FPS 扩展
- SLO 保证:0.2% Miss Rate
八、相关工作
| 方向 | 代表工作 | 与 StreamDiffusionV2 的关系 |
|---|---|---|
| 图像流式扩散 | StreamDiffusion, TouchDesigner | 前代系统,时间一致性差 |
| 因果蒸馏 | CausVid, Self Forcing, Rolling Forcing | 视频生成基线 |
| 流式视频生成 | LongLive, MotionStream | 同类实时系统 |
| 序列并行 | DeepSpeed-Ulysses, Ring Attention | 替代并行策略 |
| 流水线并行 | PipeDream, GPipe | 并行策略灵感 |
| 直播系统 | Daydream | 应用场景 |
九、总结
核心贡献
- SLO 感知调度:动态调整流批量大小,满足逐帧截止时间
- Sink Token + 滚动 KV 缓存:周期性重置时间锚点,抑制长时漂移
- 运动感知噪声控制:根据运动幅度自适应调整去噪轨迹
- 流水线编排:跨去噪步骤和网络层并行化,近线性 FPS 扩展
- 64.52 FPS 实时生成:14B 模型 58.28 FPS,训练无关
- 极低抖动:21ms mean jitter,0.2% SLO Miss Rate
技术影响
- 首次将视频扩散模型应用于实时直播场景,解决 SLO 约束问题
- 流水线编排比序列并行更适合内存受限的流式推理场景
- 训练无关方案使得现有视频模型可直接部署
- 硬件趋势分析表明流式推理将越来越受内存带宽限制
- 为从个人创作者到企业级平台的实时 AI 直播提供了实用方案
局限性
- 代码未公开
- 需要多 GPU 部署(单 GPU 无法达到实时)
- 训练无关方案的质量上限受限于基础模型
- 流水线编排需要 NVLink 等高速互连
十、参考资源
- 论文: arXiv:2511.07399
- 关键引用:
- StreamDiffusion (Kodaira et al., 2023) — 前代图像流式系统
- CausVid (Yin et al., 2025) — 因果蒸馏基线
- Self Forcing (Huang et al., 2025) — 因果蒸馏基线
- Wan 2.1/2.2 — 基础视频扩散模型
- DMD (Yin et al., 2024) — 分布匹配蒸馏
- REPA (Yu et al., 2024) — 表示对齐训练策略
- DINOv2 (Oquab et al., 2024) — 视觉编码器
分析日期: 2026-06-05