MVU-Eval: Towards Multi-Video Understanding Evaluation for Multimodal LLMs
首个多视频理解评估基准,评估MLLM在跨视频感知和推理方面的8项核心能力
MVU-Eval: Towards Multi-Video Understanding Evaluation for Multimodal LLMs
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MVU-Eval: Towards Multi-Video Understanding Evaluation for Multimodal LLMs |
| 作者 | Tianhao Peng, Haochen Wang, Yuanxing Zhang, Zekun Wang, Zili Wang, Gavin Chang, Jian Yang, Shihao Li, Yanghai Wang, Xintao Wang, Houyi Li, Wei Ji, Pengfei Wan, Steven Huang, Zhaoxiang Zhang, Jiaheng Liu |
| 论文 | https://arxiv.org/abs/2511.07250 |
| 发布 | 2025-11-10 (v1), 2025-11-13 (v2) |
| 代码库 | https://github.com/NJU-LINK/MVU-Eval |
二、核心思想
问题定义
现有视频理解基准的局限性:
| 问题 | 说明 |
|---|---|
| 单视频输入 | 仅评估单个视频理解能力 |
| 缺乏跨视频推理 | 无法评估多视频信息整合能力 |
| 应用场景有限 | 无法覆盖体育分析、自动驾驶等多视频场景 |
真实应用场景
| 场景 | 说明 |
|---|---|
| 体育分析 | 多角度摄像机分析比赛 |
| 自动驾驶 | 多传感器信息融合 |
| 视频检索 | 多个相关视频的摘要和理解 |
| 影视分析 | 多场景、多角色的跨视频推理 |
解决方案概述
MVU-Eval 是首个综合性多视频理解评估基准:
- 1,824个精心策划的QA对
- 4,959个视频,来自多个领域
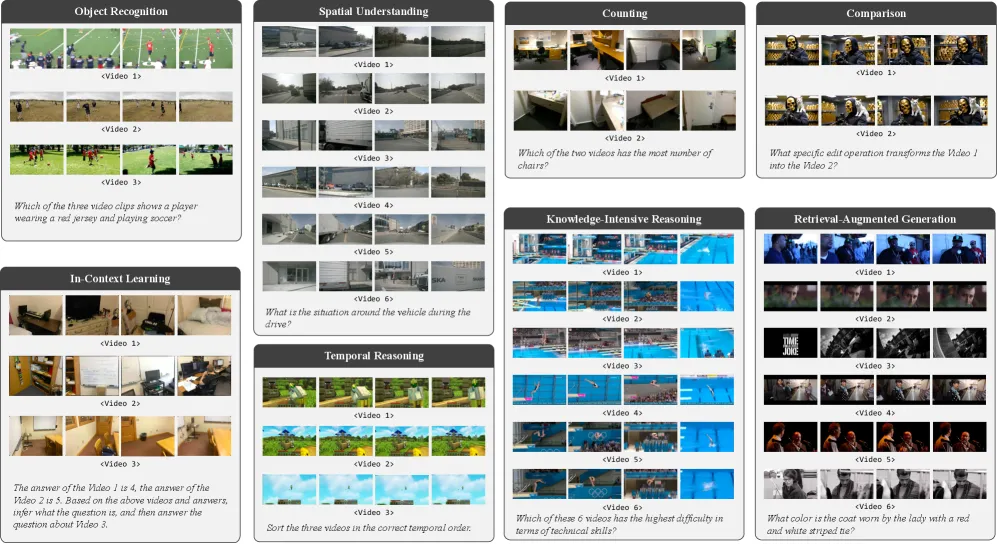
- 8项核心能力,涵盖感知和推理两个层面
- 真实场景对齐:体育、自动驾驶、电影等
三、技术架构
基准设计
两层评估协议:
多视频理解
├── 感知层(Perception)
│   ├── 物体识别(OR)
│   ├── 空间理解(SU)
│   ├── 计数(Counting)
│   └── 比较(Comparison)
│       ├── 替换(Replacement)
│       ├── 移除(Removal)
│       └── 添加(Addition)
└── 推理层(Reasoning)
    ├── 知识密集推理(KIR)
    ├── 上下文学习(ICL)
    ├── 检索增强生成(RAG)
    └── 时序推理(TR)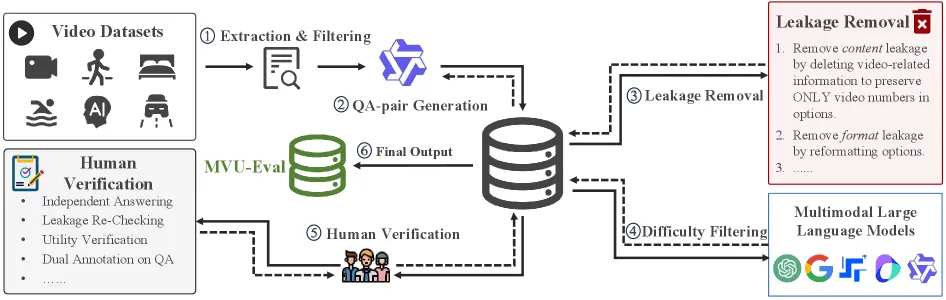
感知层任务
| 任务 | 说明 | 视频数量 |
|---|---|---|
| 物体识别(OR) | 跨视频识别和跟踪相同物体 | 126 |
| 空间理解(SU) | 从互补角度建模空间布局 | 179 |
| 计数(Counting) | 聚合异步视频中的瞬态物体 | 227 |
| 比较(Comparison) | 跨视频特征区分和细粒度分析 | 135 |
推理层任务
| 任务 | 说明 | 视频数量 |
|---|---|---|
| 知识密集推理(KIR) | 领域知识整合 | 281 |
| 上下文学习(ICL) | 跨视频模式识别 | 164 |
| 检索增强生成(RAG) | 基于多视频信息生成答案 | 339 |
| 时序推理(TR) | 时间排序、定位和描述 | 373 |
数据集统计
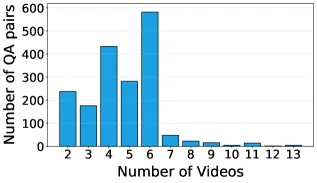
| 统计项 | 数值 |
|---|---|
| 总QA对数 | 1,824 |
| 总视频数 | 4,959 |
| 平均每个问题视频数 | 4.7 |
| 最大视频数 | 13 |
| 平均问题长度 | 111 tokens |
| 平均视频token长度 | 51,013 |
答案分布:
- 选项A: 25.5%
- 选项B: 25.8%
- 选项C: 22.7%
- 选项D: 20.4%
- 其他: 5.6%
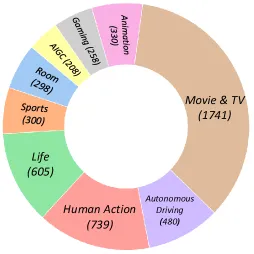
视频来源分布:
- 生活类
- 人类动作
- 电影/电视
- 体育
- 游戏
- 动画
- 自动驾驶
- AIGC
四、核心创新
| 创新点 | 说明 | 优势 |
|---|---|---|
| 首个多视频基准 | 评估跨视频理解和推理能力 | 填补评估空白 |
| 8项核心能力 | 感知+推理两层评估 | 全面覆盖 |
| 真实场景对齐 | 体育、自动驾驶等应用 | 实用性强 |
| 大规模数据 | 1,824 QA对,4,959视频 | 统计显著性 |
| 开源评测框架 | 提供标准化评估流程 | 促进研究 |
五、实验结果
主要结果
闭源模型:
| 模型 | 总体 | 感知 | 推理 | OR | SU | Counting | KIR | ICL | RAG | TR |
|---|---|---|---|---|---|---|---|---|---|---|
| Gemini 2.5 Pro | 58.4 | 47.6 | 64.1 | 54.7 | 65.6 | 76.3 | 50.2 | 34.8 | 43.7 | 83.1 |
| Gemini 1.5 Pro | 57.3 | 51.6 | 60.3 | 55.3 | 66.1 | 67.4 | 43.1 | 47.6 | 44.0 | 78.6 |
| Gemini 2.0 Flash | 56.3 | 46.0 | 60.4 | 52.0 | 45.4 | 75.6 | 53.7 | 45.1 | 44.5 | 79.1 |
| GPT-4o | 55.9 | 54.7 | 56.5 | 57.7 | 58.9 | 74.6 | 36.3 | 38.9 | 42.0 | 74.6 |
开源模型(>40B):
| 模型 | 总体 | 感知 | 推理 |
|---|---|---|---|
| Qwen2.5-VL-72B | 57.1 | 52.4 | 59.5 |
| InternVL3-78B | 50.6 | 42.9 | 54.6 |
| InternVL2.5-78B | 48.7 | 44.4 | 51.2 |
| LLaVA-OneVision-72B | 44.6 | 31.7 | 51.4 |
开源模型(8B-40B):
| 模型 | 总体 | 感知 | 推理 |
|---|---|---|---|
| Qwen2.5-VL-32B | 55.6 | 48.4 | 59.3 |
| InternVL3-38B | 48.4 | 46.0 | 49.8 |
| InternVL2.5-38B | 44.5 | 37.3 | 48.1 |
开源模型(<8B):
| 模型 | 总体 | 感知 | 推理 |
|---|---|---|---|
| Qwen2.5-VL-7B | 51.9 | 50.8 | 52.5 |
| VideoChat-Flash-7B | 48.5 | 48.4 | 48.5 |
| VideoLLaMA3-7B | 47.5 | 48.4 | 46.8 |
关键发现
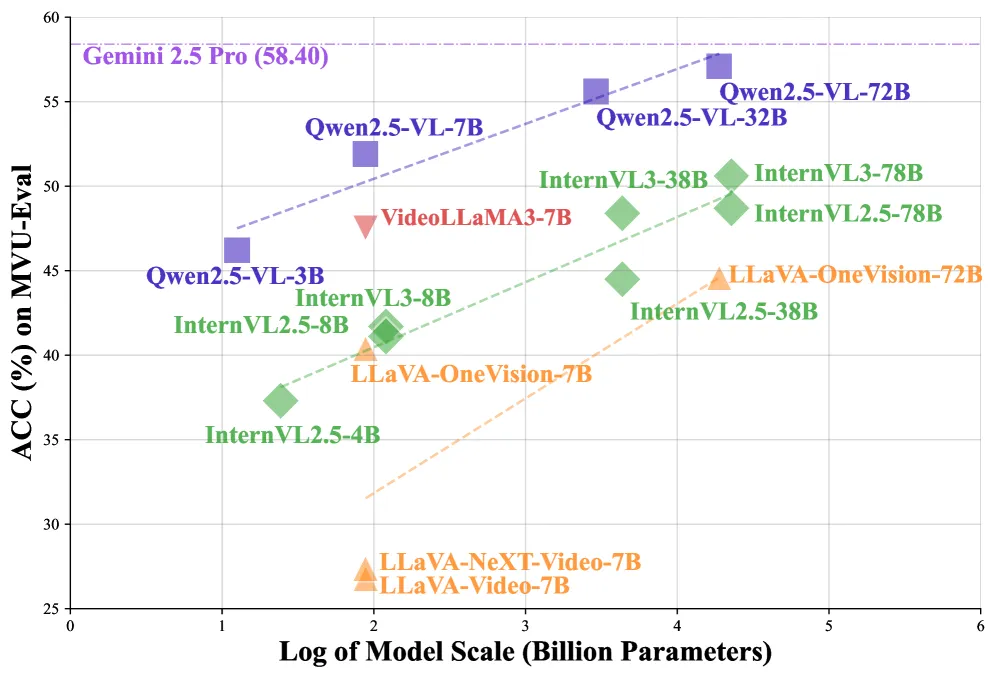
-
MVU-Eval非常具有挑战性
- 最佳闭源模型(Gemini 2.5 Pro)仅达到58.4%
- 远低于人类专家水平(93.6%)
-
不同子任务差异大
- Gemini 2.5 Pro在计数和知识推理上优于Qwen2.5-72B-VL
- 但Qwen2.5-72B-VL在RAG上(48.1%)优于Gemini 2.5 Pro(43.7%)
-
缩放效应保持
- Qwen2.5-VL系列(3B/7B/32B/72B):更大模型性能更好
- InternVL3系列(8B/38B):更大模型性能更好
-
小模型可能优于大模型
- Qwen2.5-VL-3B优于LLaVA-OneVision-7B
- 原因:更好的架构设计或更有效的数据策略
视觉信息有效性
VideoLLaMA3-7B在不同输入下的表现:
| 输入类型 | 准确率 | 变化 |
|---|---|---|
| 多视频 | 47.5% | - |
| 单视频 | 44.2% | -3.3% |
| 多图像 | 42.8% | -4.7% |
| 文本描述 | 38.5% | -9.0% |
| 无视频 | 32.1% | -15.4% |
关键发现:
- 视觉信息越多,性能越好
- 证明MVU-Eval任务设计合理,与多视频上下文紧密相关
六、相关工作
单视频基准
| 基准 | 视频数 | QA对数 | 多视频 |
|---|---|---|---|
| MVBench | 4,000 | 4,000 | × |
| LongVideoBench | 3,763 | 6,678 | × |
| Video-MME | 900 | 2,700 | × |
| MLVU | 1,730 | 3,102 | × |
| MVU-Eval | 4,959 | 1,824 | ✓ |
多模态评估
- 图像理解:MMBench, MMMU等
- 视频理解:Video-MME, LongVideoBench等
- 多视频理解:MVU-Eval(首个)
七、总结
核心贡献
- 首个多视频理解基准:填补评估空白
- 8项核心能力:感知+推理全面覆盖
- 大规模数据:1,824 QA对,4,959视频
- 真实场景对齐:体育、自动驾驶等应用
- 标准化评测:开源评测框架
技术影响
- 评估标准:为多视频理解提供统一评估框架
- 模型改进:揭示当前模型的局限性和改进方向
- 应用推动:促进体育分析、自动驾驶等领域的研究
- 研究方向:指明多视频理解的未来研究重点
局限性
- 任务类型有限:8项能力可能未完全覆盖所有场景
- 视频来源:部分视频来源可能不够多样化
- 评估指标:仅使用准确率,可能不够全面
- 模型限制:部分模型输出格式不规范
八、参考资源
论文
相关基准
- Video-MME: Fu et al., 2024
- LongVideoBench: Wu et al., 2025
- MVBench: Li et al., 2024
- MLVU: Zhou et al., 2024
评估模型
- Gemini 2.5 Pro: Google
- GPT-4o: OpenAI
- Qwen2.5-VL: Alibaba
- InternVL3: Shanghai AI Lab