ConsistTalk: Intensity Controllable Temporally Consistent Talking Head Generation with Diffusion Noise Search
具有扩散噪声搜索的强度可控时间一致说话头生成
ConsistTalk: Intensity Controllable Temporally Consistent Talking Head Generation with Diffusion Noise Search
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | ConsistTalk: Intensity Controllable Temporally Consistent Talking Head Generation with Diffusion Noise Search |
| 作者 | Ziqi Zhang, Yuxuan Zhang, Shilin Lu, Zhiyuan Ma, Yi Ren |
| 机构 | ByteDance |
| 论文 | arXiv:2511.06833 |
| 代码 | 未公开 |
| 发布 | 2025年11月10日 |
| 主题 | cs.CV, cs.MM, cs.SD, eess.AS |
二、核心思想
问题定义
现有音频驱动肖像动画方法存在三个主要问题:
- 闪烁 (Flickering): 外观信息在时序层中污染运动特征
- 身份漂移 (Identity Drift): 自回归推理策略导致误差累积
- 音画不同步: 运动强度控制不稳定
解决方案概述
ConsistTalk 是一个强度可控、时间一致的说话头生成框架:
- OFT (Optical Flow-guided Temporal Module): 使用面部光流解耦运动与外观
- A2I (Audio-to-Intensity) Model: 通过多模态师生知识蒸馏预测帧级强度序列
- IC-Init (Intensity-guided Consistent Initialization): 扩散噪声搜索推理策略
核心性能
| 指标 | 数值 | 对比 |
|---|---|---|
| FVD | 171.7 | 比 Sonic (206.1) 降低 16.7% |
| Flicker | 0.4218 | 比 Sonic 降低 39%,比 SadTalker 降低 22% |
| ID-Dist | 最低 | 最佳身份保持 |
| Beat Align | 1.659 | 最佳音画同步 |
| Diversity | 3.48 | 最佳运动多样性 |
三、技术架构
整体框架图
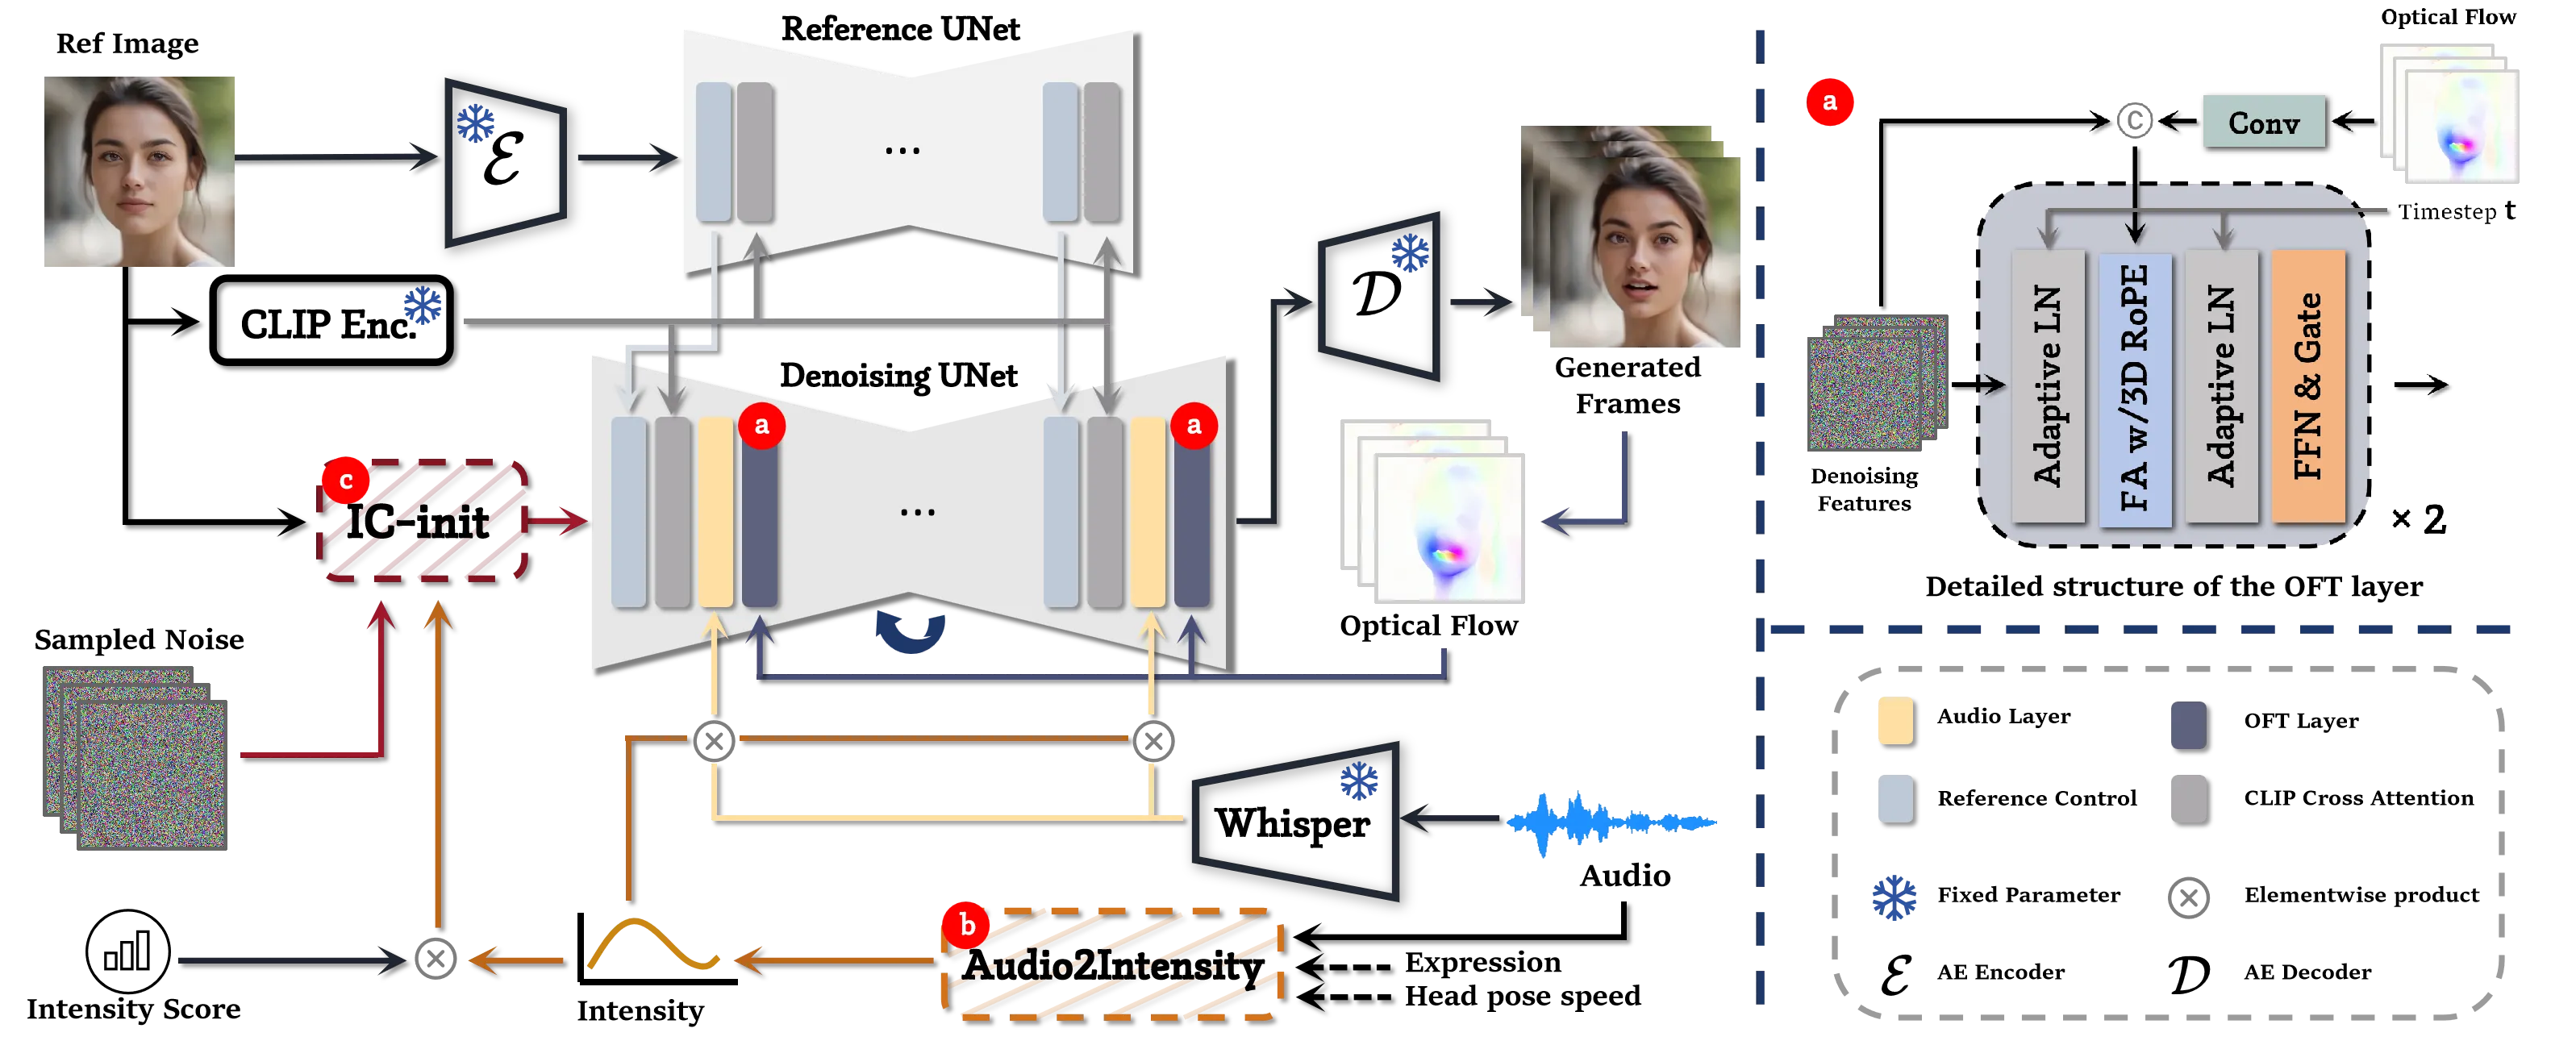
Figure 2: ConsistTalk 整体架构。系统集成三个关键模块:(a) 面部光流引导时序模块 (OFT);(b) 音频到强度模型 (A2I);(c) 强度引导噪声初始化策略 (IC-Init)。
核心模块
1. OFT: 光流引导时序模块
问题: 现有方法使用 ReferenceNet 提取前帧特征,但外观信息会污染时序层,导致闪烁。
解决方案:
- 使用 FacialFlownet 估计面部光流
- 3D 卷积下采样到潜在空间分辨率
- 使用 Full-Attention + 3D RoPE 增强时序一致性
核心思想: 运动动态从身份信息中解耦,确保模型仅依赖参考图像获取外观特征。
2. A2I: 音频到强度模型
问题: 音频到运动的一对多映射难以建模,运动强度控制不稳定。
解决方案:
- 教师模型: 多模态交叉注意力 + 门控线性单元
- 学生模型: 仅从音频预测强度序列(通过知识蒸馏)
强度损失:
其中:
- : 输出强度序列
- : 头部运动速度
- : 面部关键点运动方差
- : 形状和时序损失的权重
学生模型总损失:
3. IC-Init: 强度引导扩散噪声搜索
问题: 自回归推理策略导致误差累积和身份漂移。
解决方案:
- 训练无关的推理算法
- 基于强度序列引导的噪声搜索
- 强制背景稳定性和运动连续性约束
算法流程 (Beam Search):
输入: 潜在去噪扩散模型 ε_θ, 参考肖像图像潜在 z_ref, 束宽 B, 候选数 K, 前瞻步数 T', 加噪步数 τ
输出: 生成的视频帧序列

1. z_ref,τ = add_noise(z_ref, τ)
2. B_0 = {z_0^s}_{s=1}^B  // 初始束
3. for l = 1 to L:
   for z_{l-1}^s ∈ B_{l-1}:
     z_{l-1,τ}^s = add_noise(z_{l-1}^s, τ)
     {z_{l,T}^{s,k} ~ N(0, I)}_{k=1}^K  // 采样 K 个候选
     z_{l,T-T'}^{s,k} = de_noise(z_{l,T}^k, ε_θ, T')  // 前瞻去噪
     // 选择最优候选...
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| OFT 模块 | 面部光流解耦运动与外观 | Flicker 降低 76.6%,FVD 降低 10.7% |
| A2I 模块 | 多模态师生蒸馏预测强度 | Beat Align 从 1.551 提升到 1.624 |
| IC-Init 策略 | 强度引导噪声搜索 | 比 FreeInit 更好的身份保持和运动连续性 |
| Full-Attention + 3D RoPE | 更好的时空特征整合 | 比 2D+1D 注意力更好的时序一致性 |
五、实验结果
实验设置
| 项目 | 配置 |
|---|---|
| 训练数据 | CelebV-HQ, VFHQ, Hallov3 训练集 |
| 测试数据 | HDTF (50 个 16 秒片段) |
| 分辨率 | 512×512 |
| 帧率 | 25 FPS |
| 音频采样率 | 16 kHz |
| 优化器 | Adam (lr=1e-5) |
| DDIM 调度器 | τ=20, T’=3, T=30 |
| Beam Search | K=4, B=2 |
评估指标
| 指标 | 说明 |
|---|---|
| FVD | Fréchet Video Distance(视频质量) |
| E-FID | Expression FID(表情保真度) |
| ID-Dist | ArcFace 身份余弦距离(身份保持) |
| SyncNet-C | 音唇同步质量 |
| VBench Smooth | 运动流畅性 |
| VBench Background | 背景稳定性 |
| Flicker | 闪烁程度 |
| Beat Align | 音画对齐 |
| Diversity | 运动多样性 |
定量结果
| 方法 | FVD↓ | E-FID↓ | ID-Dist↓ | Sync-C↑ | Flicker↓ | BA↑ | Div↑ |
|---|---|---|---|---|---|---|---|
| SadTalker | 318.5 | 1.89 | 0.28 | 5.92 | 0.54 | 1.42 | 2.15 |
| AniTalker | 285.3 | 1.67 | 0.25 | 6.15 | 0.68 | 1.48 | 2.45 |
| Hallo-v1 | 228.4 | 1.52 | 0.22 | 6.30 | 2.26 | 1.55 | 2.95 |
| Hallo-v2 | 245.1 | 1.58 | 0.24 | 6.22 | 1.85 | 1.52 | 2.78 |
| EchoMimic | 268.9 | 1.72 | 0.26 | 6.08 | 0.95 | 1.45 | 2.35 |
| Sonic | 206.1 | 1.48 | 0.21 | 6.45 | 0.69 | 1.58 | 3.12 |
| FantasyTalking | 252.4 | 1.65 | 0.27 | 6.12 | 0.82 | 1.50 | 2.65 |
| ConsistTalk | 171.7 | 1.44 | 0.19 | 6.83 | 0.42 | 1.66 | 3.48 |
关键结果:
- FVD: 171.7,比 Sonic (206.1) 降低 16.7%
- Flicker: 0.4218,比 Sonic 降低 39%,比 SadTalker 降低 22%
- ID-Dist: 0.19,最佳身份保持
- Sync-C: 6.83,比 Hallo-v1 (6.30) 提升 8.4%
- Beat Align: 1.66,最佳音画同步
- Diversity: 3.48,最佳运动多样性
消融实验
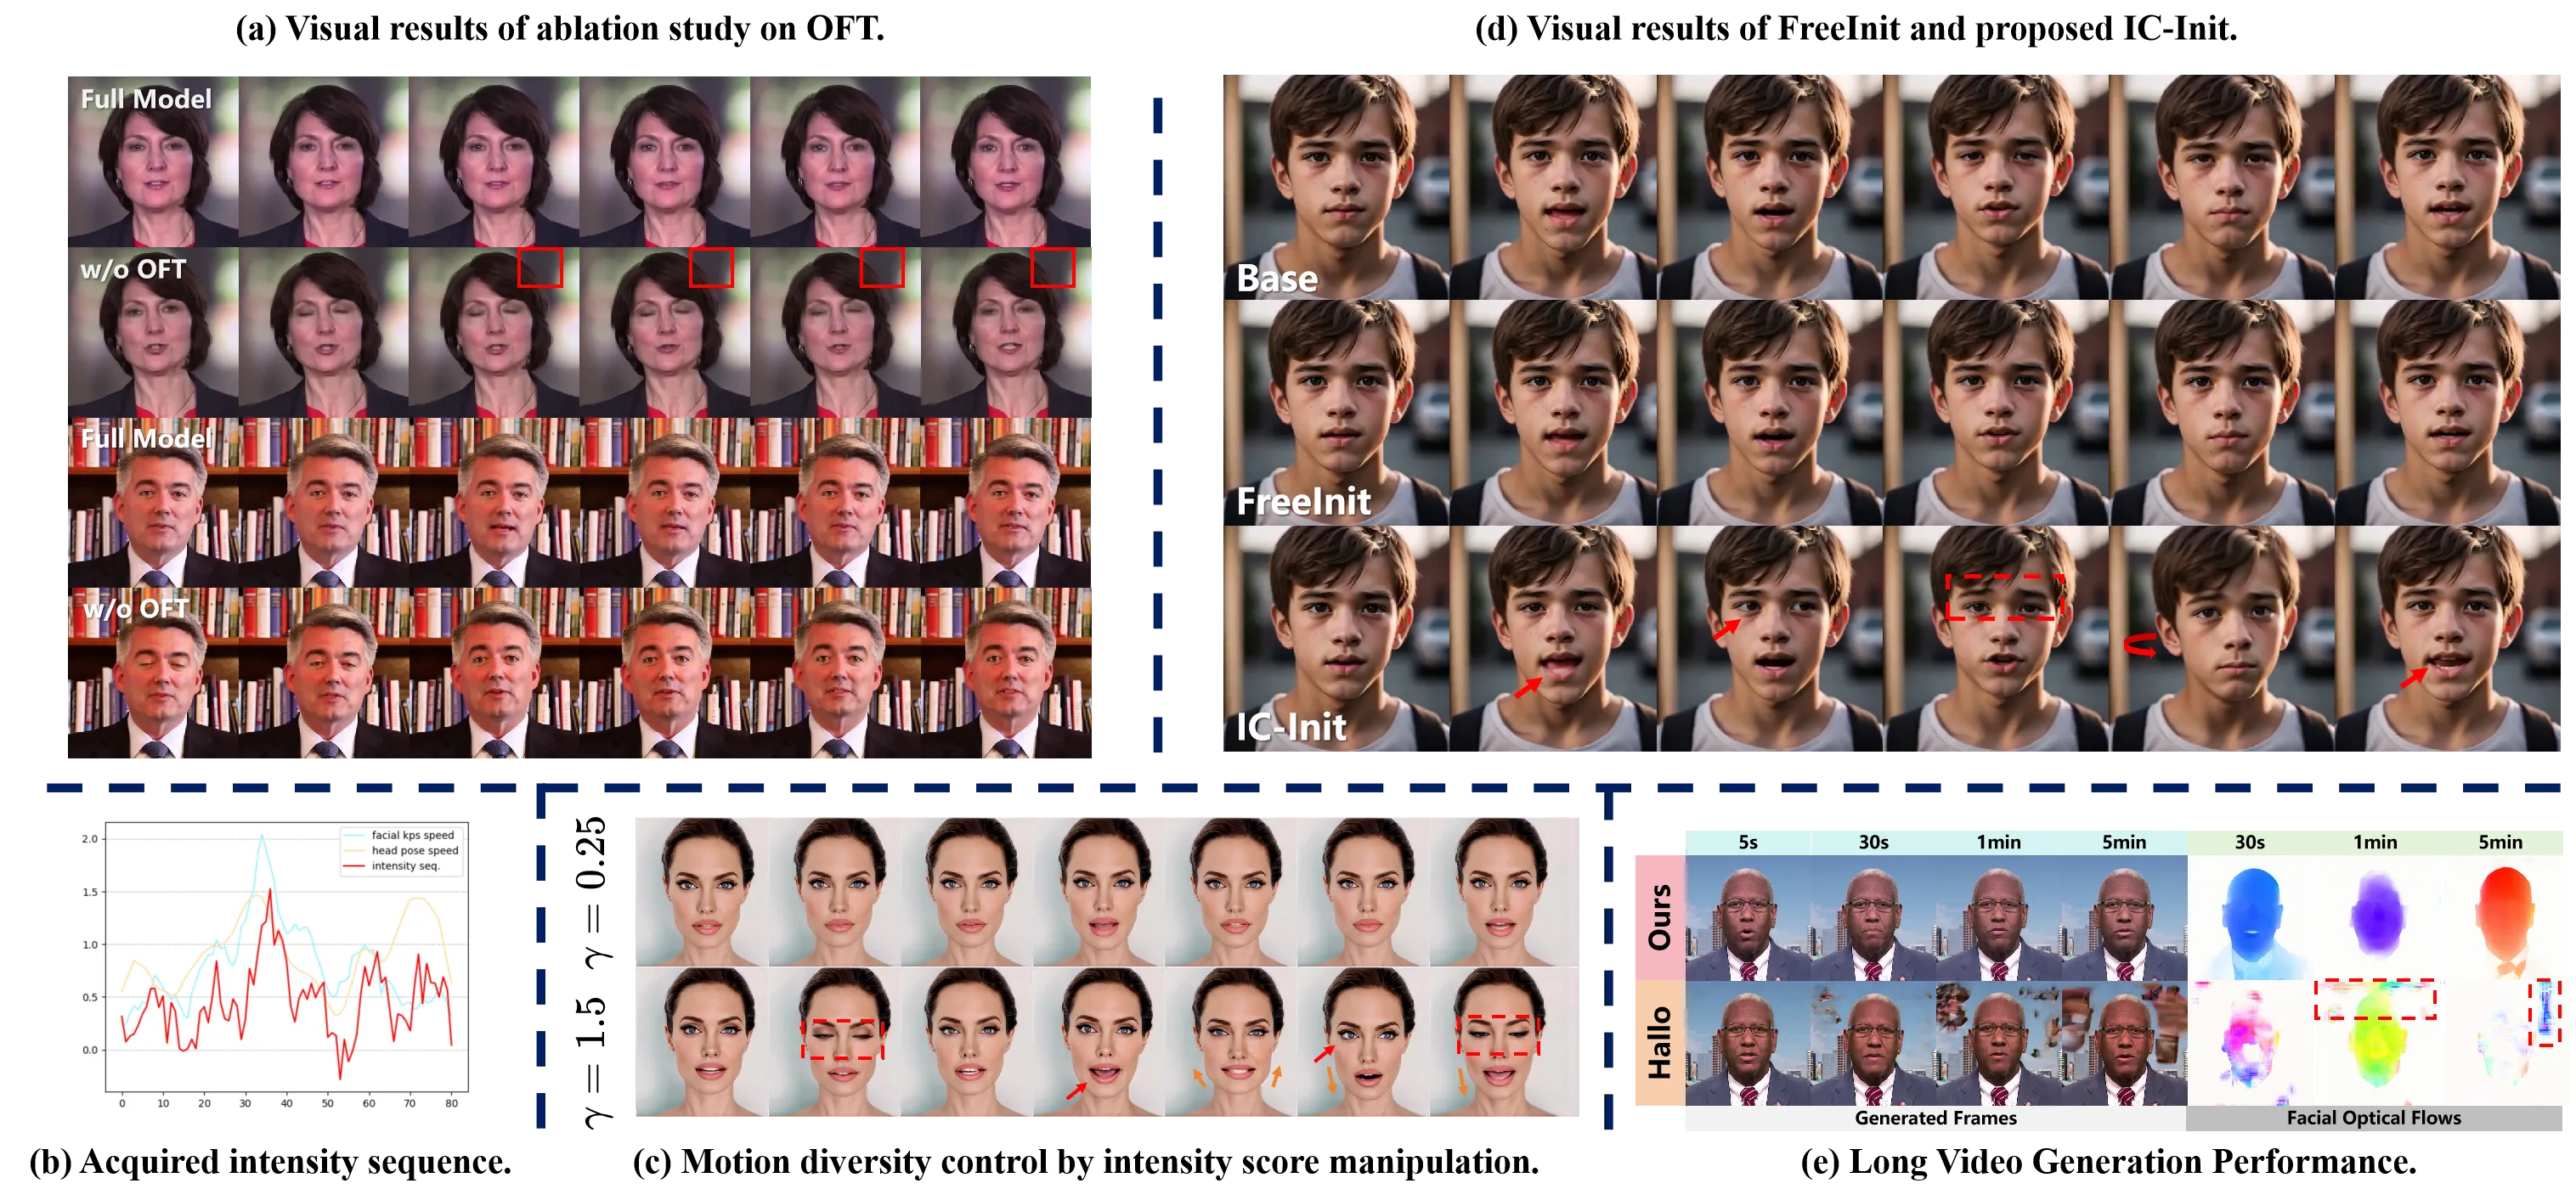
Figure 5: 消融实验。(a) OFT 消融视觉结果;(b) 强度序列可视化;(c) 强度分数操控;(d) FreeInit vs IC-Init;(e) 长视频生成质量比较。
OFT 模块效果
| 配置 | FVD | Flicker | 改进 |
|---|---|---|---|
| 基线 (ReferenceNet) | 228.4 | 2.2642 | - |
| + OFT | 203.9 | 0.5288 | FVD -10.7%, Flicker -76.6% |
| + OFT + A2I | 195.2 | 0.4856 | 进一步改进 |
| 完整模型 | 171.7 | 0.4218 | 最优 |
A2I 模块效果
| 配置 | Beat Align | Diversity |
|---|---|---|
| 基线 + OFT | 1.551 | 2.95 |
| + A2I | 1.624 | 3.16 |
| 完整模型 | 1.659 | 3.48 |
IC-Init 效果
| 配置 | 说明 |
|---|---|
| 基线 (无 IC-Init) | 基本推理 |
| FreeInit | τ=20, D0=0.25 |
| IC-Init | 更稳定的输出,更丰富的动态 |
长视频生成
问题: Hallo 在 1-5 分钟后出现严重外观漂移和背景闪烁。
ConsistTalk: 在整个视频中保持稳定的身份和连贯的面部结构,光流图显示集中、面部聚焦的运动场。
六、与现有方法对比
| 方面 | Hallo | Sonic | FantasyTalking | ConsistTalk |
|---|---|---|---|---|
| 时序模块 | ReferenceNet | 运动解耦 | ReferenceNet | OFT (光流) |
| 运动控制 | 层次化音频驱动 | 运动桶 | 无 | A2I 强度序列 |
| 推理策略 | 自回归 | 自回归 | 自回归 | IC-Init 噪声搜索 |
| Flicker | 2.26 | 0.69 | 0.82 | 0.42 |
| 身份保持 | 中等 | 较好 | 差 | 最佳 |
| 长视频 | 漂移严重 | 中等 | 中等 | 稳定 |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| Hallo / Hallo2 | 基线方法,ConsistTalk 解决其闪烁和漂移问题 |
| Sonic | 最强基线,ConsistTalk 在 FVD 上超越 16.7% |
| EchoMimic | 扩散基线,ConsistTalk 提供更好的时序一致性 |
| SadTalker | 两阶段基线,ConsistTalk 端到端更优 |
| FreeInit | 噪声初始化方法,IC-Init 提供更好的约束 |
八、总结
核心贡献
- OFT 模块: 使用面部光流解耦运动与外观,Flicker 降低 76.6%
- A2I 模块: 多模态师生知识蒸馏预测帧级强度序列,实现精细运动控制
- IC-Init 策略: 训练无关的扩散噪声搜索,增强身份保持和运动连续性
- SOTA 性能: FVD 171.7,Flicker 0.42,全面超越现有方法
技术影响
- 说话头生成: 解决闪烁、身份漂移、音画不同步三大问题
- 扩散模型推理: IC-Init 为扩散模型推理提供新的噪声初始化范式
- 多模态融合: A2I 的师生蒸馏策略可推广到其他多模态任务
- 长视频生成: OFT + IC-Init 有效抑制长视频中的误差累积
局限性
- 代码和模型未公开
- 仅在 HDTF 数据集上测试
- 未探索实时生成
- IC-Init 增加推理时间(Beam Search)
九、参考资源
- 论文: arXiv:2511.06833
- 主题: cs.CV, cs.MM, cs.SD, eess.AS
- 页数: 约 12 页, 5 图, 4 表