MotionStream: Real-Time Video Generation with Interactive Motion Controls
实时交互式运动控制视频生成
MotionStream: Real-Time Video Generation with Interactive Motion Controls
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MotionStream: Real-Time Video Generation with Interactive Motion Controls |
| 作者 | Joonghyuk Shin, Zhengqi Li, Richard Zhang, Jun-Yan Zhu, Jaesik Park, Eli Shechtman, Xun Huang |
| 论文 | arXiv:2511.01266 |
| 代码 | 未公开 |
| 发布 | 2025年11月3日(v5: 2026年3月5日) |
二、核心思想
问题定义
运动控制的视频合成目标是让用户能够直观地引导数字角色、物体和摄像机的运动。然而,现有方法存在根本性限制:
- 延迟过高:生成 5 秒视频需要 12 分钟(如 Motion Prompting),用户被困在”渲染-等待”循环中
- 非因果处理:双向注意力要求所有未来控制信号预先提供,无法支持实时交互
- 无法流式生成:整个序列并行处理,用户在完成前无法看到任何部分结果
解决方案概述
本文提出 MotionStream,专为交互式创作体验设计的实时流式视频生成框架:
- 运动控制教师模型:使用轻量级正弦位置编码 + 通道拼接进行轨迹条件化,避免 ControlNet 的计算开销
- 因果蒸馏:通过 Self Forcing + DMD 将双向教师蒸馏为因果学生模型
- 注意力汇聚 + 滑动窗口因果注意力:解决长视频外推时的质量退化和漂移问题
- 自滚动训练:用自生成输出替代 GT 进行训练,正确模拟推理时的外推
关键创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 轻量级轨迹编码 | 正弦 PE + 可学习 track head,通道拼接 | 比 RGB-VAE 快 42×,质量更好 |
| 联合文本-运动引导 | 文本提供自然动态,运动提供轨迹对齐 | 兼顾轨迹精度和自然运动 |
| 注意力汇聚机制 | 缓存初始帧 KV 作为全局锚点 | 长视频外推质量显著提升 |
| 自滚动 + KV 缓存滚动 | 训练时模拟推理时的外推行为 | 解决有限长度→无限长度的域差距 |
| Tiny VAE | 轻量级解码器,LPIPS + 对抗训练 | 解码速度提升 10×+ |
三、技术架构
整体框架图
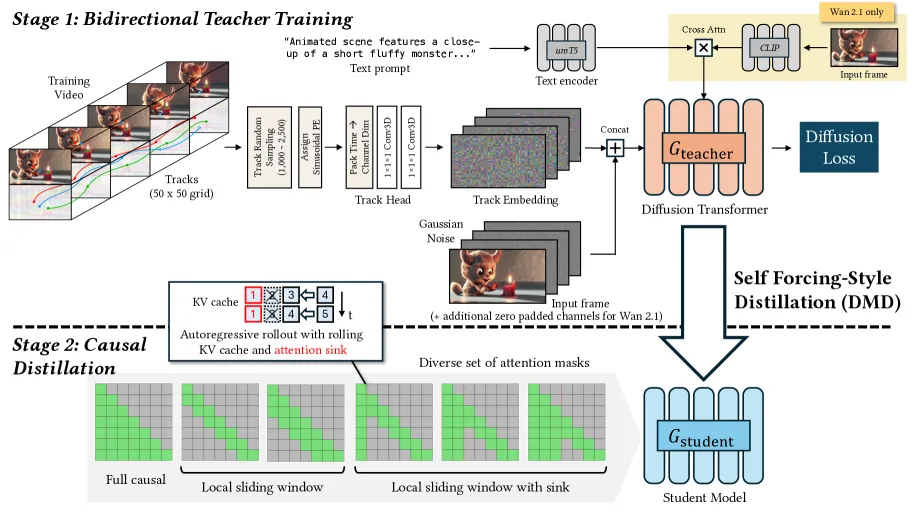
核心公式
运动控制教师模型
轨迹表示:每个 2D 轨迹分配唯一的 d 维嵌入向量 ,通过随机采样的 ID 号经正弦位置编码得到:
轻量级轨迹头:执行 4× 时间压缩后接 3×3 卷积,直接与视频 latent 通道拼接:
联合引导:
- 纯运动引导:轨迹精度最高,但运动过于刚性(如纯 2D 平移)
- 纯文本引导:自然动态,但轨迹对齐差
- 联合引导:兼顾两者优势
因果蒸馏
滑动窗口注意力:
其中 是注意力汇聚的初始帧, 是局部窗口大小。
自滚动 (Self Rollout):在训练时自回归生成视频块,用自生成输出替代 GT:
DMD 蒸馏损失:
注意力机制可视化
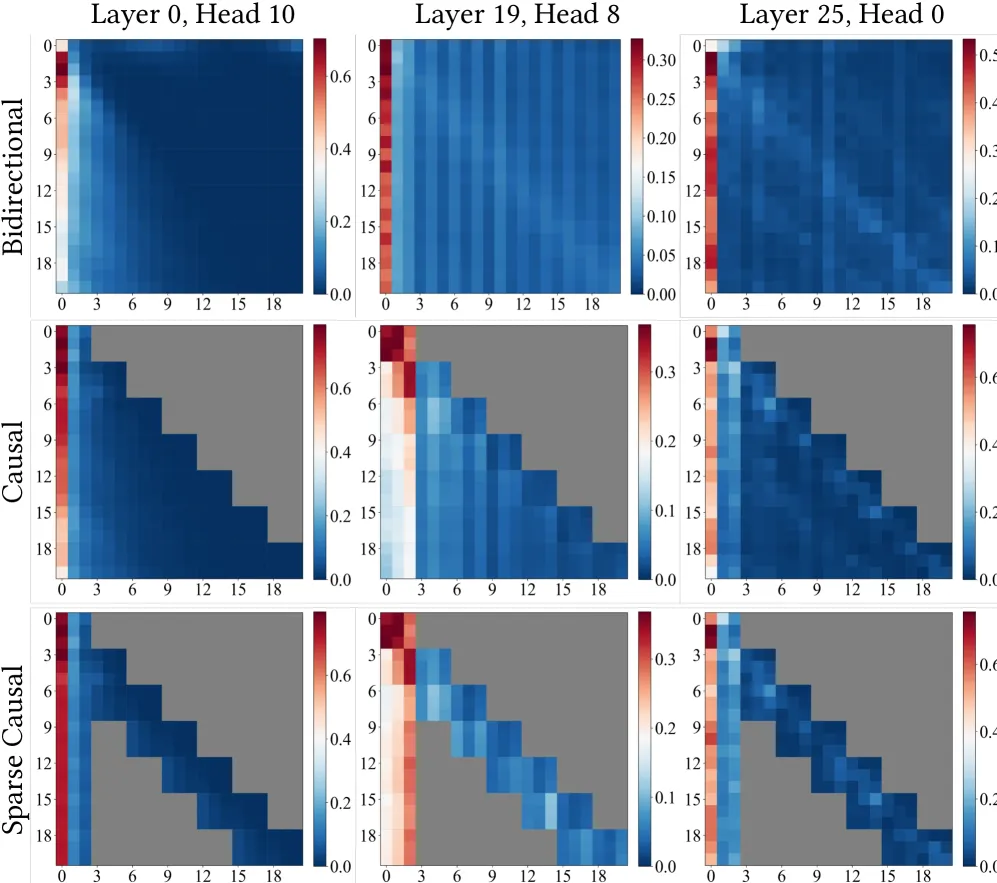
- 双向注意力:所有 token 互相注意
- 全因果注意力:只注意过去 token
- 因果滑动窗口 + 注意力汇聚:注意初始帧(汇聚)+ 最近窗口
四、核心能力
实时交互式运动控制
- 画轨迹:用户绘制 2D 轨迹,实时控制物体运动
- 相机控制:通过轨迹实现相机运动控制
- 运动迁移:从参考视频迁移运动到新场景
- 拖拽交互:实时拖拽物体,视频即时响应
性能指标
| 配置 | 分辨率 | FPS | 延迟 |
|---|---|---|---|
| Wan 2.1 (1.3B) | 480P | 16.7 | 0.69s |
| Wan 2.2 (5B) | 720P | 10.4 | 1.1s |
| Wan 2.1 + Tiny VAE | 480P | 29.5 | 0.39s |
| Wan 2.2 + Tiny VAE | 720P | 23.9 | 0.49s |
支持的应用
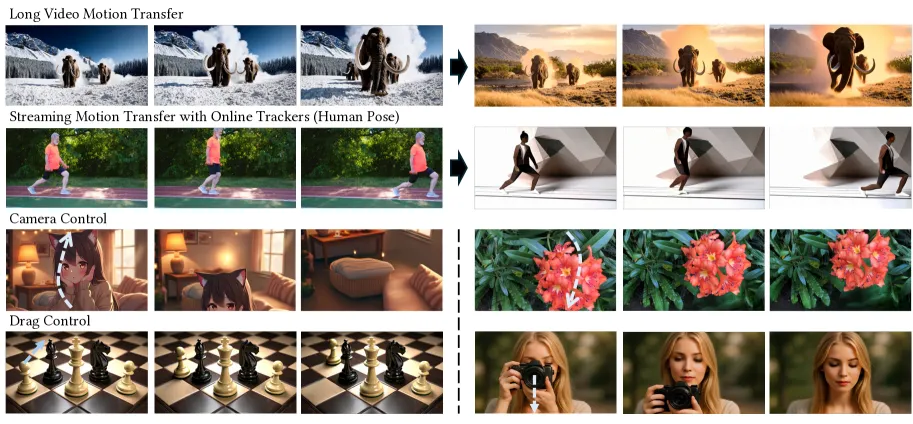
- 长视频运动迁移(离线/在线控制)
- 新视角合成(相机控制)
- 交互式拖拽演示
- 物体运动引导
五、实验结果
运动迁移(重建质量)
| 方法 | Backbone | FPS | DAVIS PSNR ↑ | DAVIS SSIM ↑ | DAVIS LPIPS ↓ | DAVIS EPE ↓ | Sora PSNR ↑ | Sora SSIM ↑ | Sora LPIPS ↓ | Sora EPE ↓ |
|---|---|---|---|---|---|---|---|---|---|---|
| Image Conductor | AnimateDiff (256P) | 2.98 | 11.30 | 0.214 | 0.664 | 91.64 | 10.29 | 0.192 | 0.644 | 31.22 |
| Go-With-The-Flow | CogVideoX-5B (480P) | 0.60 | 15.62 | 0.392 | 0.490 | 41.99 | 14.59 | 0.410 | 0.425 | 10.27 |
| Diffusion-As-Shader | CogVideoX-5B (480P) | 0.29 | 15.80 | 0.372 | 0.483 | 40.23 | 14.51 | 0.382 | 0.437 | 18.76 |
| ATI | Wan 2.1-14B (480P) | 0.23 | 15.33 | 0.374 | 0.473 | 17.41 | 16.04 | 0.502 | 0.366 | 6.12 |
| Ours Teacher (1.3B) | Wan 2.1-1.3B (480P) | 0.79 | 16.61 | 0.477 | 0.427 | 5.35 | 17.82 | 0.586 | 0.333 | 2.71 |
| Ours Causal (1.3B) | Wan 2.1-1.3B (480P) | 16.7 | 16.20 | 0.447 | 0.443 | 7.80 | 16.67 | 0.531 | 0.360 | 4.21 |
| Ours Teacher (5B) | Wan 2.2-5B (720P) | 0.74 | 16.10 | 0.466 | 0.427 | 7.86 | 17.18 | 0.571 | 0.331 | 3.16 |
| Ours Causal (5B) | Wan 2.2-5B (720P) | 10.4 | 16.30 | 0.456 | 0.438 | 11.18 | 16.62 | 0.545 | 0.343 | 4.30 |
关键发现:
- 1.3B 教师模型在 DAVIS 和 Sora 上均超越所有基线(包括使用 14B 参数的 ATI)
- 因果蒸馏版本保持高质量的同时实现 16.7 FPS(比 ATI 快 72×)
- Sora EPE: ATI 6.12 → Ours Teacher 2.71(降低 56%)
新视角合成(相机控制)
| 方法 | 分辨率 | FPS | LLFF PSNR ↑ | LLFF SSIM ↑ | LLFF LPIPS ↓ |
|---|---|---|---|---|---|
| DepthSplat | 576P | 1.40 | 13.9 | 0.28 | 0.30 |
| ViewCrafter | 576P | 0.26 | 14.0 | 0.30 | 0.30 |
| SEVA | 576P | 0.20 | 14.1 | 0.30 | 0.29 |
| Ours Teacher (1.3B) | 480P | 0.79 | 16.0 | 0.42 | 0.21 |
| Ours Causal (1.3B) | 480P | 16.7 | 15.7 | 0.38 | 0.23 |
| Ours Teacher (5B) | 720P | 0.74 | 14.0 | 0.40 | 0.22 |
| Ours Causal (5B) | 720P | 10.4 | 15.0 | 0.39 | 0.23 |
关键发现:
- 因果版本在 LLFF 上以 16.7 FPS 达到 15.7 PSNR,超越所有专用 3D 方法
- 比 ViewCrafter 快 64×,比 SEVA 快 83×,且质量更高
轨迹表示对比
| 方法 | 时间 (ms) | DAVIS PSNR | Sora PSNR | DAVIS LPIPS | Sora LPIPS |
|---|---|---|---|---|---|
| RGB-VAE | 1053 | 16.03 / 16.99 | 0.433 / 0.544 | 0.463 / 0.363 | 8.57 / 3.96 |
| PE-Head | 24.8 | 16.29 / 17.15 | 0.452 / 0.559 | 0.456 / 0.359 | 6.54 / 3.13 |
PE-Head 比 RGB-VAE 快 42×(24.8ms vs 1053ms),且质量更好。
消融实验
| 配置 | LPIPS ↓ | EPE ↓ | 延迟 (s) | 吞吐量 (FPS) |
|---|---|---|---|---|
| Ours base (c3s1w1) | 0.464 | 25.34 | 0.70 | 16.92 |
| + Remove sink (c3s0w1) | 0.501 | 26.64 | 0.68 | 17.43 |
| + Chunk Size 1 (c1s1w1) | 0.597 | 76.21 | 0.30 | 13.26 |
| Sliding window | 0.480 | 28.09 | 0.80 | 14.96 |
消融发现:
- 注意力汇聚:移除后 LPIPS 从 0.464 升至 0.501,EPE 从 25.34 升至 26.64
- Chunk Size:大小为 1 时质量严重下降(EPE 76.21),但延迟最低
- 滑动窗口:比基础配置略差,延迟波动更大
注意力汇聚和窗口大小的影响
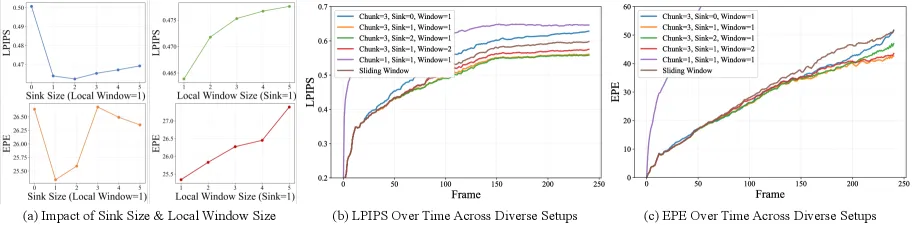
意外发现:最小配置(单 chunk 汇聚 + 单 chunk 窗口)达到最佳性能。额外的汇聚只提供边际改进,可能引入冗余上下文。
延迟-吞吐量分析
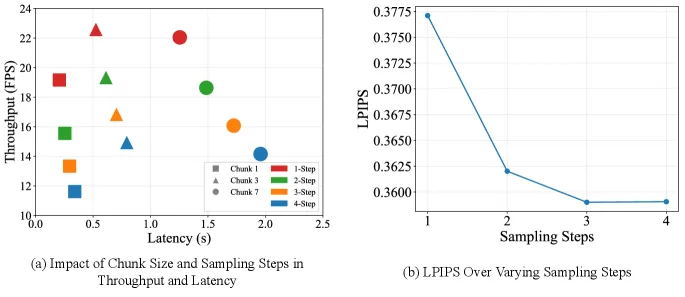
小 chunk 导致低吞吐量,大 chunk 引入过高延迟。Chunk size = 3 是最优配置。
六、实现细节
| 配置 | 值 |
|---|---|
| 基础模型 | Wan 2.1 (1.3B), Wan 2.2 (5B) |
| 训练数据 | OpenVid-1M + 合成数据 (70K/30K samples) |
| 分辨率 | 480P (832×480), 720P (1280×704) |
| 去噪步数 | 4 步 |
| Chunk Size | 3 latent frames |
| 注意力汇聚 | 1 chunk |
| 局部窗口 | 1 chunk |
| 教师模型训练 | Rectified Flow Matching |
| 学生蒸馏 | Self Forcing + DMD |
| Tiny VAE | 9.84M 参数(vs Full VAE 73.3M) |
Tiny VAE
| 模型 | 解码器参数 | 压缩率 | 解码时间 (s) | PSNR | SSIM |
|---|---|---|---|---|---|
| Full VAE (Wan 2.1) | 73.3M | 8×8×4 | 1.67 | 31.43 | 0.934 |
| Tiny VAE (社区版) | 9.84M | 8×8×4 | 0.12 | 28.85 | 0.899 |
| Tiny VAE (本文) | 9.84M | 8×8×4 | 0.12 | 29.27 | 0.904 |
| Full VAE (Wan 2.2) | 555M | 16×16×4 | 1.75 | 31.87 | 0.938 |
| Tiny VAE (Wan 2.2) | 56.7M | 16×16×4 | 0.23 | 28.43 | 0.883 |
Tiny VAE 解码速度提升 14×(1.67s → 0.12s),质量损失很小。
七、与现有方法对比
| 方法 | 类型 | FPS | 延迟 | 运动控制 | 流式 | 长视频 |
|---|---|---|---|---|---|---|
| Motion Prompting | 双向扩散 | <0.01 | 12min | 2D 轨迹 | × | × |
| Image Conductor | 双向扩散 | 2.98 | - | 运动迁移 | × | × |
| ATI | 双向扩散 | 0.23 | - | 运动迁移 | × | × |
| Go-With-The-Flow | 双向扩散 | 0.60 | - | 运动迁移 | × | × |
| Self Forcing | 因果蒸馏 | 15.38 | 0.78s | 文本 | ✓ | 有限 |
| Rolling Forcing | 因果蒸馏 | 15.79 | 0.76s | 文本 | ✓ | 有限 |
| MotionStream | 因果蒸馏 | 29.5 | 0.39s | 2D轨迹+相机 | ✓ | 无限 |
独特优势:
- 唯一支持实时运动控制的流式视频生成方法
- 29 FPS(带 Tiny VAE),比 Motion Prompting 快 2000×+
- 支持无限长度流式生成
- 同时支持轨迹控制和相机控制
八、相关工作
| 方向 | 代表工作 | 与 MotionStream 的关系 |
|---|---|---|
| 运动控制视频 | Motion Prompting, ATI, Image Conductor | 教师模型的基线 |
| AR 视频扩散 | Self Forcing, CausVid, Rolling Forcing | 因果蒸馏的基线 |
| 相机控制 | CameraCtrl, SEVA, ViewCrafter | 相机控制任务的基线 |
| 交互式世界模型 | GameNGen, Oasis | 同类实时交互系统 |
| 流式生成 | StreamingT2V, InfinityStream | 同类流式方法 |
九、总结
核心贡献
- 实时交互式运动控制:首个支持实时 2D 轨迹/相机控制的流式视频生成方法
- 轻量级轨迹编码:正弦 PE + 可学习 track head,比 ControlNet 更高效
- 联合文本-运动引导:兼顾轨迹精度和自然运动
- 注意力汇聚 + 自滚动:解决长视频外推的域差距和误差累积问题
- Tiny VAE:解码速度提升 14×,使实时流式成为可能
- 29 FPS 实时生成:单 GPU,支持无限长度流式
技术影响
- 比 Motion Prompting 快 2000×+,首次实现实时运动控制交互
- 1.3B 模型超越 14B 模型(ATI)在运动迁移任务上的表现
- 在相机控制任务上以 16.7 FPS 超越专用 3D 方法(DepthSplat, ViewCrafter)
- 注意力汇聚机制在视频扩散模型中的成功应用
- Tiny VAE 为流式生成提供了关键的速度优化
局限性
- 代码未公开
- 轨迹控制需要预先估计深度(用于相机控制)
- 某些复杂意图(如”把猫从盒子里拿出来”)难以通过轨迹表达
- Tiny VAE 有一定质量损失(PSNR 31.43 → 29.27)
十、参考资源
- 论文: arXiv:2511.01266
- 关键引用:
- Wan 2.1/2.2 (Wang et al., 2025a) — 基础视频扩散模型
- Self Forcing (Huang et al., 2025b) — 因果蒸馏基线
- Motion Prompting (Geng et al., 2025) — 运动控制基线
- CausVid (Yin et al., 2025) — 因果适应初始化
- DMD (Yin et al., 2024b) — 分布匹配蒸馏
- StreamingLLM (Xiao et al., 2023) — 注意力汇聚机制
分析日期: 2026-06-05