Cosmos-Predict2.5: World Simulation with Video Foundation Models for Physical
NVIDIA Cosmos世界基础模型2.5代:面向Physical AI的视频世界仿真
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | World Simulation with Video Foundation Models for Physical AI |
| 作者 | NVIDIA (80+作者,包括Jan Kautz, Ming-Yu Liu, Sanja Fidler等) |
| 论文 | https://arxiv.org/abs/2511.00062 |
| 代码 | https://github.com/nvidia-cosmos/cosmos-predict2.5, https://github.com/nvidia-cosmos/cosmos-transfer2.5 |
| 发布 | 2025-10-28 (v1), 2026-02-24 (v2) |
| 许可 | CC BY 4.0 (NVIDIA Open Model License) |
| 类别 | cs.CV, cs.AI, cs.LG, cs.RO |
核心亮点
- 统一世界生成:单模型统一Text2World、Image2World、Video2World
- Flow Matching架构:基于流的扩散模型,替代Cosmos-Predict1的EDM
- Cosmos-Reason1 VLM:替换T5文本编码器,提供更丰富的文本表示
- 200M视频训练:从35M小时原始视频中筛选200M高质量片段
- RL后训练:基于VideoAlign奖励模型的GRPO强化学习
- 2B和14B模型:开源发布,14B与Wan2.2 27B-A14B性能相当
- Cosmos-Transfer2.5:ControlNet风格的Sim2Real/Real2Real世界翻译,比Transfer1小3.5x但更优
二、核心思想
问题定义
Physical AI系统(配备传感器和执行器的具身智能体)需要与环境交互来完成物理任务。直接在真实世界中训练这些系统往往缓慢、昂贵且危险——特别是在早期阶段,系统缺陷可能导致不安全动作,损害智能体或环境。一个能够根据Physical AI智能体动作生成高质量、多样化视觉环境的世界仿真器,可以作为物理世界的安全代理。
解决方案概述
Cosmos-Predict2.5通过三个关键改进超越Cosmos-Predict1:
- 数据升级:更强的数据过滤管道 + 专门策划的Physical AI后训练数据
- 架构简化:统一Text2World/Image2World/Video2World为单一模型
- 训练改进:模型合并 + 新型RL算法 + Cosmos-Reason1 VLM替换T5
Cosmos-Predict2.5系列模型:
| 模型 | 能力 | 输入 |
|---|---|---|
| Cosmos-Predict2.5-2B/14B [pre-trained] | 预训练基座 | text + image/video |
| Cosmos-Predict2.5-2B/14B [post-trained] | 后训练基座 | text + image/video |
| Cosmos-Predict2.5-2B/auto/multiview | 驾驶7相机视角 | text + image/video |
| Cosmos-Predict2.5-2B/robot/action-cond | 机器人动作条件 | action |
| Cosmos-Transfer2.5-2B/general | ControlNet | edge/blur/seg/depth |
| Cosmos-Transfer2.5-2B/auto/multiview | 驾驶多视角 | world scenario map |
| Cosmos-Transfer2.5-2B/robot/multiview | 机器人3相机 | text + video |
三、技术架构
3.1 数据策划流水线
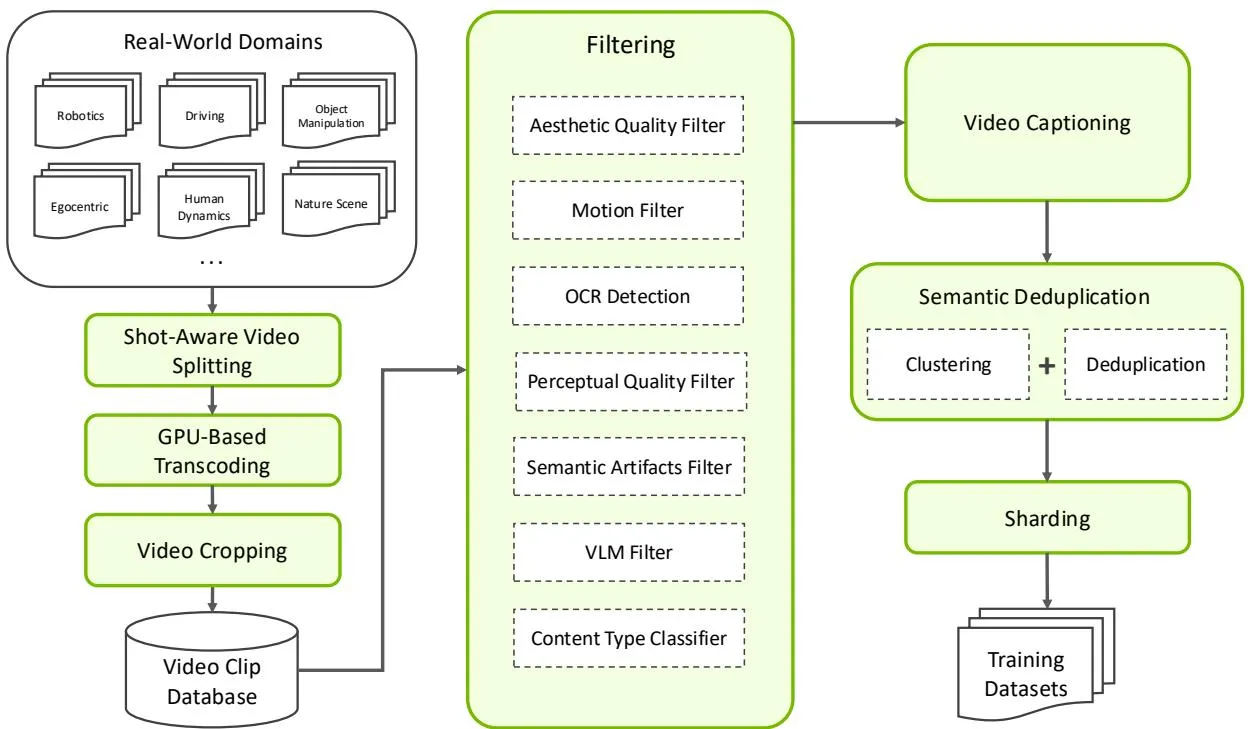
Figure 1: 视频策划流水线,将原始非结构化视频数据转化为高质量、标注、去重、分片的训练数据集。
七阶段流水线:
- 镜头感知视频分割:高精度边界检测模型
- GPU转码:GPU加速转码
- 视频裁剪:消除黑边和空间填充
- 多阶段过滤:
- 美学评分过滤
- 运动过滤
- OCR检测(去除文字覆盖)
- 感知质量过滤(类似DOVER)
- 语义伪影过滤(类似VTSS)
- VLM过滤(高精度最终过滤)
- 视频描述:Qwen2.5-VL-7B生成多长度描述
- 语义去重:基于嵌入的聚类 + 在线去重策略
- 分片:按内容类型/分辨率/宽高比/长度分片
数据规模:
- 原始视频:35M小时(Cosmos-Predict1为20M小时)
- 剪辑片段:60亿+
- 通过筛选:~200M片段(通过率仅4%,Predict1为30%)
领域特定数据:
| 领域 | 数据来源 | 关键特点 |
|---|---|---|
| 机器人 | AgiBot-Beta, Bridge, DROID, GR00T等 | 双臂/单臂,多视角 |
| 自动驾驶 | NVIDIA内部平台 | 3.1M 20秒7相机视频 |
| 智能空间 | 仓库/工厂/建筑工地 | ~40K视频片段 |
| 人体动态 | YOLOX检测+RTMPose姿态 | 关注人体运动 |
| 物理 | 经典力学/流体力学现象 | 物理合理性 |
3.2 模型架构
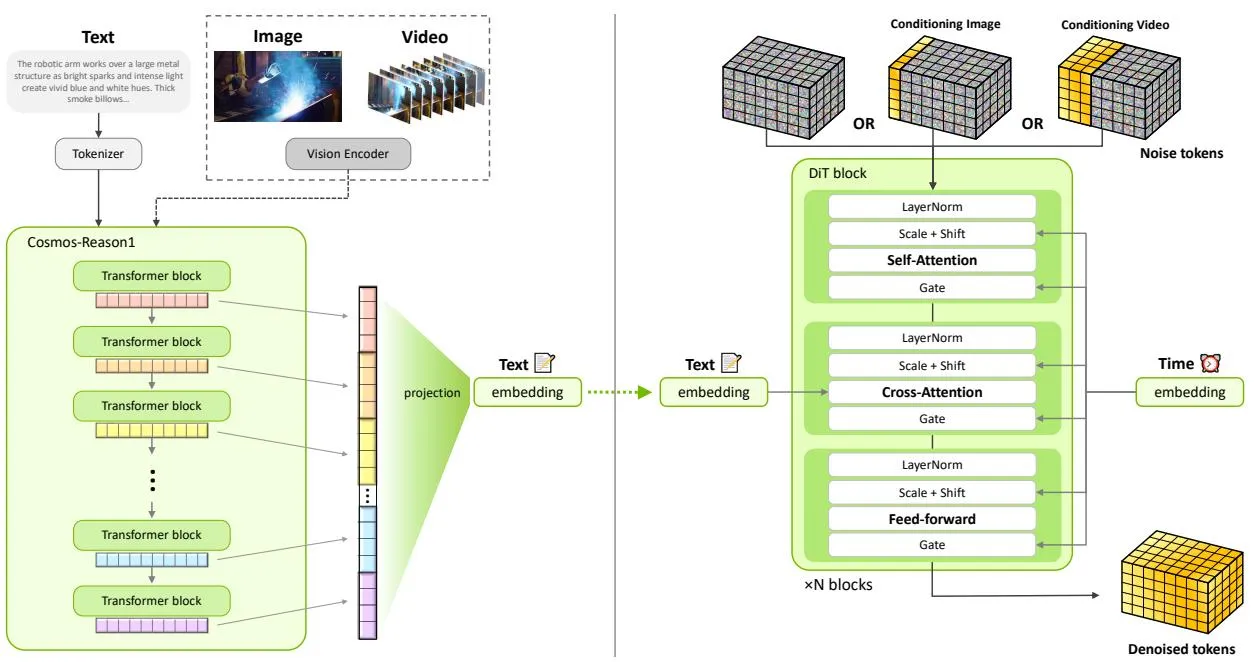
Figure 2: Cosmos-Predict2.5整体架构。在潜在空间中,模型应用重复的DiT块,支持Text2World、Image2World和Video2World的统一生成。
3.3 Flow Matching
核心公式:
插值潜在变量: \mathbf{x}_t = (1-t)\mathbf{x} + t\epsilon \tag{1}
其中 是数据样本,,。
真实速度: \mathbf{v}_t = \epsilon - \mathbf{x} \tag{2}
训练目标(MSE损失): \mathcal{L}(\theta) = \mathbb{E}_{\mathbf{x},\epsilon,\mathbf{c},t} \left\| \mathbf{u}(\mathbf{x}_t, t, \mathbf{c}; \theta) - \mathbf{v}_t \right\|^2 \tag{3}
其中 是条件信息(文本嵌入、参考帧等), 是模型参数。
偏移Logit-Normal分布(向高噪声偏移): t_s = \frac{\beta t}{1+(\beta-1)t} \tag{4}
其中 是偏移超参数, 时无偏移。
Table 3: Cosmos-Predict2.5模型配置
| 参数 | 2B模型 | 14B模型 |
|---|---|---|
| DiT层数 | 16 | 48 |
| 隐藏维度 | 1536 | 5120 |
| 注意力头数 | 12 | 32 |
| FFN维度 | 4096 | 13824 |
| 上下文并行度 | 2 | 8 |
3.4 训练流程
预训练
- 数据:200M策划视频片段
- 分辨率:720p
- 帧数:93帧
- 硬件:4096 NVIDIA H100 GPU
- MFU:2B模型36.49%,14B模型33.08%
后训练
三阶段后训练:
| 阶段 | 方法 | 说明 |
|---|---|---|
| 1. SFT | 领域微调 + 模型合并 | 领域特定SFT + Model Soup合并 |
| 2. RL | GRPO + VideoAlign | 奖励模型引导的强化学习 |
| 3. 蒸馏 | rCM一致性蒸馏 | 4步推理,质量接近教师模型 |
RL后训练细节:
- 奖励模型:VideoAlign(评估文本对齐、运动质量、视觉质量)
- 算法:GRPO,每个输入条件生成8个输出,20步扩散
- 批大小:32,训练256步
- 正则化:扩散损失防止奖励黑客
Table 6: RL前后奖励对比
| 模型 | T2W Text Align | T2W Motion | T2W Visual | T2W Sum |
|---|---|---|---|---|
| Predict2.5-2B [pre-train] | 1.55 | -0.43 | -0.05 | 1.08 |
| + RL | 1.69 | -0.19 | 0.19 | 1.69 |
| Predict2.5-2B [merged] | 1.69 | -0.46 | -0.01 | 1.23 |
| + RL | 1.75 | -0.18 | 0.18 | 1.74 |
蒸馏结果:
| 模型 | Domain Score | Quality Score | Overall Score |
|---|---|---|---|
| Predict2.5-2B [teacher] | 0.804 | 0.732 | 0.768 |
| Predict2.5-2B [distilled] | 0.797 | 0.731 | 0.764 |
4步推理即可达到接近教师模型的质量。
3.5 基础设施优化
| 优化项 | 说明 |
|---|---|
| FSDP2 | 按参数分片,更细粒度内存管理 |
| 上下文并行 | Ulysses风格,支持NATTEN稀疏注意力和JVP |
| 选择性激活检查点 | 轻量算子优先重计算 |
| 弹性奖励服务 | 异步奖励计算,CUDA IPC零拷贝 |
四、实验结果
4.1 PAI-Bench评估
Table 10: PAI-Bench-Predict-Text2World
| 模型 | Domain Score | Quality Score | Overall Score |
|---|---|---|---|
| Predict2.5-2B [pre-train] | 0.782 | 0.720 | 0.751 |
| Predict2.5-2B [post-train] | 0.804 | 0.732 | 0.768 |
| Predict2.5-14B [post-train] | 0.803 | 0.732 | 0.768 |
| Wan2.1-14B | 0.794 | 0.727 | 0.761 |
| Wan2.2-5B | 0.797 | 0.730 | 0.764 |
| Wan2.2-27B-A14B | 0.810 | 0.728 | 0.769 |
Table 11: PAI-Bench-Predict-Image2World
| 模型 | Domain Score | Quality Score | Overall Score |
|---|---|---|---|
| Predict2.5-2B [pre-train] | 0.824 | 0.775 | 0.799 |
| Predict2.5-2B [post-train] | 0.840 | 0.779 | 0.810 |
| Predict2.5-14B [post-train] | 0.838 | 0.781 | 0.810 |
| Wan2.2-27B-A14B | 0.841 | 0.772 | 0.806 |
4.2 人类评估
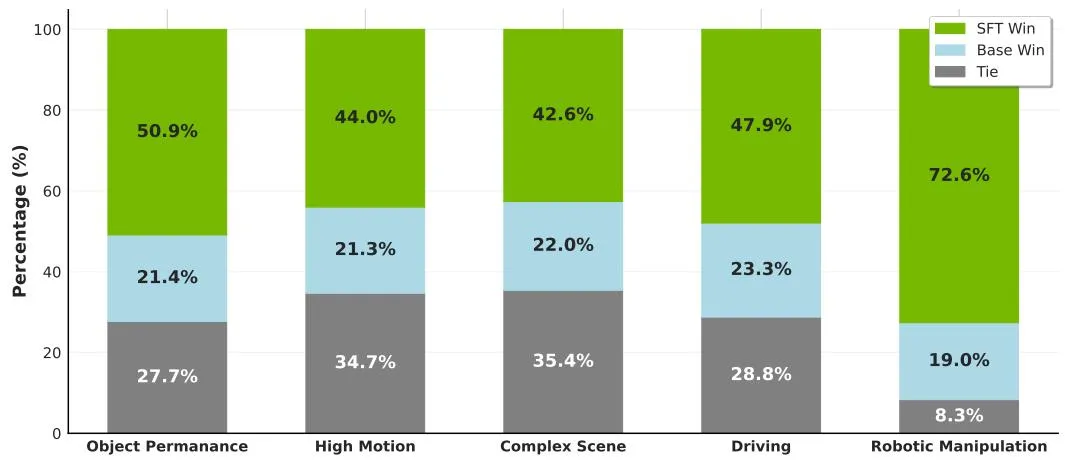
Figure 3: 领域特定SFT训练在各领域提升预训练模型性能。
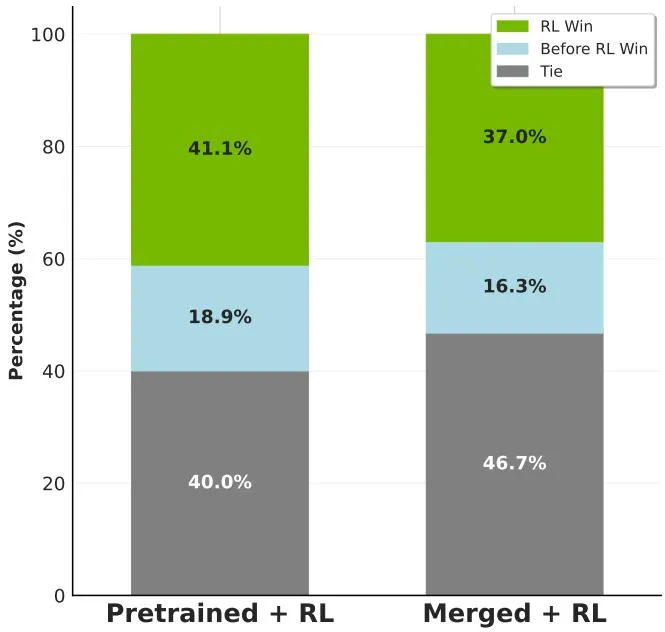
Figure 5: 人类投票显示RL能有效提升生成视频质量。
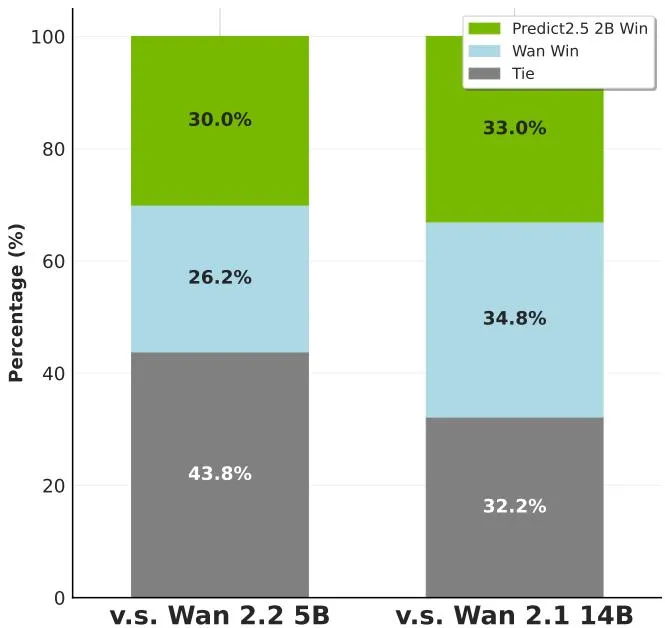
Figure 6: 尽管尺寸更小,后训练的Cosmos-Predict2.5-2B在人类投票中比Wan2.2 5B更受偏好(30.0% vs 26.2%),与Wan2.1 14B相当(33.0% vs 34.8%)。
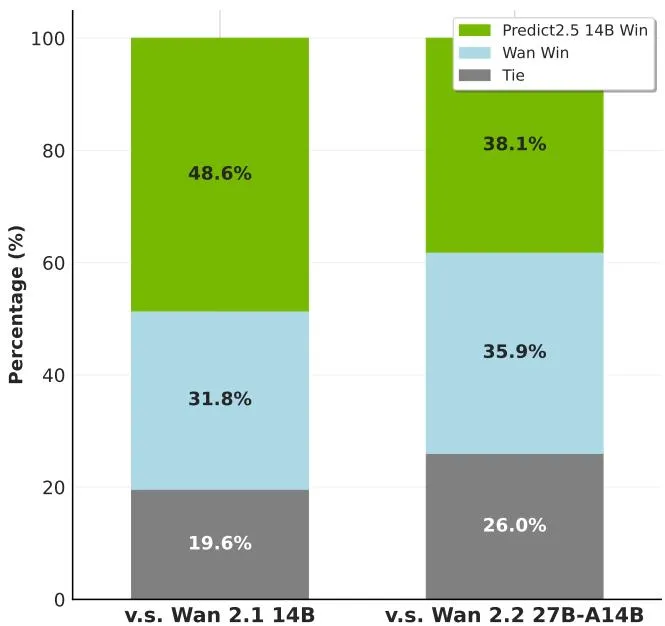
Figure 7: 后训练的14B模型比Wan2.1 14B更受偏好(48.6% vs 31.8%),与Wan2.2 27B-A14B性能相当(38.1% vs 35.9%),尽管参数量只有一半。
4.3 Cosmos-Transfer2.5结果
Table 12: Transfer模型定量评估
| 模型 | Blur SSIM↑ | Edge F1↑ | Depth si-RMSE↓ | Mask mIoU↑ | Quality↑ |
|---|---|---|---|---|---|
| Transfer1-7B Uniform | 0.82 | 0.26 | 0.70 | 0.74 | 9.24 |
| Transfer2.5-2B Uniform | 0.87 | 0.41 | 0.67 | 0.76 | 9.31 |
关键:Transfer2.5-2B比Transfer1-7B更优,尽管小3.5倍。
4.4 机器人策略学习
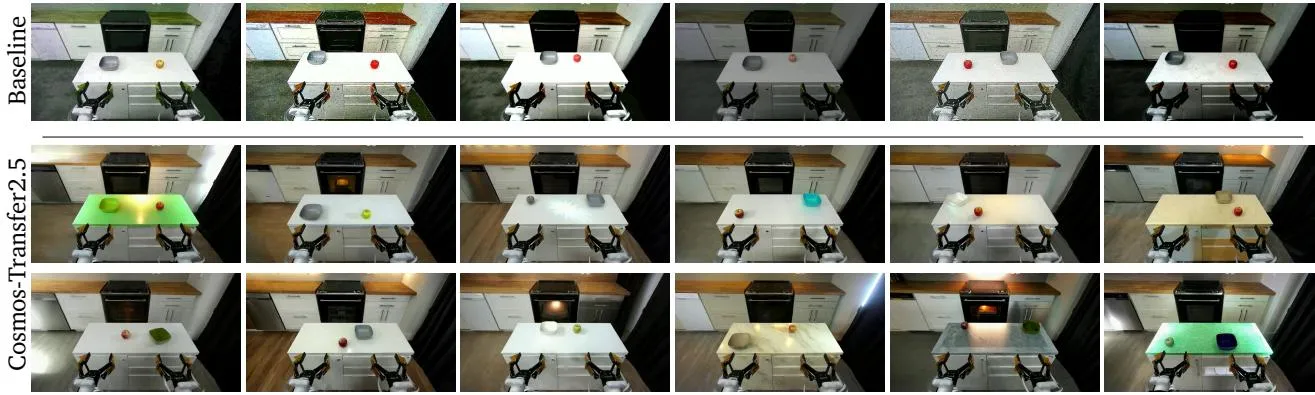
Figure 12: 真实机器人数据增强。顶行为基线,底两行为Cosmos-Transfer2.5-2B生成的多样化合成视频。
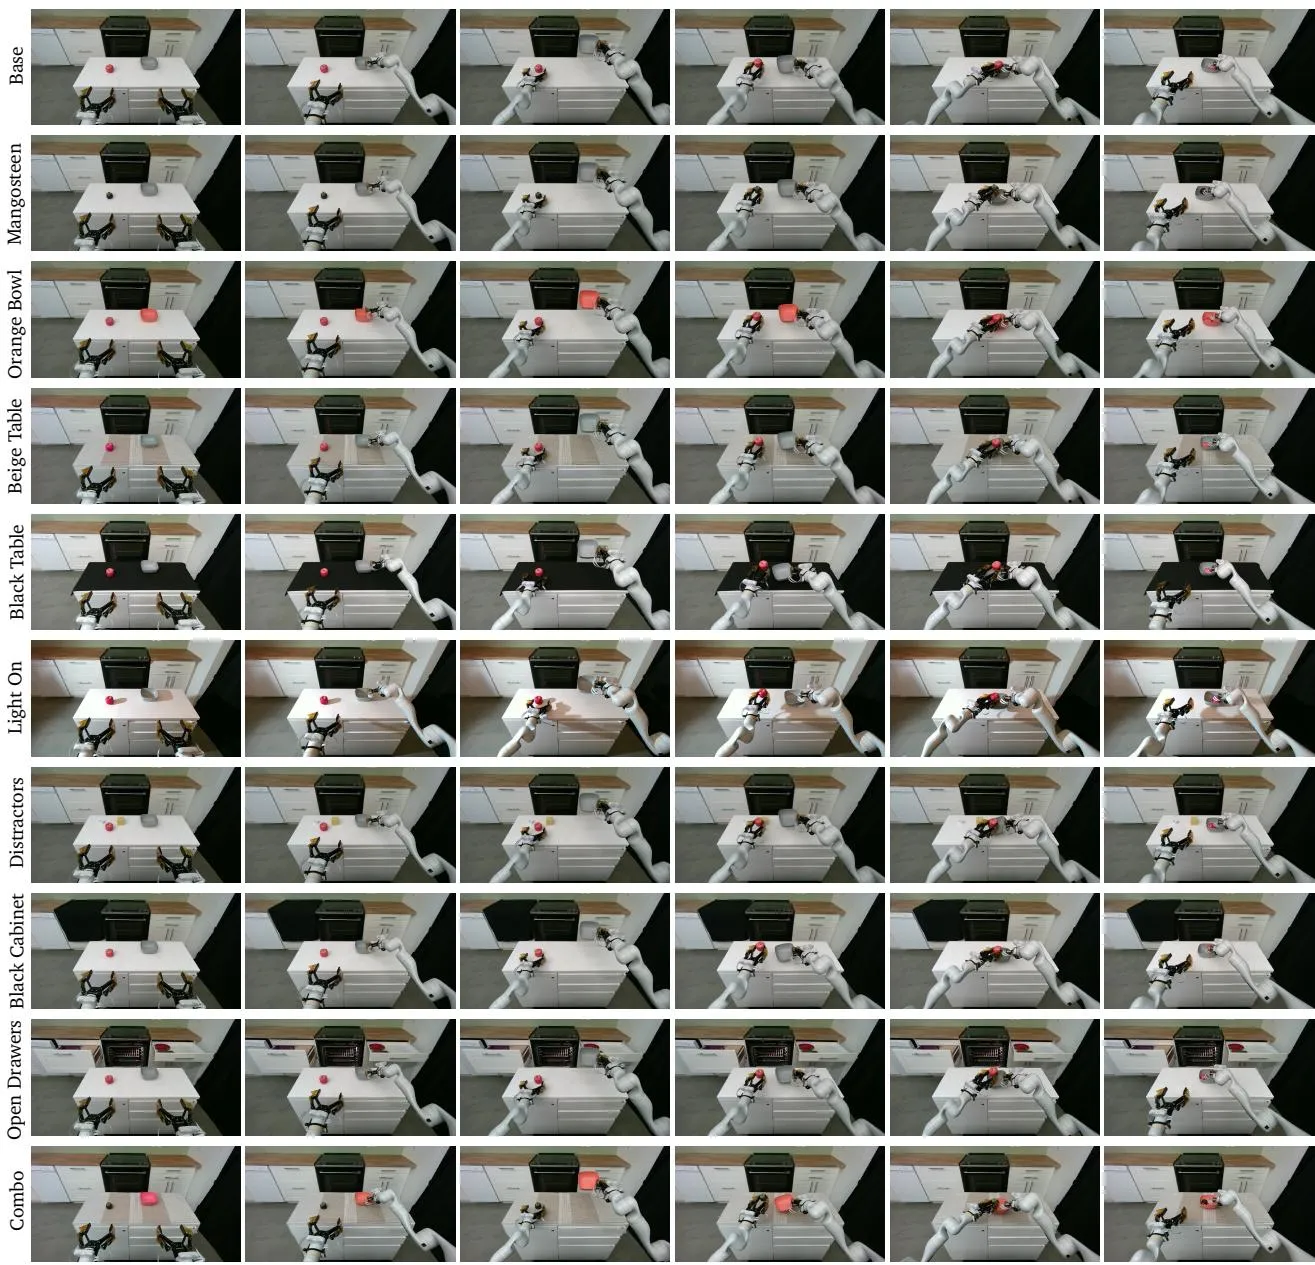
Figure 13: Cosmos-Transfer2.5真实机器人策略展开。展示基础设置和9个未见测试场景的成功执行。
Table 13: 真实机器人定量评估
| Base | Mangosteen | Orange Bowl | Beige Table | Black Table | Light On | Distractors | Black Cabinet | Open Drawers | Combo | Total | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Base | 1/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 1/30 |
| Baseline | 3/3 | 0/3 | 2/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 5/30 |
| Proposed | 3/3 | 3/3 | 3/3 | 1/3 | 1/3 | 2/3 | 3/3 | 2/3 | 3/3 | 3/3 | 24/30 |
关键发现:Cosmos-Transfer2.5增强的策略在10个测试场景中成功24/30次,远超基线(5/30)和基础策略(1/30)。
4.5 长视频生成
RNDS(相对归一化Dover分数)评估长视频质量退化:
| 控制模态 | Transfer1-7B (20 chunks) | Transfer2.5-2B (20 chunks) |
|---|---|---|
| Edge | ~0.75 | ~0.99 |
| Blur | ~0.78 | ~0.97 |
| Depth | ~0.50 | ~1.23 |
| Segmentation | ~0.46 | ~1.23 |
Transfer2.5-2B在所有控制模态上展现出显著更少的误差累积。
4.6 定性示例
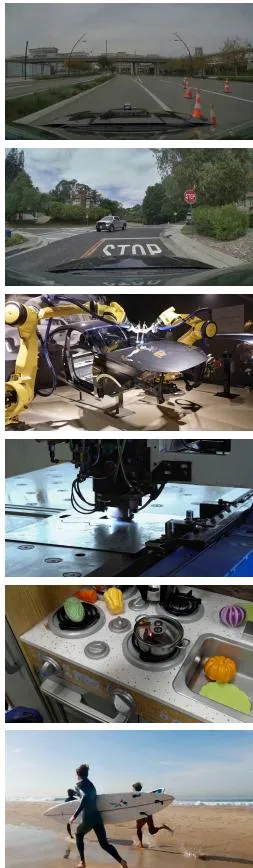
Figure 8: Cosmos-Predict2.5-2B后训练模型在PAI-Bench数据集上的预测样本,展示驾驶、工业和机器人场景的物理一致性生成。
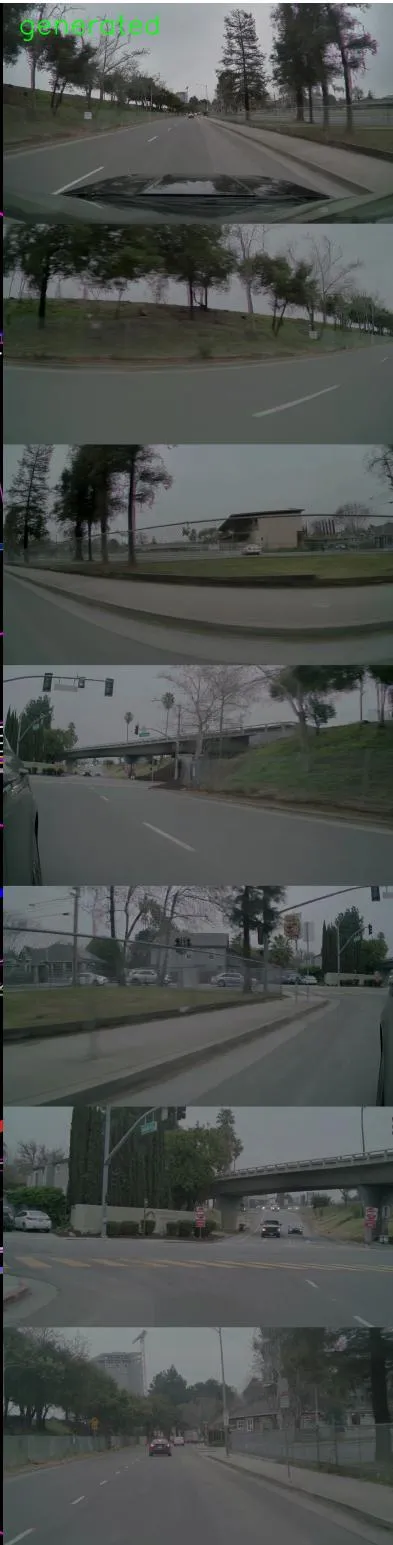
Figure 14: Cosmos-Transfer2.5-2B/auto/multiview生成的多视角720p控制视频,用于驾驶仿真。
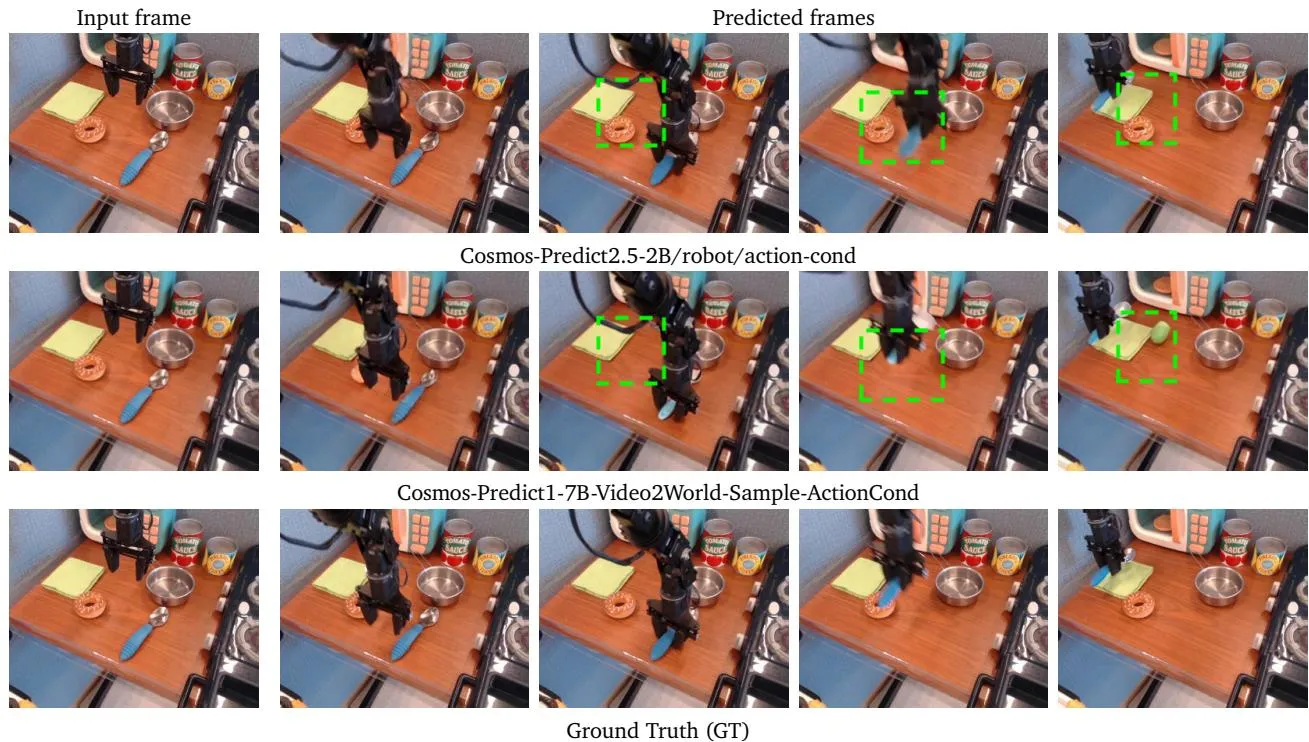
Figure 20: Bridge数据集上的动作条件视频预测,Cosmos-Predict2.5-2B/robot/action-cond的预测展开对比。
五、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| 统一多任务架构 | 单模型统一Text2World/Image2World/Video2World | 简化部署,共享表示 |
| Flow Matching | 速度预测参数化,偏移logit-normal分布 | 更平滑优化,更好样本质量 |
| Cosmos-Reason1 VLM | 替换T5文本编码器 | 更丰富文本表示,更细粒度控制 |
| RL后训练 (GRPO) | VideoAlign奖励 + 扩散损失正则化 | 奖励提升0.6+,人类偏好显著提升 |
| 模型合并 (Model Soup) | 领域SFT后简单平均合并 | 最佳性能-复杂度平衡 |
| rCM蒸馏 | 4步推理达到教师模型质量 | 推理加速5x |
| Transfer2.5分布式控制 | 每7个主块后插入1个控制块 | 更渐进的条件集成 |
| 数据筛选4%通过率 | 7阶段严格过滤 | 高质量训练数据 |
六、应用领域
6.1 机器人仿真
- 真实机器人数据增强(Real2Real)
- 策略评估和鲁棒性测试
- 多视角机器人世界生成
6.2 自动驾驶仿真
- 7相机720p多视角生成
- 世界场景图条件控制
- 长视频一致性生成
6.3 合成数据生成
- VLA训练数据生成
- 动作条件世界生成
- 跨域视觉增强
6.4 Sim2Real/Real2Real翻译
- 物理仿真器输出增强
- 真实视频增强
- 语义到真实世界转换
七、总结
核心贡献
- Cosmos-Predict2.5:首个统一Text2World/Image2World/Video2World的开源世界基础模型
- Cosmos-Transfer2.5:比前代小3.5x但更优的ControlNet风格世界翻译模型
- 大规模数据策划:35M小时→200M片段的严格筛选流水线
- RL后训练:基于VideoAlign的GRPO强化学习,显著提升视频质量
- 4步蒸馏推理:rCM一致性蒸馏实现高效推理
- 多领域应用:机器人、自动驾驶、智能空间、人体动态、物理
- 完全开源:代码、模型权重、策划基准
技术影响
- Physical AI民主化:开源模型降低具身智能研究门槛
- 世界仿真器范式:从物理仿真器到视频世界模型的转变
- 合成数据规模化:为VLA训练提供大规模合成数据
- 跨域迁移:Sim2Real和Real2Real的统一框架
局限性
- 物理一致性:视频生成模型仍可能违反物理规律
- 长视频质量:尽管改进,超长视频仍有误差累积
- 计算资源:14B模型训练需要4096 H100 GPU
- 控制精度:多模态控制的精确对齐仍有提升空间
- 动态交互:复杂物理交互(碰撞、流体)的建模仍具挑战
八、参考资源
- 论文: https://arxiv.org/abs/2511.00062
- Predict2.5代码: https://github.com/nvidia-cosmos/cosmos-predict2.5
- Transfer2.5代码: https://github.com/nvidia-cosmos/cosmos-transfer2.5
- PAI-Bench: Physical AI评估基准
- VideoAlign: VLM奖励模型
- Cosmos-Predict1: 前代世界基础模型