Rolling Forcing: Autoregressive Long Video Diffusion in Real Time
实时自回归长视频扩散生成技术
Rolling Forcing: Autoregressive Long Video Diffusion in Real Time
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Rolling Forcing: Autoregressive Long Video Diffusion in Real Time |
| 作者 | Kunhao Liu, Wenbo Hu, Jiale Xu, Ying Shan, Shijian Lu |
| 论文 | arXiv:2509.25161 |
| 代码 | 未公开 |
| 发布 | 2025年9月29日 |
二、核心思想
问题定义
流式视频生成是交互式世界模型和神经游戏引擎的基础组件,目标是生成高质量、低延迟、时间一致的长视频流。然而,现有方法存在严重的误差累积 (error accumulation) 问题,显著降低了长视频流的生成质量。
现有方法的局限:
- CausVid / Self Forcing:逐帧去噪的严格因果方式,单帧误差会传播到后续所有帧
- SkyReels-V2 (Diffusion Forcing):通过破坏历史帧来缓解误差累积,但效果有限
- MAGI-1:大规模模型(4.5B参数),但延迟极高(282秒),无法实时
解决方案概述
本文设计 Rolling Forcing,一种新型视频生成技术,通过三个关键设计实现实时流式长视频生成,同时最小化误差累积:
- 滚动扩散窗口 (Rolling Diffusion Window):联合去噪多帧,帧间噪声等级渐进增加,放松严格因果性
- 注意力汇聚机制 (Attention Sink):缓存初始帧的 KV 状态作为全局上下文锚点
- 高效训练算法:在扩展的去噪窗口上实现少步蒸馏
关键创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 滚动扩散窗口 | 联合去噪多帧,帧间噪声渐进增加 | 相邻帧互相精炼,抑制误差传播 |
| 注意力汇聚 | 缓存初始帧 KV 作为全局锚点 | 增强长程全局一致性 |
| 非重叠窗口训练 | 避免暴露偏差,支持扩展窗口 | 缓解自生成历史的条件偏差 |
| 混合训练策略 | DMD + Self Forcing 双目标 | 提升运动自然度和一致性 |
三、技术架构
整体框架图
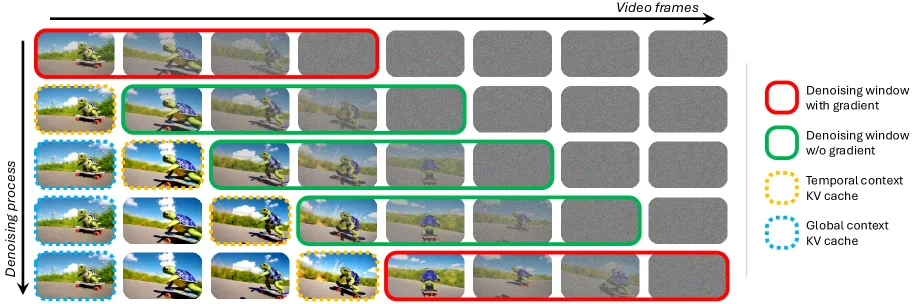
核心公式
自回归视频扩散模型基础
给定视频帧序列 ,联合分布通过链式法则分解:
每个条件分布通过去噪扩散建模:。
滚动扩散窗口
Self Forcing 的逐帧去噪:在每个去噪步骤 和帧索引 ,模型仅去噪单帧:
Rolling Forcing 的窗口去噪:扩展为多帧滚动窗口,窗口长度 :
其中 是窗口内的噪声帧,噪声等级从 到 渐进增加。
DMD 损失
标准 DMD 损失(逐帧):
Rolling Forcing 的 DMD 损失(窗口级):
其中选择每个窗口的第 帧作为预测,。
非重叠窗口训练
为降低计算复杂度,采用非重叠窗口策略:
计算复杂度从 降为 。
历史上下文机制
时间上下文:缓存最近 帧的 KV 状态
全局上下文(注意力汇聚):缓存初始 帧的 KV 状态作为全局锚点
配置:, , latent frames
噪声调度
采用修正的噪声调度:
去噪窗口的噪声等级:
模型参数化:
其中 , 。
不同范式对比
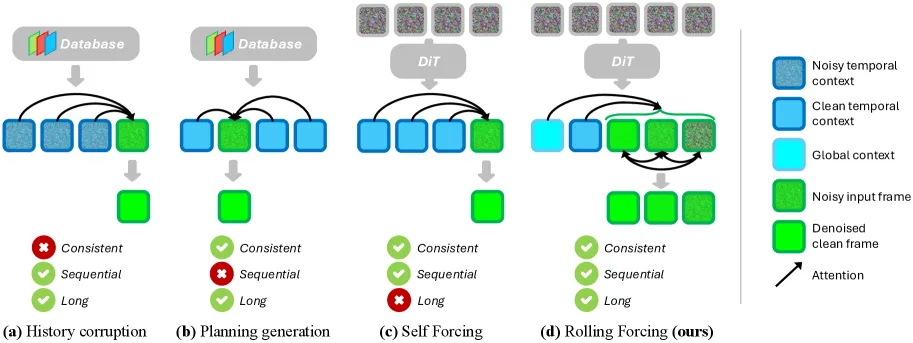
| 范式 | 方法 | 特点 |
|---|---|---|
| (a) Teacher Forcing | 基础训练 | 条件于干净历史帧 |
| (b) Diffusion Forcing | SkyReels-V2 | 条件于噪声历史帧 |
| (c) Self Forcing | CausVid, Self Forcing | 逐帧去噪,严格因果 |
| (d) Rolling Forcing | 本文 | 滚动窗口联合去噪 |
四、核心能力
实时流式生成
- 帧率:16 FPS 实时生成
- 延迟:0.76 秒(单 GPU)
- 时长:可生成多分钟长视频
- 硬件:单 GPU 即可
支持的应用场景
- 交互式世界模型:实时响应用户输入
- 神经游戏引擎:游戏画面实时生成
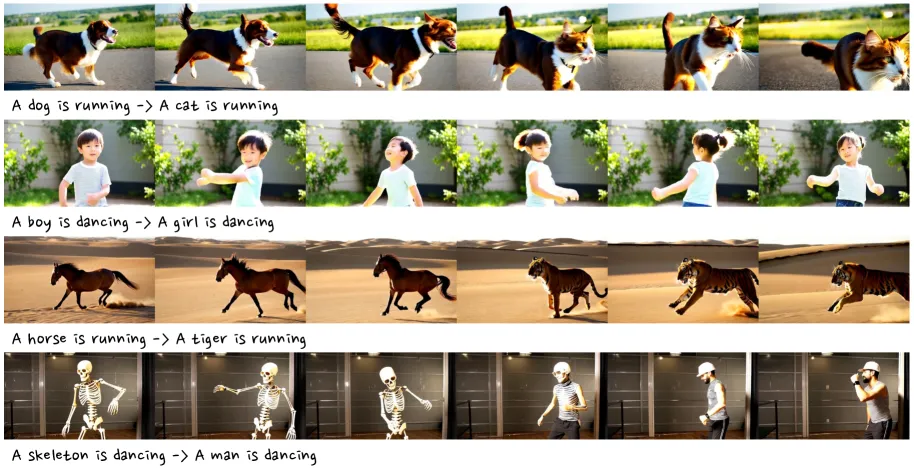
- 交互式视频流:用户可中途更改提示词引导视频方向
五、实验结果
主要定量对比(VBench)
| 模型 | 参数量 | 吞吐量 (FPS) ↑ | 延迟 (s) ↓ | Temporal Flickering ↑ | Subject Consistency ↑ | Background Consistency ↑ | Motion Smoothness ↑ | Aesthetic Quality ↑ | Imaging Quality ↑ | Δ Drift Quality ↓ |
|---|---|---|---|---|---|---|---|---|---|---|
| 双向视频扩散模型 | ||||||||||
| SkyReels-V2 | 1.3B | 0.49 | 112 | 97.43 | 89.23 | 93.45 | 98.76 | 61.55 | 62.90 | 5.59 |
| MAGI-1 | 4.5B | 0.19 | 282 | 98.21 | 90.86 | 93.25 | 99.20 | 59.91 | 59.87 | 2.15 |
| 蒸馏自回归模型 | ||||||||||
| CausVid | 1.3B | 15.38 | 0.78 | 96.84 | 87.99 | 89.99 | 98.09 | 60.95 | 66.38 | 2.18 |
| Self Forcing | 1.3B | 15.38 | 0.78 | 97.49 | 86.48 | 90.29 | 98.47 | 60.54 | 68.68 | 1.66 |
| Rolling Forcing (Ours) | 1.3B | 15.79 | 0.76 | 97.61 | 92.80 | 93.71 | 98.70 | 62.39 | 70.75 | 0.01 |
关键发现:
- Δ Drift Quality: Self Forcing 1.66 → Rolling Forcing 0.01(降低 99.4%),误差累积几乎消除
- Subject Consistency: 86.48 → 92.80(+6.32),主体一致性大幅提升
- Background Consistency: 90.29 → 93.71(+3.42),背景一致性显著提升
- 吞吐量: 15.79 FPS,略高于 Self Forcing (15.38)
- 甚至超越双向模型 SkyReels-V2 的 Subject Consistency (89.23 → 92.80)
VBench 完整质量评估
| 模型 | Subject Consistency | Background Consistency | Temporal Flickering | Motion Smoothness | Dynamic Degree | Aesthetic Quality | Imaging Quality | Quality Score |
|---|---|---|---|---|---|---|---|---|
| CausVid | 89.50 | 90.00 | 99.41 | 98.06 | 63.88 | 61.82 | 65.30 | 80.89 |
| Self Forcing | 88.61 | 89.53 | 98.90 | 98.57 | 68.05 | 60.60 | 68.98 | 81.39 |
| Rolling Forcing | 94.80 | 95.69 | 98.93 | 98.63 | 60.14 | 62.81 | 72.31 | 84.08 |
VBench 语义评估
| 模型 | Object Class | Multiple Objects | Human Action | Color | Spatial | Scene Style | Temporal Style | Appearance | Overall | Semantic |
|---|---|---|---|---|---|---|---|---|---|---|
| CausVid | 78.56 | 58.84 | 81.00 | 81.02 | 59.62 | 31.32 | 22.51 | 20.04 | 23.16 | 65.85 |
| Self Forcing | 80.06 | 62.88 | 83.00 | 79.80 | 74.76 | 30.59 | 23.78 | 20.41 | 24.80 | 69.17 |
| Rolling Forcing | 85.92 | 64.86 | 73.00 | 88.16 | 78.84 | 30.52 | 23.52 | 19.45 | 24.56 | 69.78 |
消融实验
| 模型 | Temp. Flick. ↑ | Subj. Cons. ↑ | Back. Cons. ↑ | Mot. Smooth. ↑ | Aes. Qual. ↑ | Img. Qual. ↑ | Δ Drift ↓ |
|---|---|---|---|---|---|---|---|
| w/o RF inference | 95.45 | 86.01 | 89.94 | 97.36 | 57.59 | 65.19 | 5.53 |
| w/o RF training | 95.91 | 87.50 | 90.86 | 98.05 | 60.41 | 69.24 | 0.89 |
| w/o SF training | 90.83 | 83.27 | 88.14 | 95.63 | 55.30 | 62.00 | 1.62 |
| w/o attention sink | 97.53 | 83.22 | 87.99 | 98.56 | 58.99 | 67.30 | 4.63 |
| Ours full | 97.61 | 92.80 | 93.71 | 98.70 | 62.39 | 70.75 | 0.01 |
消融发现:
- w/o RF inference:Δ Drift 从 0.01 飙升到 5.53,验证滚动窗口推理的关键作用
- w/o RF training:Δ Drift 从 0.01 升到 0.89,滚动窗口训练也有贡献
- w/o SF training:Subject Consistency 大幅下降 (92.80→83.27),Self Forcing 目标对运动自然度至关重要
- w/o attention sink:Subject Consistency 下降 (92.80→83.22),全局上下文对一致性很重要
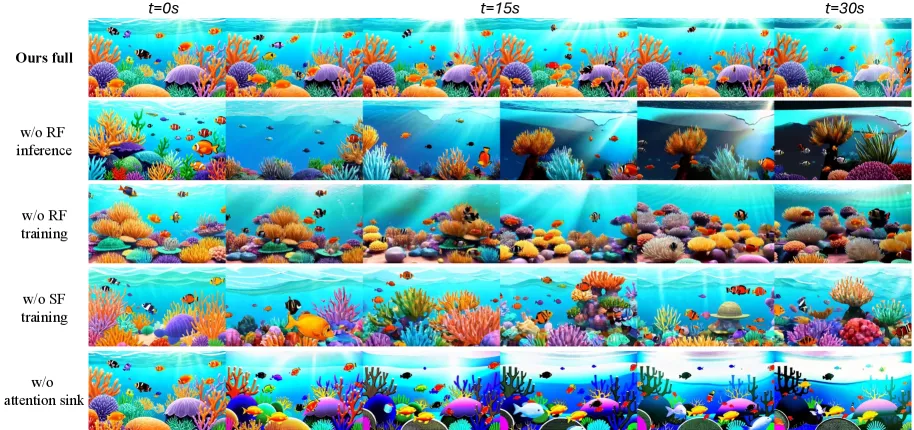
定性对比
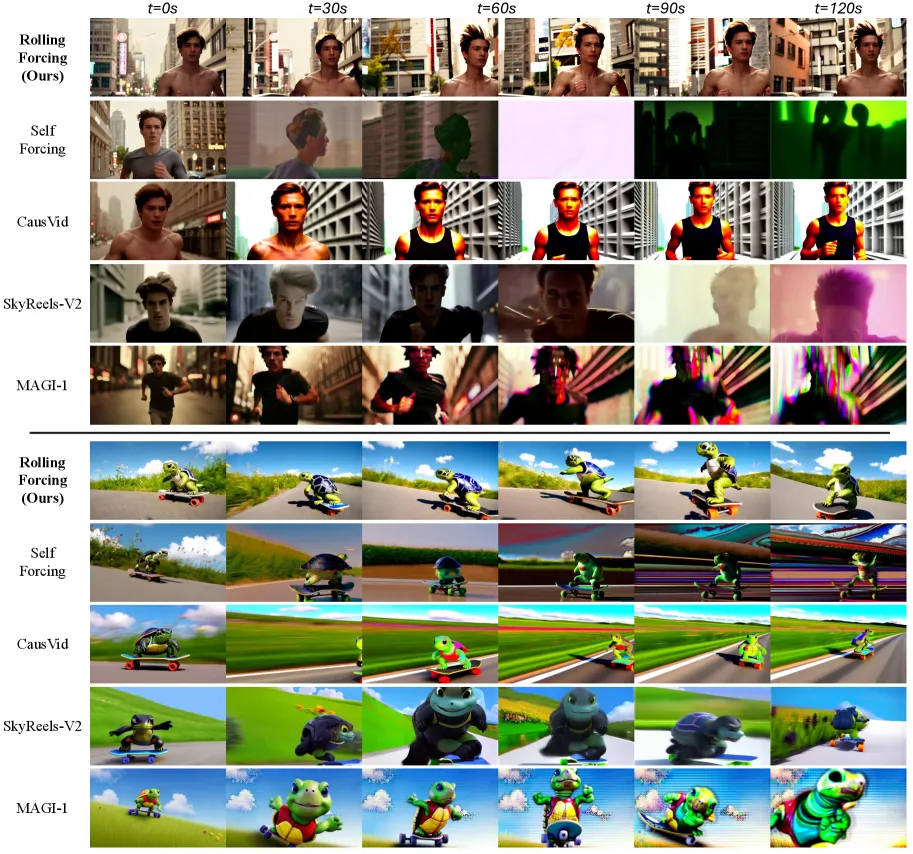
Rolling Forcing 在长时间生成中保持高保真度和时间一致性,而 Self Forcing 和 CausVid 出现明显的质量退化。
六、实现细节
| 配置 | 值 |
|---|---|
| 基础模型 | Wan2.1-T2V-1.3B |
| 分辨率 | 832 × 480 |
| 帧率 | 16 FPS |
| 生成时长 | 5 秒(评估),多分钟(流式) |
| 去噪步数 | 4 步 |
| 窗口大小 | latent frames |
| 时间上下文 | latent frames |
| 全局上下文 | latent frames |
| 噪声等级 | [1000, 800, 600, 400, 200] |
| 训练帧数 | 21-27 latent frames(随机采样) |
| DMD 学习率 | |
| SF 学习率 |
动态 RoPE
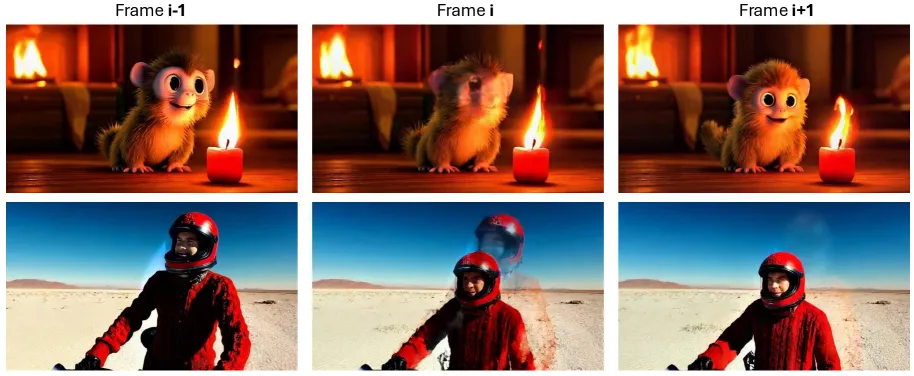
采用动态旋转位置编码 (Dynamic RoPE) 来处理流式生成中的位置索引。固定 RoPE 索引会导致严重的”跳跃”伪影(视频突然重置到初始帧)。
七、与现有方法对比
| 方法 | 类型 | 吞吐量 | 延迟 | Δ Drift | 主要局限 |
|---|---|---|---|---|---|
| SkyReels-V2 | 双向 DF | 0.49 FPS | 112s | 5.59 | 极慢,误差累积严重 |
| MAGI-1 | 双向 | 0.19 FPS | 282s | 2.15 | 极慢 |
| CausVid | 蒸馏 AR | 15.38 FPS | 0.78s | 2.18 | 误差累积 |
| Self Forcing | 蒸馏 AR | 15.38 FPS | 0.78s | 1.66 | 误差累积 |
| Rolling Forcing | 蒸馏 AR | 15.79 FPS | 0.76s | 0.01 | 几乎无误差累积 |
八、相关工作
| 方向 | 代表工作 | 与 Rolling Forcing 的关系 |
|---|---|---|
| 双向视频扩散 | Wan2.1, SkyReels-V2, MAGI-1 | 基础模型 |
| AR 视频扩散 | CausVid, Self Forcing | Rolling Forcing 的基线 |
| 扩散强制 | Diffusion Forcing (Chen et al., 2024) | 替代训练范式 |
| 流式生成 | StreamingT2V, InfinityStream | 同类工作 |
| 注意力汇聚 | StreamingLLM (Xiao et al., 2023) | 全局上下文机制的灵感来源 |
九、总结
核心贡献
- 滚动扩散窗口:联合去噪多帧,帧间噪声渐进增加,放松严格因果性,有效抑制误差累积
- 注意力汇聚机制:缓存初始帧 KV 状态作为全局上下文锚点,增强长程一致性
- 非重叠窗口训练:高效训练算法,支持扩展去噪窗口,避免暴露偏差
- 混合训练策略:DMD + Self Forcing 双目标,提升运动自然度
- 实时多分钟视频生成:单 GPU 16 FPS,延迟 0.76 秒,Δ Drift 仅 0.01
技术影响
- Δ Drift Quality 从 1.66 降至 0.01(降低 99.4%),几乎消除了长视频的误差累积问题
- 为交互式世界模型和神经游戏引擎提供了实用的实时视频生成方案
- 注意力汇聚机制可推广到其他流式生成任务
- 滚动窗口去噪范式为 AR 扩散模型提供了新的设计思路
局限性
- 中间帧离开时间上下文后被丢弃,模型不保留中间内容的记忆
- 训练 Rolling Forcing 需要较长的训练时间
- Dynamic Degree 指标略低于 Self Forcing (60.14 vs 68.05)
- 代码未公开
十、参考资源
- 论文: arXiv:2509.25161
- 关键引用:
- Wan2.1 (Wan et al., 2025) — 基础双向视频扩散模型
- Self Forcing (Huang et al., 2025) — 主要基线
- CausVid (Yin et al., 2025) — 早期 AR 蒸馏方法
- Diffusion Forcing (Chen et al., 2024) — 替代训练范式
- StreamingLLM (Xiao et al., 2023) — 注意力汇聚机制
- DMD (Yin et al., 2024b) — 分布匹配蒸馏
分析日期: 2026-06-05