LongLive: Real-time Interactive Long Video Generation
实时交互式长视频生成框架
LongLive: Real-time Interactive Long Video Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LongLive: Real-time Interactive Long Video Generation |
| 作者 | Shuai Yang, Wei Huang, Ruihang Chu, Yicheng Xiao, Yuyang Zhao, Xianbang Wang, Muyang Li, Enze Xie, Yingcong Chen, Yao Lu, Song Han, Yukang Chen |
| 论文 | arXiv:2509.22622 |
| 代码 | 承诺开源 |
| 发布 | 2025年9月26日(v2: 2025年10月13日) |
二、核心思想
问题定义
交互式长视频生成面临质量和效率双重挑战:
质量挑战:
- 切换用户提示时,保持视觉风格、运动连续性和场景布局的平滑过渡极其困难
- 微小的不匹配就会破坏叙事流和真实感
效率挑战:
- 扩散模型的双向注意力无法利用 KV 缓存,推理效率低
- 现有因果 AR 模型在长视频上训练困难,质量退化严重
- 需要支持流式提示输入,实时响应用户引导
解决方案概述
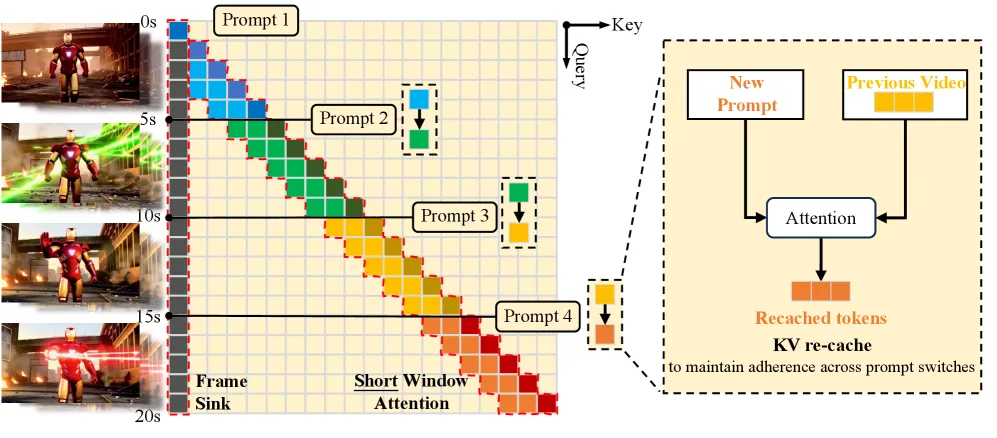
本文提出 LongLive,一个帧级自回归框架,实现分钟级实时交互式长视频生成:
- KV Recache:在提示切换时重新计算 KV 缓存,兼顾平滑过渡和提示遵循
- Streaming Long Tuning:流式长视频微调策略,训练-推理对齐(train-long-test-long)
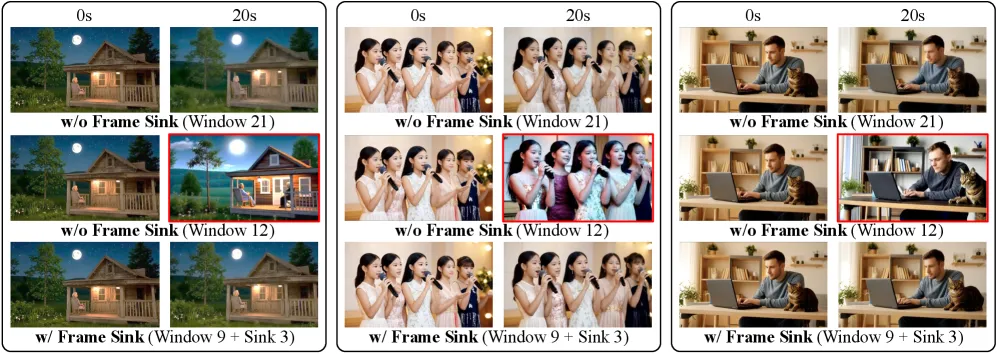
- Short-Window Attention + Frame Sink:短窗口注意力 + 帧级注意力汇聚,加速推理同时保持一致性
关键创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| KV Recache | 提示切换时用已生成帧+新提示重建 KV 缓存 | 平滑过渡+提示遵循,消除 train-inference 不匹配 |
| Streaming Long Tuning | 流式长视频微调,自监督 DMD 损失 | 32 GPU-days 微调 1.3B 模型到分钟级生成 |
| Short-Window Attention | 局部注意力窗口 12 latent frames | 推理速度提升,一致性保持 |
| Frame Sink | 帧级注意力汇聚(替代 token 级) | 长程一致性增强,计算高效 |
| INT8 量化 | 模型量化推理 | 模型大小减半,质量损失极小 |
三、技术架构
整体框架图
核心公式
KV Recache 机制
在提示切换边界,用已生成视频前缀和新提示重建 KV 缓存:
三种策略对比:
- No KV cache:丢弃所有缓存 → 提示遵循好,但过渡突兀
- KV cache:保留全部缓存 → 过渡平滑,但无法遵循新提示
- KV recache(本文):用已生成帧+新提示重建缓存 → 兼顾两者
具体流程:
- 在切换点,编码已生成视频为视觉上下文
- 将视觉上下文与新提示配对
- 重新计算 KV 缓存
- 后续步骤使用新缓存继续生成
Streaming Long Tuning
自监督流式长视频微调:
第 1 次迭代:从零采样短片段(如 5s),应用 DMD 损失
后续迭代:
- 从上一次迭代扩展短片段
- 条件于之前存储的 KV 缓存
- 生成下一个短片段
- 对新片段应用 DMD 损失
关键设计:
- 每个长序列只包含一次提示切换
- 训练时执行一次 recache + 继续 rollout
- 蒸馏时教师模型也用新提示监督
Short-Window Attention
将全注意力替换为局部窗口注意力:
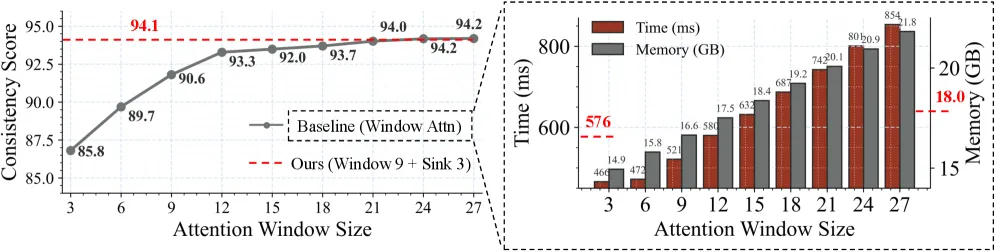
窗口大小选择 12 latent frames,在速度和质量之间取得最优平衡。
Frame Sink(帧级注意力汇聚)
借鉴 LLM 中的 attention sink 机制,但应用于帧级而非 token 级:
- 缓存初始帧的 KV 状态作为全局锚点
- 与短窗口注意力结合:9 local + 3 sink = 12 effective window
- 比长窗口注意力更高效,一致性相当
训练-推理一致性
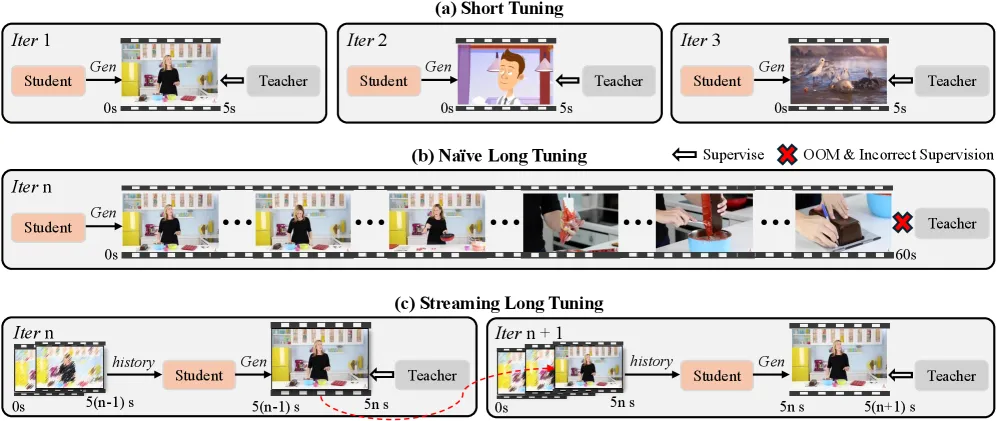
关键洞察:训练必须在长视频上进行,否则:
- 短片段训练的模型在长序列外推时质量退化
- 高效推理策略(窗口注意力、frame sink)需要长视频训练才能生效
四、核心能力
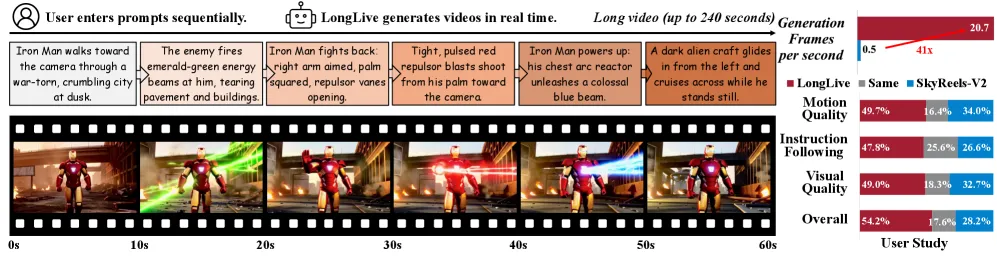
实时交互式长视频生成
- 帧率:20.7 FPS(单 H100)
- 时长:支持最长 240 秒视频
- 交互:支持流式提示输入,实时引导叙事
- 训练:仅需 32 GPU-days 微调 1.3B 模型
支持的交互模式
- 流式提示切换:用户可随时更改提示,视频平滑过渡
- 多提示序列:支持多个连续提示,每个控制不同时段
- 实时引导:用户可在生成过程中实时调整方向
INT8 量化推理
| 精度 | 模型大小 | 吞吐量 (FPS) | Total Score | Quality | Semantic |
|---|---|---|---|---|---|
| INT8 | 1.4 GB | 16.4 | 84.31 | 86.20 | 76.74 |
| BF16 | 2.7 GB | 12.6 | 84.87 | 86.97 | 76.47 |
INT8 量化:模型大小减半,FPS 提升 30%(12.6→16.4),质量损失极小。
五、实验结果
短视频生成(VBench)
| 模型 | 参数量 | 分辨率 | FPS ↑ | Total ↑ | Quality ↑ | Semantic ↑ |
|---|---|---|---|---|---|---|
| 双向扩散模型 | ||||||
| LTX-Video | 1.9B | 768×512 | 8.98 | 80.00 | 82.30 | 70.79 |
| Wan2.1 | 1.3B | 832×480 | 0.78 | 84.26 | 85.30 | 80.09 |
| 自回归/蒸馏模型 | ||||||
| SkyReels-V2 | 1.3B | 832×480 | 0.49 | 82.67 | 84.70 | 74.53 |
| MAGI-1 | 4.5B | 832×480 | 0.19 | 79.18 | 82.04 | 67.74 |
| CausVid | 1.3B | 832×480 | 17.0 | 81.20 | 84.05 | 69.80 |
| NOVA | 0.6B | 768×512 | 0.88 | 80.12 | 80.39 | 79.05 |
| Pyramid Flow | 2B | 768×512 | 6.7 | 81.72 | 84.74 | 69.62 |
| Self Forcing (chunk) | 1.3B | 832×480 | 17.0 | 84.31 | 85.07 | 81.28 |
| Self Forcing (frame) | 1.3B | 832×480 | 8.9 | 84.26 | 85.25 | 80.30 |
| LongLive | 1.3B | 832×480 | 20.7 | 84.87 | 86.97 | 76.47 |
关键发现:
- Total Score: 84.87,超越所有基线
- Quality Score: 86.97,显著领先(第二名 Wan2.1 85.30)
- FPS: 20.7,比 Self Forcing (chunk) 的 17.0 快 22%
- Semantic: 76.47,低于 Self Forcing 的 81.28(权衡)
长视频生成(VBench-Long)
| 模型 | 30s Total | 30s Quality | 30s Semantic | 特点 |
|---|---|---|---|---|
| SkyReels-V2 | 82.67 | 84.70 | 74.53 | 双向,极慢 |
| FramePack | - | - | - | I2V 模型 |
| Self Forcing | 84.31 | 85.07 | 81.28 | 因果蒸馏 |
| LongLive | 84.87 | 86.97 | 76.47 | 因果 AR,实时 |
交互式长视频生成
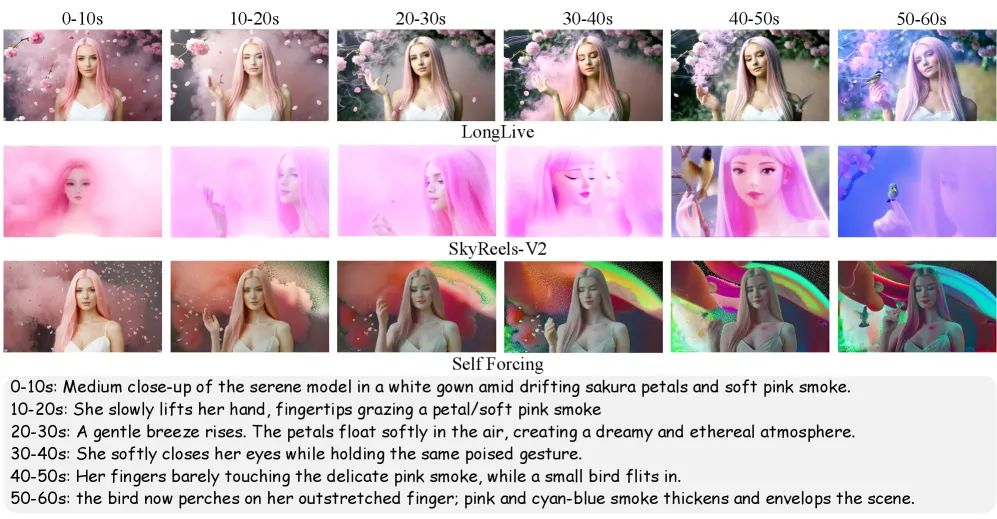
在 160 个交互式 60 秒视频(每个包含 6 个连续 10 秒提示)上的评估:
- LongLive 在 prompt following、visual consistency 和 overall quality 上均优于基线
- 支持多轮提示切换,过渡平滑
消融实验
KV Recache 策略
| 策略 | Background Consistency ↑ | Subject Consistency ↑ | Semantic Score ↑ |
|---|---|---|---|
| No KV cache | 低 | 低 | 高(提示遵循好) |
| KV cache | 高 | 高 | 低(无法遵循新提示) |
| KV recache | 高 | 高 | 高 |
KV recache 兼顾视觉一致性和语义遵循。
短窗口注意力和 Frame Sink
| 窗口大小 | Long-Range Consistency |
|---|---|
| 3 latent frames | 低 |
| 12 latent frames | 中高 |
| 24 latent frames | 高(饱和) |
| 9 local + 3 sink | 高(与 24 相当) |
发现:
- 一致性随窗口增大而提升,在 24 帧时饱和
- 9 local + 3 sink 达到与 24 帧窗口相当的一致性
- 小窗口 + frame sink 是最优配置(速度+质量)
LoRA 预算
| LoRA rank | 可训练参数 | Total Score |
|---|---|---|
| 32 | 44M | 81.08 |
| 64 | 87M | 82.68 |
| 128 | 175M | 82.98 |
| 256 | 350M | 83.12 |
| 512 | 700M | 83.04 |
| Full Model | 1.3B | 83.52 |
rank 256 接近全模型质量(83.12 vs 83.52),参数量仅 27%。
定性对比
LongLive 展示了:
- 强提示遵循能力
- 平滑的提示切换过渡
- 长程视觉一致性
六、实现细节
| 配置 | 值 |
|---|---|
| 基础模型 | Wan 2.1 (1.3B) |
| 微调方法 | LoRA (rank 256) |
| 训练时间 | 32 GPU-days |
| 分辨率 | 832×480 |
| 帧率 | 20.7 FPS (H100) |
| 最大时长 | 240 秒 |
| 注意力窗口 | 12 latent frames (9 local + 3 sink) |
| 训练数据 | 自监督,Qwen2-72B 生成提示 |
| 去噪步数 | 4 步 |
| INT8 量化 | 模型大小 1.4GB,FPS 16.4 |
训练细节
- 使用自监督方式,无需额外长视频数据集
- 文本提示由 Qwen2-72B-Instruct 生成
- Streaming Long Tuning:每次迭代扩展短片段
- DMD 损失用于蒸馏
七、与现有方法对比
| 方法 | 类型 | FPS | 最大时长 | 交互式 | 流式提示 | 训练成本 |
|---|---|---|---|---|---|---|
| Wan2.1 | 双向扩散 | 0.78 | 5s | × | × | 高 |
| SkyReels-V2 | Diffusion Forcing | 0.49 | 长 | × | × | 高 |
| MAGI-1 | 双向扩散 | 0.19 | 长 | × | × | 高 |
| CausVid | 蒸馏 AR | 17.0 | 5s | × | × | 中 |
| Self Forcing | 蒸馏 AR | 17.0 | 有限 | × | × | 中 |
| Rolling Forcing | 蒸馏 AR | 15.79 | 多分钟 | × | × | 中 |
| MotionStream | 蒸馏 AR | 29.5 | 无限 | ✓(轨迹) | ✓ | 中 |
| LongLive | 因果 AR | 20.7 | 240s | ✓(文本) | ✓ | 低 |
独特优势:
- 唯一支持实时流式文本提示切换的长视频生成方法
- 训练效率极高:仅 32 GPU-days 微调
- 支持最长 240 秒视频
- INT8 量化支持,模型仅 1.4GB
八、相关工作
| 方向 | 代表工作 | 与 LongLive 的关系 |
|---|---|---|
| 双向视频扩散 | Wan2.1, MAGI-1 | 基础模型 |
| 因果蒸馏 | CausVid, Self Forcing, Rolling Forcing | 基线方法 |
| Diffusion Forcing | SkyReels-V2, FramePack | 替代范式 |
| 流式生成 | StreamingT2V, InfinityStream | 同类工作 |
| 交互式世界模型 | MotionStream, GameNGen | 同类交互系统 |
| Attention Sink | StreamingLLM | 机制灵感来源 |
九、总结
核心贡献
- KV Recache:提示切换时重建 KV 缓存,兼顾平滑过渡和提示遵循
- Streaming Long Tuning:自监督流式长视频微调,32 GPU-days 高效训练
- Short-Window Attention + Frame Sink:短窗口+帧级汇聚,加速推理保持一致性
- INT8 量化:模型大小减半,FPS 提升 30%,质量损失极小
- 20.7 FPS 实时生成:单 H100,支持最长 240 秒交互式视频
技术影响
- 训练效率极高:32 GPU-days 微调 1.3B 模型(vs 需要大量计算的全量训练)
- VBench Quality Score 86.97,超越所有同类方法
- KV recache 机制为交互式视频生成提供了通用解决方案
- Frame sink 机制可推广到其他流式生成任务
- INT8 量化使部署更实用
局限性
- Semantic Score (76.47) 低于 Self Forcing (81.28)
- 最大时长 240 秒(单 H100),超长视频需要更多优化
- 交互仅限于文本提示切换(不支持轨迹/拖拽控制)
- 代码尚未开源(承诺开源)
十、参考资源
- 论文: arXiv:2509.22622
- 关键引用:
- Wan 2.1 (Wan et al., 2025) — 基础视频扩散模型
- Self Forcing (Huang et al., 2025) — 因果蒸馏基线
- CausVid (Yin et al., 2025) — 因果适应初始化
- DMD (Yin et al., 2024b) — 分布匹配蒸馏
- StreamingLLM (Xiao et al., 2023) — Attention Sink 机制
- SkyReels-V2 (Chen et al., 2025) — Diffusion Forcing 基线
分析日期: 2026-06-05