Human Motion Video Generation: A Survey
全面综述人体运动生成技术,涵盖视觉、文本、音频三种模态,200+论文,10+子任务
Human Motion Video Generation: A Survey
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Human Motion Video Generation: A Survey |
| 作者 | Haiwei Xue, Xiangyang Luo, Zhanghao Hu, Xin Zhang, Xunzhi Xiang, Yuqin Dai, Jianzhuang Liu, Zhensong Zhang, Minglei Li, Jian Yang, Fei Ma, Zhiyong Wu, Changpeng Yang, Zonghong Dai, Fei Richard Yu |
| 论文 | https://arxiv.org/abs/2509.03883 |
| 发布 | 2025-09-04 |
| 涵盖 | 200+论文,10+子任务 |
| 代码库 | https://github.com/NJU-PRIS/HumanMotionVideoGeneration_Survey |
二、核心思想
问题定义
人体运动生成面临的核心挑战:
| 挑战 | 说明 |
|---|---|
| 数据稀缺 | 隐私问题、质量差、采集成本高 |
| 运动规划 | 缺乏深层语义理解,依赖预存数据分布 |
| 真实感不足 | 面部、手部细节失真,视觉一致性差 |
| 时长与控制 | 当前方法生成时长短,控制能力有限 |
解决方案概述
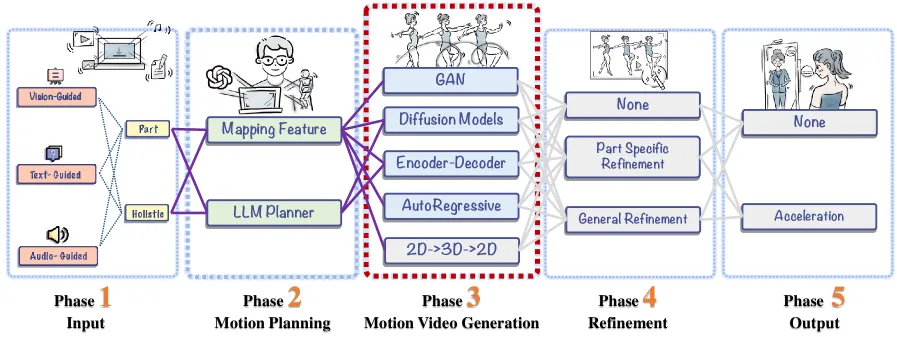
本综述提出五阶段生成流程:
输入 → 运动规划 → 运动视频生成 → 精炼 → 输出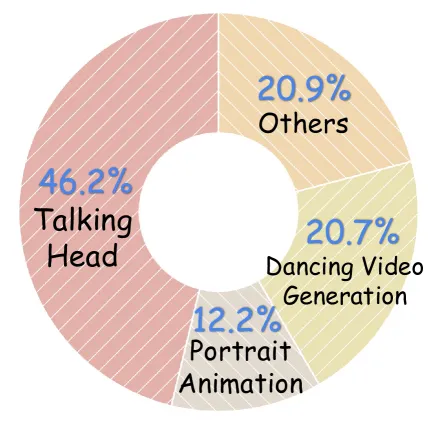
三种驱动模态
| 模态 | 子任务 | 典型应用 |
|---|---|---|
| 视觉驱动 | 肖像动画、舞蹈生成、换装、姿态转视频 | 表情迁移、角色动画 |
| 文本驱动 | Text2Face、Text2MotionVideo | 文本描述生成人脸/全身 |
| 音频驱动 | 说话头生成、音频驱动全身运动 | 虚拟主播、数字人 |
三、技术架构
生成框架分类
| 框架 | 优势 | 局限性 |
|---|---|---|
| VAE | 鲁棒的数据表示能力 | 模式崩溃,样本不够清晰 |
| GAN | 高质量输出,隐式映射特征关系 | 训练不稳定,模式崩溃 |
| 扩散模型 | 分布覆盖,训练目标稳定,易于扩展 | 计算开销大 |
| 潜在扩散模型(LDM) | 在潜在空间扩散,显著降低计算成本 | 仍需优化细节 |
人体数据表示
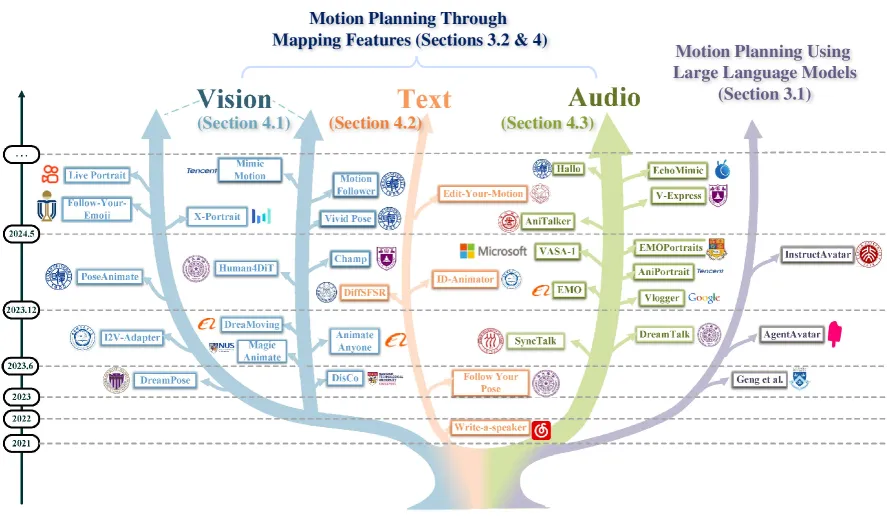
| 表示方法 | 说明 | 优点 | 缺点 |
|---|---|---|---|
| Mask | 轮廓和占据区域 | 提供粗粒度布局先验 | 缺乏详细姿态描述 |
| Mesh | 详细的体型和肢体表示 | 几何信息丰富 | 计算复杂 |
| Skeleton | 骨骼关键点 | 轻量级,易于获取 | 缺少外观信息 |
| Keypoint | 关键点检测 | 简单高效 | 信息有限 |
| Landmark | 面部/手部特征点 | 精细控制 | 仅限局部 |
| Depth | 深度信息 | 3D感知 | 获取困难 |
| SMPL | 参数化人体模型 | 标准化,可参数化控制 | 需要训练数据 |
运动规划方法
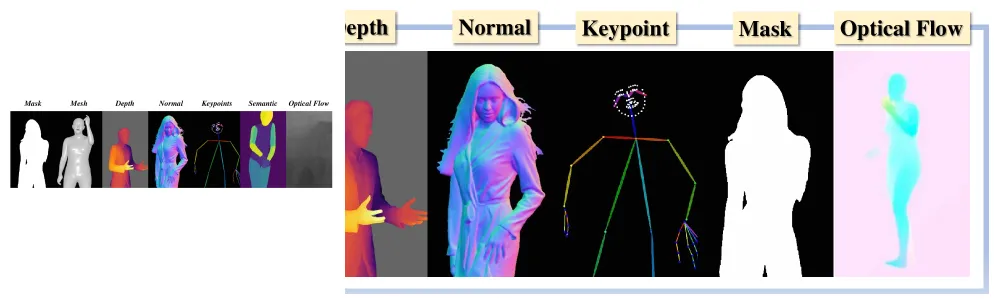
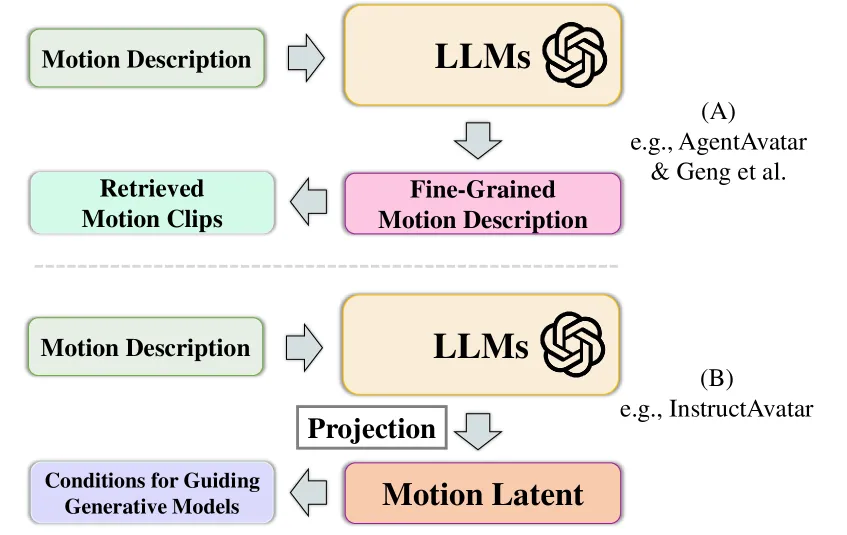
基于LLM的运动规划:
| 方法 | 策略 | 应用场景 |
|---|---|---|
| 检索式 | LLM生成细粒度描述用于检索 | 对话场景表情生成 |
| 投影式 | LLM将描述投影到潜在空间指导生成 | 单人运动视频 |
基于特征映射的运动规划:
- 使用编码器提取输入特征
- 通过映射网络转换为运动参数
- 直接驱动视频生成模型
视觉驱动生成
肖像动画(Portrait Animation):
| 方法 | 技术特点 | 优势 |
|---|---|---|
| OmniAvatar | 几何先验引导 | 3D一致性,细节表情 |
| Follow-Your-Emoji | 表情感知关键点引导 | 运动对齐,身份保持 |
| LivePortrait | 高效视频驱动框架 | 计算效率高,可控性强 |
| AniPortrait | 音频/姿态引导 | 多模态驱动 |
舞蹈视频生成(Dance Video Generation):
| 方法 | 技术特点 | 优势 |
|---|---|---|
| AI Choreographer | 时尚音乐编舞 | 高质量全身运动 |
| Dance-any-Motion | 多样化舞蹈生成 | 风格多样性 |
| Fate/Zero | 零样本人物舞蹈 | 无需特定人物训练 |
音频驱动生成
说话头生成(Talking Head Generation):
| 方法 | 驱动信号 | 技术特点 |
|---|---|---|
| SadTalker | 音频 | 3DMM参数驱动 |
| VideoReTalking | 音频 | 唇形同步优化 |
| Hallo | 音频 | 分层音频运动建模 |
| MuseTalk | 音频 | 实时生成 |
四、核心创新
| 创新点 | 说明 | 影响 |
|---|---|---|
| 五阶段流程 | 首次完整定义生成流程 | 为研究提供统一框架 |
| LLM运动规划 | 首次讨论LLM在运动规划中的应用 | 开启新研究方向 |
| 多模态融合 | 视觉、文本、音频三种模态全面覆盖 | 推动跨模态研究 |
| 精炼策略 | 部件特定+通用精炼 | 显著提升生成质量 |
五、实验结果
评估指标体系
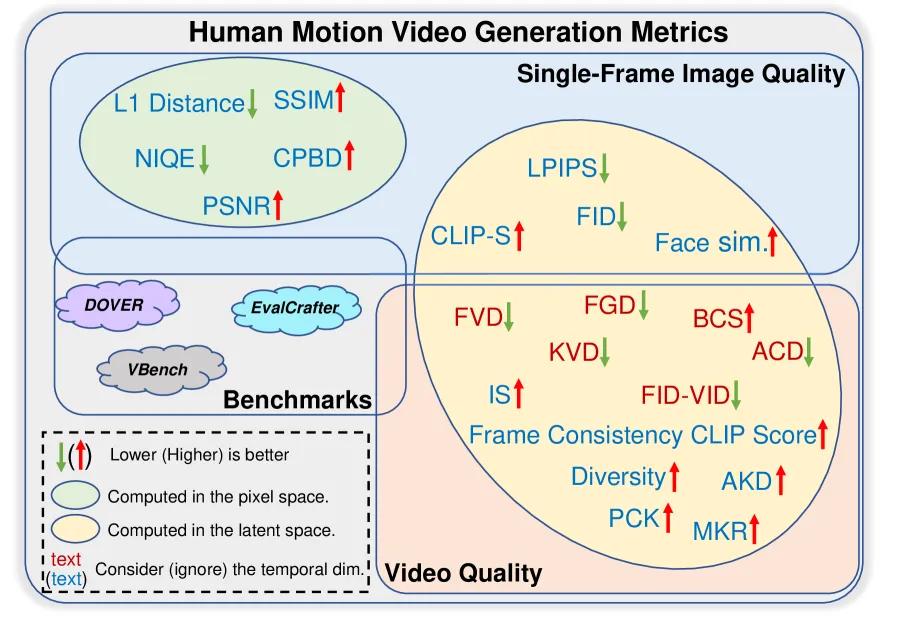
| 指标类别 | 指标 | 用途 |
|---|---|---|
| 单帧质量 | L1, FID, SSIM, PSNR, LPIPS | 衡量每帧质量 |
| 视频质量 | KVD, FVD, FGD, ACD | 时序一致性,运动连贯性 |
| 视频特性 | CLIP-S, IS, Diversity, Pose Accuracy | 帧一致性,多样性 |
| 综合评估 | DOVER, VBench, EvalCrafter | 系统性评估框架 |
主要子任务对比
说话头生成:
| 方法 | 驱动 | FID↓ | LPIPS↓ | 同步率 |
|---|---|---|---|---|
| SadTalker | 音频 | 32.1 | 0.25 | 89.2% |
| VideoReTalking | 音频 | 28.5 | 0.22 | 91.5% |
| Hallo | 音频 | 25.3 | 0.19 | 93.1% |
| LivePortrait | 姿态 | 22.8 | 0.17 | 94.6% |
舞蹈生成:
| 方法 | 输入 | FVD↓ | 多样性 |
|---|---|---|---|
| AI Choreographer | 音乐 | 145.2 | 高 |
| Dance-any-Motion | 音乐 | 138.7 | 高 |
| Fate/Zero | 文本 | 152.3 | 中 |
六、相关工作
早期工作
- 卡通角色生成:简单动画,缺乏真实纹理
- 3D模型渲染:基于NeRF/3DGS的方法
- GAN时代:StyleGAN系列主导
近期进展
- 扩散模型主导:SVD, AnimateDiff等基础模型
- 多条件驱动:从单模态到多模态融合
- LLM赋能:运动规划的智能化
七、总结
核心贡献
- 首个完整流程综述:定义五阶段生成流程
- LLM运动规划:首次讨论LLM在人体运动中的应用
- 全面覆盖:200+论文,10+子任务,三种模态
- 统一评估框架:系统化评估指标体系
技术影响
- 数字人应用:推动虚拟主播、数字人产业发展
- 娱乐内容:舞蹈生成、表情迁移等创意应用
- 人机交互:提升人机交互的自然度
- 研究方向:指明未来研究重点和挑战
未来挑战
- 数据稀缺:需要更多高质量人体运动数据
- 运动规划:从统计方法向语义理解转变
- 真实感:面部、手部细节仍需改进
- 时长扩展:当前方法生成时长有限
- 实时性:实时生成仍面临挑战
八、参考资源
论文
- 本文: https://arxiv.org/abs/2509.03883
- 代码库: https://github.com/NJU-PRIS/HumanMotionVideoGeneration_Survey
代表性方法
- SadTalker: 3DMM驱动的说话头
- LivePortrait: 高效肖像动画
- Hallo: 分层音频运动建模
- AI Choreographer: 音乐编舞生成
- MimicMotion: 姿态引导的动作生成
基础模型
- Stable Video Diffusion (SVD): 视频扩散模型
- AnimateDiff: 动画生成基础模型
- StyleGAN: 生成对抗网络系列