Waver: 面向逼真视频生成的统一基础模型
字节跳动 Waver 团队的统一图像/视频生成基础模型:基于 Rectified Flow Transformer,用 Hybrid Stream DiT(Dual Stream 前 16 层对齐模态 + Single Stream 后 40 层提效)在单一网络内统一 T2V/I2V/T2I,原生生成 720p 5–10 秒视频再经 Cascade Refiner 级联超分到 1080p(提速 40%)。配套 MLLM 视频质量模型的数据清洗流水线、REPA 表征对齐、mode 时间步采样、192p 运动预训练、视频 APG、模型平均等训练/推理配方,在 Artificial Analysis T2V/I2V 榜单双双第三,复杂运动场景显著领先。
Waver: 面向逼真视频生成的统一基础模型
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Waver: Wave Your Way to Lifelike Video Generation |
| 作者 | Bytedance Waver Team(Yifu Zhang, Hao Yang, Yuqi Zhang, Yifei Hu, Fengda Zhu, Chuang Lin, Xiaofeng Mei, Yi Jiang, Bingyue Peng, Zehuan Yuan 等) |
| 机构 | 字节跳动(ByteDance) |
| 论文 | arXiv:2508.15761(v2, 2025-08-26) |
| 代码/主页 | https://github.com/FoundationVision/Waver |
| 主题 | 统一图像/视频生成、Rectified Flow Transformer、DiT、级联超分 |
一句话总结:Waver 用一套 12B 的 Rectified Flow Transformer 在单一网络内统一 T2V/I2V/T2I,靠 Hybrid Stream DiT 加速收敛、Cascade Refiner 两阶段生成 1080p,并以工业级数据清洗与训练配方在复杂运动视频上取得 SOTA,Artificial Analysis 榜单 T2V/I2V 双双第三。
二、核心思想
问题定义
当前视频生成社区面临四大挑战:(1) 生成视频质量仍不理想,缺乏美感与真实感,尤其在体操、篮球等复杂运动场景表现差;(2) 公开技术报告很少讨论 1080p 高分辨率生成的技术细节,架构设计的动机也常常语焉不详;(3) 多数模型用两个独立模型分别实现 T2V 和 I2V,训练资源开销大;(4) 数据处理流水线与训练流程信息有限,难以完整复现。
解决方案概述
Waver 基于 Rectified Flow Transformer,由两大模块构成:
- Task-Unified DiT:用灵活的输入条件机制把 T2I/T2V/I2V 统一进单一网络(仅需改变输入通道维度),生成原生 720p、时长 5–10 秒的视频;采用 Hybrid Stream 架构在模态对齐与参数效率间取得平衡并加速收敛。
- Cascade Refiner:把第一阶段的 480p/720p 视频作为输入,通过 flow matching 以更少推理步超分到 1080p,相比直接生成 1080p 提速 40%。
配套贡献:完整的数据清洗流水线(含人工标注训练的 MLLM 视频质量模型)+ 详尽的训练/推理配方(语义表征、美学、运动、真实感的优化与权衡)。累计训练超 2 亿视频片段。
三、技术架构
3.1 整体框架
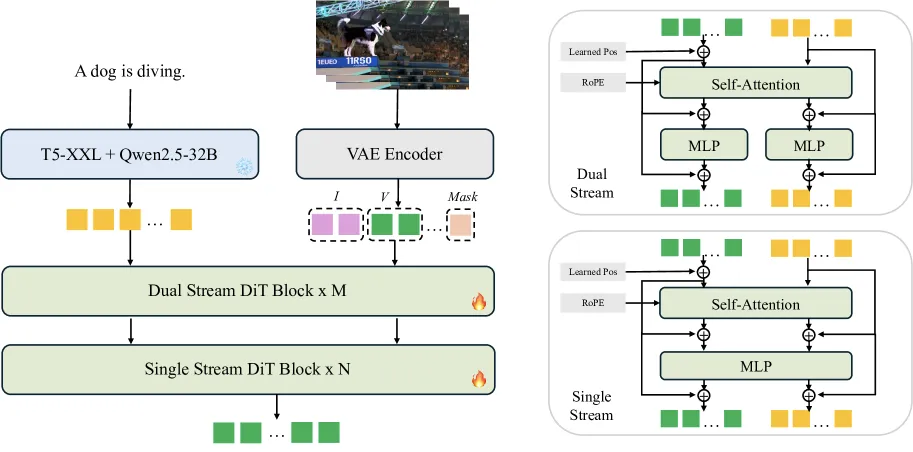
- VAE:采用 Wan2.1-VAE 做高效视频潜变量压缩。
- 双文本编码器:flan-t5-xxl + Qwen2.5-32B-Instruct。得益于 Qwen 的强能力,双编码器显著提升 T2I 的 prompt following(Fig 4)。
- 主干:Rectified Flow Transformer,“Dual Stream + Single Stream”融合视频与文本模态。
- Refiner:同为 Rectified Flow Transformer,作为超分模块,把 480p/720p 升到 1080p。
3.2 Task-Unified DiT
统一输入表示(Unified Input Formulation):把三部分沿通道维拼接——主噪声潜变量 、条件帧张量 (已知条件帧的 VAE 潜变量,其余帧填黑图潜变量)、二值条件掩码 (1=条件帧,0=待生成帧)。这一表示极为灵活:既能在训练时混合并调节各任务比例,也能直接扩展到视频插帧等新任务。
Hybrid Stream 结构:
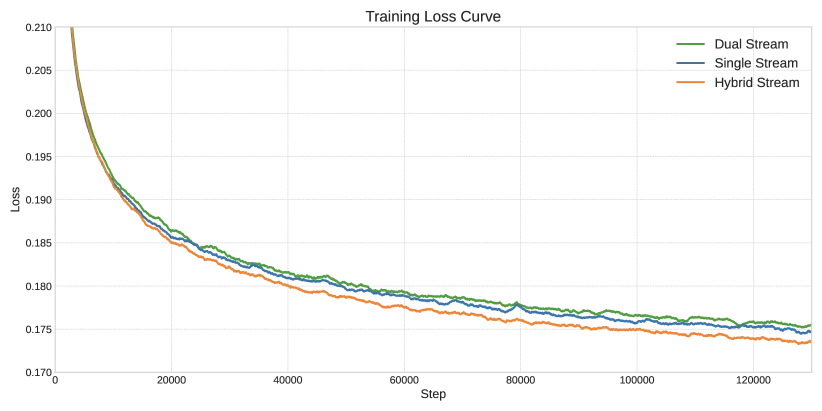
- Dual Stream block:视频与文本模态用独立参数,仅在 self-attention 时合并——利于模态共适应对齐,但参数效率低(T2V 时视频 token 极多,文本参数被闲置)。
- Single Stream block:模态共享同一套参数,效率最高,但因视频/文本统计分布差异导致收敛慢。
- 混合策略:前 M 层 用 Dual Stream 对齐模态,后 N 层 切换为 Single Stream 提效。收敛比任一纯方案都快。
关键参数(Table 1):
| Model Size | M | N | Input Dim | Output Dim | Num Heads | Head Dim |
|---|---|---|---|---|---|---|
| 12B | 16 | 40 | 36 | 16 | 24 | 128 |
Hybrid Position Embedding:融合相对与绝对位置信号——
- 3D RoPE:提供时间/高/宽三维相对位置,相比 ViT 正弦编码有更强的时长/分辨率外推能力,减少变形失真;
- factorized 可学习位置编码:独立编码每一维再求和,提供绝对位置锚点,加速收敛。
3.3 Cascade Refiner
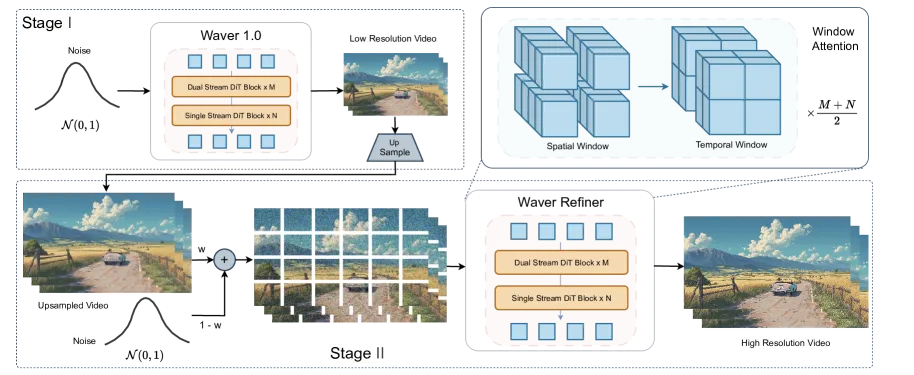
两阶段思路:先生成低分辨率视频,再由专用 refiner 超分到 1080p(受强先验条件约束,可加速 1080p 生成)。
- Window Attention:把 token 划分到 局部窗口内计算注意力;交替使用空间窗(2×2×1)与时间窗(1×1×2)实现跨窗通信。观察到 DiT 注意力在最浅与最深层最密集,故对首尾各 8 层用 full attention、中间层用 window attention。
- 像素 + 潜变量退化(Pixel & Latent Degradation):从高清源合成低质视频。像素退化:1080p→360p→1080p;潜变量退化:向 VAE 潜空间注入高斯噪声弥合域差:
- Refiner 训练/推理:模型输入为退化潜变量与干净潜变量的线性插值,训练目标为预测从退化到干净的差量:
Refiner 不仅超分,还能修正生成伪影;当 取大值时甚至能做视频编辑(如把视频里的女性变成男性,Fig 7)。
3.4 核心公式:表征对齐(Representation Alignment)
借鉴 REPA / VA-VAE,用 Qwen2.5-VL 抽取视频高层语义特征 ,与 DiT 第 16 层的中间特征 对齐(仅在 480p 阶段施加,避免拖慢 192p 快速迭代、规避 720p 特征存储开销)。将 空间下采样 2×、时间下采样 4×,再用轻量 MLP 投影通道,最大化余弦相似度:
最终训练目标():
四、训练数据流水线
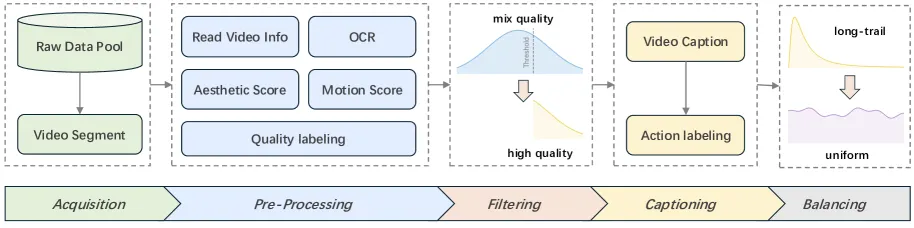
4.1 数据预处理
- 多源采集:对复杂球类运动、复杂运动场景做定向补充采集,缓解数据集偏差。
- 视频切分:先用 PySceneDetect 做场景检测,再用 DINOv2 相邻帧余弦相似度细分镜头;保留 2–10 秒片段,对超 10 秒者采样内部相似度最低的段(捕捉显著运动/高光时刻)。
- 片段质量打分:基础属性(FPS/分辨率/码率)+ 静态视觉(美学模型 + OCR 文字占比 + 水印检测)+ 动态质量(RAFT 光流,前景/背景分离后主要基于前景光流度量运动幅度)。
4.2 质量模型(MLLM-based)
质量打分有局限(慢动作运动分不准、美学分某些区间不可靠、OCR 漏检小水印)。因此对 100 万+高分片段人工标注,标注高质量样本与 13 个低质维度(Fig 9a),用于对 VideoLLaMA3 做 SFT。在 480p 训练阶段用它过滤数据;验证集上”预测为高质量”样本的准确率为 78%。
4.3 字幕模型
基于 Qwen2.5-VL,联合训练 caption 与 sub-action 描述任务;以 Tarsier2 caption 作为输入生成更细粒度字幕。为每个子动作标注起止时间戳以增强动作时序理解。DPO 阶段用 DPOP loss 抑制幻觉、稳定长文本输出。
4.4 语义均衡
用 Qwen2.5-32B 对字幕做多级动作分类(12 个一级、100 个二级、6000+ 三级动作标签),对占比过低的类别(如稀缺的体育类,Fig 9b)通过过采样 + 合成样本补齐。
4.5 分层数据过滤漏斗
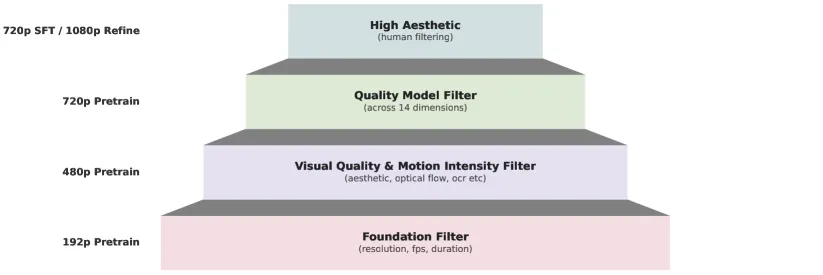
各训练阶段逐级收严:
- 192p 预训练:尽量保留多样性,仅去除过多叠字与近静态视频,重运动一致性/语义对齐/时序连贯。
- 480p 预训练:引入美学打分、更严叠字/运动阈值、8 维质量模型。
- 720p 预训练:质量模型扩到 12 维(新增主体截断、过曝、暗/模糊、图像动画)。
- 720p CT:新增清晰度、色彩平衡;强制数据源与语义类别均衡。
- 720p SFT:引入合成数据(高美学 + 超现实),仅保留 2K/4K 真实片段,复杂运动人工精选并详细标注。
- 1080p Refinement:只留 720p CT 数据 + 最高质量 2K/4K 数据。
五、训练 / 推理配方
5.1 多阶段训练(Table 2)
| Task | Stage | Resolution | Data volume (video/image) | Epochs | LR | Sigma shift |
|---|---|---|---|---|---|---|
| T2I | Pretrain | 256p | 170M | 24 | 1e-4 | 1.0 |
| T2I | Pretrain | 512p | 100M | 3 | 6e-5 | 2.0 |
| T2I | Pretrain | 1024p | 60M | 1 | 3e-5 | 3.0 |
| T2V/T2I | Pretrain | 192p 12fps | 185M/40M | 2 | 1e-4 | 1.5 |
| T2V/T2I | Pretrain | 192p 16fps | 185M/40M | 1.5 | 1e-4 | 1.5 |
| T2V+I2V/T2I | Pretrain | 480p 16fps | 41M/40M | 3 | 5e-5 | 2.5 |
| T2V+I2V/T2I | Pretrain | 720p 24fps | 22M/15M | 1 | 3e-5 | 3.0 |
| T2V+I2V/T2I | CT | 720p 24fps | 4M/15M | 2 | 1e-5 | 3.0 |
| T2V+I2V/T2I | SFT | 720p 24fps | 0.1M/15M | 2 | 5e-6 | 3.0 |
| (T+V)2V/T2I | Refine | 1080p 24fps | 3M/3M | 1 | 1e-5 | 4.5 |
| (T+V)2V/T2I | SFT | 1080p 24fps | 0.2M/3M | 1 | 5e-6 | 4.5 |
先训 T2I(256p→1024p,学文图对应与指令跟随);再从 192p 起联合训 T2V + T2I;480p 起以 20% 概率 训 I2V(控制是否加首帧条件)。遵循 SD3:分辨率越高、flow matching 的 sigma shift 越大。
5.2 运动优化(Motion Optimization)
- 低分辨率视频训练:在 192p(12fps→16fps)学运动,把运动学习与视觉质量/语义部分解耦。相比从 T2I 直接跳到 480p,加入 192p 中间步能让 480p 收敛更快、运动幅度更大(Fig 12)。
- 噪声调度(mode 采样):遵循 SD3,中间时间步最难学,故用中间概率高、两端低的 PDF。
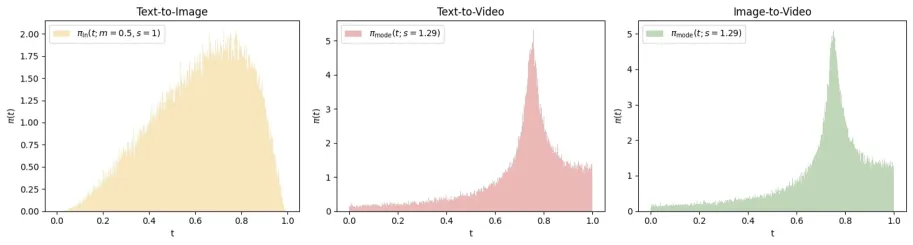
mode 采样让运动幅度更大(Fig 13)。最终 T2I 用 Lognorm(0.5,1),T2V/I2V 用 Mode(1.29)。
- T2V & I2V 联合训练:I2V 因强首帧条件易”运动不足”。以 20% 概率引入首帧条件做联合训练,防止首帧主导,使 I2V 与 T2V 运动幅度相当(Fig 15)。
- 弱运动数据过滤:用前景运动分过滤静态/过度运动视频;再用质量模型过滤慢动作与图像动画视频。
5.3 美学优化(合成数据增强)
利用统一多任务模型 + 高质量图像 + I2V 能力,合成强调美学(构图/光影/色彩)的视频;经至少 2 名标注员一致通过的严格人工审核(N=8381,主要失败原因为畸变,Fig 18a)。高美学微调后视觉质量 SBS 胜率从 32.9% 升到 39.5%(+7%),运动质量保持不变(Fig 18b/19)。需平衡合成与真实数据比例,防止过拟合合成风格。
5.4 模型平衡(Model Balancing)
视频生成常有”运动大↔清晰度低""真实感↔伪影”等权衡。三招应对:
- Prompt tagging:按数据源/质量给数据打标签(anime/game/CG/real/synthetic + 清晰度/运动速度),训练时前/后缀入 caption,推理时把不良质量描述放进 negative prompt。
- Video APG:把 APG 扩展到视频,将 CFG 更新项分解为平行 + 正交分量并下调平行分量,减伪影不过饱和;从 [C,H,W] 维归一化优于 [C,T,H,W],最佳超参 CFG=8、norm threshold=27(Fig 21)。
- 模型平均(Model averaging):合并 7–10 个不同数据/阶段/采样概率的模型,运动质量 +5%、视觉 +2%、指令 +1%(Fig 22)。
5.5 Prompt Rewriting
不训练专用改写模型,直接用 GPT-4.1,按训练字幕分布补充相机/外观/背景/动作细节;对 5 秒与 10 秒设计两套 system prompt。
六、基础设施
- FSDP 混合分片:inner shard 64 或 128,平衡显存与通信开销。
- torch.compile:把 transformer 层编译成 fullgraph,让 inductor 自动融合 CUDA 算子。
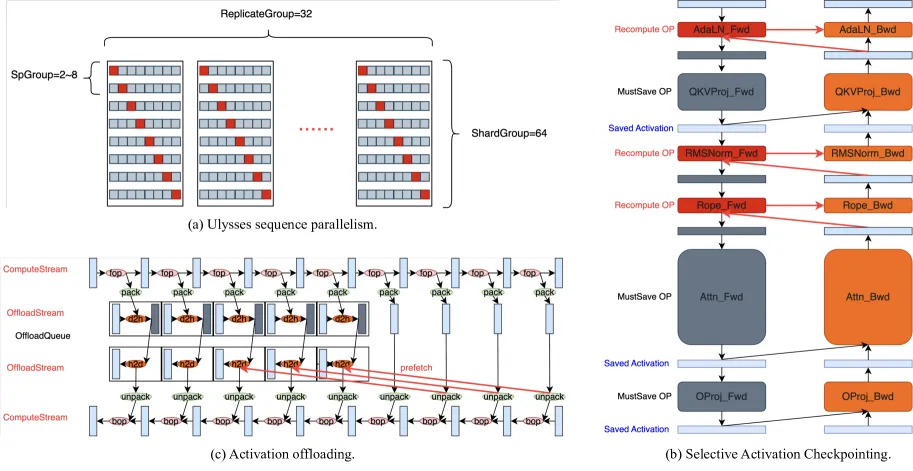
- Ulysses 序列并行:720p/1080p、8–10 秒视频序列可达数十万 token,沿序列维切分到并行组,缓解显存压力。
- Bucket Dataloader + Sequence Packing:用 SPFHP 按 token 长度打包短视频,按计算量分桶,保证同批 token 长度一致。
- Selective Activation Checkpointing (SAC):低重算成本算子(逐元素加乘)重算,昂贵算子(attention/GEMM)尽量留存。
- Activation Offloading:前向激活拷贝到 CPU,反向前几步预取回 GPU,用独立 CUDA 流与主计算重叠,开销可忽略。
MFU(Table 3):192p 0.32 / 480p 0.36 / 720p 0.39 / 1080p 0.40。
七、实验结果
7.1 Artificial Analysis Arena
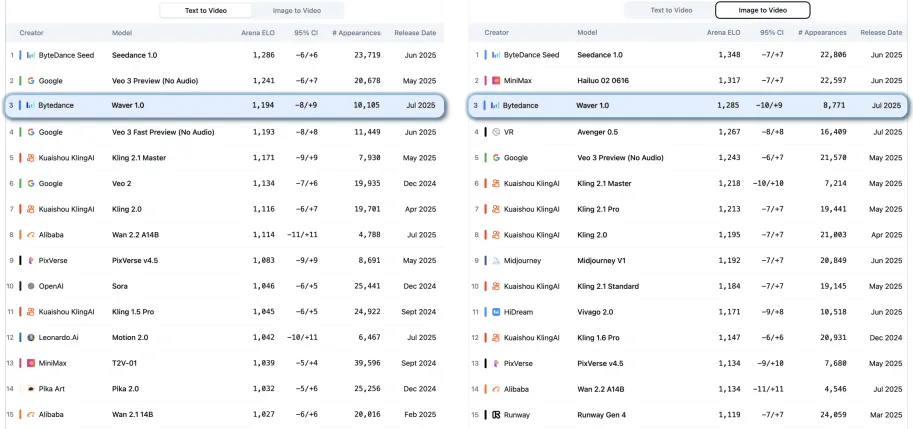
基于大量用户对比的 Elo 排名,Waver 在 T2V 与 I2V 双榜均排第三(数据截至 2025-07-22/08-05)。
7.2 人工评估
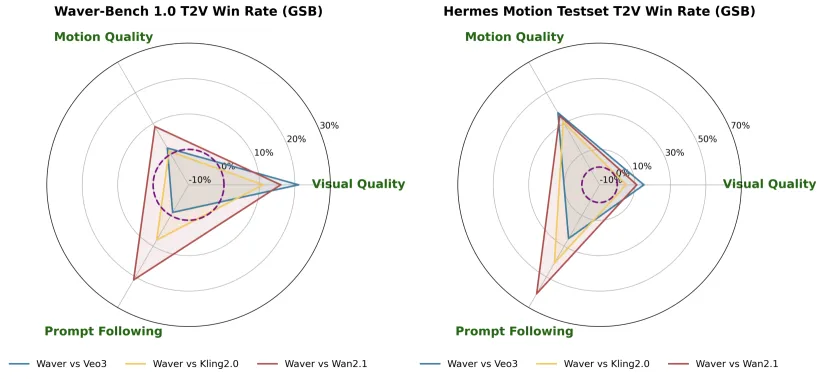
两个自建基准:
- Waver-Bench 1.0:304 个通用样本(体育、日常、超现实等)。
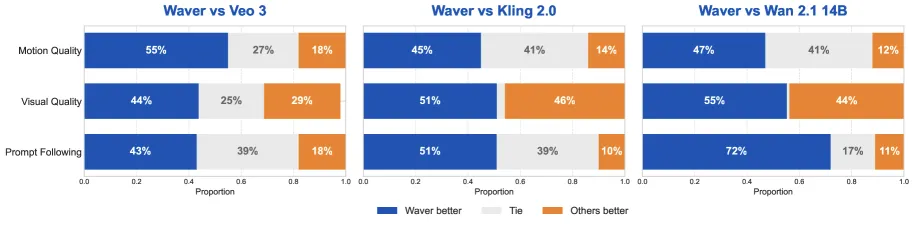
- Hermes Motion Testset:96 个 prompt,聚焦 32 类体育运动(网球、篮球、体操等)复杂运动。
评估维度分三类:运动质量(Action/Interaction/Distortion)、视觉质量(Image Quality/Color/Clarity/Realism/Aesthetics)、prompt following(Subject/描述/动作准确性/动作幅度/相机运动)。
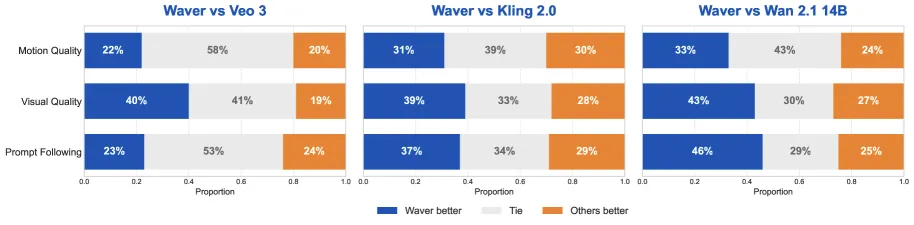
- Waver-bench 1.0:全面优于 Wan2.1 14B;对 Kling2.0 视觉/指令更好、运动略优;对 Veo3 视觉更高、运动略优,仅 prompt following 略弱。
- Hermes 运动集:在运动质量与 prompt following 上大幅领先所有 baseline,凸显复杂动态运动生成能力。
八、讨论:稀疏注意力与 VAE 经验
8.1 DiT 稀疏性
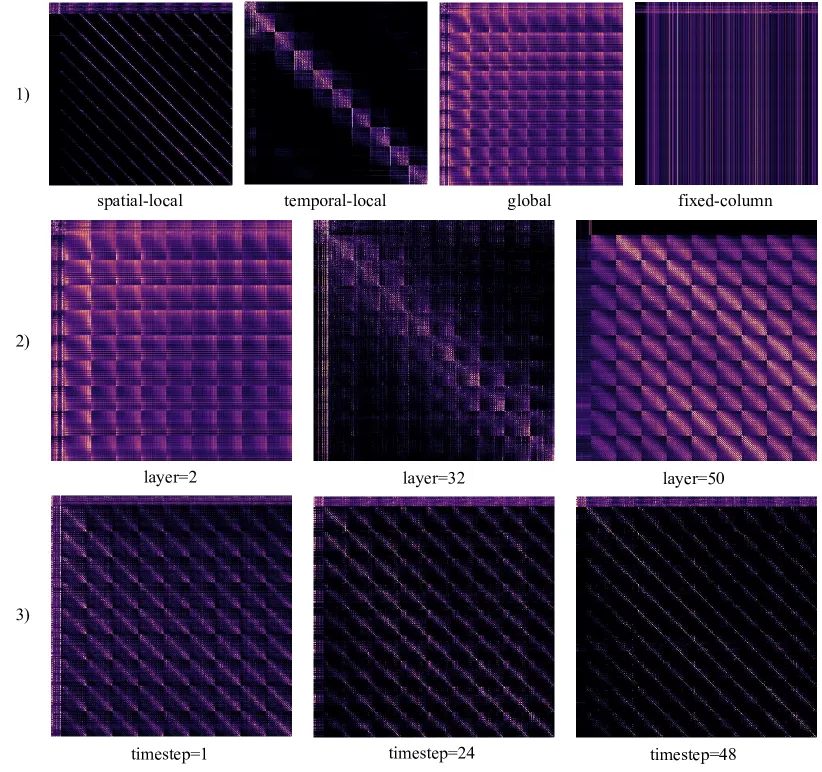
self-attention 复杂度 ,生成 5 秒 1080p 时注意力占总计算 90%+。作者观察到三大规律:(1) 跨注意力头异质(空间局部/时间局部/全局/固定列);(2) 层间稀疏呈”密-疏-密”;(3) 随去噪时间步稀疏度递增。据此指出两条方向:时空滑窗注意力、以及为视频重设计的 NSA(Native Sparse Attention) 自适应稀疏注意力。
8.2 VAE 经验(虽用 Wan2.1-VAE,仍给出优化洞见)
- KL 权重敏感:过低(Wan VAE)导致颗粒纹理/模式坍塌;过高(CogVideoX VAE)扭曲背景。KL=0 时潜空间平滑规整,KL 增大则潜表示向 坍缩、变噪,扩散训练更难(Fig 30/31)。
- LPIPS 权重:过高在高运动细节区引入网格状伪影,故设为 0.1(Fig 32)。
- 未来方向:更高压缩率、与音频/文本融合的多模态统一潜空间。
九、核心创新与贡献
| 创新点 | 说明 | 依据 |
|---|---|---|
| Task-Unified DiT | 三段式输入(噪声潜变量 + 条件帧 + 掩码)在单一网络统一 T2I/T2V/I2V,仅改通道维 | 省去双模型开销,支持任务混合 |
| Hybrid Stream 架构 | 前 16 层 Dual Stream 对齐模态 + 后 40 层 Single Stream 提效 | Fig 5 收敛快于纯方案 |
| Cascade Refiner | 两阶段生成 + 像素/潜变量退化训练,超分并修伪影 | 比直生 1080p 提速 40% |
| 表征对齐 | Qwen2.5-VL 语义特征对齐 DiT 第 16 层(仅 480p 阶段) | Fig 11 语义结构更清晰 |
| 运动优化组合拳 | 192p 运动预训练 + mode 采样 + T2V/I2V 联合 + 弱运动过滤 | 复杂运动 SOTA |
| 工业级数据流水线 | MLLM 质量模型 + 细粒度字幕 + 多级动作均衡 + 分层漏斗 | 2 亿+片段,可复现配方 |
十、局限性
- 高运动场景下人体细节(手、腿)易畸变;
- 生成视频有时缺乏丰富视觉细节,表现力受限;
- 未来拟用强化学习(RL)缓解畸变、增强细节。
十一、参考资源
- 论文:Waver: Wave Your Way to Lifelike Video Generation (arXiv:2508.15761)
- 代码/主页:https://github.com/FoundationVision/Waver
- 关键引用:SD3 / Rectified Flow(Esser et al., 2024)、DiT(Peebles & Xie, 2023)、Wan2.1、HunyuanVideo、CogVideoX、REPA(Yu et al., 2024)、VA-VAE(Yao et al., 2025)、APG(Sadat et al., 2024)、NSA(Yuan et al., 2025)、Ulysses(Jacobs et al., 2023)、FSDP(Zhao et al., 2023)、Qwen2.5-VL、VideoLLaMA3、Tarsier2
- 相关文档:
- HunyuanVideo: 大规模视频生成框架(13B 开源,同期强 baseline)
- HunyuanVideo 1.5(8.3B 轻量化 + 稀疏注意力)
- Movie Gen: 媒体基础模型全家桶(30B,Flow Matching,本文人评协议参照)
- LTX-Video: 实时视频潜在扩散(holistic 高压缩效率路线对比)
- Video LDM: 高分辨率视频合成的隐扩散模型
- LongCat-Video 技术报告(长视频方向)