Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion
自强制训练范式解决自回归视频扩散模型的暴露偏差问题,实现单GPU 17FPS实时视频生成
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion |
| 作者 | Xun Huang, Zhengqi Li, Guande He, Mingyuan Zhou, Eli Shechtman |
| 机构 | Adobe Research、德克萨斯大学奥斯汀分校 |
| 论文 | arXiv:2506.08009 |
| 主页 | self-forcing.github.io |
| 硬件 | 单卡NVIDIA H100(推理)、64×H100(训练) |
| 领域 | 视频生成、自回归扩散模型 |
二、核心思想
问题定义
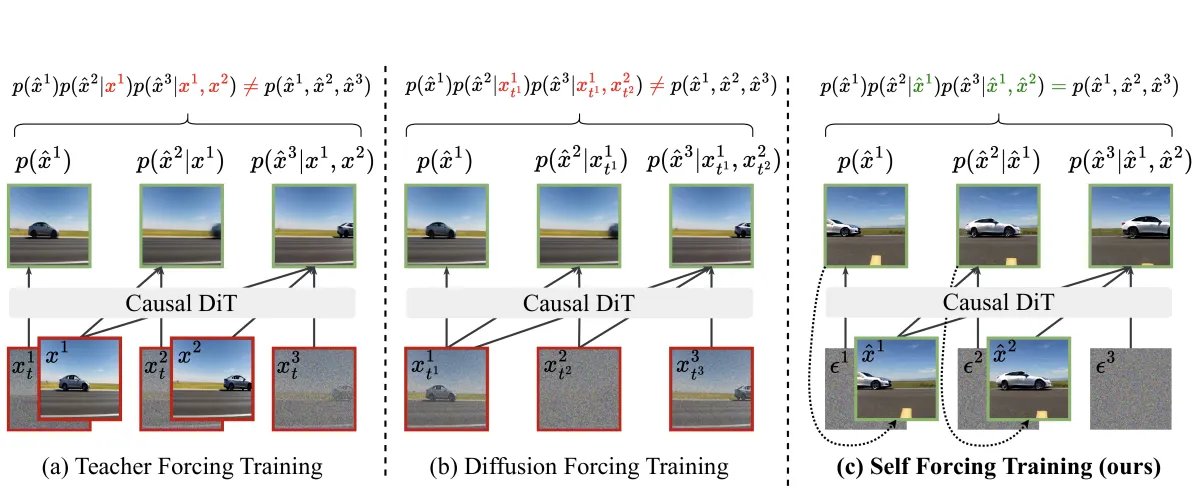
Figure 1: AR视频扩散模型的三种训练范式对比
自回归视频扩散模型存在**暴露偏差(Exposure Bias)**问题:
| 训练范式 | 上下文来源 | 问题 |
|---|---|---|
| Teacher Forcing (TF) | 干净的真实帧 | 推理时从未见过自己的错误输出 |
| Diffusion Forcing (DF) | 带噪声的真实帧 | 仍然存在暴露偏差和误差累积 |
| Self Forcing (本文) | 自生成的帧 | 训练与推理分布一致 |
核心问题:模型训练时使用真实帧作为上下文,但推理时必须依赖自己不完美的预测,导致误差累积。
解决方案概述
Self Forcing在训练时执行自回归自展开(self-rollout),使训练过程镜像推理过程:
- 自回归自展开:训练时基于自生成帧去噪下一帧
- 整体分布匹配损失:视频级损失函数评估整个生成序列
- 随机梯度截断:平衡计算成本和性能
- 滚动KV缓存:高效生成任意长度视频
三、技术架构
整体框架
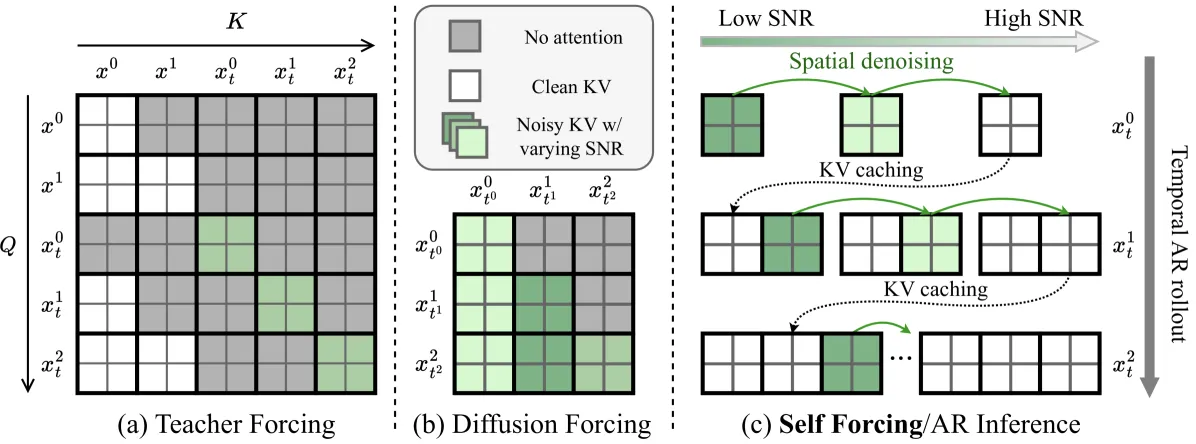
Figure 2: 三种方法的注意力掩码配置
Self Forcing的核心创新:
| 组件 | 功能 | 效果 |
|---|---|---|
| Self-Rollout | 训练时自回归生成 | 消除暴露偏差 |
| Holistic Loss | 视频级分布匹配 | 整体质量优化 |
| Stochastic Gradient Truncation | 随机选择梯度计算步骤 | 内存高效训练 |
| Rolling KV Cache | 固定大小缓存+淘汰机制 | O(TL)复杂度 |
核心公式
自回归分解
前向扩散过程
其中 ,
标准帧级去噪损失(TF/DF)
其中
Few-step扩散模型分布
其中:
且
整体分布匹配目标
关键区别:Self Forcing匹配整个视频序列的整体分布,而TF/DF执行帧级分布匹配。
噪声分布匹配
DMD损失(反向KL散度)
SiD损失(Fisher散度)
GAN损失(Jensen-Shannon散度)
通过生成器和判别器的极小极大博弈近似JS散度。
复杂度对比
| 方法 | 视频外推复杂度 |
|---|---|
| 双向模型(无KV缓存) | |
| 先前因果模型(重计算KV) | |
| Self Forcing(滚动KV缓存) |
随机梯度截断
关键创新:使顺序训练在内存上可行
- 采样随机步骤
- 仅在步骤 (每帧的最后去噪步骤)启用梯度计算
- 之前的步骤无梯度运行
效果:保持训练效率的同时,让模型从自己的预测中学习。
滚动KV缓存
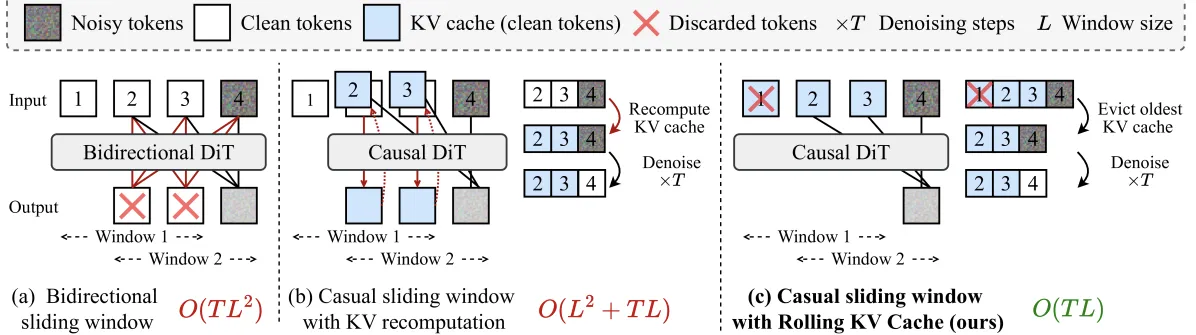
Figure 3: 视频外推的效率对比
机制:
- 维护固定大小KV缓存,存储最近L帧
- 缓存满时,淘汰最旧条目再添加新条目
- 支持无限帧生成,复杂度
问题:朴素实现会导致闪烁伪影(首帧潜在帧统计特性不同)
解决:训练时限制注意力窗口,使模型在去噪最后chunk时不能attend到第一个chunk
四、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| Self Forcing训练范式 | 训练时自回归自展开 | 消除暴露偏差 |
| 整体分布匹配损失 | 视频级而非帧级损失 | 整体质量优化 |
| 随机梯度截断 | 随机选择梯度计算步骤 | 内存高效训练 |
| 滚动KV缓存 | 固定缓存+淘汰机制 | O(TL)复杂度 |
| 局部注意力训练 | 限制注意力窗口 | 消除外推伪影 |
| 范式转换 | 并行预训练+顺序后训练 | 类似RL的训练范式 |
与CausVid的关键区别:
- CausVid使用DF训练,但推理时用自回归条件——训练分布与推理分布不匹配
- Self Forcing在训练时执行实际的自回归展开,确保训练分布=推理分布
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 基础模型 | Wan2.1-T2V-1.3B(Flow Matching模型) |
| 视频规格 | 5秒,16 FPS,832×480 |
| 扩散步数 | 4步 |
| AR变体 | 帧级(1帧/次)、chunk级(3帧/次) |
| 评估 | VBench(16个指标)、用户偏好研究 |
| 硬件 | 单卡H100(推理)、64×H100(训练) |
性能对比
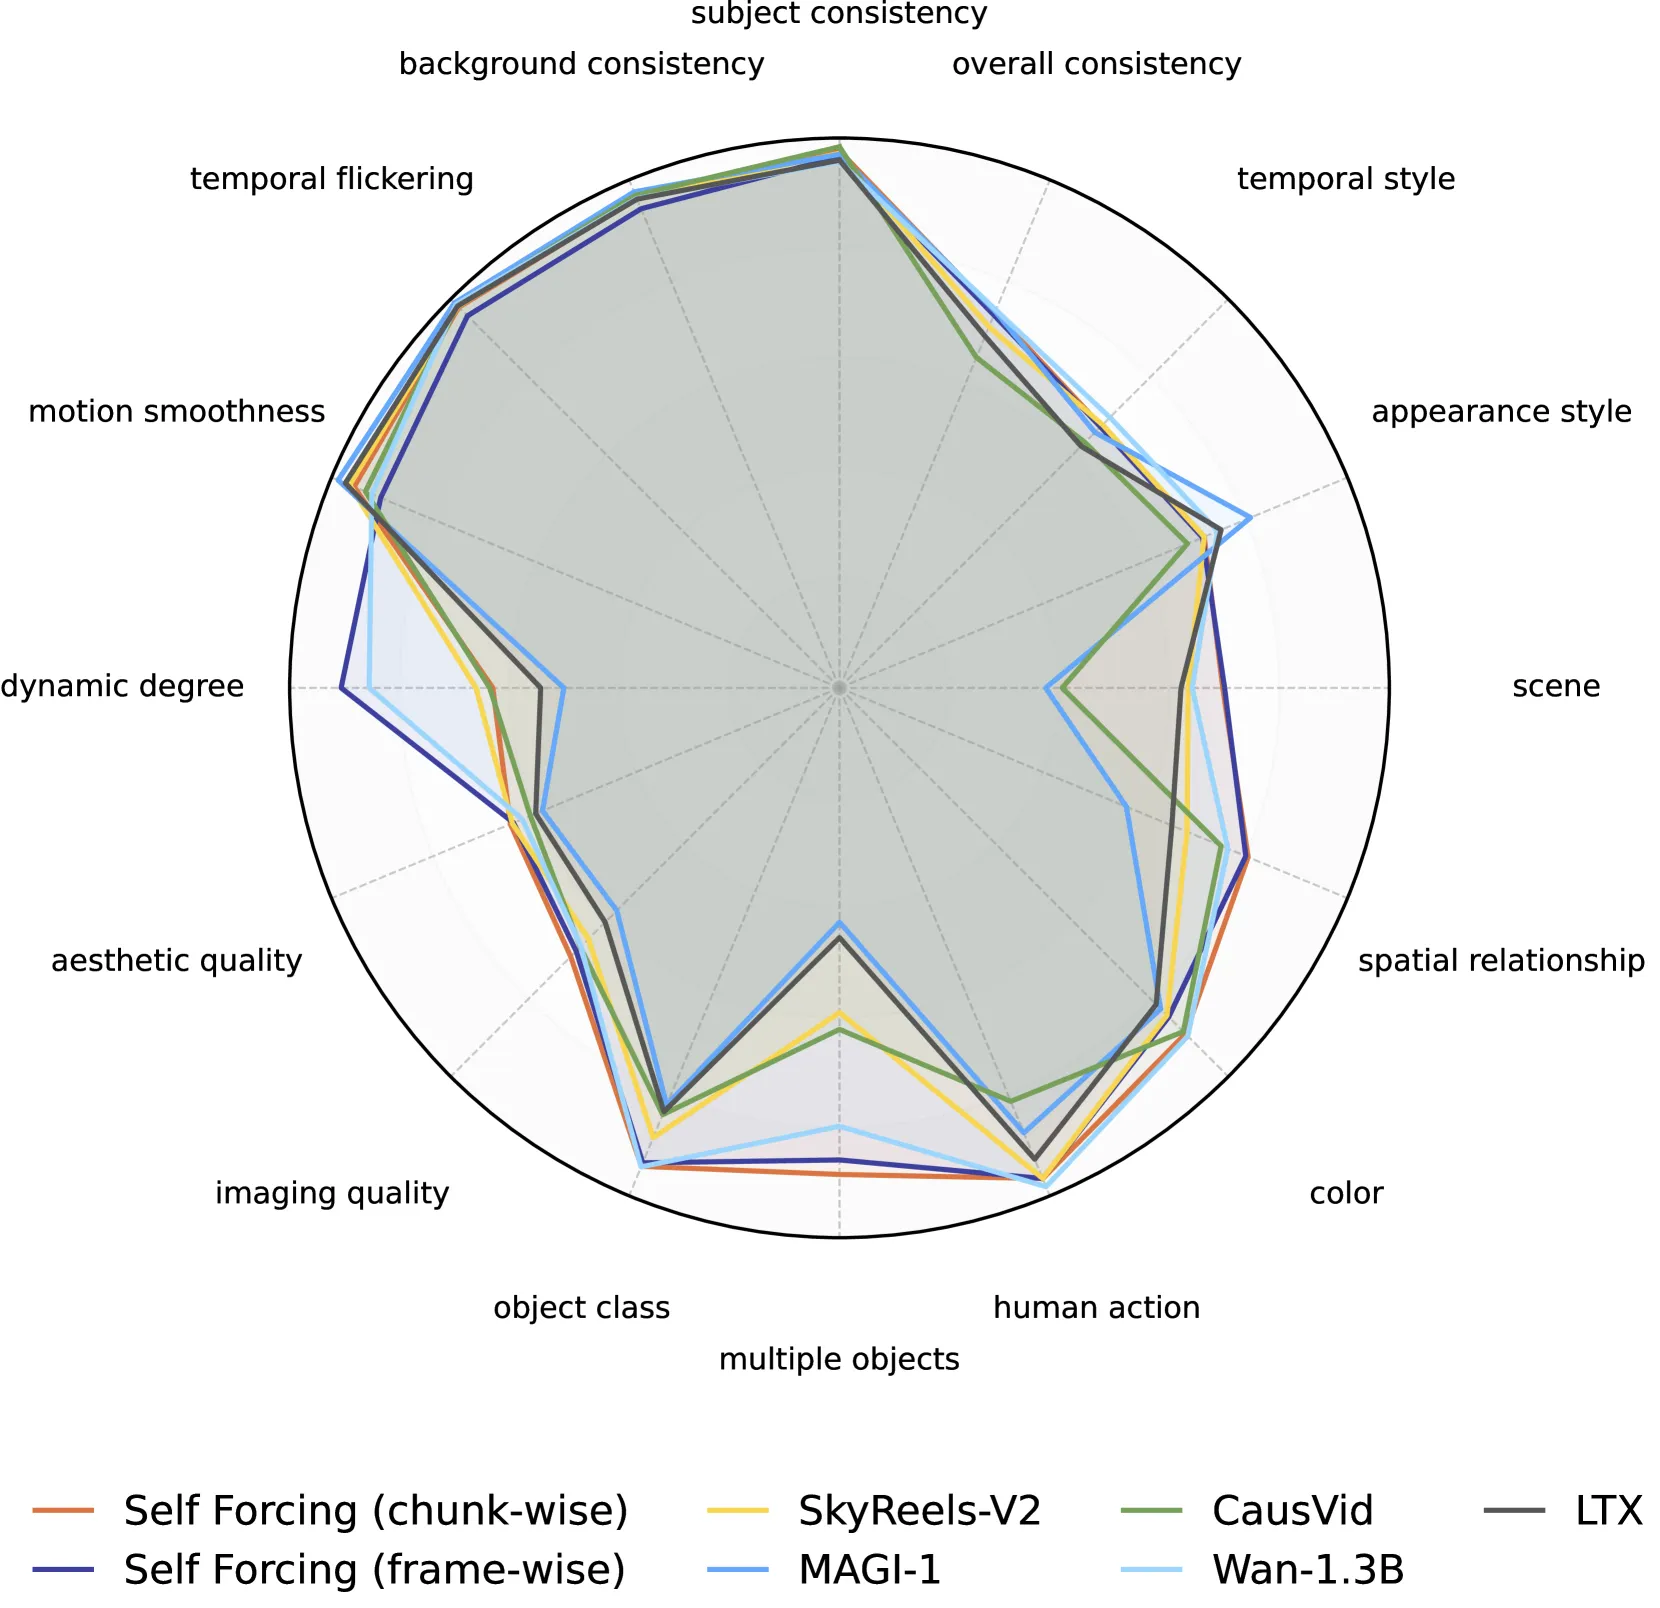
Figure 8: VBench 16个维度的分数可视化
Table 1: 与基线模型对比
| 模型 | 参数 | 分辨率 | 吞吐量(FPS) | 延迟(s) | 总分 | 质量分 | 语义分 |
|---|---|---|---|---|---|---|---|
| 扩散模型 | |||||||
| LTX-Video | 1.9B | 768×512 | 8.98 | 13.5 | 80.00 | 82.30 | 70.79 |
| Wan2.1 | 1.3B | 832×480 | 0.78 | 103 | 84.26 | 85.30 | 80.09 |
| Chunk级AR模型 | |||||||
| SkyReels-V2 | 1.3B | 960×540 | 0.49 | 112 | 82.67 | 84.70 | 74.53 |
| MAGI-1 | 4.5B | 832×480 | 0.19 | 282 | 79.18 | 82.04 | 67.74 |
| CausVid* | 1.3B | 832×480 | 17.0 | 0.69 | 81.20 | 84.05 | 69.80 |
| Self Forcing (chunk级) | 1.3B | 832×480 | 17.0 | 0.69 | 84.31 | 85.07 | 81.28 |
| 帧级AR模型 | |||||||
| NOVA | 0.6B | 768×480 | 0.88 | 4.1 | 80.12 | 80.39 | 79.05 |
| Pyramid Flow | 2B | 640×384 | 6.7 | 2.5 | 81.72 | 84.74 | 69.62 |
| Self Forcing (帧级) | 1.3B | 832×480 | 8.9 | 0.45 | 84.26 | 85.25 | 80.30 |
*CausVid使用相同的基础模型(Wan-1.3B)
关键结果:
- 最高VBench分数:84.31(chunk级),84.26(帧级)
- 实时生成:17 FPS,0.69秒延迟(chunk级)
- 最低延迟:8.9 FPS,0.45秒(帧级)
- vs Wan2.1基础模型:快约150倍(0.69s vs 103s),质量相当
- vs SkyReels-V2:快约162倍(0.69s vs 112s),质量更优
- vs MAGI-1:快约409倍(0.69s vs 282s),质量显著更优
用户偏好研究
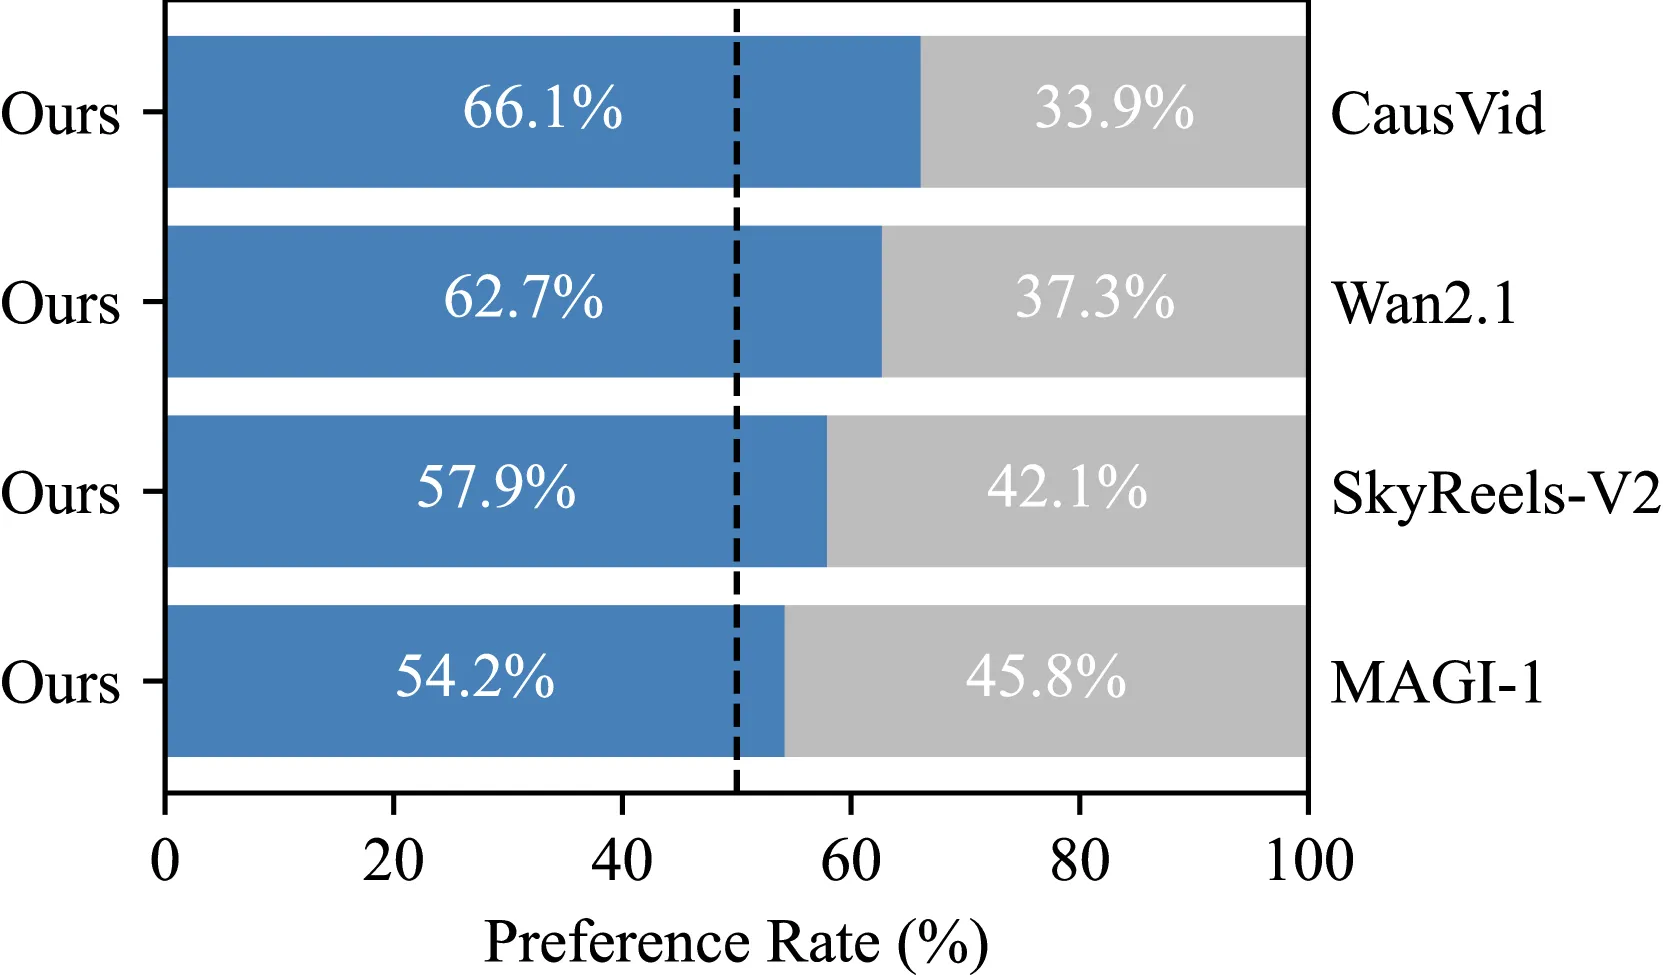
Figure 4: 用户偏好研究结果
Self Forcing在人类偏好评估中超越所有基线。
消融实验
Table 2: 训练范式消融
Chunk级AR:
| 训练范式 | 总分 | 质量分 | 语义分 |
|---|---|---|---|
| Diffusion Forcing (DF) [50×2步] | 82.95 | 83.66 | 80.09 |
| Teacher Forcing (TF) [50×2步] | 83.58 | 84.34 | 80.52 |
| DF + DMD [4步] | 82.76 | 83.49 | 79.85 |
| TF + DMD [4步] | 82.32 | 82.73 | 80.67 |
| Self Forcing + DMD [4步] | 84.31 | 85.07 | 81.28 |
| Self Forcing + SiD [4步] | 84.07 | 85.52 | 78.24 |
| Self Forcing + GAN [4步] | 83.88 | 85.06 | 79.16 |
帧级AR:
| 训练范式 | 总分 | 质量分 | 语义分 |
|---|---|---|---|
| Diffusion Forcing (DF) [50×2步] | 77.24 | 79.72 | 67.33 |
| Teacher Forcing (TF) [50×2步] | 80.34 | 81.34 | 76.34 |
| DF + DMD [4步] | 80.56 | 81.02 | 78.71 |
| TF + DMD [4步] | 78.12 | 79.62 | 72.11 |
| Self Forcing + DMD [4步] | 84.26 | 85.25 | 80.30 |
| Self Forcing + SiD [4步] | 83.54 | 84.71 | 78.86 |
| Self Forcing + GAN [4步] | 83.27 | 84.57 | 78.08 |
关键发现:
- Self Forcing在所有分布匹配目标下均稳健工作
- 基线从chunk级切换到帧级时质量显著下降(误差累积)
- Self Forcing在两种设置下保持一致性能
- CausVid(DF+DMD)因误差累积导致饱和度随时间增加
训练效率
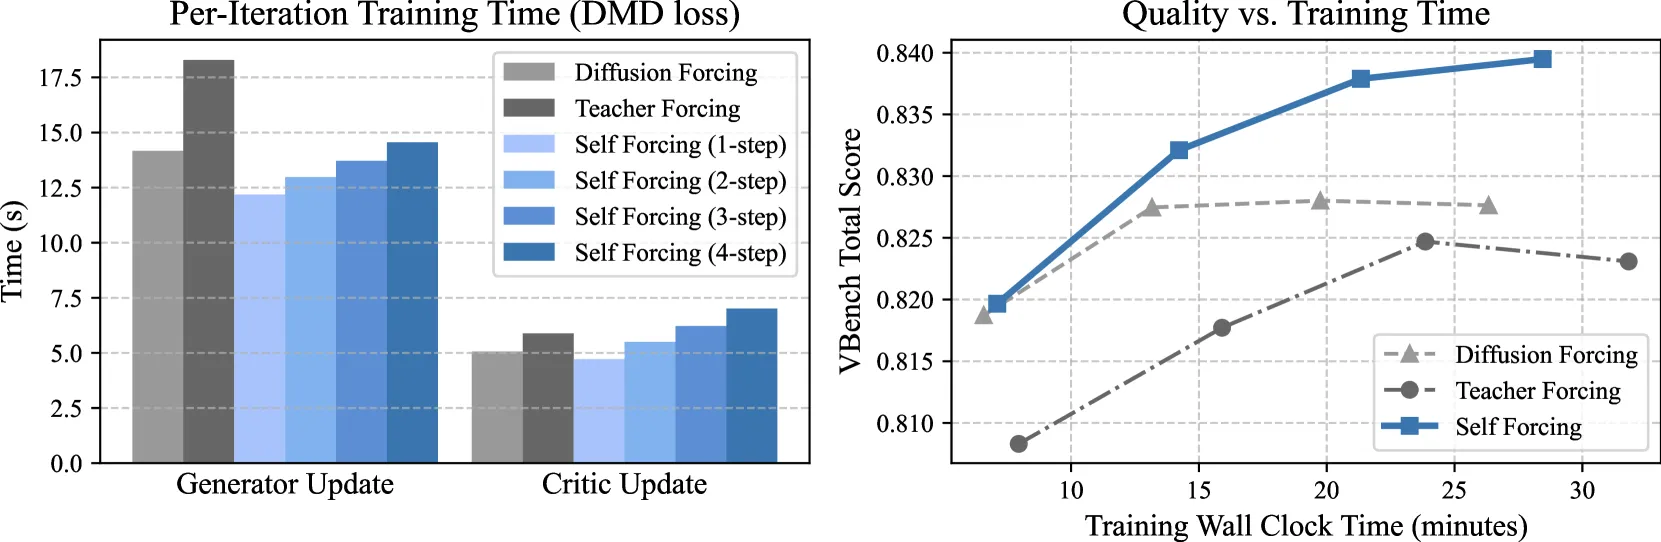
Figure 6: 训练效率对比
- Self Forcing在64×H100上约1.5小时收敛(使用DMD)
- 每次迭代训练时间与TF和DF相当
- 相同wall-clock训练预算下,质量优于TF和DF
- 效率原因:
- 顺序展开仍并行处理每帧/chunk内的所有token
- TF/DF需要特殊注意力掩码,有计算开销
- Self Forcing使用全注意力+FlashAttention-3优化
滚动KV缓存结果
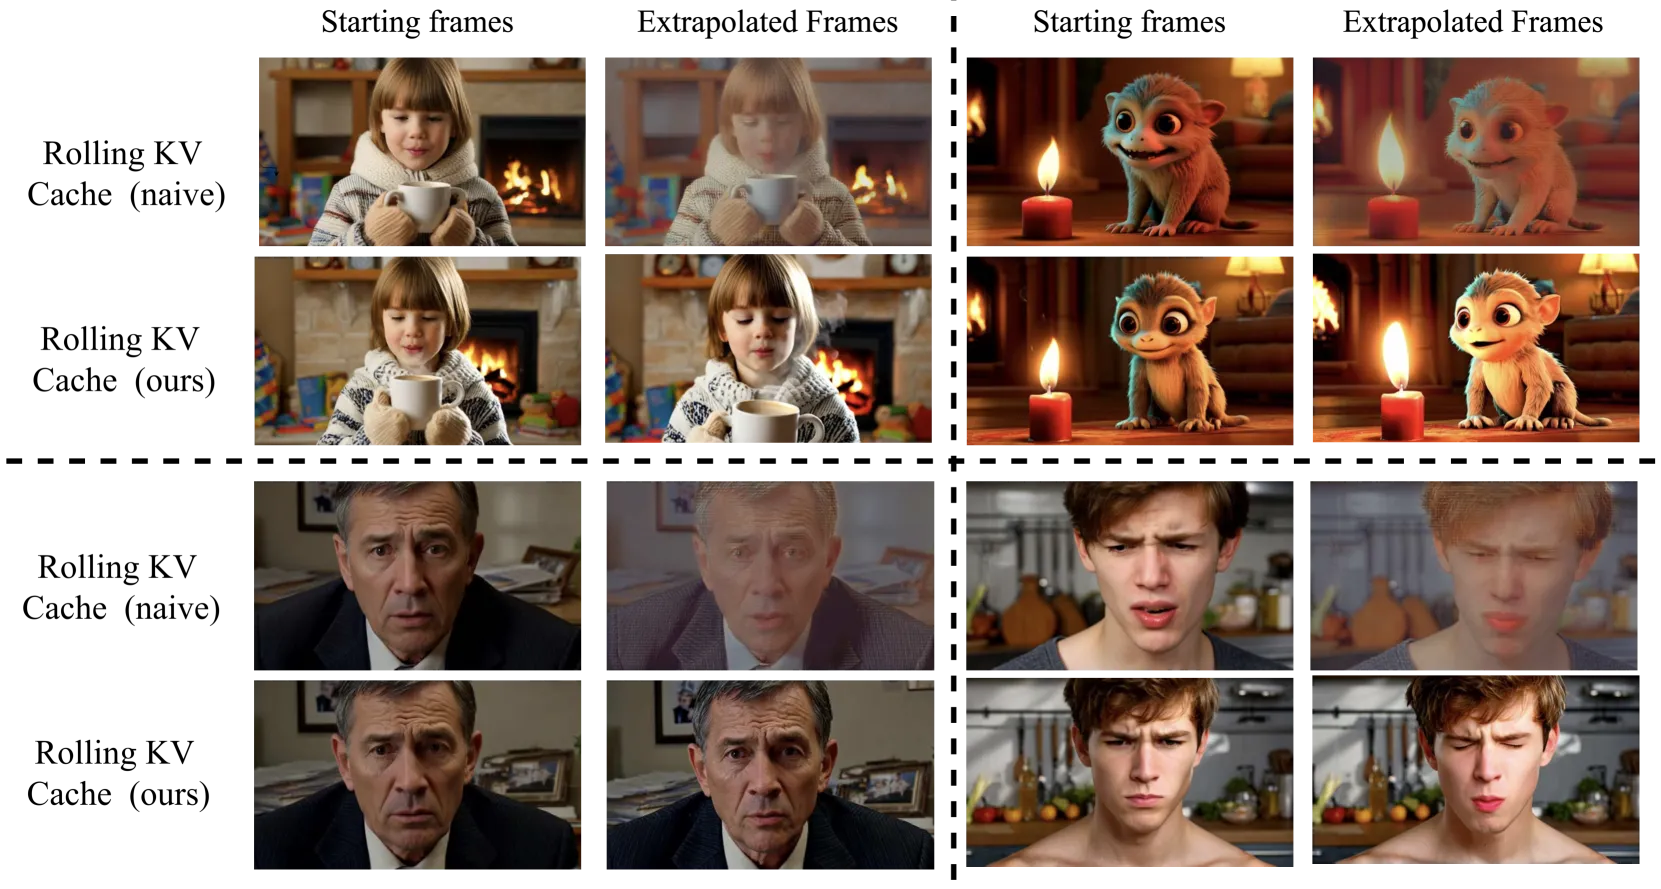
Figure 7: 视频外推的定性对比
| 方法 | 10秒视频FPS | 伪影 |
|---|---|---|
| 重计算KV缓存 | 4.6 | 无 |
| 朴素滚动KV缓存 | 高 | 严重 |
| Self Forcing + 滚动KV缓存训练 | 16.1 | 缓解 |
定性对比
生成质量对比(Self Forcing vs Wan2.1, SkyReels-V2, CausVid):
- Self Forcing生成更清晰、更连贯的视频
- CausVid存在饱和度随时间增加的问题
- Self Forcing在长时间生成中保持稳定质量
六、相关工作对比
| 方法 | 方案 | Self Forcing解决的局限 |
|---|---|---|
| Teacher Forcing | 干净真实帧训练 | 暴露偏差:从未见过自己的错误 |
| Diffusion Forcing | 噪声真实帧训练 | 仍有暴露偏差和误差累积 |
| CausVid | DF + DMD | 训练分布≠推理分布,DMD匹配错误分布 |
| Rolling Diffusion | 渐进噪声调度 | 不严格遵循AR链式法则 |
| GANs | 生成器训练/推理一致 | 无法直接应用于扩散模型 |
| Professor Forcing | RNN时代的暴露偏差解决方案 | Self Forcing将其适配到视频扩散领域 |
与CausVid的关键区别:
- CausVid用DF训练,但推理用自回归条件
- DMD损失匹配的是DF生成的分布,而非推理时的分布
- Self Forcing在训练时执行实际自回归展开,确保分布一致
七、总结
核心贡献
- Self Forcing训练范式:首个在训练时执行自回归自展开的视频扩散方法
- 暴露偏差解决:强制模型在训练时遇到并学习自己的预测错误
- 整体分布匹配损失:视频级而非帧级的分布匹配
- 随机梯度截断:使顺序训练在内存上可行
- 滚动KV缓存:O(TL)复杂度的无限视频生成
- 局部注意力训练:消除外推伪影
- 实时流式视频生成:单GPU 17 FPS,亚秒延迟
- 范式转换:并行预训练+顺序后训练(类似RL)
性能指标
| 指标 | 数值 |
|---|---|
| 吞吐量(chunk级) | 17.0 FPS |
| 延迟(chunk级) | 0.69秒 |
| 吞吐量(帧级) | 8.9 FPS |
| 延迟(帧级) | 0.45秒 |
| VBench总分 | 84.31(最高) |
| 质量分数 | 85.07(超越基础模型) |
| 语义分数 | 81.28(最高) |
| 训练时间 | 1.5小时(64×H100) |
| 速度提升 | 150-409倍 |
技术影响
- 首次证明自回归视频扩散可以实时生成且质量不妥协
- 揭示了并行训练的根本局限:训练/推理分布不匹配
- 提出新的训练范式:并行预训练+顺序后训练
- 为交互式视频生成(游戏、机器人)开辟道路
局限性
- 生成远超训练上下文长度的视频时质量下降
- 梯度截断可能限制长程依赖学习
- 未来可探索状态空间模型等循环架构
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 训练范式对比 | figure1-training-paradigms.png |
| Figure 2 | 注意力掩码配置 | figure2-attention-masks.png |
| Figure 3 | 外推效率对比 | figure3-extrapolation-efficiency.png |
| Figure 4 | 用户偏好研究 | figure4-user-study.png |
| Figure 6 | 训练效率对比 | figure6-training-efficiency.png |
| Figure 7 | 外推定性对比 | figure7-extrapolation-comparison.png |
| Figure 8 | VBench分数可视化 | figure8-vbench-scores.png |